本指南面向已经能编写 FastAPI 接口的读者,讨论项目结构、业务校验、数据库和测试的维护实践。基础用法与运行原理见 FastAPI 学习笔记。
内容基于 zhanymkanov/fastapi-best-practices 作者在初创公司的生产经验,包含通用实践和团队约定,应结合适用条件选择。
示例使用 Python 3.11+、Pydantic 2、pydantic-settings 和 SQLAlchemy 2.x,目录沿用主笔记的 src/app/core、src/app/modules。“项目片段”需接入自己的服务、模型和数据库;独立示例包含所需定义。
目录#
1. 项目结构与配置管理#
1.1 按业务领域组织模块#
项目结构有很多种,但好的结构应该一致、直观且没有意外。
按文件类型划分 routers/、crud/ 等目录,适合小项目。业务领域增多后,修改一个功能可能需要跨越多个目录,此时可以按业务划分模块,把相关路由、模型、依赖和服务放在一起。
下面的结构受 Netflix 的 Dispatch 启发,沿用主笔记的 src/app/modules 层级:
project_root/├── src/│ └── app/│ ├── core/│ │ ├── config.py # 全局配置│ │ ├── database.py # 数据库引擎、会话、ORM 基类│ │ ├── schemas.py # 确实需要共享的 Pydantic 基础模型│ │ ├── exceptions.py # 全局异常│ │ └── pagination.py # 公共分页约定│ ├── modules/│ │ ├── auth/│ │ │ ├── router.py│ │ │ ├── schemas.py│ │ │ ├── service.py│ │ │ ├── dependencies.py│ │ │ └── config.py│ │ ├── posts/│ │ │ ├── router.py│ │ │ ├── schemas.py│ │ │ ├── models.py│ │ │ ├── service.py│ │ │ ├── dependencies.py│ │ │ ├── constants.py│ │ │ └── exceptions.py│ │ └── aws/│ │ ├── client.py # 外部服务客户端封装│ │ ├── schemas.py│ │ └── config.py│ └── main.py # 创建应用、注册路由和生命周期├── tests/ # 按业务模块组织测试│ ├── auth/│ └── posts/├── migrations/ # Alembic 迁移脚本├── templates/ # 需要服务端模板时再添加├── pyproject.toml├── uv.lock # 使用 uv 时锁定依赖版本├── .env.example├── .gitignore├── logging.ini # 使用文件式日志配置时再添加└── alembic.ini目录树省略了 __init__.py;users、products 等业务也放在 modules/ 下。各文件职责如下,按需要创建即可:
| 文件 | 主要职责 |
|---|---|
router.py | 定义端点、声明输入输出和依赖,把处理交给服务层 |
schemas.py | Pydantic 模型,描述接口输入、输出和数据校验 |
models.py | SQLAlchemy ORM 模型,描述数据库表结构 |
service.py | 模块的业务逻辑、事务协调和对外提供的业务操作 |
crud.py | 数据库读写复杂到值得独立拆分时,再从服务层抽出 |
dependencies.py | 路由依赖项,例如查询资源、校验权限 |
constants.py | 模块特定的常量和错误代码 |
config.py | 模块特定的配置,例如认证参数或外部服务连接信息 |
utils.py | 范围明确的非业务辅助函数,避免成为杂物箱 |
exceptions.py | 模块特定的异常,例如 PostNotFound、InvalidUserData |
client.py | 外部系统的调用封装,例如对象存储 SDK |
从项目根目录启动仍然使用主笔记的命令:uvicorn src.app.main:app --reload。
也可用 requirements/base.txt、dev.txt、prod.txt 区分环境依赖;已有 pyproject.toml 和锁文件的项目沿用现有分组,避免重复维护两套清单。
1.2 跨模块使用显式导入#
跨模块导入时显式标明来源,避免多个 service.py 或 ErrorCode 混淆:
# 项目片段:以下模块由实际业务提供from src.app.modules.auth import constants as auth_constantsfrom src.app.modules.notifications import service as notification_servicefrom src.app.modules.posts.constants import ErrorCode as PostsErrorCode跨模块调用尽量经过服务接口,避免依赖对方路由或私有实现。出现循环导入时,先检查业务职责是否混杂,不要立即把所有东西搬到 core/。
1.3 配置增多后,按领域拆分 BaseSettings#
小项目用一个 BaseSettings 配置类即可;配置增多后,再把认证、数据库、外部服务配置拆到所属模块。下面按需创建并缓存配置实例,避免每次请求重新读取。密钥通过环境变量或 .env 提供。
from datetime import timedeltafrom functools import lru_cache
from pydantic import Field, SecretStrfrom pydantic_settings import BaseSettings, SettingsConfigDict

class AuthConfig(BaseSettings):    model_config = SettingsConfigDict(        env_prefix="AUTH_", env_file=".env", env_file_encoding="utf-8", extra="ignore"    )
    JWT_ALG: str = "HS256"    JWT_SECRET: SecretStr    JWT_EXP: int = Field(default=5, gt=0)  # 分钟    REFRESH_TOKEN_KEY: str = "refresh_token"  # Cookie 名称    REFRESH_TOKEN_EXP: timedelta = timedelta(days=30)    SECURE_COOKIES: bool = True

@lru_cachedef get_auth_settings() -> AuthConfig: return AuthConfig()from functools import lru_cachefrom typing import Literal
from pydantic import PostgresDsn, RedisDsnfrom pydantic_settings import BaseSettings, SettingsConfigDict
class Config(BaseSettings): model_config = SettingsConfigDict( env_file=".env", env_file_encoding="utf-8", extra="ignore" )
DATABASE_URL: PostgresDsn REDIS_URL: RedisDsn | None = None SITE_DOMAIN: str = "myapp.com" ENVIRONMENT: Literal["local", "staging", "production"] = "production" SENTRY_DSN: str | None = None CORS_ORIGINS: list[str] = [] CORS_ORIGINS_REGEX: str | None = None CORS_HEADERS: list[str] = [] APP_VERSION: str = "1.0"
@lru_cachedef get_settings() -> Config: return Config()env_prefix="AUTH_" 使认证配置读取 AUTH_JWT_SECRET 等变量;全局配置直接读取 DATABASE_URL 等名称。列表用 JSON 字符串配置,例如 CORS_ORIGINS='["https://example.com"]'。
extra="ignore" 忽略共享 .env 中其他模块的字段,也可能漏掉拼写错误,需通过测试或启动校验发现。配置 getter 可通过 Depends 注入;签名时用 JWT_SECRET.get_secret_value() 取得密钥,避免打印原文。
启动时应验证所需配置;缓存不会随环境变量自动更新,测试修改变量后需清除 getter 缓存。基础用法见主笔记“项目配置”,详细行为见 Pydantic Settings 文档。
2. 路由与业务依赖设计#
2.1 依赖项可以承担共享的业务校验#
资源存在性和权限检查可以抽成依赖,避免每个端点重复查询、验证和测试。主笔记的链式依赖示例已演示文章查询、作者身份和账号状态检查;这里把查询交给服务层,让多个路由复用结果。
下面是项目片段,假设已经提供异步 service.get_by_id、service.update 和 reviews_service.get_by_post_id,以及对应的请求、响应模型:
from typing import Anyfrom uuid import UUID
from fastapi import HTTPException
from src.app.modules.posts import service

async def valid_post_id(post_id: UUID) -> dict[str, Any]: post = await service.get_by_id(post_id) if post is None: raise HTTPException(status_code=404, detail="文章不存在") return postfrom typing import Annotated, Any
from fastapi import APIRouter, Depends
from src.app.modules.posts import servicefrom src.app.modules.posts.dependencies import valid_post_idfrom src.app.modules.posts.schemas import PostResponse, PostUpdatefrom src.app.modules.reviews import service as reviews_servicefrom src.app.modules.reviews.schemas import ReviewResponse
router = APIRouter()PostExists = Annotated[dict[str, Any], Depends(valid_post_id)]
@router.get("/posts/{post_id}", response_model=PostResponse)async def get_post_by_id(post: PostExists): return post
@router.patch("/posts/{post_id}", response_model=PostResponse)async def update_post(update_data: PostUpdate, post: PostExists): return await service.update(id=post["id"], data=update_data)
@router.get("/posts/{post_id}/reviews", response_model=list[ReviewResponse])async def get_post_reviews(post: PostExists): return await reviews_service.get_by_post_id(post["id"])这里仅检查资源存在性,修改接口还需身份和权限依赖。若底层使用同步数据库,应采用同步依赖与路由,或显式转交线程池;改成 async def 不会消除阻塞。
2.2 用依赖链组合规则#
需要“作者本人且账号有效”才能访问的接口,可以组合这些依赖:
接口├── valid_owned_post│ ├── valid_post_id → 获取文章│ └── get_current_user → 验证登录身份└── valid_active_creator └── get_current_user → 取得同一个已验证用户valid_post_id 只查文章,便于读取和管理接口复用;valid_owned_post 再比较 creator_id 与当前用户 ID;valid_active_creator 检查账号启用状态和创作者资格。get_current_user 的 JWT 实现见主笔记“用户认证”。
路径为 /users/{user_id}/posts/{post_id} 时,要检查 user_id 与文章、当前身份的关系。若语义只是“操作自己的文章”,用 /posts/{post_id} 加身份依赖即可。
2.3 理解请求内缓存,再决定怎样复用#
上图两条路径使用相同配置的 get_current_user,默认可复用本次请求的结果,无需重复执行或手工传递用户对象。官方子依赖与缓存说明
缓存不跨请求,也不适用于自己直接调用函数。不同参数绑定、Security scopes 或依赖配置不能一概认为共享结果;需要重新执行时,在对应声明上设置 use_cache=False。
依赖尽量只做查询或校验,不要在“读取当前用户”时顺便发邮件。通知由路由安排到 BackgroundTasks 或任务队列,选择边界见“4.3 CPU 密集型任务单独考虑”。
2.4 统一路径参数含义,方便组合依赖#
路径应表达资源关系,例如 /courses/{course_id}、/chapters/{chapter_id},以及嵌套的 /courses/{course_id}/chapters/{chapter_id}/lessons。
FastAPI 根据参数名识别路径参数:valid_profile_id(profile_id: UUID) 可用于 /profiles/{profile_id};如果创作者是一种个人资料,也可在 /creators/{profile_id} 中复用,再检查 is_creator:
# 项目片段:valid_profile_id 已完成资料查询,并返回包含 is_creator 的字典from typing import Annotated
from fastapi import Depends, HTTPException
from src.app.modules.profiles.dependencies import valid_profile_id

async def valid_creator_id(    profile: Annotated[dict, Depends(valid_profile_id)],) -> dict:    if not profile["is_creator"]:        raise HTTPException(status_code=403, detail="该用户不是创作者")    return profile
同名参数便于复用,并非 REST 的强制要求。既有接口使用 {creator_id} 时,可用适配依赖接收,再调用公共查询服务。嵌套路径还需检查子资源归属,不能只确认两个 ID 分别存在。
2.5 同步还是异步依赖,取决于内部工作#
FastAPI 会在线程池执行普通 def 依赖。只做轻量内存计算、读取已加载的配置或条件判断时,async def 可以省去线程切换,即使内部没有 await。同步数据库和 SDK 调用仍应交给线程池或换成异步客户端,不能一律改成异步依赖。
3. 数据模型、校验与响应#
3.1 充分使用 Pydantic,同时区分校验边界#
长度、数值、枚举、邮箱、URL 及 field_validator 的用法见主笔记字段约束与校验。项目中的规则按职责归位:
| 规则 | 合适的位置 |
|---|---|
| 用户名长度、邮箱格式、允许的枚举值 | Pydantic 字段声明 |
| 一组字段之间的纯数据约束 | 字段或模型校验器 |
| 文章是否存在、用户是否有权操作 | 依赖项与业务服务 |
| 邮箱唯一、外键有效、交易更新一致性 | 数据库约束和事务,并转换成合适的业务错误 |
例如,先查询“邮箱不存在”不能防止两个并发请求同时插入同一个邮箱,数据库仍需要唯一约束。
请求模型校验器的 ValueError 会由 Pydantic 收集,再由 FastAPI 返回 422。历史响应截图如下,具体格式以当前版本和异常处理器为准:
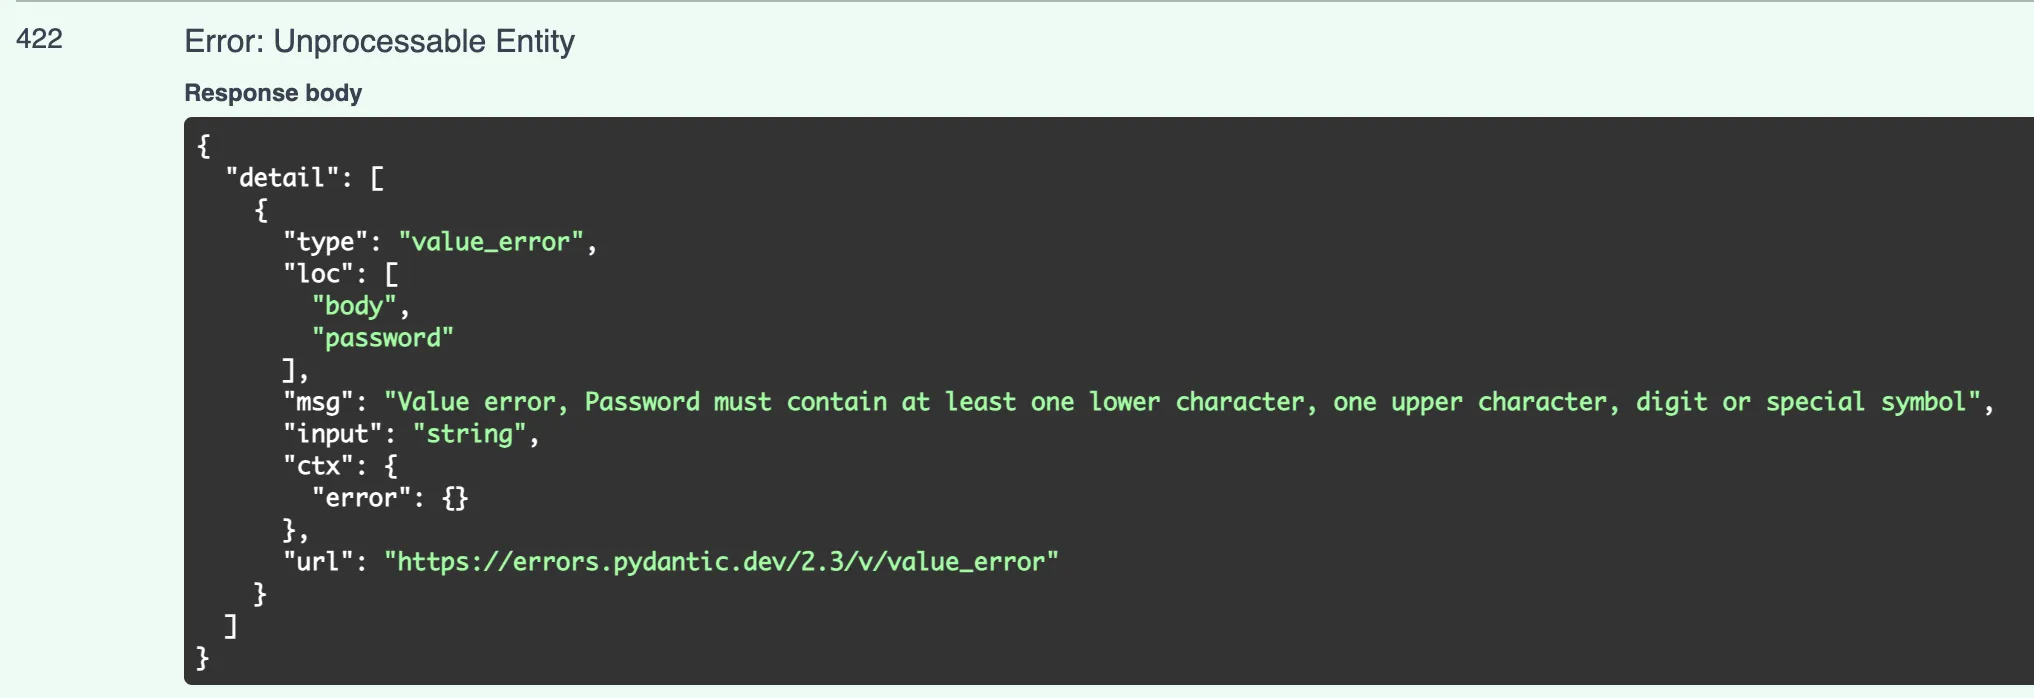
任意业务异常不等于请求参数错误;响应模型校验失败通常是服务端返回值违反接口约定,应修复服务端。
3.2 有统一约定时,再建立公共基础模型#
Pydantic 默认支持 datetime 的 JSON 序列化。需要统一定制格式或导出方法时,再建立公共基类。下面把直接的时间字段转换为 UTC、输出带时区的 ISO 格式,并提供 JSON 模式的字典导出:
from datetime import datetime, timezonefrom typing import Any
from pydantic import AwareDatetime, BaseModel, ConfigDict, Field, field_serializer

class CustomModel(BaseModel):    # Pydantic 2.11+:同时接受字段名与别名作为输入。    model_config = ConfigDict(validate_by_name=True, validate_by_alias=True)
    @field_serializer("*", when_used="json", check_fields=False)    def serialize_datetimes(self, value: Any) -> Any:        if isinstance(value, datetime):            if value.utcoffset() is None:                raise ValueError("时间字段必须带时区")            return value.astimezone(timezone.utc).isoformat(timespec="seconds")        return value
    def serializable_dict(self, **kwargs) -> dict[str, Any]:        """返回 JSON 模式的字典,支持 exclude、by_alias 等导出参数。"""        return self.model_dump(mode="json", **kwargs)

class EventResponse(CustomModel):    created_at: AwareDatetime    title: str = Field(alias="eventTitle")

example = EventResponse( created_at="2026-01-01T08:00:00+08:00", title="发布文章")print(example.serializable_dict(exclude={"title"}))# {'created_at': '2026-01-01T00:00:00+00:00'}- 接受
title和别名eventTitle,导出时用by_alias=True选择别名。此配置要求 Pydantic 2.11+;较早的 2.x 使用populate_by_name=True。 AwareDatetime要求输入带时区,不能擅自把无时区的本地时间当成 UTC。when_used="json"只在 JSON 模式生效;默认model_dump()使用 Python 模式,不会触发它。serializable_dict()返回字典,model_dump_json()返回字符串。普通 FastAPI 路由通常返回模型或字典,避免 JSON 字符串再次编码。- 通配序列化器只处理直接字段;列表、字典和嵌套模型里的时间不会自动全部套用此格式,需另作约定。
- 示例使用秒精度,会丢弃微秒;需要更高精度时应调整格式。
如果只为少数字段定制格式,直接给这些字段定义序列化器更清楚,无需让所有模型继承公共基类。Pydantic 序列化文档
3.3 用 response_model 表达响应约定#
返回字典还是 Pydantic 对象,都可以由路由的 response_model 描述公开字段。重要的是接口的输出结构稳定,敏感字段不会意外泄露。
from fastapi import FastAPIfrom pydantic import BaseModel
app = FastAPI()

class ProfileResponse(BaseModel):    id: int    username: str

@app.get("/profiles/{profile_id}", response_model=ProfileResponse)async def get_profile(profile_id: int):    return {"id": profile_id, "username": "alice", "internal_note": "仅供内部使用"}
响应只公开 id 和 username;业务层已有 ProfileResponse 对象时可直接返回。不要为“避免重复构造”手工转成字典:序列化可能直接使用 Pydantic,是否重新校验取决于版本、配置和输入;“模型必定创建两次”不是通用规则,校验器调用次数也不等于对象创建次数。
response_model 负责响应校验、过滤、序列化和文档声明;直接返回 Response / JSONResponse 时不再按模型过滤,正文由你负责。基础用法见主笔记“响应”及 FastAPI 响应模型文档。
4. 异步调用与阻塞任务处理#
4.1 根据调用的库选择路由写法#
事件循环与线程池的原理见主笔记运行机制总览,项目中按实际工作选择:
| 主要工作 | 实践选择 |
|---|---|
| 异步数据库、异步 HTTP 请求 | async def 配合相应客户端的 await |
| 整条业务链只有同步阻塞接口 | 使用 def 路由,由框架安排在线程池执行 |
| 异步业务中夹杂同步 SDK | 对这段调用显式使用 run_in_threadpool |
| 少量内存操作、轻量校验 | 通常可以直接在异步函数内完成 |
| 大量计算或长时间任务 | 根据任务特性考虑进程池、计算服务或任务队列 |
例如,async def 里直接 time.sleep(10) 会占住当前事件循环线程;改成 def 路由后由工作线程等待,改成 await asyncio.sleep(10) 则通过异步计时器让出执行权。后者是模拟等待,并非网络 I/O;FastAPI 不会自动识别并搬走阻塞调用。
4.2 同步 SDK 的调用边界#
同步库调用可交给工作线程,完整代码见主笔记线程池示例:
# 项目片段:client 和 data 由业务提供result = await run_in_threadpool(client.make_request, data=data)接入时还要确认:
- SDK 的构造、连接和关闭是否也会阻塞;必要时把整段同步操作封装成一个函数交给线程池。
- 客户端能否在线程之间共享,数据库会话等对象是否有并发使用限制。
- SDK 自己有没有设置超时;请求取消或等待超时,不等于线程里正在执行的调用会被强制终止。
- 并发量是否超过线程池、连接池或外部服务容量。线程通常比协程占用更多资源,同步路由、依赖及部分框架操作还会共享线程容量。Starlette 线程池文档
4.3 CPU 密集型任务单独考虑#
繁重计算、数据处理和视频转码不会因 async def / await 自动并行。在启用 GIL 的 CPython 中,纯 Python 计算通常也无法靠多线程获得多核加速;释放 GIL 的扩展或委托外部程序的操作则需另行测量。
长时间计算可交给独立进程或计算服务;需要排队、重试、持久化和进度查询时使用任务队列,由 API 返回任务 ID,客户端查询结果。
BackgroundTasks 适合较小的收尾工作,不提供持久任务保证:返回响应不代表任务完成,进程退出可能丢失未完成任务。
5. 数据库与迁移管理#
5.1 表名和字段名保持一致#
以下是可选的团队命名约定:
- 使用小写蛇形命名,例如
post_like。 - 表名使用单数,例如
post、post_like、user_playlist;已有项目使用复数也可以,关键是保持一致。 - 用业务模块前缀对相关表分组,例如
payment_account、payment_bill。 - 外键名称保持业务含义一致:文章关联用
post_id,课程关联用course_id;强调角色时可用指向个人资料表的creator_id。 - 时间点字段用
_at后缀,如created_at;日期字段用_date,如birth_date。
已有项目以一致性为主,不必仅为单复数进行大规模改名。
5.2 显式设置约束和索引的命名约定#
在共享的 MetaData 中定义稳定的约束和索引名称,方便迁移引用及错误排查:
# src/app/core/database.py 中的基类定义片段from sqlalchemy import MetaDatafrom sqlalchemy.orm import DeclarativeBase
NAMING_CONVENTION = {    "ix": "%(table_name)s_%(column_0_N_name)s_idx",    "uq": "%(table_name)s_%(column_0_N_name)s_key",    "ck": "%(table_name)s_%(constraint_name)s_check",    "fk": "%(table_name)s_%(column_0_N_name)s_%(referred_table_name)s_fkey",    "pk": "%(table_name)s_pkey",}metadata = MetaData(naming_convention=NAMING_CONVENTION)

class Base(DeclarativeBase): metadata = metadataix、uq、ck、fk、pk 分别代表索引、唯一约束、检查约束、外键和主键。column_0_N_name 会包含多个列名,减少复合约束仅按第一列命名时的冲突;表达式索引等特殊情况仍可显式命名。
因为 ck 模板使用了 constraint_name,声明检查约束时要提供基础名称,例如 CheckConstraint("price >= 0", name="price_nonnegative")。
模型共用该基类,Alembic 的 target_metadata 指向 Base.metadata。已有 declarative_base() 时,把 metadata 传给现有基类即可,不要另建一套。SQLAlchemy 约束命名文档
5.3 让 Alembic 迁移可理解、可复现#
基本命令见主笔记“数据库配置与 ORM 操作”;项目中的迁移还应满足:
- 固定历史变化。 把当时的表结构和数据转换逻辑写在迁移里,不要由持续变化的最新 ORM 模型、配置或服务决定旧迁移的行为。
- 名称描述变更。 例如
add_post_content_index比update_tables清楚;文件名中的 slug 就是这类简短描述。 - 检查自动生成的脚本。
--autogenerate提供候选变更,不能替代对重命名、约束、数据回填和生产数据影响的审查。 - 说明回退能力。 可逆结构变化实现
downgrade();反向 DDL 无法恢复已丢失的数据,需说明备份恢复或向前修复方案。
文件名可用“日期 + revision ID + 描述”,便于阅读并避免同日同名冲突:
# alembic.ini 的 [alembic] 段file_template = %%(year)d-%%(month).2d-%%(day).2d_%%(rev)s_%%(slug)s例如 2026-01-10_a1b2c3d4_add_post_content_index.py。文件名便于人阅读,迁移顺序仍由文件中的 revision / down_revision 决定,不按日期排序。Alembic 配置说明
5.4 能在查询中完成的筛选和聚合,尽量交给数据库#
筛选、分页、连接和聚合通常适合在数据库完成,避免先把大量记录拉到 Python。但 SQL 负责查询,Pydantic 负责数据结构与接口约定,业务规则仍应明确归属;数据库端 JSON 拼装也要权衡性能、可读性和可移植性。
下面用 SQLAlchemy 2.x 同步 Session 查询带作者信息的文章列表。代码从项目 ORM 模型的 __table__ 取得 Table,字段需匹配实际表结构。json_build_object 构造作者对象,是 PostgreSQL 专用写法,不能直接用于 SQLite 或 MySQL。
from typing import Anyfrom uuid import UUID
from sqlalchemy import func, selectfrom sqlalchemy.orm import Session
from src.app.modules.posts.models import Post as PostModelfrom src.app.modules.profiles.models import Profile as ProfileModel
posts = PostModel.__table__profiles = ProfileModel.__table__

def get_posts( db: Session, creator_id: UUID, *, limit: int = 10, offset: int = 0) -> list[dict[str, Any]]: query = ( select( posts.c.id, posts.c.slug, posts.c.title, func.json_build_object( "id", profiles.c.id, "first_name", profiles.c.first_name, "last_name", profiles.c.last_name, "username", profiles.c.username, ).label("creator"), ) .select_from(posts.join(profiles, posts.c.creator_id == profiles.c.id)) .where(posts.c.creator_id == creator_id) .order_by( func.coalesce( posts.c.updated_at, posts.c.published_at, posts.c.created_at ).desc(), posts.c.id.desc(), # 时间相同时,提供稳定的次级顺序 ) .limit(limit) .offset(offset) ) return [dict(row) for row in db.execute(query).mappings().all()]from uuid import UUID
from pydantic import BaseModel
class Creator(BaseModel): id: UUID first_name: str last_name: str username: str
class PostResponse(BaseModel): id: UUID slug: str title: str creator: Creatorfrom typing import Annotatedfrom uuid import UUID
from fastapi import APIRouter, Depends, Queryfrom sqlalchemy.orm import Session
from src.app.core.database import get_dbfrom src.app.modules.posts import servicefrom src.app.modules.posts.schemas import PostResponse
router = APIRouter()
@router.get("/creators/{creator_id}/posts", response_model=list[PostResponse])def get_creator_posts( creator_id: UUID, db: Annotated[Session, Depends(get_db)], limit: Annotated[int, Query(ge=1, le=100)] = 10, offset: Annotated[int, Query(ge=0)] = 0,): return service.get_posts(db, creator_id, limit=limit, offset=offset)接口无记录时返回空列表;若要求创作者不存在时返回 404,需另加存在性依赖。
json_build_object 只拼装每行字段,无需 GROUP BY。一篇文章对应多条评论时可考虑 json_agg,但要注意连接后的行数和分页语义。
数据量不大时,ORM 关联加载或 Python 整理结果可能更直观;优化前先检查查询次数、索引和执行计划。使用 AsyncSession 时,需配套异步引擎、驱动、会话依赖和服务调用。参考 SQLAlchemy 查询教程与 PostgreSQL JSON 函数。
6. API 文档与接口约定#
6.1 根据环境决定文档是否公开#
文档公开范围由项目决定。下面沿用第一章配置,仅在 local、staging 开放;公开 API 也可选择在生产环境提供文档:
from fastapi import FastAPI
from src.app.core.config import get_settings
settings = get_settings()show_docs = settings.ENVIRONMENT in {"local", "staging"}
app = FastAPI(    title="My API",    version=settings.APP_VERSION,    openapi_url="/openapi.json" if show_docs else None,    docs_url="/docs" if show_docs else None,    redoc_url="/redoc" if show_docs else None,)
隐藏文档不能代替接口鉴权;生产环境的内部文档也可通过网关等方式限制访问。文档类型与开关见主笔记“自动生成的接口文档”。
6.2 让文档描述接口的实际行为#
用 response_model、status_code 声明成功响应,summary、description 解释作用与限制,tags 按业务分组,responses 描述其他响应。文档必须与实际分支一致。
下面的独立示例创建文章返回 201,标题重复返回 409;内存字典仅用于演示,不代替数据库唯一约束。
from fastapi import FastAPI, HTTPException, statusfrom pydantic import BaseModel, Field
app = FastAPI()posts_by_title: dict[str, dict] = {}

class PostCreate(BaseModel):    title: str = Field(min_length=1)

class PostResponse(BaseModel):    id: int    title: str

class ErrorResponse(BaseModel):    detail: str

@app.post(    "/posts",    response_model=PostResponse,    status_code=status.HTTP_201_CREATED,    summary="创建文章",    description="创建一篇文章;如果标题已经存在,则返回 409。",    tags=["文章"],    responses={409: {"model": ErrorResponse, "description": "标题已经存在"}},)async def create_post(data: PostCreate):    if data.title in posts_by_title:        raise HTTPException(status_code=409, detail="标题已经存在")    post = {"id": len(posts_by_title) + 1, "title": data.title}    posts_by_title[data.title] = post    return post
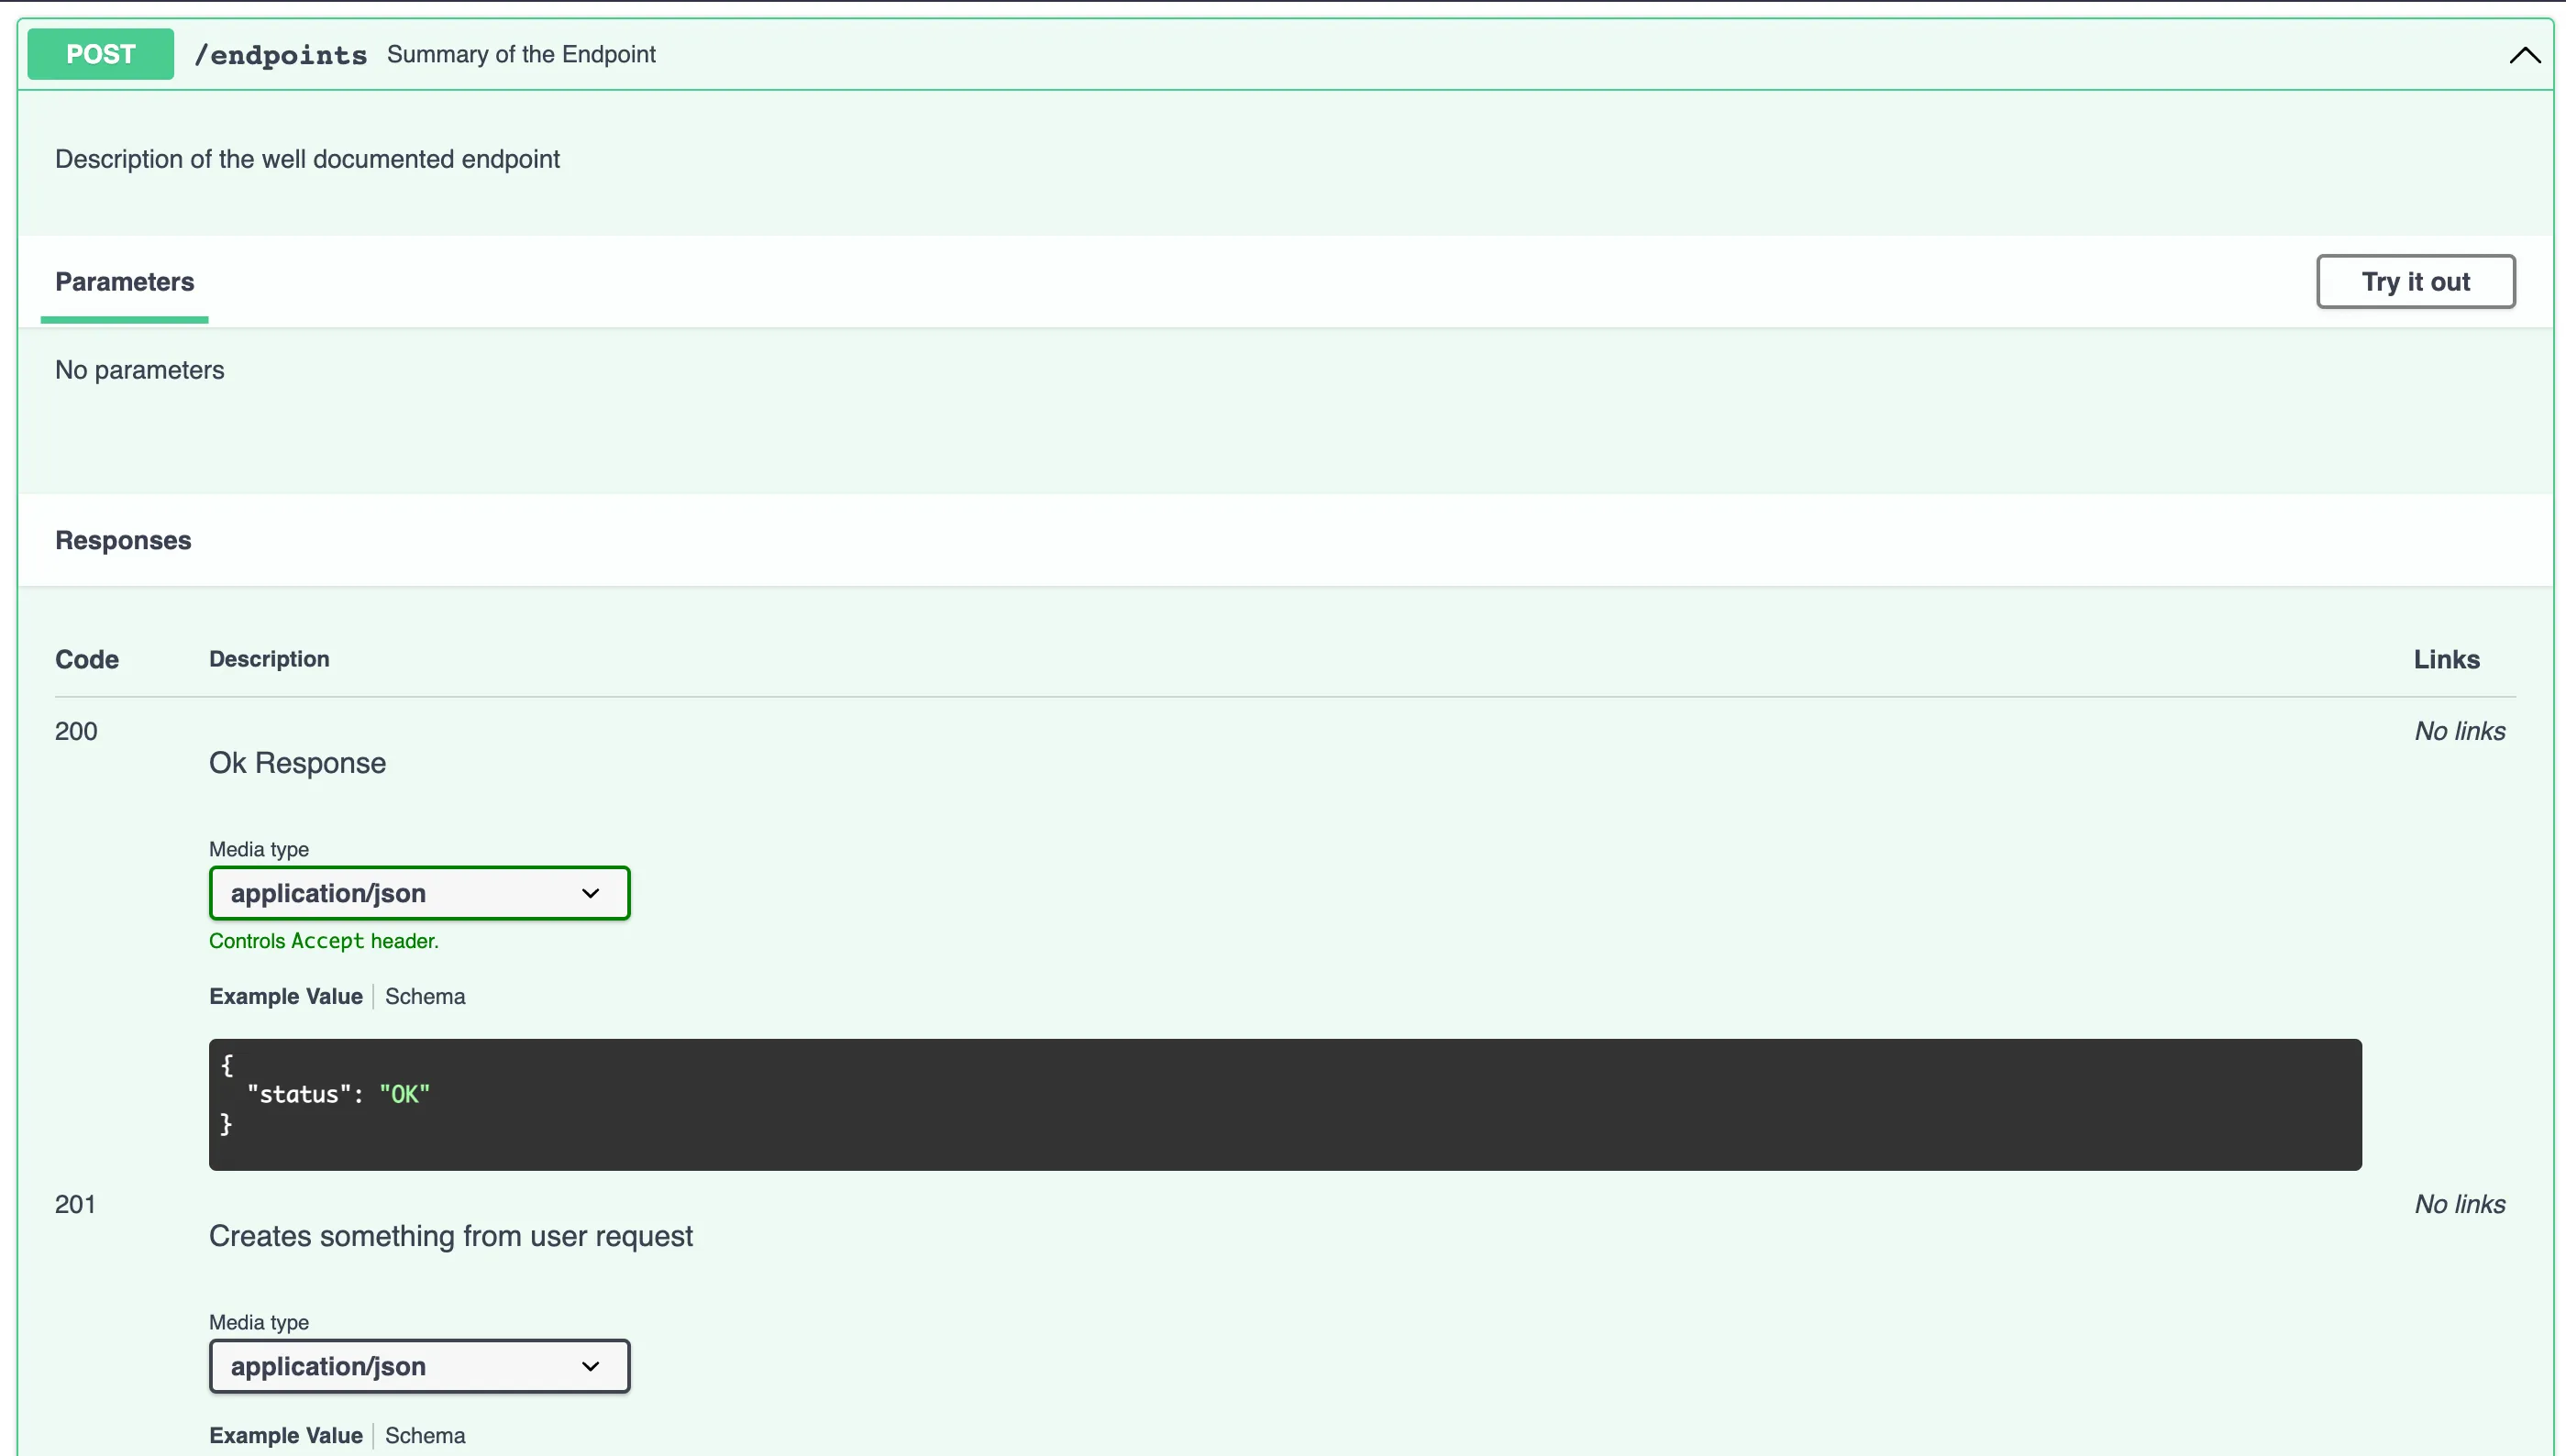
responses 只补充文档,不会实现分支、切换状态码或校验任意错误响应。上例由 HTTPException 产生 409;其他 200、202 等分支也须实际实现,并声明对应模型与状态码。FastAPI 附加响应文档
以下历史截图展示多种响应的文档布局,状态码与上例不完全对应:
7. 测试与代码质量#
7.1 根据测试需要选择客户端#
只需同步调用 HTTP 接口时可用 TestClient;测试还要 await 数据库等异步资源时,可用 httpx.AsyncClient,并让客户端、fixture 和资源生命周期配合一致。
下面的独立示例验证创建接口和输入校验,并管理应用的 lifespan。先安装开发依赖:
pip install pytest anyio httpx asgi-lifespanfrom contextlib import asynccontextmanager
from fastapi import FastAPI, Requestfrom pydantic import BaseModel, Field
@asynccontextmanagerasync def lifespan(app: FastAPI): app.state.posts = [] try: yield finally: app.state.posts.clear()
app = FastAPI(lifespan=lifespan)
class PostCreate(BaseModel): title: str = Field(min_length=1)
class PostResponse(BaseModel): id: int title: str
@app.post("/posts", response_model=PostResponse, status_code=201)async def create_post(data: PostCreate, request: Request): post = {"id": len(request.app.state.posts) + 1, "title": data.title} request.app.state.posts.append(post) return postfrom collections.abc import AsyncIterator
import pytestfrom asgi_lifespan import LifespanManagerfrom httpx import ASGITransport, AsyncClient
from demo_app import app
@pytest.fixturedef anyio_backend(): # 本例固定使用 asyncio,避免测试被自动运行到其他后端。 return "asyncio"
@pytest.fixtureasync def client(anyio_backend) -> AsyncIterator[AsyncClient]: async with LifespanManager(app) as manager: transport = ASGITransport(app=manager.app) async with AsyncClient(transport=transport, base_url="http://test") as ac: yield ac
@pytest.mark.anyioasync def test_create_post(client: AsyncClient): response = await client.post("/posts", json={"title": "Hello FastAPI"}) assert response.status_code == 201 assert response.json() == {"id": 1, "title": "Hello FastAPI"} assert app.state.posts == [{"id": 1, "title": "Hello FastAPI"}]
@pytest.mark.anyioasync def test_invalid_post_is_not_saved(client: AsyncClient): response = await client.post("/posts", json={"title": ""}) assert response.status_code == 422 assert app.state.posts == []两个文件放在同一目录,执行 pytest -q。测试同时检查状态码与数据:成功时确实保存,非法输入时没有写入。
ASGITransport 直接调用应用,不监听端口,也不自动执行启动与关闭逻辑;LifespanManager 负责请求前初始化、测试后清理。FastAPI 异步测试、HTTPX ASGI Transport
接入项目时替换 demo_app,使用独立测试数据库或事务回滚,不连接生产库。异步连接池在对应生命周期内创建、关闭,避免跨事件循环复用。已有 pytest-asyncio 的项目可沿用其 marker、fixture,避免混用自动管理方式。
7.2 用 Ruff 统一格式与检查#
Ruff 提供格式化、lint 和导入整理。将下面的最小配置合入 pyproject.toml:
[tool.ruff]target-version = "py311"
[tool.ruff.lint]select = ["E4", "E7", "E9", "F", "I"]
I 启用导入排序,formatter 不负责全部导入修复。安装开发依赖 ruff 后,本地运行:
#!/bin/sh -eset -x
ruff check --fix src testsruff format src tests
CI 中使用只检查、不修改文件的形式:
ruff check src testsruff format --check src testspre-commit 可选,简单项目用脚本和 CI 即可;避免多个 formatter 反复处理同一批文件。环境与依赖管理见 Python 笔记,Ruff 规则见官方配置文档。
评论
欢迎交流,使用 GitHub 账号登录后即可留言。
在 GitHub Discussions 中查看讨论 ↗