FastAPI 是一个用于构建 Web API 的 Python 框架。你通过函数定义接口,用类型提示描述输入和输出;框架负责路由匹配、参数验证、依赖注入,以及自动生成接口文档。
配套阅读:FastAPI 项目开发实践。学会基本用法后,可以继续阅读模块划分、业务依赖、数据库迁移、测试和代码质量等工程实践。
FastAPI、Starlette、Pydantic 与 Uvicorn 的关系#
Uvicorn:接收网络请求的服务器#
Uvicorn 是 ASGI 服务器(Server),负责监听端口、处理网络连接,把请求转换成 ASGI 标准事件,调用 FastAPI 应用,并把应用发回的响应传给客户端。
FastAPI() 创建的是应用(Application),负责定义路由、中间件、请求处理等逻辑。仅仅创建这个对象不会启动网络监听,还需要由 Uvicorn 等服务器加载并运行它。
Uvicorn 可以使用 uvloop 替代标准的 asyncio 事件循环实现,用 httptools 解析 HTTP 请求;它也有其他可用实现,具体选择取决于安装依赖、运行平台和配置。这些工具是服务器的实现选项,不是编写 FastAPI 路由时必须操作的对象。Uvicorn 配置说明
Starlette:FastAPI 复用的 Web 基础能力#
FastAPI 是基于 Starlette 构建的,许多 Web 基础能力直接来自 Starlette:
- 微框架内核:Starlette 提供路由、中间件、异常处理和请求/响应处理等组件,FastAPI 在这些能力之上继续构建。
- 异步支持:Starlette 提供 ASGI 应用能力,借助 AnyIO 支持 asyncio、Trio 等异步后端,并处理线程执行。底层服务器也必须支持所选择的异步运行环境;例如 Uvicorn 使用 asyncio 兼容的事件循环,不能由此推断它也能直接运行 Trio。
- WebSocket 与后台任务:你在 FastAPI 中使用的 WebSocket 支持和后台任务功能,其基础实现同样来源于 Starlette。
- 功能模块复用:跨域处理(
CORSMiddleware)、GZip 压缩、Session 签名等,都可以直接集成 Starlette 的对应组件。
Starlette 自身也能用来编写 Web 应用。FastAPI 在它的基础上增加了面向 API 开发的参数声明、验证、依赖注入和文档生成等能力。Starlette 能力说明
Pydantic 与 FastAPI 各自补上什么?#
FastAPI = Starlette + Pydantic + 便利功能。这个公式可以用来记忆主要关系,但不是完整的依赖清单。
Pydantic 负责根据声明的数据结构进行验证、转换和序列化。例如,你声明某个参数是整数,框架可以借助它验证输入是否合法,并在允许的情况下把字符串形式的数字转换成整数。
FastAPI 把这些能力与路由函数的类型提示结合起来,负责从请求中提取参数、组织依赖注入、调用业务函数,并根据接口声明生成 OpenAPI 文档。因此,日常开发时通常只需要声明参数、模型和业务逻辑,不必自己处理底层网络消息。
把组件放进同一条请求链路#
客户端发出 HTTP 请求 ↓Uvicorn:接收网络数据,按 ASGI 约定调用应用 ↓FastAPI 应用:复用 Starlette 的路由、中间件、请求/响应等能力 ↓提取并验证参数(Pydantic),解析依赖 ↓你的路由函数:执行业务逻辑 ↓FastAPI/Starlette 组织响应 → Uvicorn 发送 HTTP 响应 → 客户端这里的“路由函数”也叫路径操作函数或端点函数(endpoint)。它的作用是:
- 接收请求数据:FastAPI 把已经准备好的参数传给你。
- 执行业务操作:查询数据库、调用其他服务,或完成计算。
- 返回响应数据:把处理结果交给框架,最终发回客户端。
Python 提供 async/await 语法,asyncio 提供事件循环等运行能力;ASGI 则规定服务器与应用如何配合。接下来具体解释这套约定。
ASGI:服务器与应用怎样配合#
ASGI 是一套约定:规定 Python Web 服务器怎样调用应用,以及双方怎样传递请求和响应。
全称是 Asynchronous Server Gateway Interface,异步服务器网关接口。它具体规定了函数参数、数据格式和调用方式。官方规范
为什么需要这个约定?#
前面我们说:
Uvicorn 接收请求 → 交给 FastAPI 应用处理但“交给”到底怎么交?
- 调用应用的哪个函数?
- 请求路径放在哪个参数里?
- 请求正文怎么读取?
- 应用怎样把结果交回来?
如果每个服务器和框架都自己设计一套,双方就很难配合。ASGI 把这些接口统一了。
它与 HTTP 处在不同的位置:
浏览器 ── HTTP 网络请求 ──→ Uvicorn │ ASGI 调用约定 │ ▼ FastAPI 应用HTTP 规定网络上的请求和响应怎样表达;ASGI 规定服务器收到这些信息后,怎样交给 Python 应用。
它具体约定了什么?#
核心是:应用要提供一个可以这样调用的异步入口:
async def app(scope, receive, send): ...这里的 async def 表示定义一个异步函数,函数内部可以用 await 等待异步操作。现在先认识这种写法,具体执行机制会在后面的“运行机制总览”中解释。
这是服务器调用应用的底层入口,FastAPI 已经替你实现。 日常开发时,你编写的是业务路由函数,不需要给每个接口手动添加 scope、receive、send 参数。
三个参数各有职责。下面以 HTTP 请求为例;WebSocket 和生命周期交互会使用不同的 scope 内容和事件类型:
| 参数 | 可以理解成 | 里面有什么或能做什么 |
|---|---|---|
scope | 请求的基本资料 | 请求方式、路径、请求头等 |
receive | 收件口 | 读取请求正文、接收断开连接等事件 |
send | 发件口 | 交回响应状态、响应头、响应正文 |
服务器准备好这三个参数,再调用应用。接口说明
用 /hello 走一遍消息传递#
以访问 /hello、返回纯文本 Hello! 为例。下面是框架与服务器之间发生的事情,使用 FastAPI 时通常不用手写这些代码。
① Uvicorn 整理请求资料
传入的 scope 包含这些字段,下面只展示一部分:
{ "type": "http", "method": "GET", "path": "/hello", # 其他字段省略}② 应用处理请求
FastAPI 根据 /hello 找到你写的 hello() 函数,准备所需参数,再执行它。如果业务需要读取正文,框架或你的代码会调用 receive() 接收事件。例如,一个没有正文的 HTTP 请求,其请求事件可以是:
{ "type": "http.request", "body": b"", "more_body": False,}body 是这一段正文的字节数据,more_body 表示后面是否还有正文片段。上传较大的请求体时可能需要多次接收,直到 more_body 为 False;不能假定一次 receive() 就拿到了全部正文。对于不需要正文的 /hello 接口,业务函数不必主动读取它。
这里的 b"" 表示空的字节串;后面的 b"Hello!" 同样是字节串,用来表示最终要发送的内容。
③ 应用通过 send() 交回响应
ASGI 规定响应也使用特定格式的 Python 字典。例如:
# 先交回状态码和响应头await send({    "type": "http.response.start",    "status": 200,    "headers": [(b"content-type", b"text/plain")],})
# 再交回响应正文await send({    "type": "http.response.body",    "body": b"Hello!",})
Uvicorn 收到这些字典,再把它们转换成 HTTP 响应发给浏览器。这些字典是在 Python 程序内部传递的,并不是直接发给浏览器的 JSON。 HTTP 消息格式规范
为什么叫“异步”?#
因为收发数据的接口可以用 await:
event = await receive()await send(...)等待数据时,程序可以让其他任务继续执行。这种设计也允许多次收发事件,适合流式响应和 WebSocket 等场景。它不表示业务代码会自动变快,也不保证所有操作都不会阻塞。
与 WSGI 的区别#
WSGI 的全称是 Web Server Gateway Interface。它同样规定 Python Web 服务器与应用如何配合,采用同步调用接口,主要面向 HTTP 请求与响应。ASGI 使用异步调用和事件收发接口,可以表达 HTTP、WebSocket 等不同交互。ASGI 设计背景
| 接口规范 | 常见服务器或运行方式 | 常见应用或框架 |
|---|---|---|
| WSGI | Gunicorn 的 WSGI worker、uWSGI | Flask、Django 的 WSGI 应用 |
| ASGI | Uvicorn、Daphne | FastAPI、Starlette、Quart、Django 的 ASGI 应用 |
这个表用于展示常见组合,并不是说一个框架只能支持一种接口。服务器负责承载应用,应用则需要提供对应规范的入口。
传统 WSGI 同步部署中,一次请求处理会占用一个工作线程或进程,通常通过多个 worker 实现并发。ASGI 允许应用在等待 I/O 时挂起当前任务,让一个事件循环线程处理其他任务。但 ASGI 本身不会把同步数据库调用、同步休眠或 CPU 计算自动变成非阻塞操作,后面的“运行机制总览”会用“协程的诅咒”实验说明这一点。
补充:不经过网络也能调用 ASGI 应用#
因为 ASGI 约定的是 Python 调用接口,调用应用的一方也可以是测试工具。例如 HTTPX 的 ASGITransport 可以直接按这套约定调用应用,在同一进程中收发事件,不需要先启动 Uvicorn 或经过真实网络端口。HTTPX ASGITransport 说明
这类 ASGI 传输适配器适合测试接口:调用方仍然可以写类似 HTTP 客户端的请求,但底层直接调用应用。它不会自动验证真实网络、代理和端口配置;HTTPX 的这个适配器也不会自动触发应用的 lifespan,需要测试代码另行管理生命周期。
FastAPI 服务启动#
前面解释了服务器和应用怎样配合,现在把它们实际运行起来。下面使用 Python 3.11 或更新版本,建议在项目的虚拟环境里安装依赖,避免不同项目互相影响。
安装依赖与最小应用#
先安装 FastAPI 及其常用运行依赖,其中包含 FastAPI CLI 和 Uvicorn:
python -m pip install "fastapi[standard]"假设代码保存在 main.py,应用对象叫 app:
from fastapi import FastAPI
app = FastAPI()

@app.get("/hello")def hello():    return {"message": "你好"}
app = FastAPI() 创建应用;@app.get("/hello") 注册一个 GET 接口;hello() 是请求到达这个接口后执行的业务函数。这里返回字典,框架会把它转换成 JSON 响应。
先认识 def 与 async def 两种路由写法#
上面的 def hello() 定义的是普通同步函数。FastAPI 也支持异步路由:如果要把这个接口改成异步函数,可以将上面的路由定义替换为:
@app.get("/hello")async def hello(): return {"message": "你好"}两种写法都能处理 /hello 请求,并返回同样的数据。async def 允许函数内部使用 await 来等待异步操作,例如异步 HTTP 请求或数据库查询;但并不是每个异步函数都必须写 await,像上面这样直接返回结果也可以。
添加 async 不会让普通阻塞操作自动变成异步操作。两种路由的执行位置和选择方法,见下一章的实验。
开发启动与访问接口#
在 main.py 所在目录执行:
fastapi dev main.py这会以开发模式启动服务,修改代码后自动重载。也可以直接使用 Uvicorn:
uvicorn main:app --reload两种写法选择一种即可,不需要同时运行。启动后,在本机浏览器访问:
- 接口:
http://127.0.0.1:8000/hello,可以看到{"message":"你好"}。 - 自动生成的接口文档:
http://127.0.0.1:8000/docs,可以查看并试调接口。
终端会持续显示服务日志。需要关闭时按 Ctrl+C。如果修改了端口,访问地址里的端口也要随之修改。
main
Uvicorn 启动命令的基本格式是:
uvicorn <模块路径>:<应用实例名称> [选项]| 组成部分 | 示例 | 含义 |
|---|---|---|
| 模块路径 | main | Python 文件名 main.py,不带 .py 后缀;包内模块使用点分隔路径 |
| 应用实例 | app | 该模块内部创建的 FastAPI 应用对象 |
| 完整形式 | main:app | 导入 main 模块,并取出其中的 app 对象 |
main:app 可以理解为执行 from main import app。因此,Uvicorn 接收的不是 main.py 文件路径;这与 fastapi dev main.py 的命令格式不同。
| 参数 | 作用 | 示例 |
|---|---|---|
--reload | 代码变动后重新加载,适合本地开发 | uvicorn main:app --reload |
--port | 指定监听端口,默认是 8000 | uvicorn main:app --port 8001 |
--host | 指定监听地址,默认是 127.0.0.1 | uvicorn main:app --host 0.0.0.0 --port 8001 |
127.0.0.1 是本机回环地址,通常只供本机访问;0.0.0.0 表示监听所有 IPv4 网络接口,常用于容器或需要其他机器访问的场景。浏览器中仍使用 127.0.0.1、服务器实际 IP 或域名访问,而不是把 0.0.0.0 当成远程服务器的地址。
为什么 uvicorn main
对于上面这个只定义应用和路由的 main.py,直接运行 python main.py,只是执行导入、创建对象、注册函数,然后程序就结束了。它没有主动启动服务器。
python main.py导入依赖 → 创建 app → 注册路由 → 文件执行完毕 → 退出
uvicorn main:app加载 main 模块 → 取得 app → 启动服务器和事件循环                              ↓                    持续接收、处理请求,直到关闭
下面用 Uvicorn 的公开 API 演示这层关系。将它保存为与 main.py 同目录的 run_server.py,执行 python run_server.py 也能运行服务。这是行为示意,不是 Uvicorn 命令行内部源码的逐行复刻。
import asyncio
import uvicorn
from main import app

async def run_server():    config = uvicorn.Config(app, host="127.0.0.1", port=8000)    server = uvicorn.Server(config)    await server.serve()

if __name__ == "__main__":    asyncio.run(run_server())
asyncio.run() 负责运行事件循环,server.serve() 负责服务器的运行流程。主程序等待服务器结束,所以不会执行几行代码就退出;等待期间,事件循环仍然可以调度请求任务,这里等待的是服务器的异步运行过程,并不是用同步休眠占住事件循环线程。
部署启动与开发启动的区别#
部署运行时,不开启热重载:
fastapi run main.py对应的基本 Uvicorn 写法:
uvicorn main:app --host 0.0.0.0 --port 8000fastapi dev 面向开发,默认启用重载并监听本机;fastapi run 面向部署,默认不启用重载并监听所有网络接口。直接使用 Uvicorn 时,由命令中的参数决定这些行为。FastAPI CLI 说明
这里先掌握“怎样把服务跑起来”。实际部署还涉及进程管理、反向代理、容器和网络配置,后面的 Docker 部署章节会继续展开。
运行机制总览:Python 协程与 FastAPI#
请求怎样进入事件循环?#
请求通过 ASGI 进入应用后,同步函数和异步函数分别怎样执行?先从运行它们的机制看起。
先区分三个概念:
- 协程:可以在执行过程中暂停、之后再继续的计算过程。调用 Python 的
async def函数会得到协程对象;它需要被await或交给任务调度,函数体才会执行。 - 事件循环:安排异步任务执行的调度机制。某个任务等待网络、定时器等操作时,事件循环可以转去处理其他已就绪的任务。
- 线程池:用一组工作线程执行同步任务,让这些任务不必占住事件循环所在的线程。
在常见的 Uvicorn 运行方式下,每个服务进程有自己的事件循环。网络请求进来时,服务器会创建任务来调用 FastAPI 应用;应用再找到对应的路由函数。对于 async def 路由,业务代码也在这个事件循环所在的线程上执行。
这种方式相对于“每个请求单独占用一个线程”有很大优势:当大量请求主要在等待 I/O 时,协程可以在等待期间让出执行机会,不必为每个请求都创建一个线程。协程开销通常更小,但实际并发能力还会受数据库连接、内存、下游服务等资源限制。
“协程的诅咒”:为什么一个接口会阻塞其他请求?#
然而这正是所谓协程诅咒的来源。同一个事件循环中的任务共享执行线程,一旦某个任务长时间运行而不让出执行机会,其他请求就无法在这个事件循环上继续处理。
原解析用两个接口演示这个问题:其中一个接口故意用同步 sleep 模拟耗时操作,长达 10 秒。当客户端请求 square 的同时再请求 hello,会发现 hello 也被阻塞,直到 square 的阻塞操作结束才有机会响应。
下面是一份可以用于对比的最小示例,保存为 concurrency_demo.py。其中 /square 是刻意保留的错误写法:
import asyncioimport time
from fastapi import FastAPI
app = FastAPI()

@app.get("/hello")async def hello():    return {"message": "Hello"}

@app.get("/square")async def square(n: int = 2):    time.sleep(10)  # 同步阻塞:占住事件循环所在的线程    return {"result": n * n}

@app.get("/square-sync")def square_sync(n: int = 2):    time.sleep(10)  # 普通 def 路由由框架放到工作线程执行    return {"result": n * n}

@app.get("/square-async")async def square_async(n: int = 2):    await asyncio.sleep(10)  # 异步等待:暂停当前任务,让其他任务执行    return {"result": n * n}
按照前面“FastAPI 服务启动”一章安装好依赖后,可用 uvicorn concurrency_demo:app 启动这个示例。这里使用单个服务进程,便于观察共享事件循环的影响。
在一个终端请求 http://127.0.0.1:8000/square,在它等待期间,用另一个终端请求 http://127.0.0.1:8000/hello,就能观察阻塞。再分别换成 /square-sync 和 /square-async 做同样的对比。
注意,三个 square 接口本身都需要等待约 10 秒。后两种写法的意义是让其他请求能在这段时间内继续处理,并没有让这 10 秒的任务本身消失。
普通 def 路由为什么会在线程池执行?#
FastAPI 判断路由函数是同步函数还是异步函数:异步函数直接 await 执行,同步函数通过 Starlette 提供的线程池工具执行;这条同步调用路径底层使用的是 anyio.to_thread.run_sync。把同步路由放进线程池的是应用框架这一层。FastAPI 同步与异步说明、Starlette 线程池说明
一个 Uvicorn 服务进程 │ ├── 事件循环线程 │ ├── 请求 1:async def → await I/O → 等待期间让其他任务执行 │ ├── 请求 2:def → 框架提交到工作线程,并异步等待结果 │ └── 请求 3:async def → 继续处理 │ └── 工作线程池 └── 执行请求 2 的同步路由 → 完成后把结果交回默认的线程容量限制器有 40 个令牌。可以理解成:使用这项限制器的同步任务最多同时占用 40 个工作线程,其余任务需要等待名额。同步路由、同步依赖以及部分文件和后台任务操作会共享这项容量,因此它不是“每个接口各有 40 个线程”。
还要区分框架调用的函数和你自己直接调用的函数。同步路由、同步依赖可以由框架安排到线程池;但你在 async def 里直接调用一个普通工具函数,它仍然在当前线程执行,不会仅仅因为写成了 def 就自动进入线程池。普通工具函数的调用规则
async def、def 和后台任务怎样选择?#
| 业务中的主要操作 | 常见选择 | 原因 |
|---|---|---|
| 异步数据库查询、异步 HTTP 调用 | async def 配合 await | 等待 I/O 时可以让其他任务继续执行 |
| 只有同步接口的数据库或 HTTP 客户端 | def 路由 | 让框架把同步路由放进线程池 |
| 异步流程中混入一个阻塞调用 | 使用 run_in_threadpool 等工具显式交给线程池 | 避免直接占住事件循环线程 |
| 大量 CPU 计算 | 考虑进程池、独立计算服务或任务队列 | 单靠 async def 不会让计算自动并行 |
协程调度是协作式的:代码必须执行到能够真正挂起的等待点,事件循环才有机会调度其他任务。写了 await 不代表一定会切换任务,如果等待的操作立即完成,代码可能继续往下运行;普通生成器的 yield 也不能等同于把控制权交给事件循环。
这与操作系统调度线程不同:操作系统可以抢占线程。线程池能移走同步阻塞调用,但也不保证计算密集型任务完全不影响其他请求;在常见启用 GIL 的 CPython 中,多个线程执行纯 Python 计算还会竞争解释器锁。因此,不宜把“改成 def”当成重计算任务的通用解决方案。
在异步路由中调用同步 SDK#
如果一个路由大部分操作都是异步的,只有某个外部 SDK 提供同步接口,可以把这一段阻塞调用显式交给线程池,不必把整个路由改成 def。
下面用 time.sleep 模拟同步 SDK 的网络等待,保存为 main.py 后即可运行:
import time
from fastapi import FastAPIfrom fastapi.concurrency import run_in_threadpool
app = FastAPI()

def call_sync_sdk(item_id: int) -> dict:    time.sleep(1)  # 模拟同步 SDK 的阻塞等待    return {"item_id": item_id, "status": "ready"}

@app.get("/sdk/items/{item_id}")async def read_sdk_item(item_id: int):    # 传入函数本身和参数;不要先写 call_sync_sdk(item_id)。    result = await run_in_threadpool(call_sync_sdk, item_id)    return result
await run_in_threadpool(...) 等待的是工作线程的结果;等待期间,事件循环可以继续处理其他任务。如果写成 run_in_threadpool(call_sync_sdk(item_id)),就会先在当前线程执行阻塞函数,失去转交线程池的意义。
接入真实 SDK 时,还要配置其网络超时、管理客户端的关闭,并确认客户端是否支持跨线程使用。线程池有容量上限,也不会自动把纯 Python 的重计算变成并行计算。项目中的选择规则见开发实践指南的异步调用章节。
FastAPI 处理一次请求的完整流程#
下面把前面的组件与运行机制串成一次 HTTP JSON 请求的完整流程。文件下载、流式响应和 WebSocket 的收发细节有所不同。
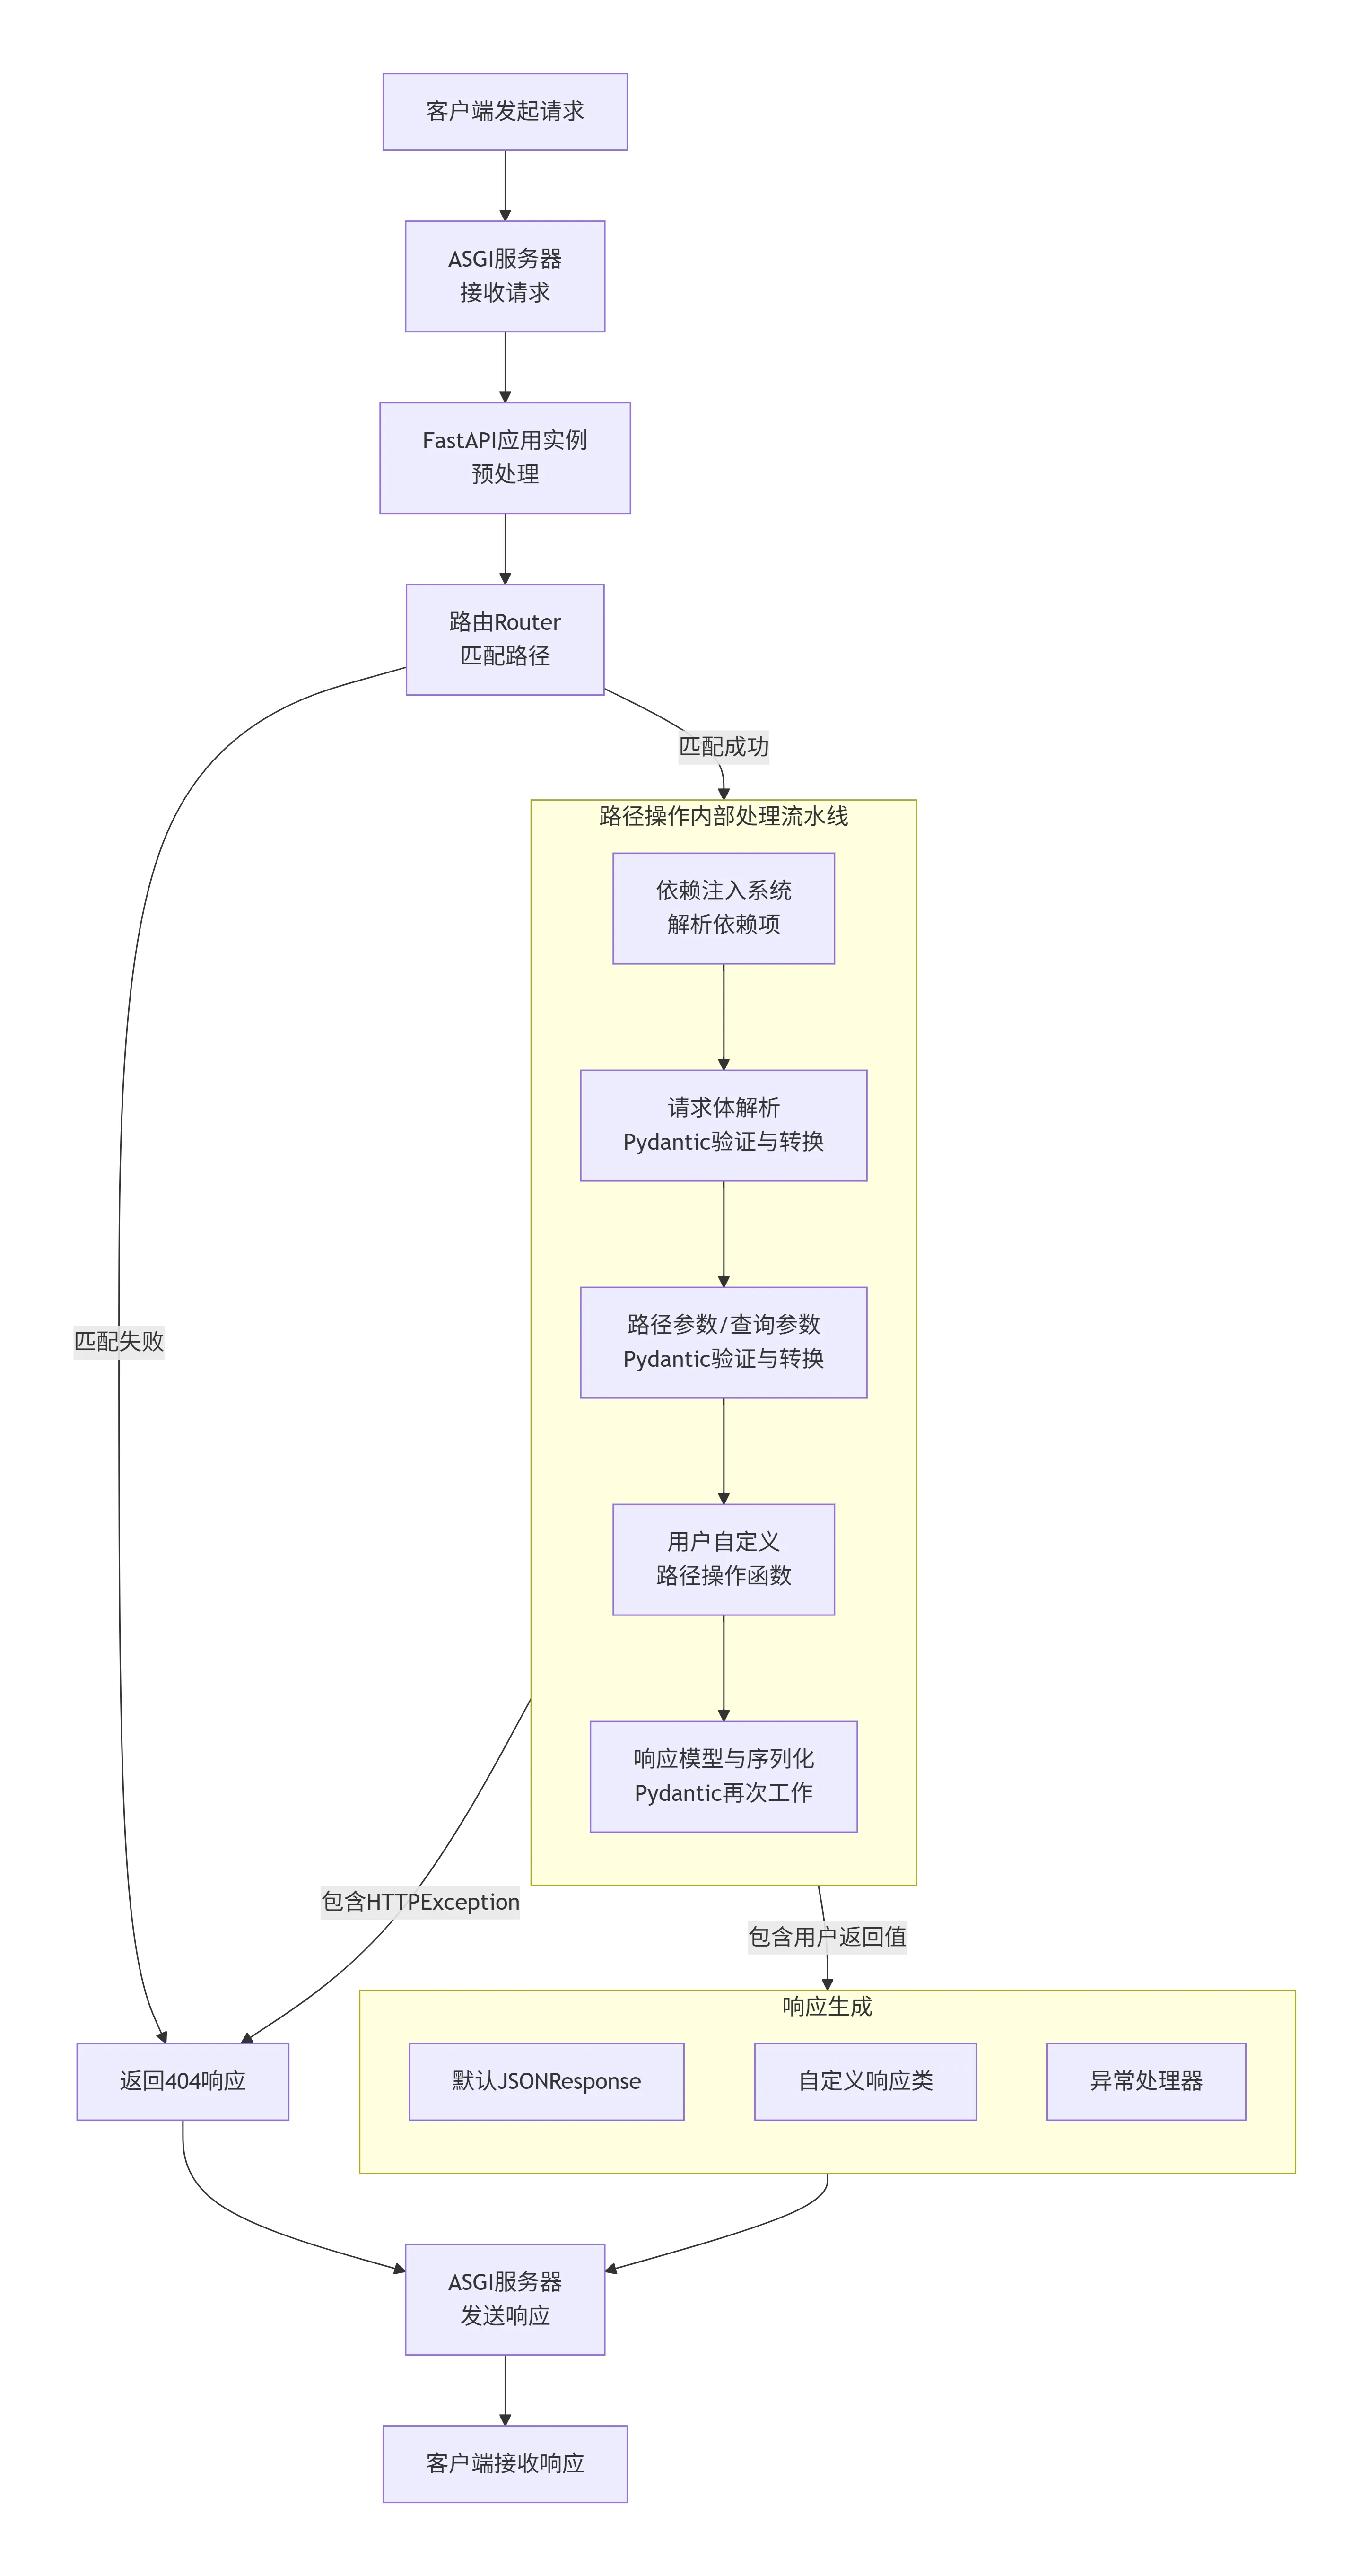
flowchart TD A[客户端发出 HTTP 请求] --> B[Uvicorn 接收请求] B --> C[按 ASGI 约定调用 FastAPI 应用] C --> D[经过中间件并匹配路由] D -->|匹配成功| E[按接口声明读取和解析请求体] D -->|路径不存在或方法不匹配| X[404 或 405 响应] E --> F[提取与验证参数、解析依赖] F --> G[执行路由函数] G --> H[按响应声明验证、过滤和序列化结果] H --> I[响应经中间件返回] X --> I E -->|请求验证失败| V[默认 422 响应] F -->|请求验证失败| V F -->|HTTPException| Q[按指定状态码生成错误响应] G -->|HTTPException| Q V --> I Q --> I I --> J[通过 ASGI send 交回 Uvicorn] J --> K[发送 HTTP 响应给客户端]阶段一:请求接收与预处理(ASGI 服务器与 FastAPI 应用)#
ASGI 服务器接收请求。 流程开始于 Uvicorn 等服务器:它监听网络端口,接收客户端的 HTTP 请求,并整理出 scope,其中包含请求的方法、路径、请求头等基本信息;请求正文则通过 receive 事件读取。
FastAPI 应用实例接管。 服务器调用 FastAPI 应用实例,将 scope、receive 和 send 传递给它。请求进入应用的中间件栈;中间件可以做日志、跨域处理等工作,也可以提前返回响应。
进入对应的 HTTP 路由处理时,框架会使用 Starlette 的 Request 对象封装请求信息。它让应用可以通过 request.url、request.headers、await request.body() 等接口操作请求,不必手写 ASGI 事件处理。
阶段二:路由匹配#
路由器根据请求的 URL 路径和 HTTP 方法,在注册的路径操作中查找匹配项。例如,GET /items/123 可以匹配 @app.get("/items/{item_id}"),并提取出路径中的 123。
- 找不到对应路径:通常返回
404 Not Found。 - 路径存在,但不支持这个 HTTP 方法:通常返回
405 Method Not Allowed。 - 匹配成功:进入该路径操作的参数准备、依赖处理和业务执行流程。
FastAPI 的 APIRouter 用于组织这些路由;业务模块可以各自注册接口,再通过 include_router() 汇总到主应用。
阶段三:读取请求数据、验证参数与解析依赖#
这一步的目标是:在调用业务函数之前,把它需要的参数和依赖结果准备好。
读取和解析请求体。 如果接口声明了请求体参数,FastAPI 会按声明读取正文,并按请求格式解析 JSON 或表单等数据。读取正文可以异步等待;JSON 解析、类型转换和验证本身仍需要执行计算,并不是所有步骤都会自动进入线程池。没有声明需要请求体的普通接口,也不必先把正文全部解析一遍。
提取参数并验证。 FastAPI 根据函数参数的声明,从路径、查询字符串、请求头、Cookie 或请求体中取值,使用相应的类型和约束进行验证与转换:
- 路径参数和查询参数:如
item_id: int、skip: int = 0。路径中的"123"可以转换成整数123;"abc"则不能转换成整数。 - 请求体模型:如果声明了 Pydantic 模型,会检查字段是否缺失、类型和约束是否满足。在允许转换的模式下,输入也可能转换成模型要求的类型。
- 验证失败:框架会产生请求验证错误,默认返回包含错误详情的 422 响应,业务路由函数不会执行。
解析依赖项。 依赖项是通过 Depends(...) 等方式声明的辅助逻辑,例如取得数据库会话、识别当前用户。依赖函数也可能有自己的参数和子依赖:框架会先准备它需要的数据,再调用它,并把返回值注入需要它的位置。如果依赖抛出 HTTPException,会中断正常处理,转入异常响应流程。
这里不能机械地理解成“所有依赖执行完 → 才验证所有参数”。参数验证和依赖求解相互关联:依赖自己的参数需要先验证,另一些依赖可能已执行后,才发现路由参数有误。对常见声明请求体的接口,读取和解析正文通常发生在依赖求解之前。请求处理实现参考
阶段四:执行用户代码与处理响应模型#
执行路径操作函数。 现在,参数已经准备就绪:经过验证和转换的路径、查询、请求体数据,以及依赖项的返回值。FastAPI 用这些参数调用你编写的函数。
函数可以是普通的同步函数,也可以是 async def 异步函数。框架会按前面“运行机制总览”介绍的规则执行:异步路由在事件循环上运行,同步路由交给线程池。你在函数中完成数据库操作、外部服务调用或其他业务逻辑,然后返回结果。
处理响应模型。 如果通过 response_model 或有效的返回类型注解声明了响应模型,FastAPI 会对返回数据进行验证、转换、字段过滤和序列化。例如,用户对象中可能有密码哈希,而公开响应模型只声明了用户名,响应就可以只保留模型允许公开的字段。
如果返回数据不能满足响应模型,属于服务端实现与接口声明不一致,默认作为服务端错误处理,通常返回 500;不能把它与客户端输入不合法时的 422 混为一谈。响应模型说明
如果你直接返回 Response 或其子类实例,框架会使用这个响应,不再按通常的路径做响应模型验证和自动 JSON 转换。这适合文件、HTML、流式内容等需要自行控制响应的场景,但内容的正确性也要由你负责。
阶段五:生成并发送响应#
对于普通字典、列表等返回值,FastAPI 通常生成 JSON 响应,同时设置状态码、响应头和响应正文。序列化就是把 Python 对象转换成可以发送的 JSON 等格式;文件和流式响应则由对应的响应类处理。
响应经过相应的中间件返回时,中间件还可以添加响应头、记录处理时间等。最后,响应通过 ASGI 的 send 交回服务器,由服务器把 HTTP 响应发送给客户端。
因此,路由函数里的 return 只是把结果交给框架。它后面还可能有响应验证、序列化、中间件处理和网络发送,不能理解成 return 的那一刻浏览器就已经收到了完整响应。
错误处理贯穿始终#
在整个流程中,路由匹配、参数验证、依赖项和业务逻辑都可能产生错误。下面是默认行为,自定义异常处理器或中间件可以改变具体响应:
| 错误情况 | 默认处理 |
|---|---|
| 路径不存在 | 返回 404 |
| 路径存在,但 HTTP 方法不匹配 | 返回 405 |
| 请求参数或请求体不符合接口声明 | 返回包含验证详情的 422 |
代码主动抛出 HTTPException | 使用异常里指定的状态码和详情,如 401、403、404 |
| 响应模型验证失败或其他未处理的服务端异常 | 通常返回 500,并在服务端排查原因 |
可以使用 @app.exception_handler() 自定义特定异常的响应。这里的“请求验证错误”指 FastAPI 在请求输入处理过程中产生的错误;业务代码里自己创建模型时抛出的普通 Pydantic ValidationError,并不会因此自动变成客户端 422。
应用生命周期:lifespan#
为什么需要启动与关闭逻辑?#
前面讲的是每次请求的处理过程。但有些操作不适合每来一个请求就做一遍,例如加载机器学习模型、建立数据库连接池;还有一些资源需要在服务关闭时统一释放。
lifespan 用于组织应用启动和关闭时的逻辑:开始处理请求前准备资源,正常关闭时释放资源。 FastAPI 提供 lifespan 参数接收一个异步上下文管理器,底层对应 ASGI 的生命周期协议。官方生命周期说明
启动服务器 ↓执行 lifespan 中 yield 之前的代码:初始化资源 ↓应用准备就绪,开始处理请求 ↓收到关闭信号,进入关闭流程 ↓执行 yield 之后的清理逻辑:释放资源 ↓服务结束完整示例:初始化模型和连接池#
下面保留模型与数据库连接池的示例,用字符串模拟资源,便于直接运行。保存为 lifecycle_demo.py,使用 uvicorn lifecycle_demo:app 启动;访问 / 可以看到已初始化的值,按 Ctrl+C 后可以在终端看到清理日志。
from contextlib import asynccontextmanager
from fastapi import FastAPI
# 模拟需要初始化的资源db_pool = Nonemodel = None
@asynccontextmanagerasync def lifespan(app: FastAPI):    # ========== 启动时执行 ==========    global db_pool, model    print("Loading model...")    model = "model_weights"  # 模拟加载模型    print("Connecting to database...")    db_pool = "connection_pool"  # 模拟建立连接池    print("Startup complete!")
    try:        yield  # ========== 应用运行期间 ==========    finally:        # ========== 关闭时执行 ==========        print("Closing database pool...")        db_pool = None        print("Unloading model...")        model = None        print("Shutdown complete!")
app = FastAPI(lifespan=lifespan)
@app.get("/")async def root():    return {"model": model, "db": db_pool}
yield 前后分别何时执行?#
@asynccontextmanager 把这个包含 yield 的异步函数转换成异步上下文管理器,也就是“进入时准备、退出时清理”的结构。FastAPI(lifespan=lifespan) 告诉框架使用它管理应用生命周期,不需要你在每个接口里手动调用。
yield之前:应用启动时执行,完成后才开始正常处理请求。- 停在
yield的期间:应用处于运行阶段,可以处理很多次请求。这里并没有把每个请求传给yield。 - 退出上下文时:执行
finally中的清理逻辑。正常关闭或上下文退出异常时都会尝试清理,但强制杀进程、断电等情况不能保证执行。
示例里的资源只是字符串,所以设为 None 即可。真实数据库连接池需要调用对应库的关闭方法,模型资源也要按所用库的方式释放;如果初始化到一半就失败,还需要清理已经成功创建的部分资源。
这些资源属于当前服务进程。使用多个 worker 进程时,每个进程通常分别执行自己的生命周期,不能理解成“整台机器只初始化一次”。开发时热重载,也会触发新应用实例的初始化。
1.项目整体结构#
下面按业务模块组织项目。文件较少时不必一次创建所有目录;模块边界、跨模块导入和配置拆分见开发实践指南。
1.1 顶层目录结构#
project_root/├── src/│ └── app/ # 应用主目录│ ├── core/ # 全局核心代码(配置、数据库、依赖等)│ ├── modules/ # 业务模块目录,每个模块自成体系│ ├── main.py # FastAPI 应用入口│ └── __init__.py├── tests/ # 测试代码├── docs/ # 项目文档├── worker.py # RQ (Redis Queue) worker 入口├── Dockerfile # Docker 镜像构建文件├── docker-compose.yml # Docker Compose 配置├── pyproject.toml # uv/Poetry 依赖管理文件├── uv.lock # uv lock文件,锁定依赖版本├── alembic.ini # Alembic 配置(如用数据库迁移)├── migrations/ # Alembic 迁移脚本目录├── Makefile # 常用命令脚本├── .env.example # 环境变量示例文件├── .gitignore└── README.md1.2 app/ 目录结构#
src/app/├── core/│ ├── config.py # 配置加载与管理│ ├── database.py # 数据库连接与会话│ ├── redis.py # Redis 连接与 RQ 队列│ ├── dependencies.py # 全局依赖(如认证、权限)│ ├── exceptions.py # 自定义异常定义│ ├── handlers.py # 全局异常处理器│ ├── security.py # 安全相关工具(如密码哈希、JWT 编码解码)│ ├── logging.py # 日志配置与管理│ └── __init__.py│├── modules/│ ├── users/ # 用户模块│ │ ├── router.py # 路由定义(APIRouter)│ │ ├── service.py # 业务逻辑│ │ ├── schemas.py # Pydantic 数据模型 (请求/响应/校验)│ │ ├── models.py # SQLAlchemy ORM 数据模型 (数据库表结构)│ │ ├── crud.py # 数据库 CRUD 操作│ │ ├── tasks.py # 异步任务定义│ │ └── __init__.py│ ││ ├── products/ # 产品模块,内部结构同 users││ └── ... # 其他业务模块│├── main.py # FastAPI 应用实例与路由注册└── __init__.py1.3 按这个目录结构启动项目#
如果采用上面的目录结构,应用对象位于 src/app/main.py,就应在 project_root 目录执行:
uvicorn src.app.main:app --reload这里的 src.app.main 是 Python 模块路径,app 是 main.py 中的应用实例名称。启动参数的含义见前面的“FastAPI 服务启动”;这里仅把最小示例的导入路径换成实际项目路径。
2.项目配置与 .env 文件的使用#
不建议采用硬编码的形式将一些敏感配置信息写死在代码里,推荐使用 .env 文件统一管理配置信息。
2.1 创建 .env 文件#
在项目根目录下创建 .env 文件(xxx 需替换为你的配置信息):
# FastAPI 连接数据库的URL# docker使用#DATABASE_URL=mysql+pymysql://root:xxx@host.docker.internal:3306/cognitive_disorder?charset=utf8mb4# 本地使用DATABASE_URL=mysql+pymysql://root:xxx@localhost:3306/cognitive_disorder?charset=utf8mb4
# minio配置(若需要使用minio对象存储)MINIO_ENDPOINT=xxxMINIO_ACCESS_KEY=xxxMINIO_SECRET_KEY=xxxMINIO_SECURE=falseMINIO_BUCKET_NAME=xxx
# 若需要使用JWT验证,JWT配置SECRET_KEY="miyue"ALGORITHM=HS256ACCESS_TOKEN_EXPIRE_MINUTES=240
2.2 读取 .env 文件#
BaseSettings 继承自 Pydantic 的 BaseModel,把环境变量和 .env 中的配置解析为有类型的属性。安装后,在 config.py 中声明需要的配置:
pip install pydantic-settingsfrom pydantic_settings import BaseSettings
class Settings(BaseSettings): DATABASE_URL: str model_config = {"env_file": ".env", "case_sensitive": False, "extra": "ignore"}
settings = Settings()业务代码通过 settings.DATABASE_URL 读取配置。case_sensitive=False 表示环境变量名称不区分大小写;extra="ignore" 忽略 .env 中未声明的字段。后面使用 JWT 配置时,也要在这个类中声明对应字段。
3.路径装饰器和路由分组#
3.1路径装饰器#
路径装饰器将 HTTP 方法、URL 路径与下方的路径操作函数绑定。例如,@app.get("/") 表示 GET 请求访问根路径时调用 root():
from fastapi import FastAPI
app = FastAPI()@app.get("/")async def root():    return {"message": "Hello World"}
3.2 路由分组#
APIRouter 把同一业务模块的路由组织在一起,再注册到主应用。
a. 创建路由器#
在模块的 router.py 中,使用 APIRouter 创建路由器实例。
from fastapi import APIRouter
# 创建路由器实例router = APIRouter()
# 在路由器上定义路由@router.get("/items/")async def read_items():    return [{"name": "Item 1"}, {"name": "Item 2"}]
@router.get("/items/{item_id}")async def read_item(item_id: int):    return {"name": f"Item {item_id}", "id": item_id}
b. 在主应用中包含路由器#
其中,prefix=/api/v1 表示此路由器中的路由全都带有 /api/v1 的前缀
from fastapi import FastAPIfrom router import router  # 上一个示例保存为同目录的 router.py
app = FastAPI()
# 包含路由器app.include_router(router, prefix="/api/v1", tags=["items"])
c. 路由器参数详解#
router = APIRouter( tags=["items"], # OpenAPI 标签,用于在api文档中展示 dependencies=[], # 依赖项)4.自动生成的接口文档#
FastAPI 会根据路由、参数类型、请求模型和响应声明自动生成接口文档,方便查看接口和进行调试。服务的启动方式见前面的“FastAPI 服务启动”。
4.1 Swagger UI、ReDoc 与 OpenAPI#
按默认地址启动后,可以访问:
| 地址 | 用途 |
|---|---|
http://127.0.0.1:8000/docs | Swagger UI:查看参数、响应结构,并交互式发送请求 |
http://127.0.0.1:8000/redoc | ReDoc:以另一种布局阅读接口文档 |
http://127.0.0.1:8000/openapi.json | OpenAPI 描述:以 JSON 形式记录接口结构,供文档页面和其他工具读取 |
OpenAPI 是描述 API 的规范;Swagger UI 和 ReDoc 是展示这些描述的界面。路由中的 tags、summary,以及参数和模型的声明,都会影响最终生成的文档。
4.2 关闭自动文档入口#
如果需要关闭这些入口,在创建应用时设置:
from fastapi import FastAPI
app = FastAPI(docs_url=None, redoc_url=None, openapi_url=None)
docs_url 控制 Swagger UI,redoc_url 控制 ReDoc,openapi_url 控制 OpenAPI 描述的地址。关闭文档不会关闭业务接口,也不能代替接口本身的认证与权限控制。官方文档配置说明
5.路径与查询参数#
客户端可以在请求 url 中携带信息进行传递以查询特定数据,包含两种方式:路径参数和查询参数
5.1 路径参数#
路径参数是 url 中使用{}包裹的占位符,可以提取传递给路径操作函数。
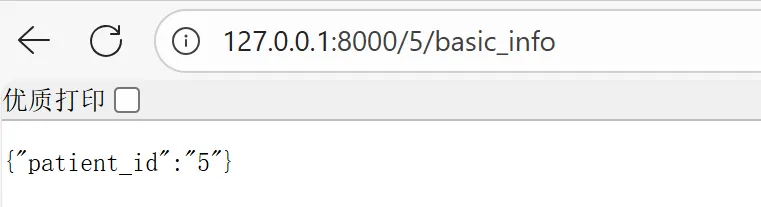
@patient_info.get("/{patient_id}/basic_info", summary="获取某一位患者基本信息")def single_basic_info(patient_id): return {"patient_id": patient_id}在路径操作函数中传入 patient_id 参数就可以获取到路由中大括号中 patient_id 的值。
其中 url 中的5便是路径参数:
5.2 查询参数#
查询参数是指 url 中?后面键值对中的值。我们直接在路径操作函数中接收即可。
@patient_info.get("/basic_info", summary="获取患者基本信息")def single_basic_info(patient_id: str): return {"patient_id": patient_id}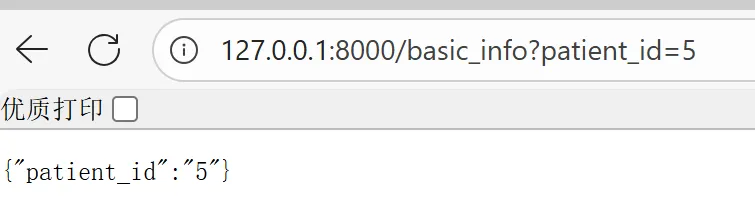
6.Pydantic 模型#
6.1 什么是 Pydantic?#
Pydantic 用带类型提示的类声明数据结构。用输入数据创建模型实例时,它会校验字段,并在规则允许时转换类型,例如把 ISO 格式的字符串转换为 datetime。
6.2 为什么在 FastAPI 中使用 Pydantic 模型?#
把模型声明为路由参数后,FastAPI 会自动验证请求体;验证失败默认返回包含错误详情的 422,成功后把模型对象传给函数。模型还参与响应序列化和 OpenAPI 文档生成,让输入输出约定集中在一处,减少重复的 if 检查。
6.3 基础使用#
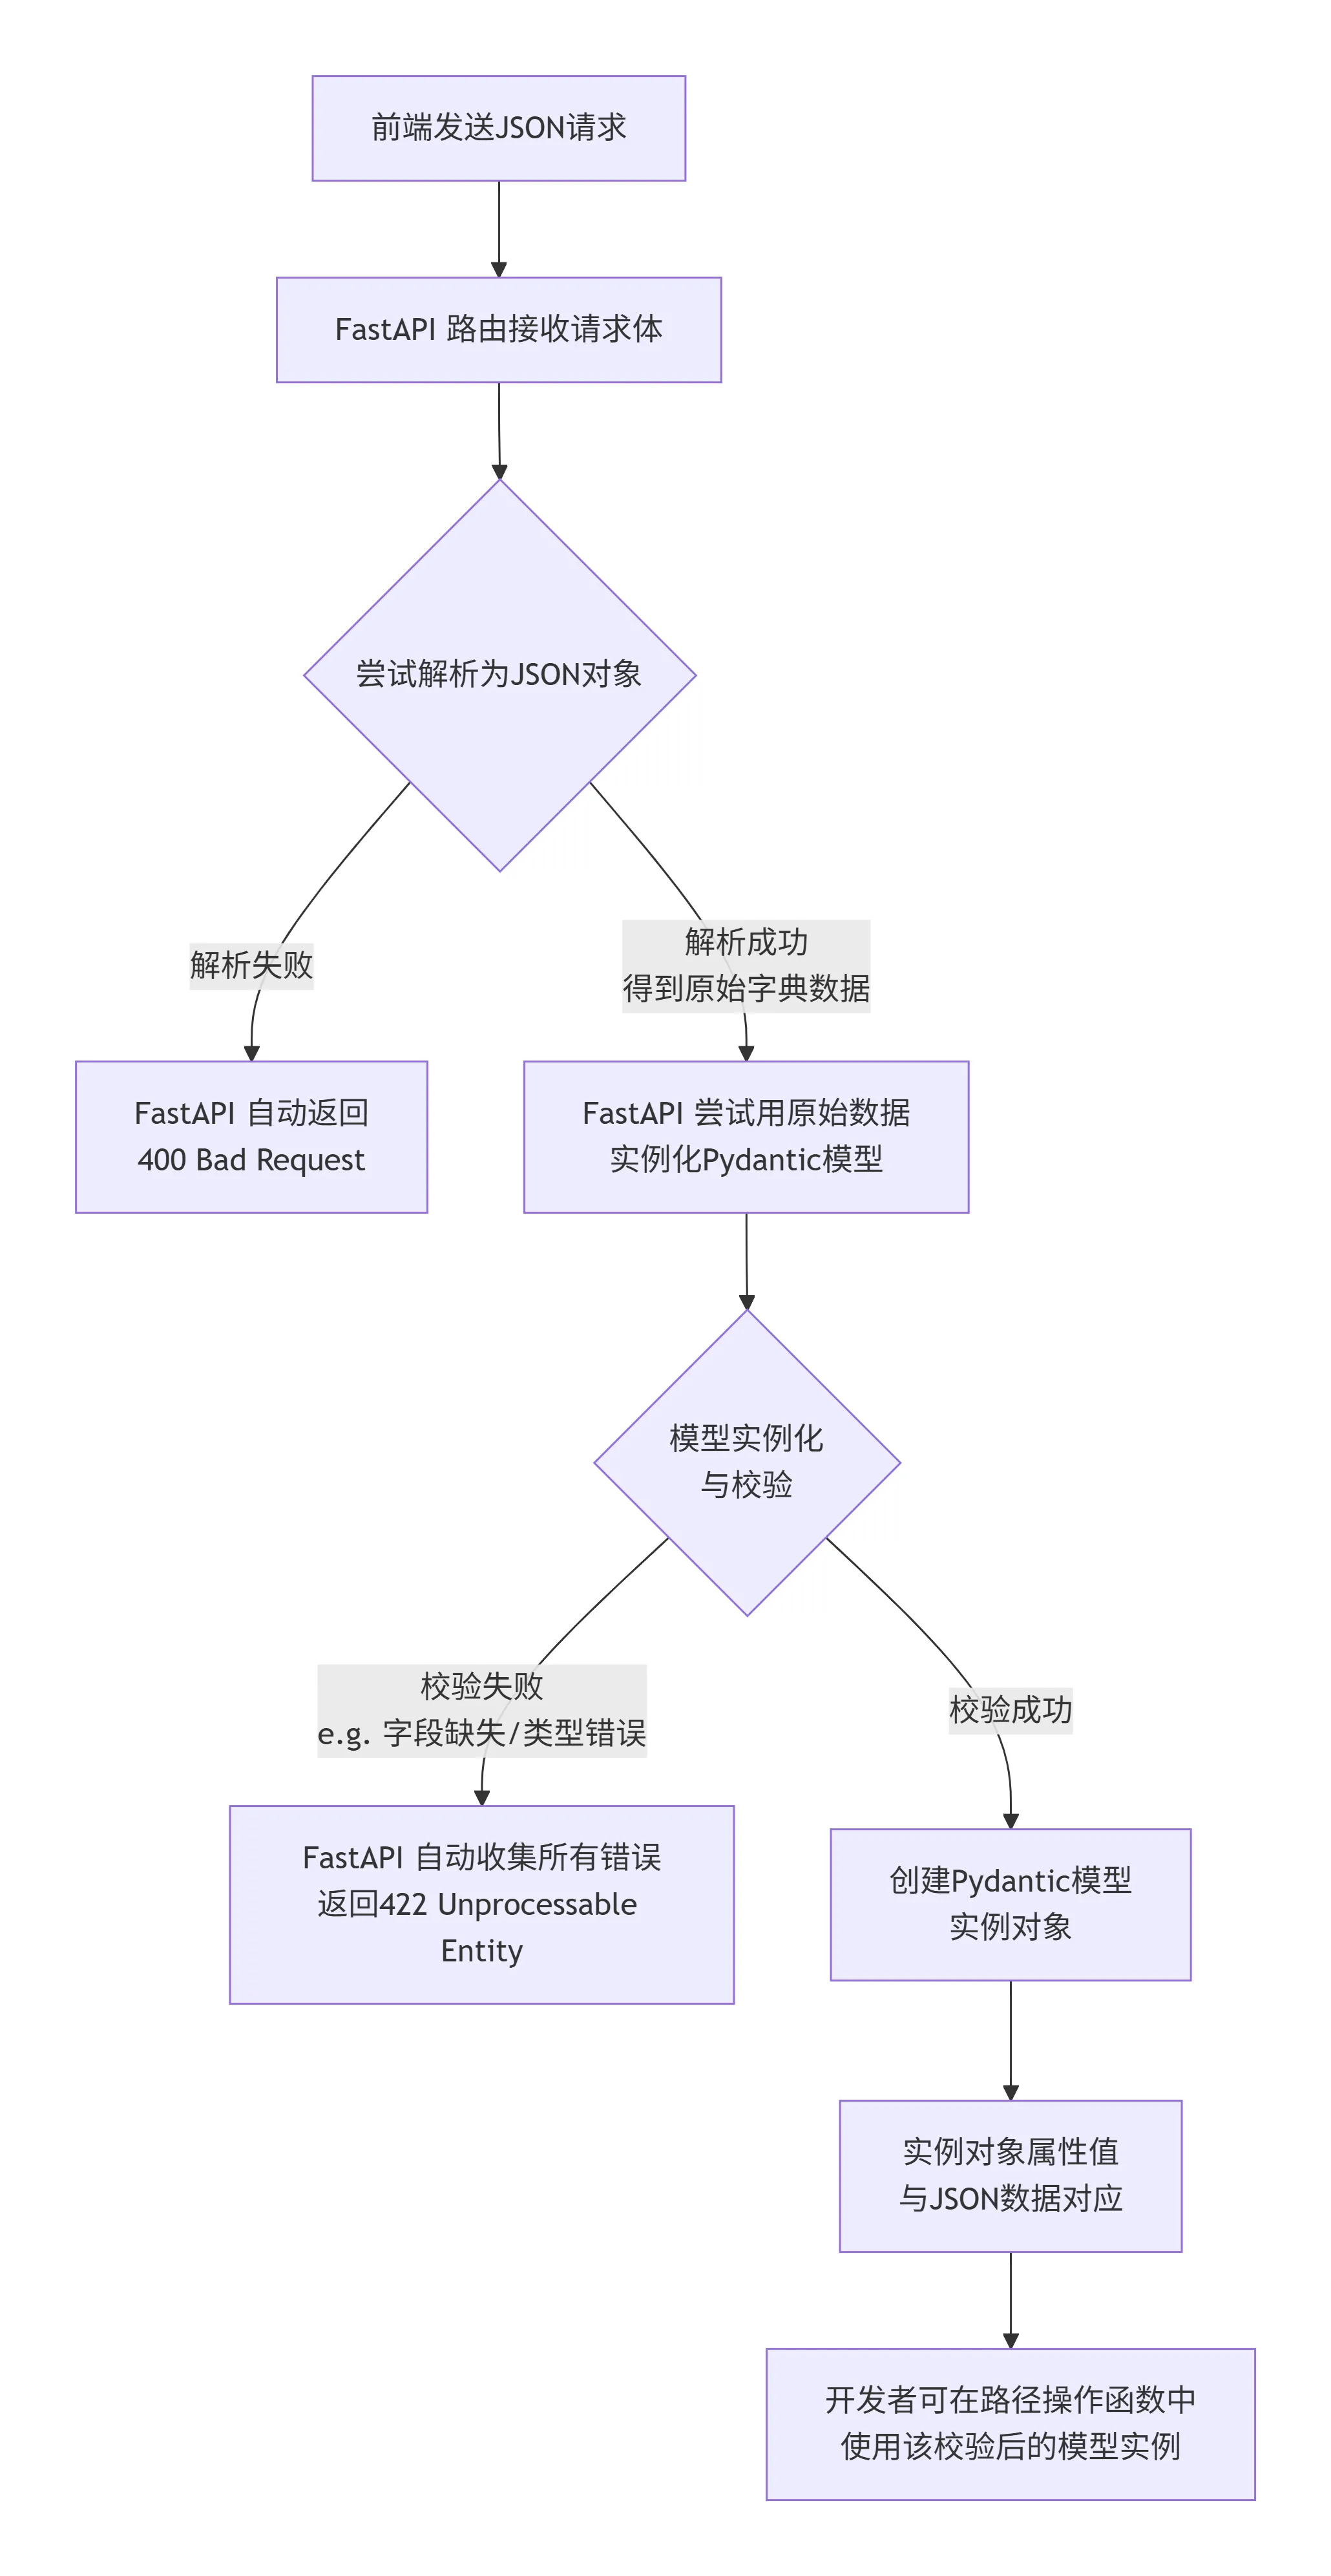
a. 接收并验证 form-data 数据#
模型通常放在 schemas.py 中。下面先用 Form 接收用户名和密码,再手动构造模型;表单字段的声明规则见“7.2 获取普通 form-data 数据”。
from pydantic import BaseModelclass LoginForm(BaseModel):    username: str    password: strfrom fastapi import FastAPI, Form
app = FastAPI()
@app.post("/login")async def login(    username: str = Form(...),    password: str = Form(...)):    # 手动创建 Pydantic 模型实例进行验证    form_data = LoginForm(username=username, password=password)    return {"message": f"Welcome {form_data.username}"}
b. 接收并验证 json 数据#
from pydantic import BaseModel
class UserSchema(BaseModel): name: str age: int friends: list[int]三个字段都没有默认值,因此必须提供。friends 是整数列表。在路由中声明模型参数:
@user.post("/user")
def create_user(data:UserSchema):   return {"username":data.name, "age":data.age, "friends":data.friends}
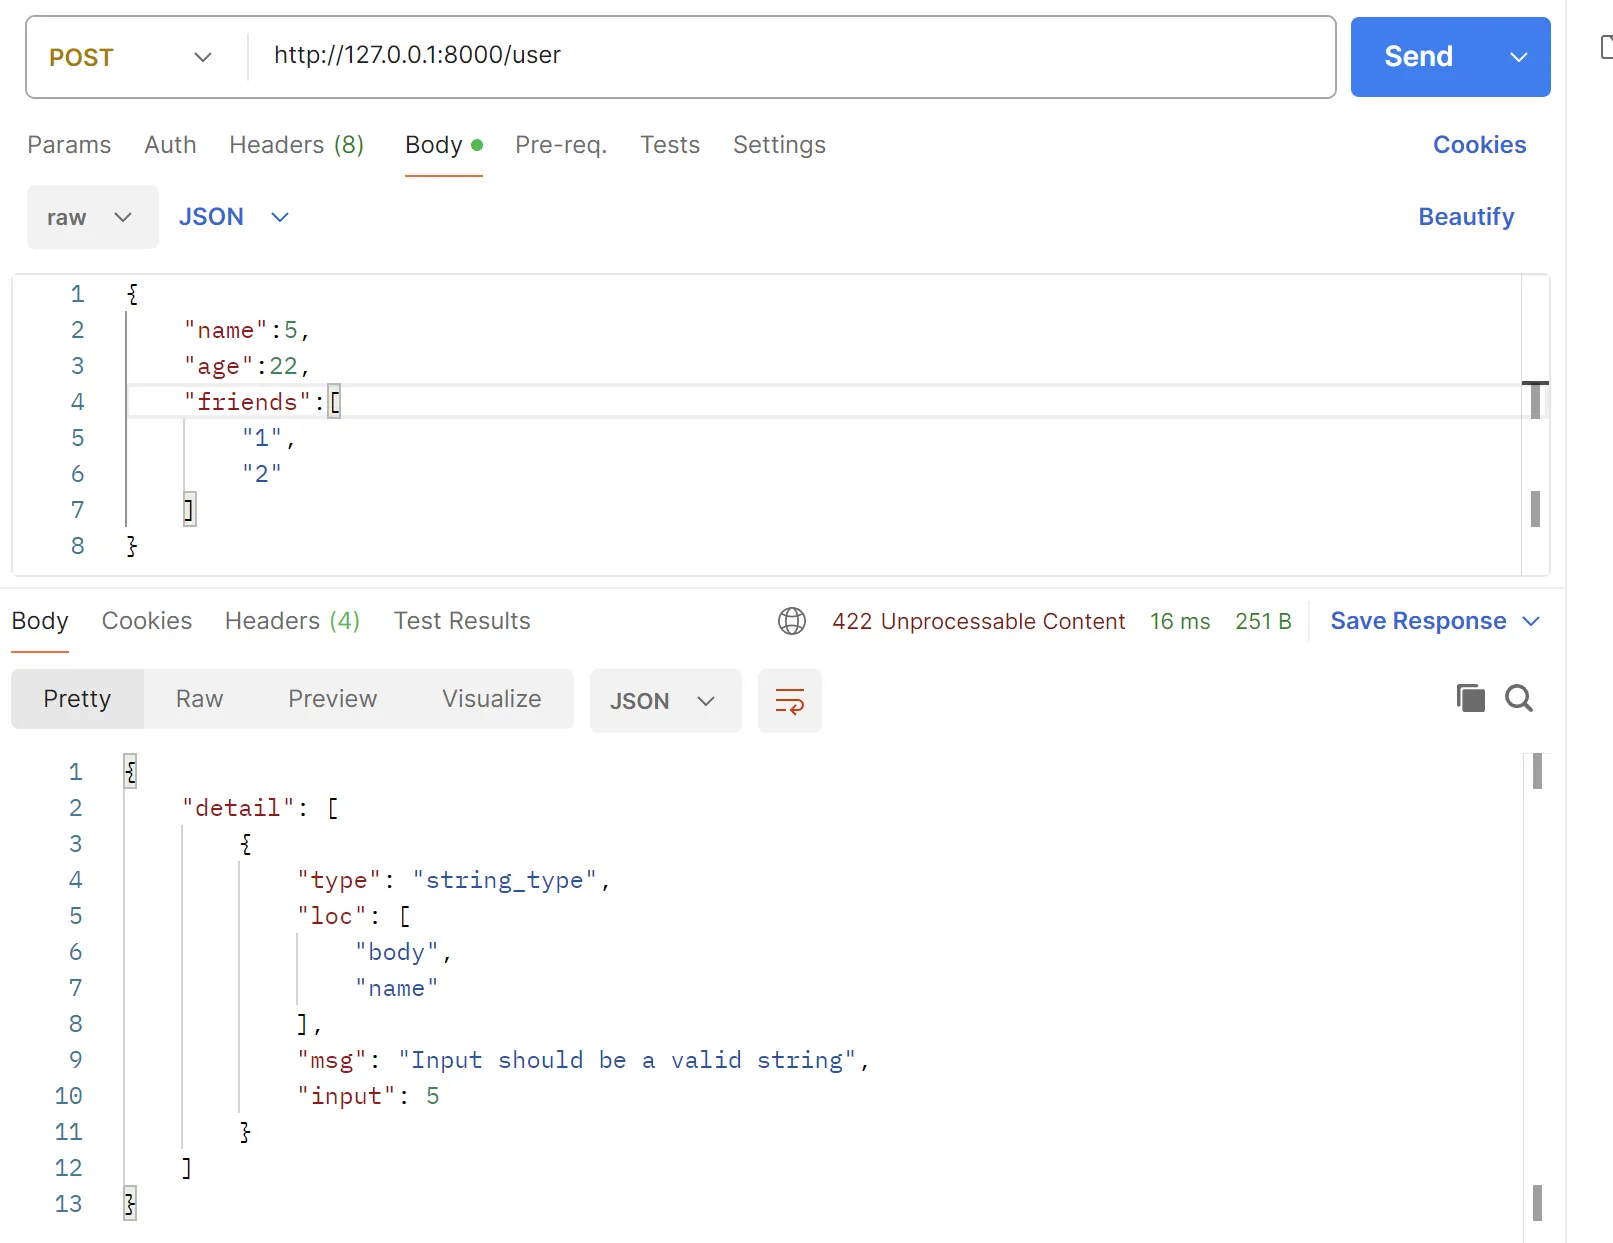
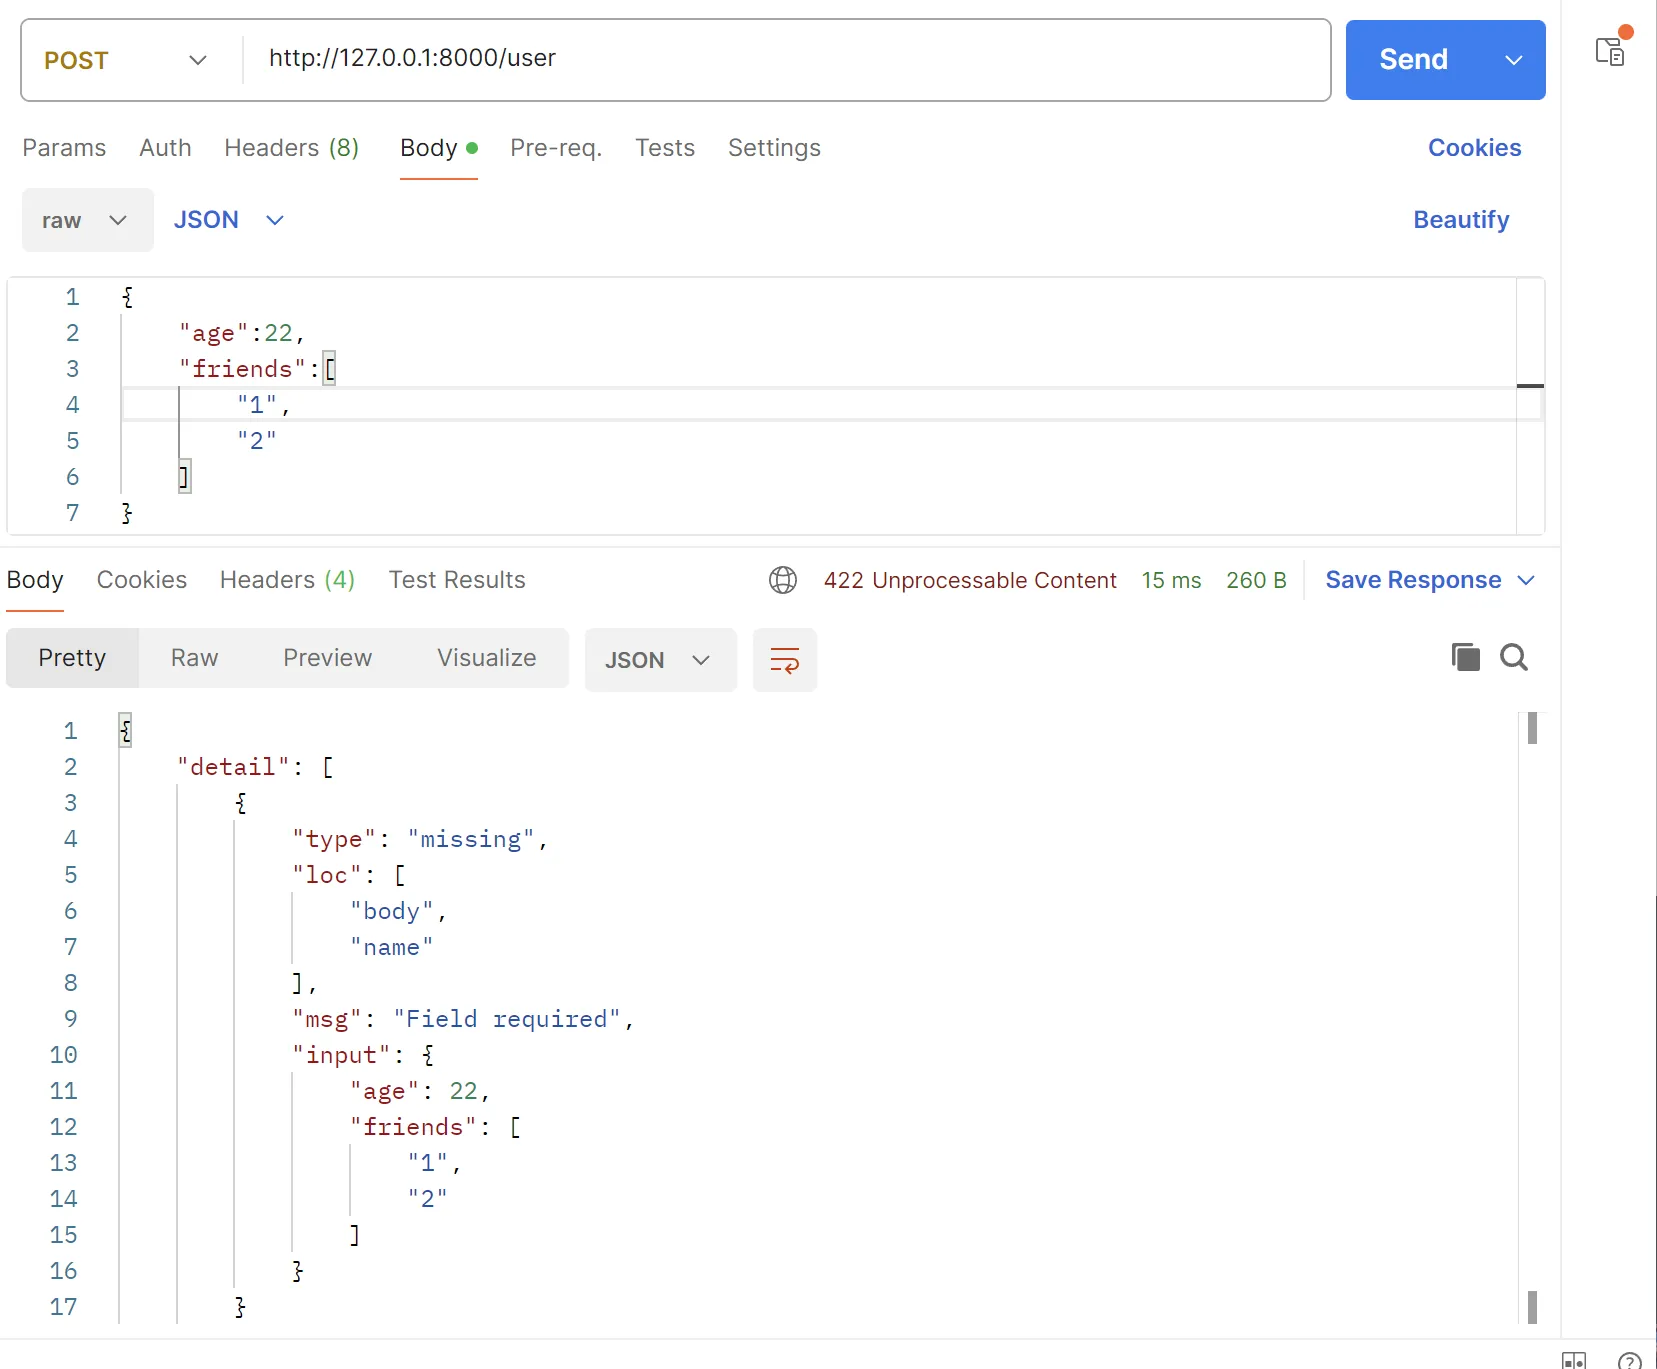
data: UserSchema 让 FastAPI 将 JSON 请求体解析为模型,函数内通过 data.name 等属性取值。下面用 Postman 对比成功、类型错误和缺少字段三种情况:
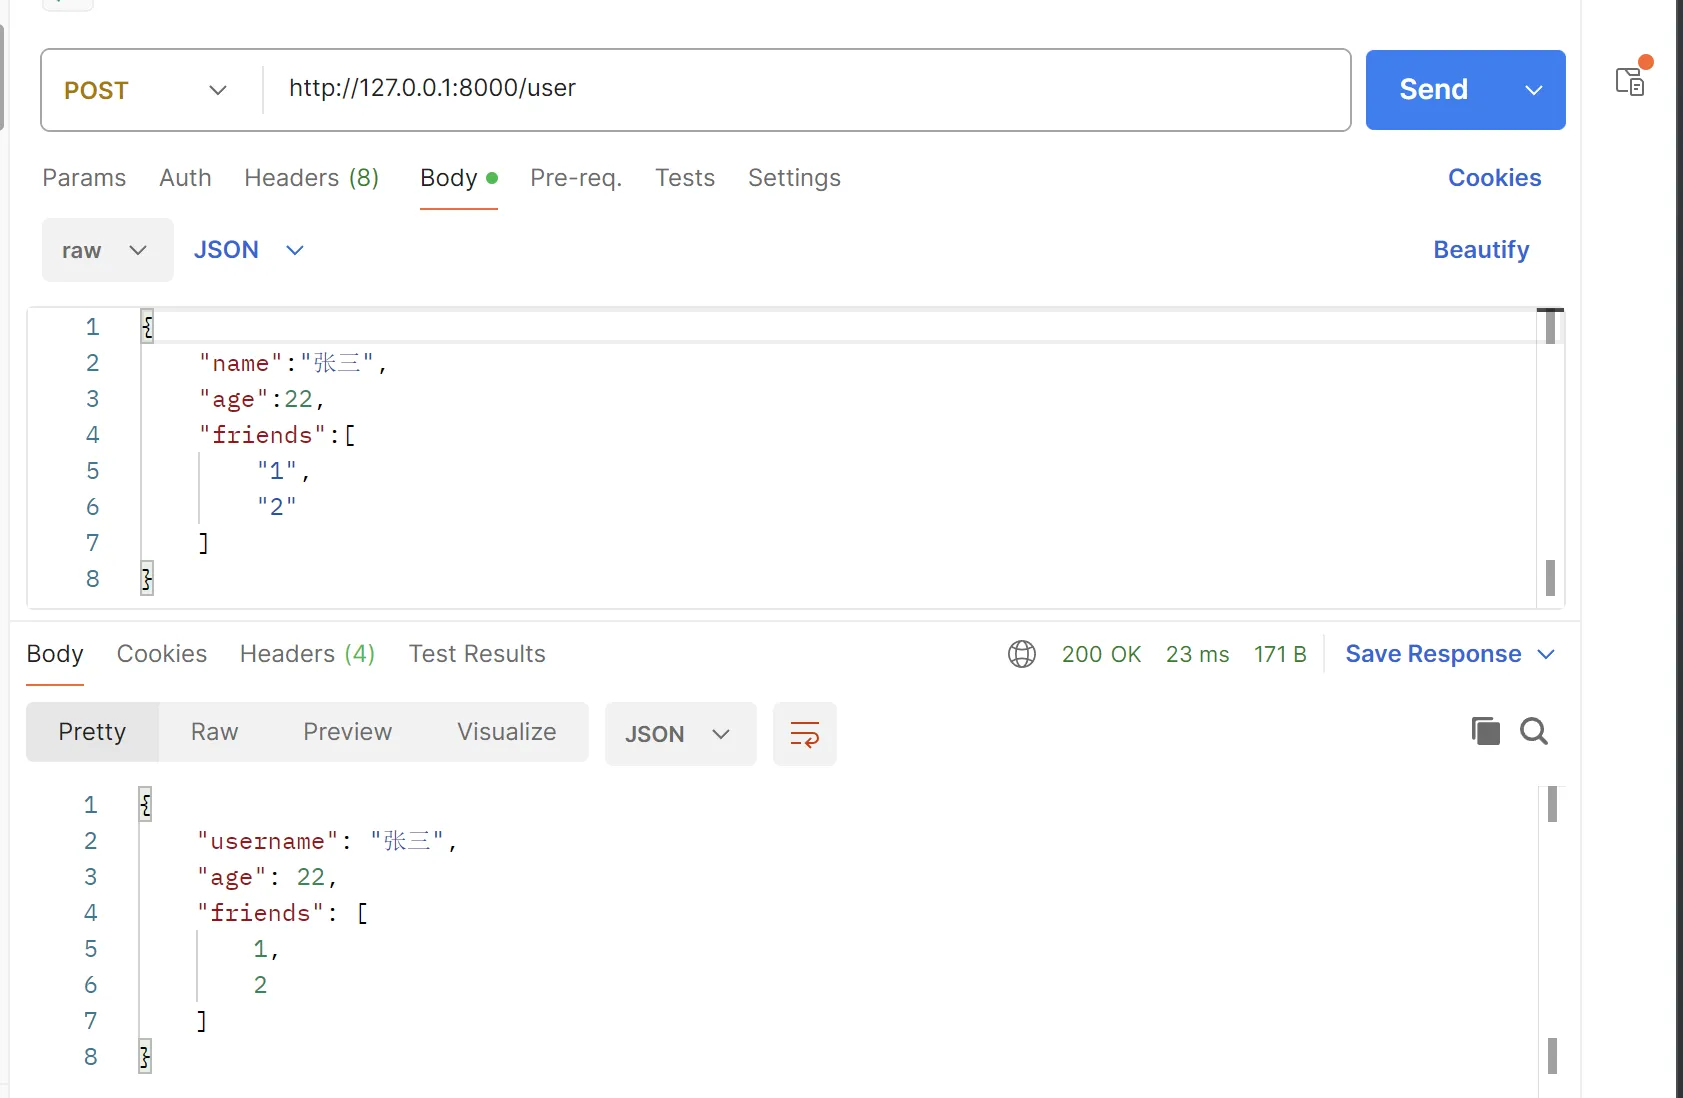
当我们发送错误数据时(将 name 的值改为数字5进行传递):
当我们缺少字段时(缺少 name 字段):
配置管理的 BaseSettings 用法见第 2 章。
6.4 Pydantic 校验类型归纳#
以下按 Pydantic 2 说明;简单约束优先通过类型提示和 Field(...) 声明。
基础标量类型
| 类型 | 描述 | 常用校验参数 |
|---|---|---|
str | 字符串 | min_length, max_length, pattern |
constr | 约束字符串 | min_length, max_length, pattern, strip_whitespace |
int | 整数 | Field(ge=..., gt=..., le=..., lt=..., multiple_of=...) |
conint | 约束整数 | ge, gt, le, lt, multiple_of |
float | 浮点数 | Field(ge=..., gt=..., le=..., lt=..., multiple_of=...) |
confloat | 约束浮点数 | ge, gt, le, lt, multiple_of |
bool | 布尔值 | 无 |
Decimal | 高精度小数 | max_digits, decimal_places |
容器类型
| 类型 | 描述 | 常用校验参数 |
|---|---|---|
List[T] | 列表 | 无 |
conlist(T) | 约束列表 | min_length, max_length |
Set[T] | 集合 | 无 |
Dict[K, V] | 字典 | 无 |
Tuple | 元组 | 无 |
Sequence[T] | 序列 | 无 |
FrozenSet[T] | 不可变集合 | 无 |
可选和默认值
| 类型 | 描述 |
|---|---|
Optional[T] | 值可为 None,能否省略取决于是否有默认值 |
T = default | 带默认值字段 |
T 或 T = Field(...) | 未提供默认值的必需字段 |
6.5 把字段约束写进模型#
Pydantic 有丰富的功能来验证和转换数据。长度、范围、格式和枚举值等规则,可以直接声明在字段上,避免在每个路由里重复写 if。
下面使用 Pydantic 2 的写法;EmailStr 还需要安装 email-validator,也可以通过 pip install 'pydantic[email]' 安装。
from enum import Enum
from pydantic import AnyUrl, BaseModel, EmailStr, Field

class MusicBand(str, Enum):    AEROSMITH = "AEROSMITH"    QUEEN = "QUEEN"    ACDC = "AC/DC"

class UserBase(BaseModel): first_name: str = Field(min_length=1, max_length=128) username: str = Field(min_length=1, max_length=128, pattern=r"^[A-Za-z0-9_-]+$") email: EmailStr age: int = Field(ge=18) favorite_band: MusicBand | None = None website: AnyUrl | None = None例如,age=17 会校验失败,favorite_band 只能是枚举中的值或 None。AnyUrl 验证 URL 的结构,并不会访问网址检查服务是否可用。类型允许 None 与字段可以省略是两回事:这里因为同时设置了 = None,后两个字段才可以不传。
6.6 自定义校验与请求错误#
内置约束不能表达的规则,可以写成 field_validator。例如,下面的密码规则只是为了演示校验器:至少 8 个字符,且包含小写字母、大写字母和数字。
from fastapi import FastAPIfrom pydantic import BaseModel, Field, field_validator
app = FastAPI()

class ProfileCreate(BaseModel):    username: str = Field(min_length=1)    password: str = Field(min_length=8)
    @field_validator("password")    @classmethod    def valid_password(cls, password: str) -> str:        if not (            any(c.islower() for c in password)            and any(c.isupper() for c in password)            and any(c.isdigit() for c in password)        ):            raise ValueError("密码必须包含小写字母、大写字母和数字")        return password

@app.post("/profiles/validate")async def validate_profile(profile: ProfileCreate):    # 这里只演示校验,不保存账号,也不把密码返回给客户端。    return {"username": profile.username}
请求体中的密码不符合规则时,Pydantic 会把校验器中的 ValueError 组织成校验错误,FastAPI 的请求校验流程再将它转换为 422 响应,错误位置包含 body 和 password。这不代表业务代码中任意位置抛出的 ValueError 都会自动返回 422;手动构造模型发生的异常也需要按所在场景处理。
格式校验适合放在模型里;“文章是否存在”“当前用户是否拥有文章”等需要查询资源的检查,见后面的“9.5 用链式依赖完成业务校验”。
7.请求数据#
7.1 Request 对象#
Request 来自 Starlette,封装 HTTP 请求信息。在路径操作函数中声明 request: Request,FastAPI 就会传入当前请求对象:
from fastapi import FastAPI, Request
app = FastAPI()
@app.get("/")async def read_root(request: Request):    return {"message": "Hello World", "root_path": request.scope.get("root_path")}
常用属性和方法如下:
| 属性或方法 | 用途 |
|---|---|
request.method | HTTP 方法,如 GET、POST |
request.url | 完整 URL 对象;可读取 .path、.query、.scheme、.hostname、.port |
request.headers | 只读的类字典请求头,例如 request.headers.get("user-agent") |
request.client | 客户端连接信息;存在时用 .host、.port 读取 IP 和端口 |
await request.body() | 读取完整请求体,返回 bytes,会占用与正文大小相应的内存 |
await request.json() | 解析 JSON 请求体,返回 dict、list 等 Python 对象 |
await request.form() | 解析 URL 编码表单或 multipart 表单,返回 FormData |
直接读取 Request 适合处理原始数据;这些数据不会自动经过你未声明的 Pydantic 参数校验。大文件优先使用下面的 UploadFile 分块读取。Starlette 请求接口
7.2 获取普通 form-data 数据#
使用 Form 参数,在函数参数中使用 xxx: 参数类型 = Form(...) 其中 xxx 是字段名,需与 form-data 中的 key 的值相对应(三个点表示必传)
如果想给字段值默认值,则 xxx:字段类型 = Form(default=xxx),若想将默认值设为空,则 Form(None)
from fastapi import FastAPI, Form
app = FastAPI()
@app.post("/login/")async def login(username: str = Form(...), password: str = Form(...)):    return {        "username": username,        "password": password    }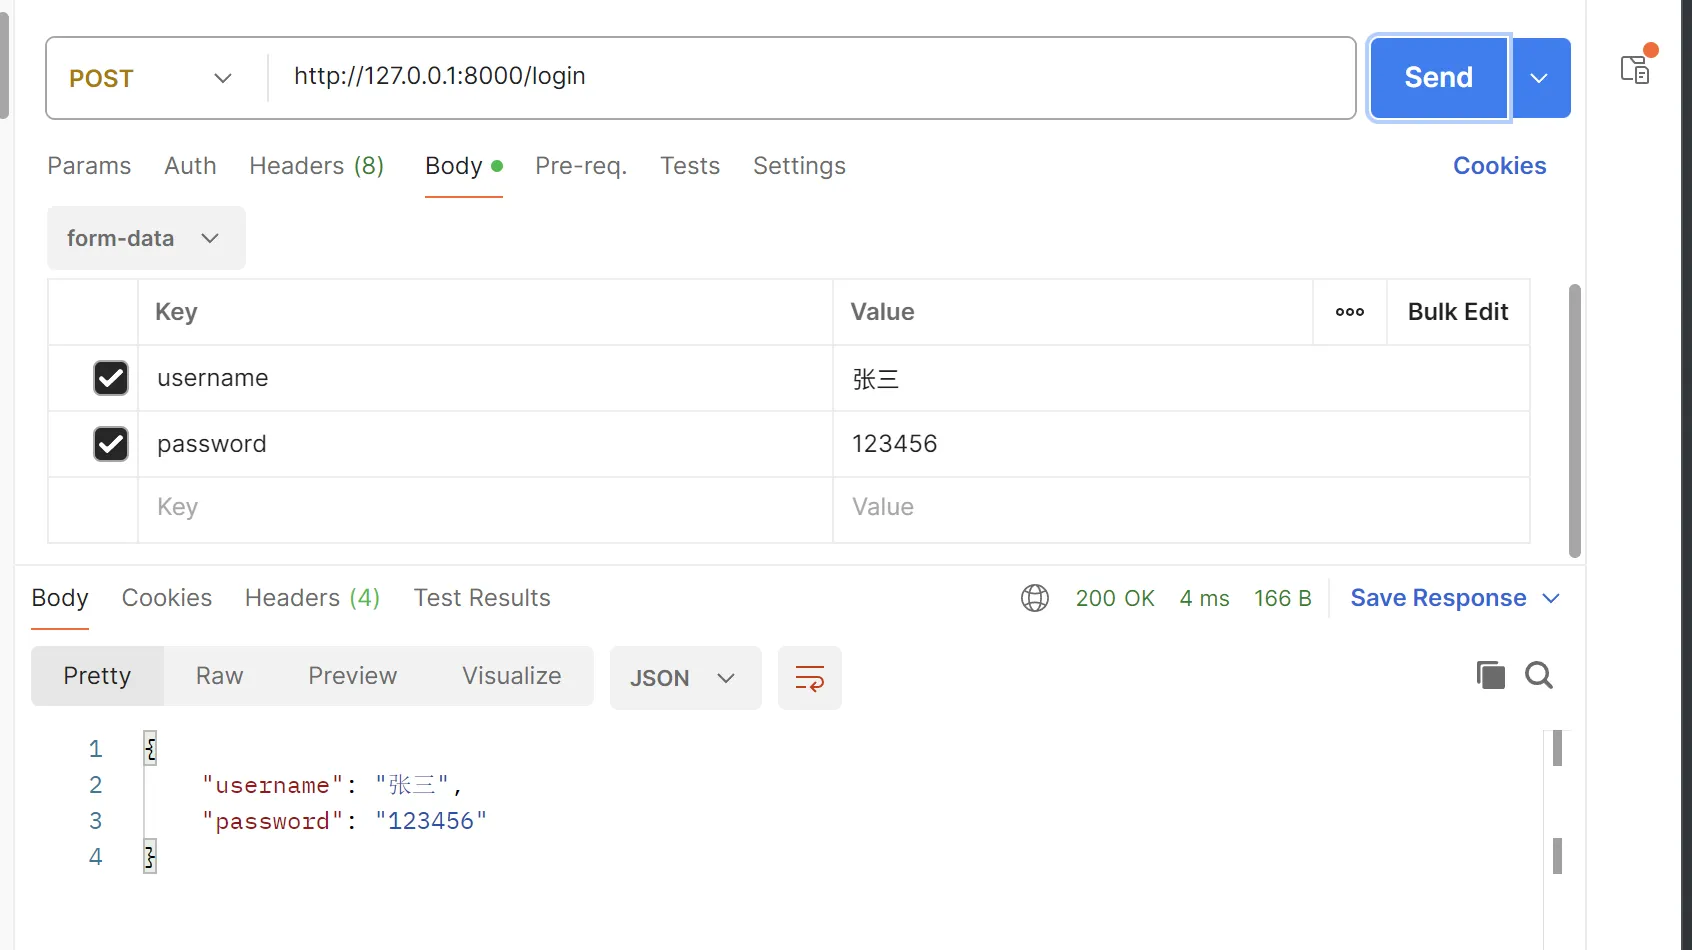
7.3 获取文件#
a. 直接使用 File#
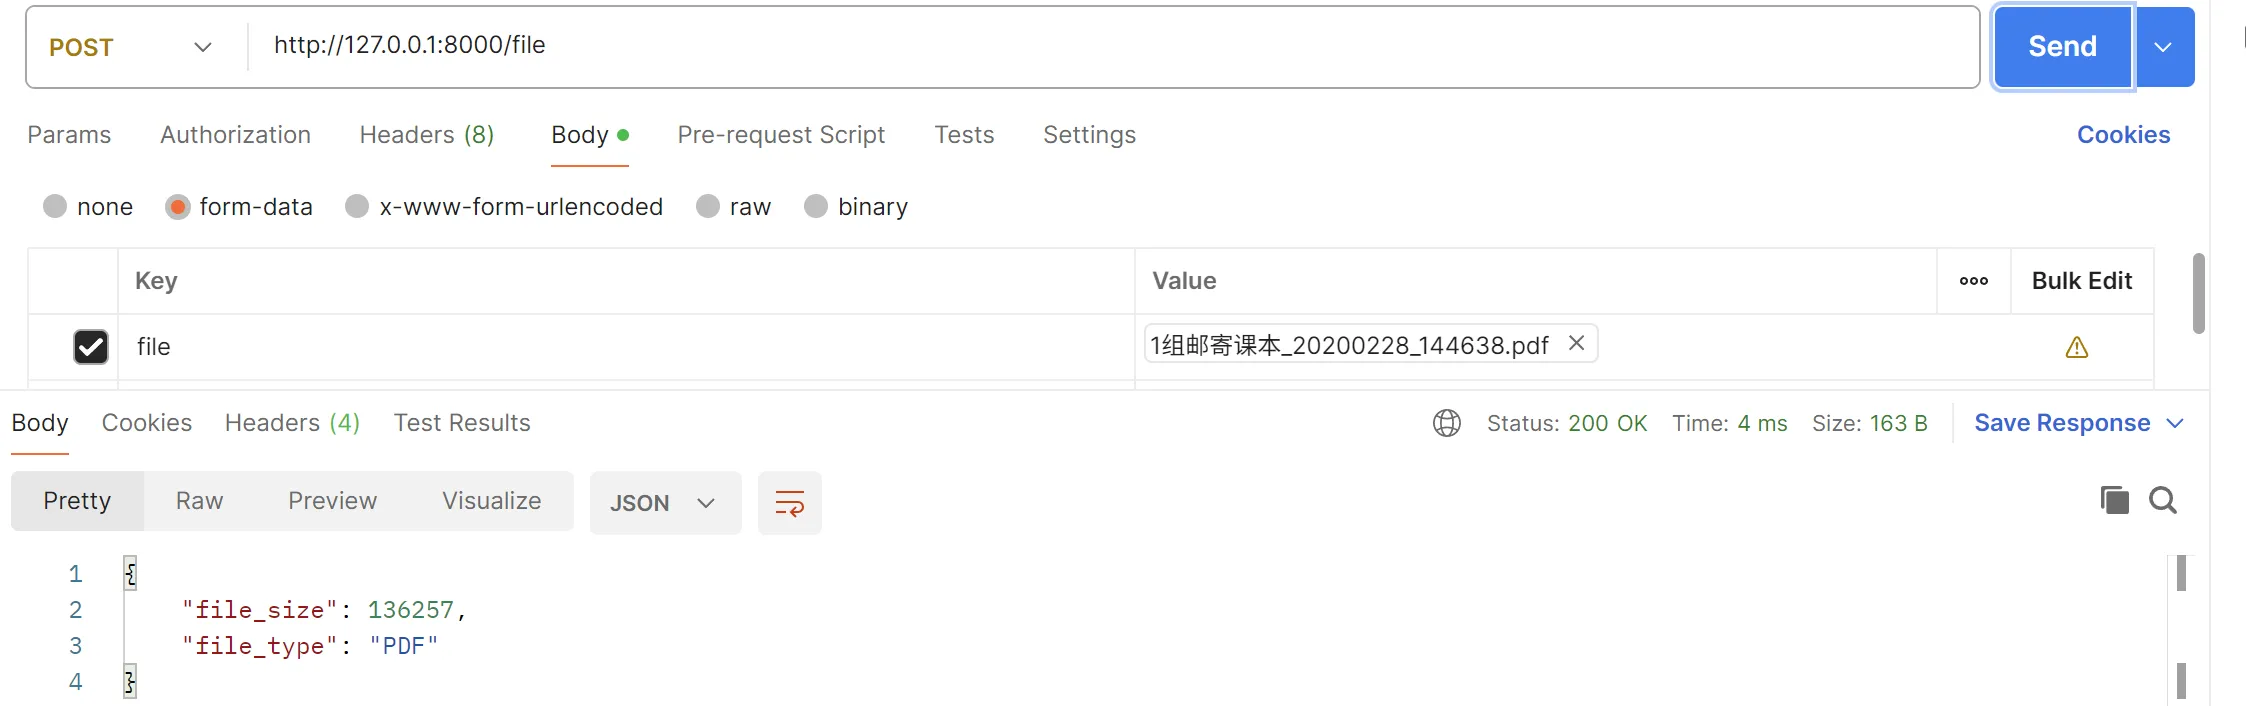
bytes = File(...) 会把文件完整读入内存,适合直接处理小文件的原始字节。
@app.post("/file")async def upload_file(file: bytes = File(...)):    # file 是 bytes 类型    file_size = len(file)    # 可以直接处理字节数据    if file.startswith(b'%PDF'):        file_type = "PDF"    else:        file_type = "其他"
    return {"file_size": file_size, "file_type": file_type}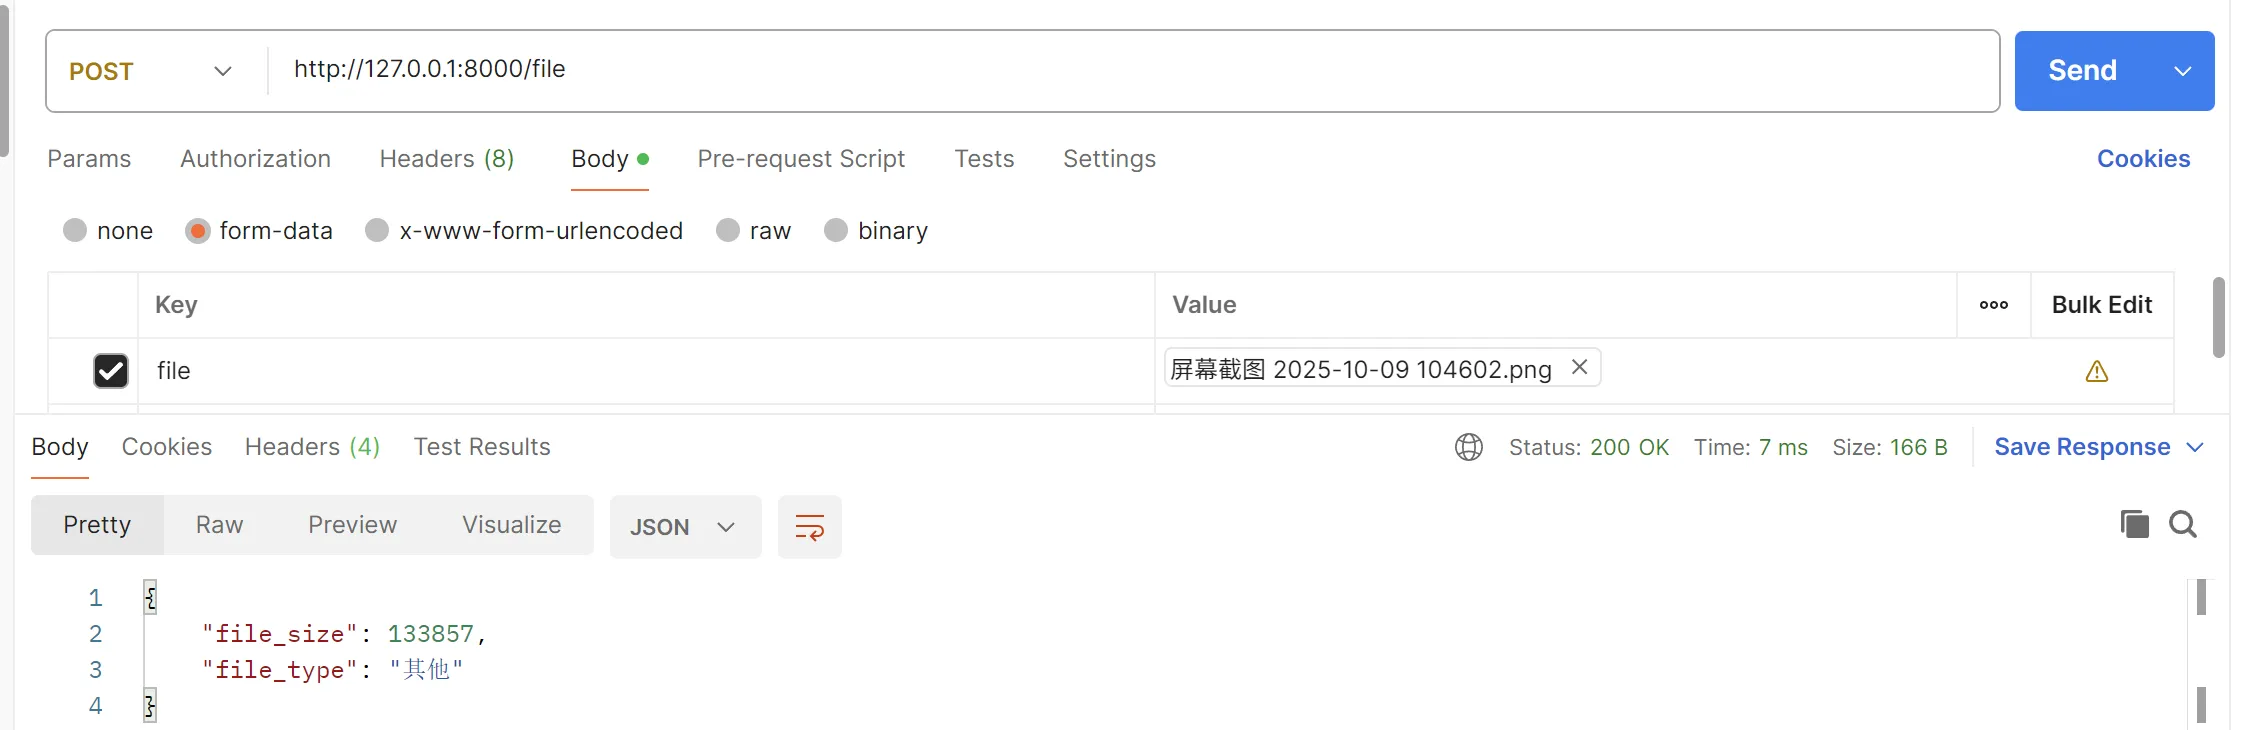
b. 使用 UploadFile#
UploadFile 提供文件名、内容类型以及读写方法,底层可使用内存或临时文件。处理大文件时应分块读取;一次 await file.read() 仍会把全部内容读入内存。
@app.post("/file_uploadfile")async def upload_file_by_uploadfile(file: UploadFile = File(...)):    # 访问文件属性    filename = file.filename    content_type = file.content_type
    # 读取文件内容(可以分块读取)    content = await file.read()
    # 若改为分块读取,应替换上面的整体读取;已读过则先 await file.seek(0)。    # chunk_size = 1024 * 1024  # 1MB    # while chunk := await file.read(chunk_size):    #     # 处理每个块
    return {        "filename": filename,        "content_type": content_type,        "file_size": len(content)    }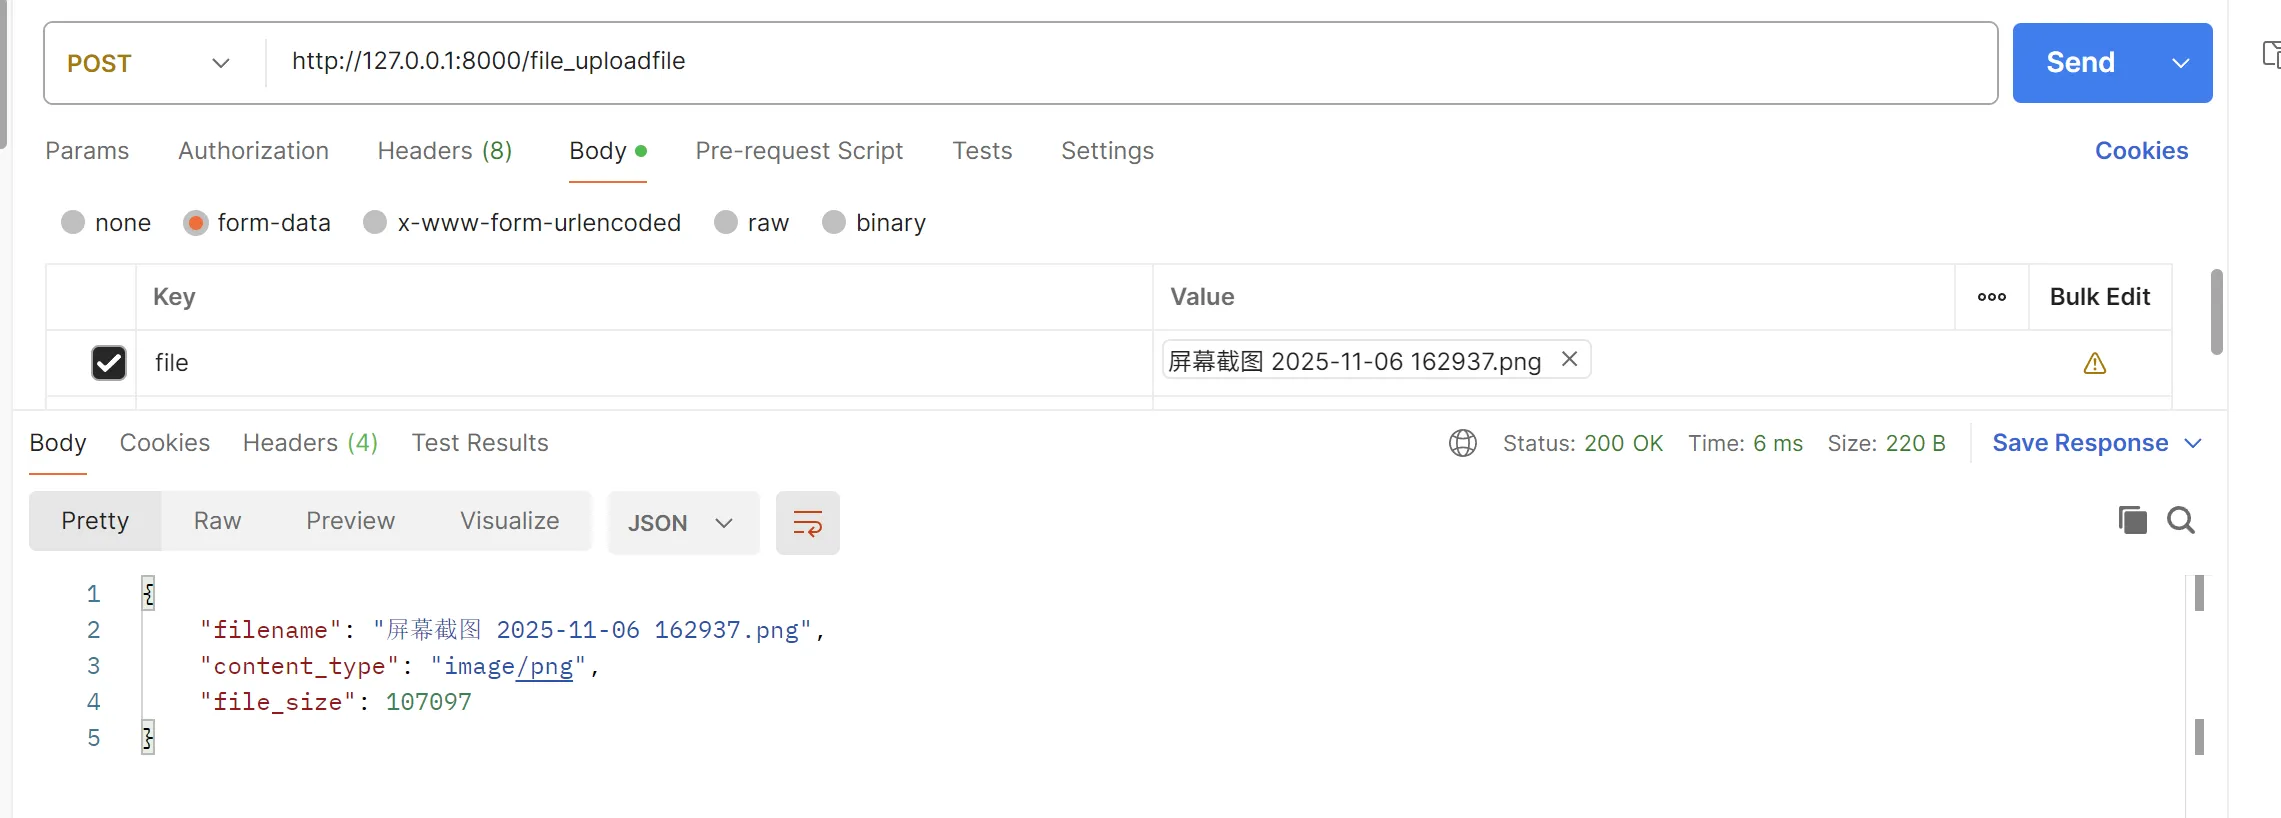
c. 接收文件加表单数据#
from fastapi import FastAPI, File, UploadFile, Formfrom typing import Optional
app = FastAPI()
@app.post("/upload/")async def upload_file(    file: UploadFile = File(...),    description: str = Form(""),    tags: str = Form("")):    return {        "filename": file.filename,        "description": description,        "tags": tags.split(",") if tags else []    }
d. 接收多个同名文件#
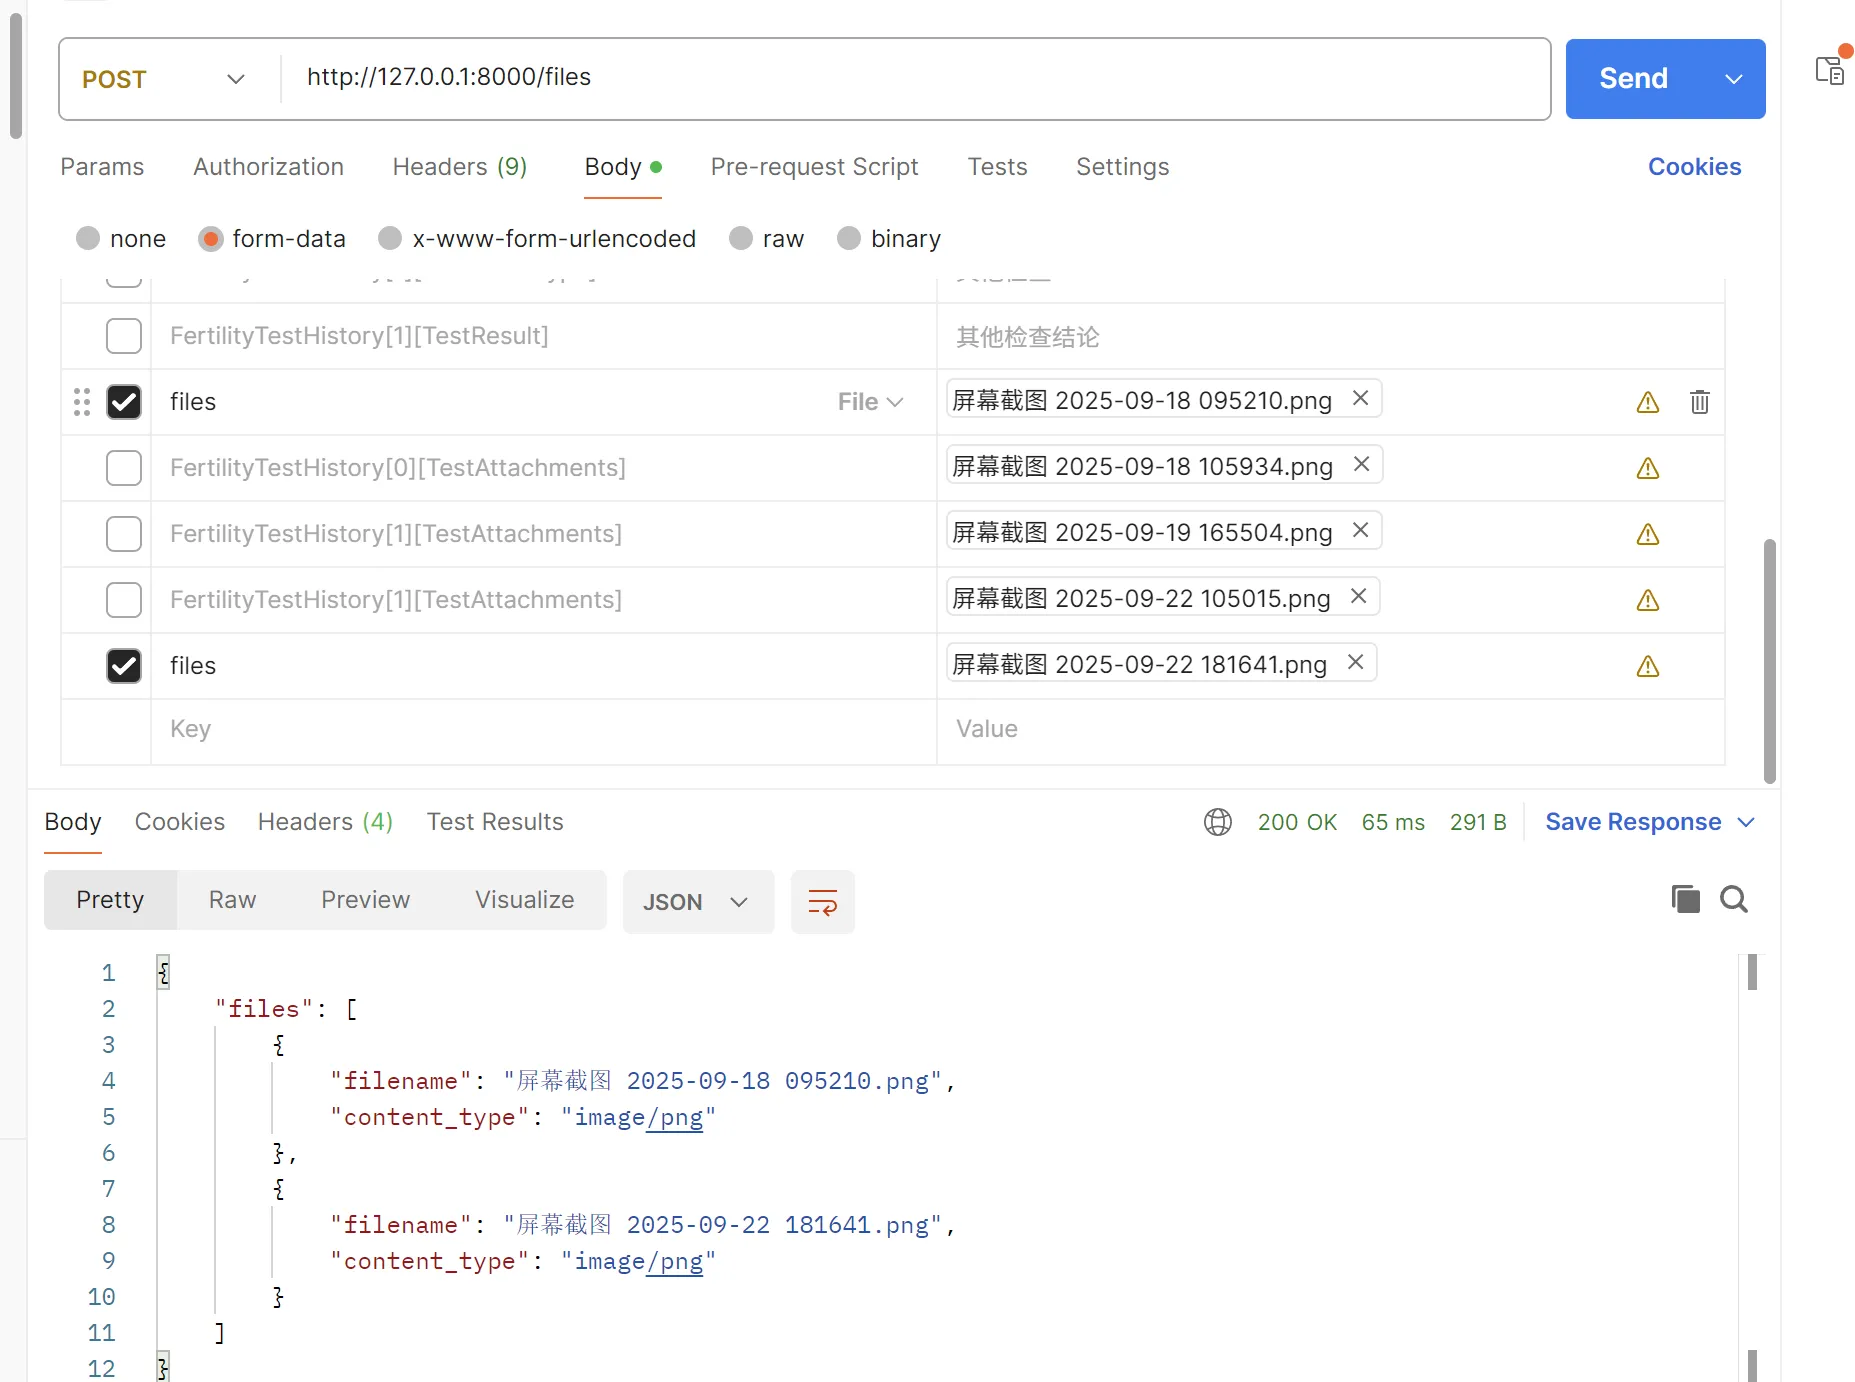
这里我们上传了两张图片,form-data 的 Key 都为 files。
@app.post("/files")def upload_files(files: list[UploadFile] = File(...)): return {"files": [ {"filename": file.filename, "content_type": file.content_type} for file in files ]}这里只读取元数据,不需要读取内容或重置指针。需要在异步路由中处理内容时,使用 await file.read(),再次读取前用 await file.seek(0);同步路由则可操作 file.file。
e. 接收多个不同名文件#
1.使用多个 File 参数
@app.post('/upload/multiple-files')def upload_multiple_files(avatar: UploadFile = File(...), document: UploadFile = File(...), photo: UploadFile = File(...)): return { "avatar": avatar.filename, "document": document.filename, "photo": photo.filename }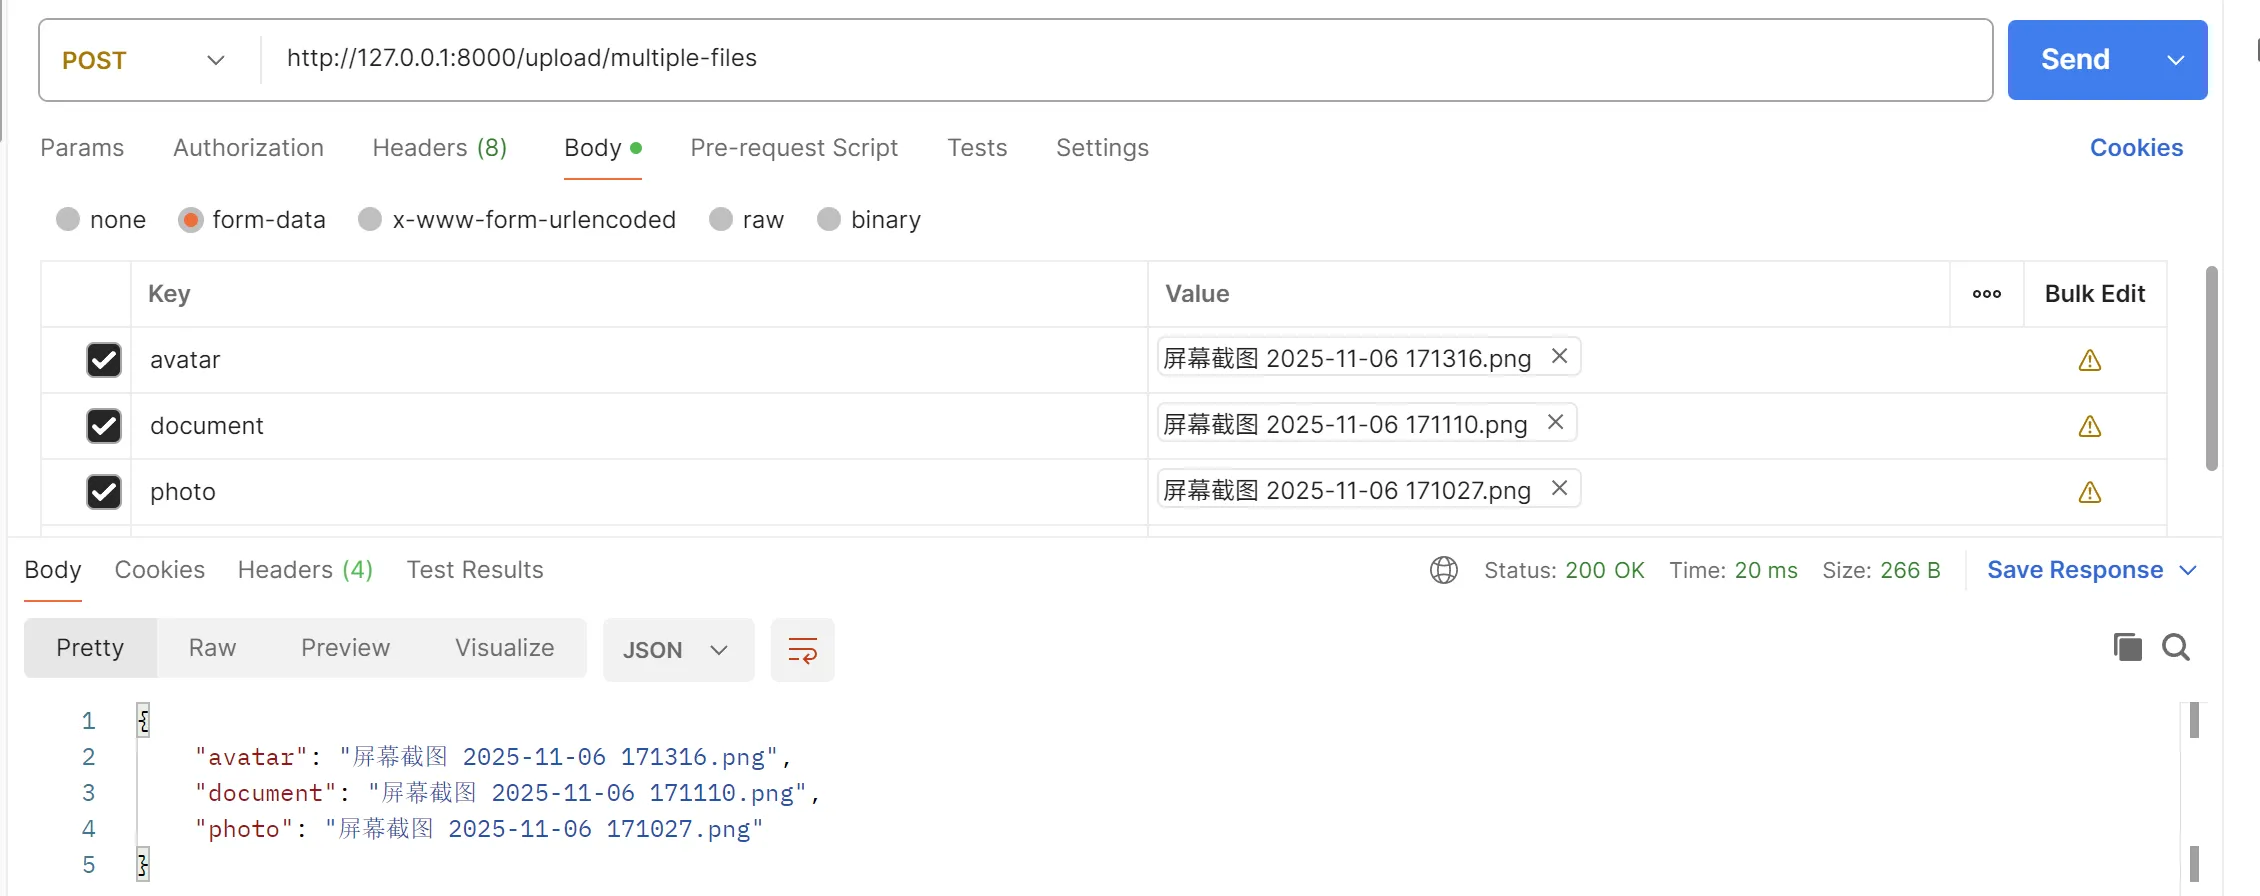
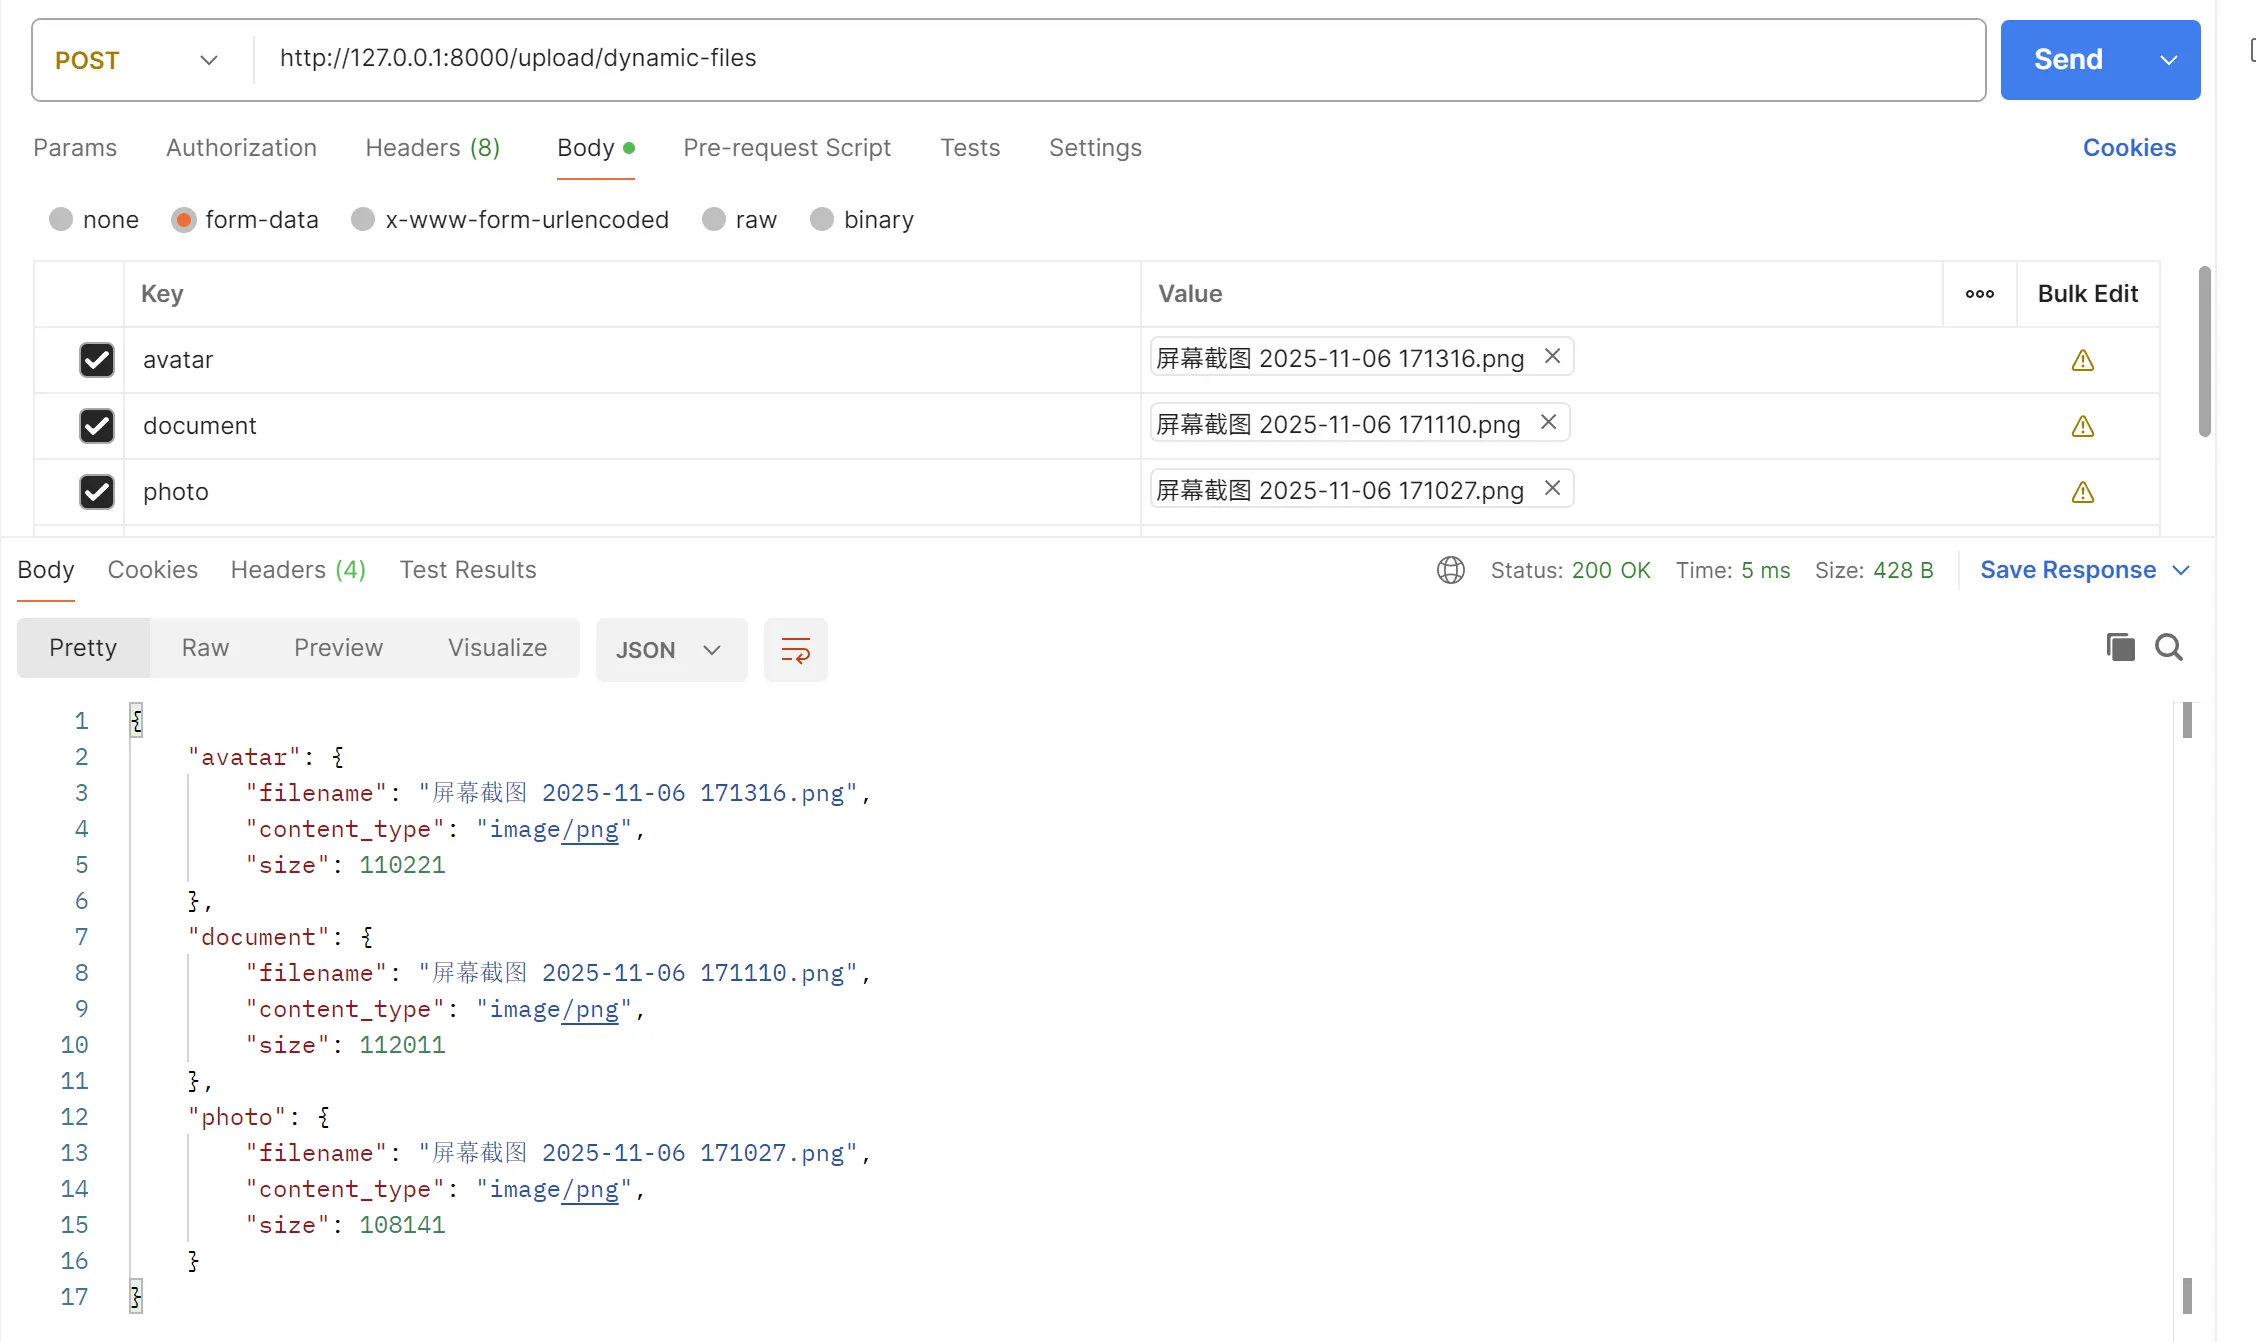
2.使用字典动态接收
from starlette.datastructures import UploadFile as StarletteUploadFile
@app.post('/upload/dynamic-files')async def upload_dynamic_files(request: Request):    form_data = await request.form()    result = {}    # 遍历表单数据的键和值    for field_name, value in form_data.items():        # 使用正确的类型检查        if isinstance(value, StarletteUploadFile):            content = await value.read()            result[field_name] = {                "filename": value.filename,                "content_type": value.content_type,                "size": len(content)            }            await value.seek(0)
    return result
注意这里使用 StarletteUploadFile 做类型判断:我起初用 FastAPI 的 UploadFile,实际表单文件没有通过检查。request.form() 解析出的对象来自 Starlette;FastAPI 的 UploadFile 是它的子类,用子类去检查父类实例不会匹配。
FormData 是不可变的多值字典,可以同时保存文本和文件,也支持普通 URL 编码表单。保留常用操作如下:
| 操作 | 含义 |
|---|---|
form_data.items() / .keys() / .values() | 遍历键值对、字段名或值;不保留同名字段的全部值 |
form_data.get("avatar") | 读取字段,不存在时返回 None |
"avatar" in form_data、form_data["avatar"] | 判断字段存在、按键访问 |
form_data.getlist("files") | 取得一个字段名下的全部值 |
form_data.multi_items() | 遍历所有键值对,包括重复的字段名 |
上面的动态示例按字段名返回一个文件信息,适用于不同名文件;同名多文件应使用 getlist() 或 multi_items() 并按列表收集,避免后一个值覆盖前一个。
7.4 获取 json 数据#
在上面 Pydantic 模型的基础使用验证 json 数据小节说到。
8.响应#
8.1 直接返回数据#
from fastapi import FastAPIfrom pydantic import BaseModel
app = FastAPI()
class Item(BaseModel):    name: str    price: float    is_offer: bool = False
@app.get("/items/{item_id}")async def read_item(item_id: int):    return {"item_id": item_id, "name": "Example Item"}
@app.post("/items/")async def create_item(item: Item):    return item  # 自动序列化为JSON
8.2 使用 Response 参数#
from fastapi import FastAPI, Response
app = FastAPI()
@app.get("/custom-response/")async def custom_response(response: Response):    response.headers["X-Custom-Header"] = "CustomValue"    response.status_code = 201    return {"message": "Custom response"}
8.3 设置响应状态码#
在装饰器方法中使用 status_code 参数。
from fastapi import FastAPI, status
app = FastAPI()
@app.post("/items/", status_code=status.HTTP_201_CREATED)async def create_item(name: str):    return {"name": name, "id": 1}
@app.get("/items/{item_id}", status_code=status.HTTP_200_OK)async def read_item(item_id: int):    if item_id == 0:        return {"error": "Item not found"}    return {"item_id": item_id}
@app.delete("/items/{item_id}", status_code=status.HTTP_204_NO_CONTENT)async def delete_item(item_id: int):    # 删除操作,返回空内容但状态码为204    return
8.4 设置响应头#
from fastapi import FastAPI, Response
app = FastAPI()
@app.get("/items/")async def read_items(response: Response):    response.headers["X-Total-Count"] = "100"    response.headers["X-Custom-Header"] = "MyValue"    response.headers["Cache-Control"] = "max-age=3600"    return {"items": []}
8.5 设置 Cookies#
from fastapi import FastAPI, Response
app = FastAPI()
@app.post("/login/")async def login(response: Response):    response.set_cookie(key="session_id", value="abc123", max_age=3600)    response.set_cookie(        key="user_pref",        value="dark_mode",        httponly=True,        secure=True    )    return {"message": "Login successful"}
@app.post("/logout/")async def logout(response: Response):    response.delete_cookie(key="session_id")    return {"message": "Logout successful"}
8.6 自定义响应模型#
from fastapi import FastAPIfrom pydantic import BaseModelfrom typing import Optional
app = FastAPI()
class SuccessResponse(BaseModel):    success: bool    message: str    data: Optional[dict] = None
class ErrorResponse(BaseModel):    success: bool = False    error: str    code: int
@app.get("/standard-response/", response_model=SuccessResponse)async def standard_response():    return SuccessResponse(        success=True,        message="Operation successful",        data={"item_id": 1, "name": "Example"}    )
@app.get("/error-response/", response_model=ErrorResponse, status_code=404)async def error_response():    return ErrorResponse(        error="Item not found",        code=404    )
响应正文的 code=404 不会改变 HTTP 状态码,因此上例同时在装饰器声明 status_code=404。
声明 response_model 后,返回的普通数据会按模型进行校验、过滤和序列化;它不仅影响文档。不要假定模型一定被重新创建两次,也不要为了避免这个假设而手工绕过校验。直接返回 Response 对象时则由你负责正文。示例和版本边界见开发实践指南。
8.7 异常错误处理#
遇到需要终止请求的业务错误时,抛出 HTTPException,不要 return 异常对象。FastAPI 会根据异常生成响应:
raise HTTPException(status_code=404, detail="Item not found")status_code:必需,HTTP 状态码。detail:可选,错误详情;默认响应正文包含detail字段。headers:可选,附加响应头,例如认证失败时的WWW-Authenticate。
其他错误的默认状态码及 @app.exception_handler() 入口,见前面的“错误处理贯穿始终”。
9.依赖注入#
9.1 一句话概念#
FastAPI 的依赖注入:把可复用逻辑写成依赖函数,由框架在请求中调用,再把返回值传给声明了 Depends(...) 的参数。
9.2 适合复用哪些逻辑#
- 复用:JWT 校验、分页、数据库会话、权限……写一次,处处注入。
- 解耦:视图只关心“业务”,不操心“token 怎么验、DB 怎么拿”。
- 性能:依赖结果默认在一次请求内缓存(可关),不会重复算。
- 自动生成文档:依赖里声明的 Query/Header/Body 参数会自动出现在 OpenAPI 文档。
9.3 最小可运行示例#
from fastapi import Depends, FastAPI
app = FastAPI()
# 1. 写依赖函数def get_query_page(page: int = 1) -> int:    return page
# 2. 在路径操作函数里声明依赖@app.get("/items")async def list_items(page: int = Depends(get_query_page)):    return {"page": page, "data": []}
运行后访问 /items?page=3,FastAPI 会把 3 注入给 page,并自动校验类型、生成文档。
9.4 依赖到底能干什么#
a. 共享数据库会话#
get_db() 创建会话,用 yield 提供给路由,并在依赖退出时关闭。完整定义见“10.1 数据库配置”,业务路由只需注入:
# 项目片段:UserCreate、get_db 等由业务模块提供@app.post("/users")def create_user(user: UserCreate, db: Session = Depends(get_db)): ...b. 用户认证#
把令牌验证和用户查询封装为 get_current_user(),接口即可取得当前用户。该函数统一在“11.3 JWT 认证”中定义,权限章节也复用它:
# 项目片段@person.get("/persons/self")def get_person_self(current_user: Annotated[User, Depends(get_current_user)], db: Session = Depends(get_db)): return service.get_person_self(current_user, db)c. 为整组路由添加依赖#
在 APIRouter(dependencies=[...]) 中声明依赖,这个路由器的接口就会统一执行检查。下面用固定令牌演示,实际项目换成第 11 章的认证函数:
from fastapi import APIRouter, Depends, FastAPI, HTTPExceptionfrom fastapi.security import OAuth2PasswordBearer
app = FastAPI()oauth2_scheme = OAuth2PasswordBearer(tokenUrl="/login")

def get_current_user(token: str = Depends(oauth2_scheme)):    if token != "42":        raise HTTPException(401, "token 无效", headers={"WWW-Authenticate": "Bearer"})    return {"user_id": 7, "name": "alice"}

router = APIRouter(dependencies=[Depends(get_current_user)])

@router.get("/profile")def profile(user=Depends(get_current_user)):    return {"msg": f'{user["name"]} 的个人中心'}

@router.get("/order")def order():    return {"msg": "订单页"}

app.include_router(router, prefix="/user", tags=["user"])
/user/profile 和 /user/order 都必须通过认证,但路由器级依赖的返回值不会自动成为函数参数。profile 再次声明同一个依赖,是为了取得用户对象;默认请求内缓存会复用结果,不会再次认证。order 只需要检查,不需要用户对象。
依赖也可加在单个路径装饰器的 dependencies=[...] 上。多层依赖先准备子依赖,再执行父依赖;发生 HTTPException 时按其状态码中止,其他异常需要对应处理器。若使用 request.state.user 传递用户,则需要依赖自行写入、路由自行读取。
9.5 用链式依赖完成业务校验#
依赖项不只用来获取配置或数据库连接,也可以封装多个接口共享的业务检查。Pydantic 负责判断输入格式是否正确,依赖项则可以进一步检查对应资源是否存在、用户是否有权操作它。
下面是一个可独立运行的例子,用内存数据模拟数据库,演示“查文章 → 校验归属 → 修改标题”的过程。为便于观察依赖关系,使用演示请求头 X-Demo-User-Id 代替认证;真实项目必须换成已验证的登录身份,不能信任客户端自报的用户 ID。
from typing import Annotated
from fastapi import Depends, FastAPI, Header, HTTPExceptionfrom pydantic import BaseModel, Field
app = FastAPI()posts = {1: {"id": 1, "creator_id": 7, "title": "FastAPI 入门"}}users = {7: {"id": 7, "is_active": True}, 8: {"id": 8, "is_active": False}}

class PostUpdate(BaseModel):    title: str = Field(min_length=1, max_length=200)

class PostResponse(BaseModel):    id: int    creator_id: int    title: str

async def get_current_user(    user_id: Annotated[int, Header(alias="X-Demo-User-Id")],) -> dict:    user = users.get(user_id)    if user is None:        raise HTTPException(status_code=401, detail="用户未登录")    return user

async def valid_post_id(post_id: int) -> dict:    post = posts.get(post_id)    if post is None:        raise HTTPException(status_code=404, detail="文章不存在")    return post

async def valid_owned_post(    post: Annotated[dict, Depends(valid_post_id)],    user: Annotated[dict, Depends(get_current_user)],) -> dict:    if post["creator_id"] != user["id"]:        raise HTTPException(status_code=403, detail="只能修改自己的文章")    return post

async def valid_active_user(    user: Annotated[dict, Depends(get_current_user)],) -> dict:    if not user["is_active"]:        raise HTTPException(status_code=403, detail="账号已停用")    return user

@app.patch("/posts/{post_id}", response_model=PostResponse)async def update_post(    data: PostUpdate,    post: Annotated[dict, Depends(valid_owned_post)],    user: Annotated[dict, Depends(valid_active_user)],):    post["title"] = data.title    return post
可以用下面的请求验证成功路径:
curl -X PATCH http://127.0.0.1:8000/posts/1 \ -H 'Content-Type: application/json' \ -H 'X-Demo-User-Id: 7' \ -d '{"title":"修改后的标题"}'依赖关系可以这样读:
update_post├── valid_owned_post│ ├── valid_post_id → 查文章,不存在则返回 404│ └── get_current_user → 取得当前用户└── valid_active_user └── get_current_user → 复用本次请求的用户结果这里 get_current_user 被两条依赖路径使用,但在默认缓存规则下,同一次请求只执行一次;下一次请求会重新执行。需要禁用某处的缓存读取时,可以在对应位置使用 Depends(get_current_user, use_cache=False)。
如果文章不存在、用户不是作者或者账号已停用,依赖抛出异常后就不会进入修改标题的函数。多个条件同时失败时,不应依赖某个固定错误优先级来实现业务规则;如确实需要先认证再查资源,应把先后关系写进依赖链。
实际项目可以把 valid_post_id 复用于读取、修改和评论列表等接口,并把内存查询换成服务层调用。服务函数仍要维护自己的事务与业务约束,例如唯一性最终应由数据库唯一约束保证,不能只依赖请求前的一次查询。模块拆分方式见开发实践指南。
10.数据库配置与 ORM 操作#
10.1 数据库配置#
在需要操作数据库的路径操作函数中,都需要注入数据库会话依赖,如果在会话依赖函数中为 db = SessionLocal(),则以后的数据库操作都为 db.add,db.query,db.delete 等等。
from sqlalchemy import create_enginefrom collections.abc import Generatorfrom sqlalchemy.orm import declarative_base, sessionmaker, Session
from src.app.core.config import settings
# 配置连接参数SQLALCHEMY_DATABASE_URL = settings.DATABASE_URL# 创建engine对象engine = create_engine(    SQLALCHEMY_DATABASE_URL,    pool_pre_ping=True  # 取出连接时检查是否仍有效)# 创建会话SessionLocal = sessionmaker(autocommit=False, autoflush=True, bind=engine)
# 声明基类,所有模型继承此类Base = declarative_base()

# 数据库会话依赖def get_db() -> Generator[Session, None, None]:    db = SessionLocal()    try:        yield db    finally:        db.close()
这里的对象分工如下:
engine:管理数据库连接池,避免每次请求都重新建立连接。pool_pre_ping=True会在取出连接时检查有效性,避免复用已经断开的连接。Base:declarative_base()返回的 ORM 基类;模型继承它后,表结构会收集到Base.metadata。SessionLocal:sessionmaker创建的会话工厂,绑定到engine。autocommit=False要求显式commit();autoflush=True会在相关查询等操作前把待处理变更发送到数据库,flush 不等于提交事务。db:本次请求使用的Session,通过add、query、delete等方法操作数据。
get_db() 是生成器依赖:执行到 yield db 时把会话注入路由,退出依赖作用域时执行 finally,关闭会话并归还连接。它不会自动提交业务事务;清理时点与 FastAPI 的依赖作用域有关,不应一概理解为紧跟路由的 return。
10.2 ORM(使用 SQLAlchemy)#
a. ORM 与对象映射#
ORM(Object-Relational Mapping,对象关系映射)把数据库表映射成 Python 类,让你通过对象和属性读写数据,由 ORM 生成相应 SQL。
| 数据库 | Python |
|---|---|
表,例如 users | 模型类 User |
| 一行用户记录 | 一个 User 实例 |
一列,例如 phone_number | 实例属性 user.phone_number |
下面直接用 SQLAlchemy 模型展示这套映射。
b. 安装依赖#
pip install sqlalchemyc. 编写 ORM 模型#
from sqlalchemy import Column, Integer, String, TIMESTAMPfrom sqlalchemy.sql import funcfrom src.app.core.database import Baseimport uuid
class User(Base):    """用户信息表"""    __tablename__ = 'users'    id = Column(Integer, primary_key=True, autoincrement=True)    user_id = Column(String(36), unique=True, nullable=False, default=lambda: str(uuid.uuid4()))    phone_number = Column(String(11), unique=True, nullable=False)    hashed_password = Column(String(255), nullable=False)    created_at = Column(TIMESTAMP, nullable=False, default=func.now())    updated_at = Column(TIMESTAMP, nullable=False, default=func.now(), onupdate=func.now())
10.3 Alembic 数据库迁移#
Alembic 与 SQLAlchemy 配合,对数据库 schema(表、字段、约束等结构)进行版本管理。代码更新不会自动修改其他环境的数据库;迁移脚本让团队和部署环境按同一组变更升级,并留下可追踪的历史。
| 组成 | 作用 |
|---|---|
| 迁移脚本 | Python 文件,upgrade() 描述升级,downgrade() 描述回退,可调用 create_table、add_column、alter_column 等操作 |
alembic.ini | 迁移目录、数据库连接等基础配置 |
env.py | 迁移运行环境,配置连接并加载模型元数据 |
alembic_version 表 | 记录数据库当前的迁移版本,Alembic 据此确定需要执行哪些脚本 |
结构回退不代表删除的数据能够恢复;迁移审查、命名和回退边界见开发实践指南。
① 安装并初始化迁移目录
pip install alembicalembic init migrationsmigrations 是目录名,也可以取名 alembic。以下配置写入生成的 migrations/env.py,其中 config 使用文件里已有的 Alembic 配置对象:
from src.app.core.database import Basefrom src.app.core.config import settings# 必须导入需要迁移的模型,让表结构注册到 Base.metadata。from src.app.modules.persons.models import Personfrom src.app.modules.users.models import Userfrom src.app.modules.records.models import Record
config.set_main_option("sqlalchemy.url", settings.DATABASE_URL)target_metadata = Base.metadata
② 生成、检查并执行迁移
alembic revision --autogenerate -m "add user table"alembic upgrade headrevision 只生成候选脚本,不修改数据库;检查脚本后执行 upgrade head,才会升级到最新版本。
③ 需要回退时
alembic downgrade -1 # 回退一个版本,执行对应脚本的 downgrade()10.4 基础的增删改查操作#
下面的 session 是 SessionLocal() 创建的会话。为便于演示年龄筛选,CRUD 示例使用独立的简化模型,与前面的账号表区分:
class User(Base): __tablename__ = "demo_users" id = Column(Integer, primary_key=True) name = Column(String(50), nullable=False) age = Column(Integer, nullable=False)以下沿用 session.query(...) 写法;它在 SQLAlchemy 2.x 中属于旧式查询接口。事务通过 commit() 提交,失败后应 rollback(),会话使用后关闭。
a. 增加(Create)#
add() 添加单个对象,add_all() 添加多个对象;commit() 提交事务:
# 创建新用户对象new_user = User(name="张三", age=25)
# 添加到 sessionsession.add(new_user)
# 提交到数据库session.commit()print(f"新增用户ID: {new_user.id}")  # 提交后会自动填充自增的 ID
# 批量添加user_list = [    User(name="李四", age=30),    User(name="王五", age=28),    User(name="赵六", age=35)]session.add_all(user_list)session.commit()
b. 查询(Read)#
最常用的操作,SQLAlchemy 提供了丰富的查询方式。
基本查询方法:
# 查询所有用户all_users = session.query(User).all()
# 查询第一个用户first_user = session.query(User).first()
# 根据主键查询user_by_id = session.get(User, 1)  # 查询 id=1 的用户
# 查询数量user_count = session.query(User).count()
过滤查询:
from sqlalchemy import or_
# WHERE 条件查询users_30 = session.query(User).filter(User.age == 30).all()
# 多种过滤方式users_25_30 = session.query(User).filter(User.age > 25, User.age < 30).all()
# 或者使用 filter_by (更简洁,但只能用于等值比较)users_30_alt = session.query(User).filter_by(age=30).all()
# OR 条件users_25_or_35 = session.query(User).filter(or_(User.age == 25, User.age == 35)).all()
# LIKE 查询users_li = session.query(User).filter(User.name.like('张%')).all()
排序和限制:
# 按年龄升序排序users_asc = session.query(User).order_by(User.age).all()
# 按年龄降序排序users_desc = session.query(User).order_by(User.age.desc()).all()
# 限制返回数量first_two_users = session.query(User).limit(2).all()
# 分页查询 (offset + limit)page_size = 2page_number = 1users_page = session.query(User).offset(page_size * (page_number - 1)).limit(page_size).all()
desc() 函数与 .desc() 方法表达相同的降序规则:
| 参数 | 函数形式 | 方法形式 |
|---|---|---|
| 列对象 | desc(User.age) | User.age.desc() |
| SQL 表达式 | desc(User.age + 10) | (User.age + 10).desc() |
| 可解析的列名或标签字符串 | desc("age") | 不可写成 "age".desc(),字符串没有该方法 |
函数形式需要 from sqlalchemy import desc;使用列对象通常更容易由编辑器检查名称。
c. 更新(Update)#
可以先查询再修改属性,也可以按条件批量更新;两种方式都需要提交事务:
# 方法1:先查询再修改user_to_update = session.query(User).filter_by(name="张三").first()if user_to_update:    user_to_update.age = 26  # 修改属性    session.commit()
# 方法2:批量更新session.query(User).filter(User.age < 30).update({"age": User.age + 1})session.commit()
d. 删除(Delete)#
删除单个对象用 delete(instance),也可通过查询条件批量删除:
# 方法1:先查询再删除user_to_delete = session.query(User).filter_by(name="赵六").first()if user_to_delete:    session.delete(user_to_delete)    session.commit()
# 方法2:批量删除session.query(User).filter(User.age > 40).delete()session.commit()
10.5 条件查询,分页#
分页依赖负责接收和校验查询参数,路由把参数与数据库会话交给服务层:
def get_query_params(        page: int = Query(1, ge=1, description="页码(从 1 开始)"),        page_size: int = Query(20, ge=1, le=100, description="每页记录数"),        sort: str = Query("created_at,desc", description="排序字段,格式为 field,asc|desc"),        keyword: Optional[str] = Query(None, max_length=128, description="根据名称进行模糊搜索")):    """获取人员查询参数"""    return {        "page": page,        "page_size": page_size,        "sort": sort,        "keyword": keyword    }# router.pyfrom src.app.core.dependencies import get_query_params
@person.get('/persons')def get_persons(query_params=Depends(get_query_params), db: Session = Depends(get_db)):    return service.get_persons(db, query_params)
服务层:
def apply_sorting(query, sort_str: str):    if not sort_str:        return query.order_by(desc(Person.created_at))
    try:        sort_field, sort_order = sort_str.split(',')        if hasattr(Person, sort_field):            # 获取列对象            sort_column = getattr(Person, sort_field)            if sort_order.lower() == 'desc':                # 根据列对象进行排序                return query.order_by(desc(sort_column))            else:                return query.order_by(asc(sort_column))    except (ValueError, AttributeError):        # 如果排序格式错误或字段不存在,使用默认排序        pass
    return query.order_by(desc(Person.created_at))

def get_persons(db, query_params: dict):    """    获取人员列表    """    # 构建基础查询    query = db.query(Person)
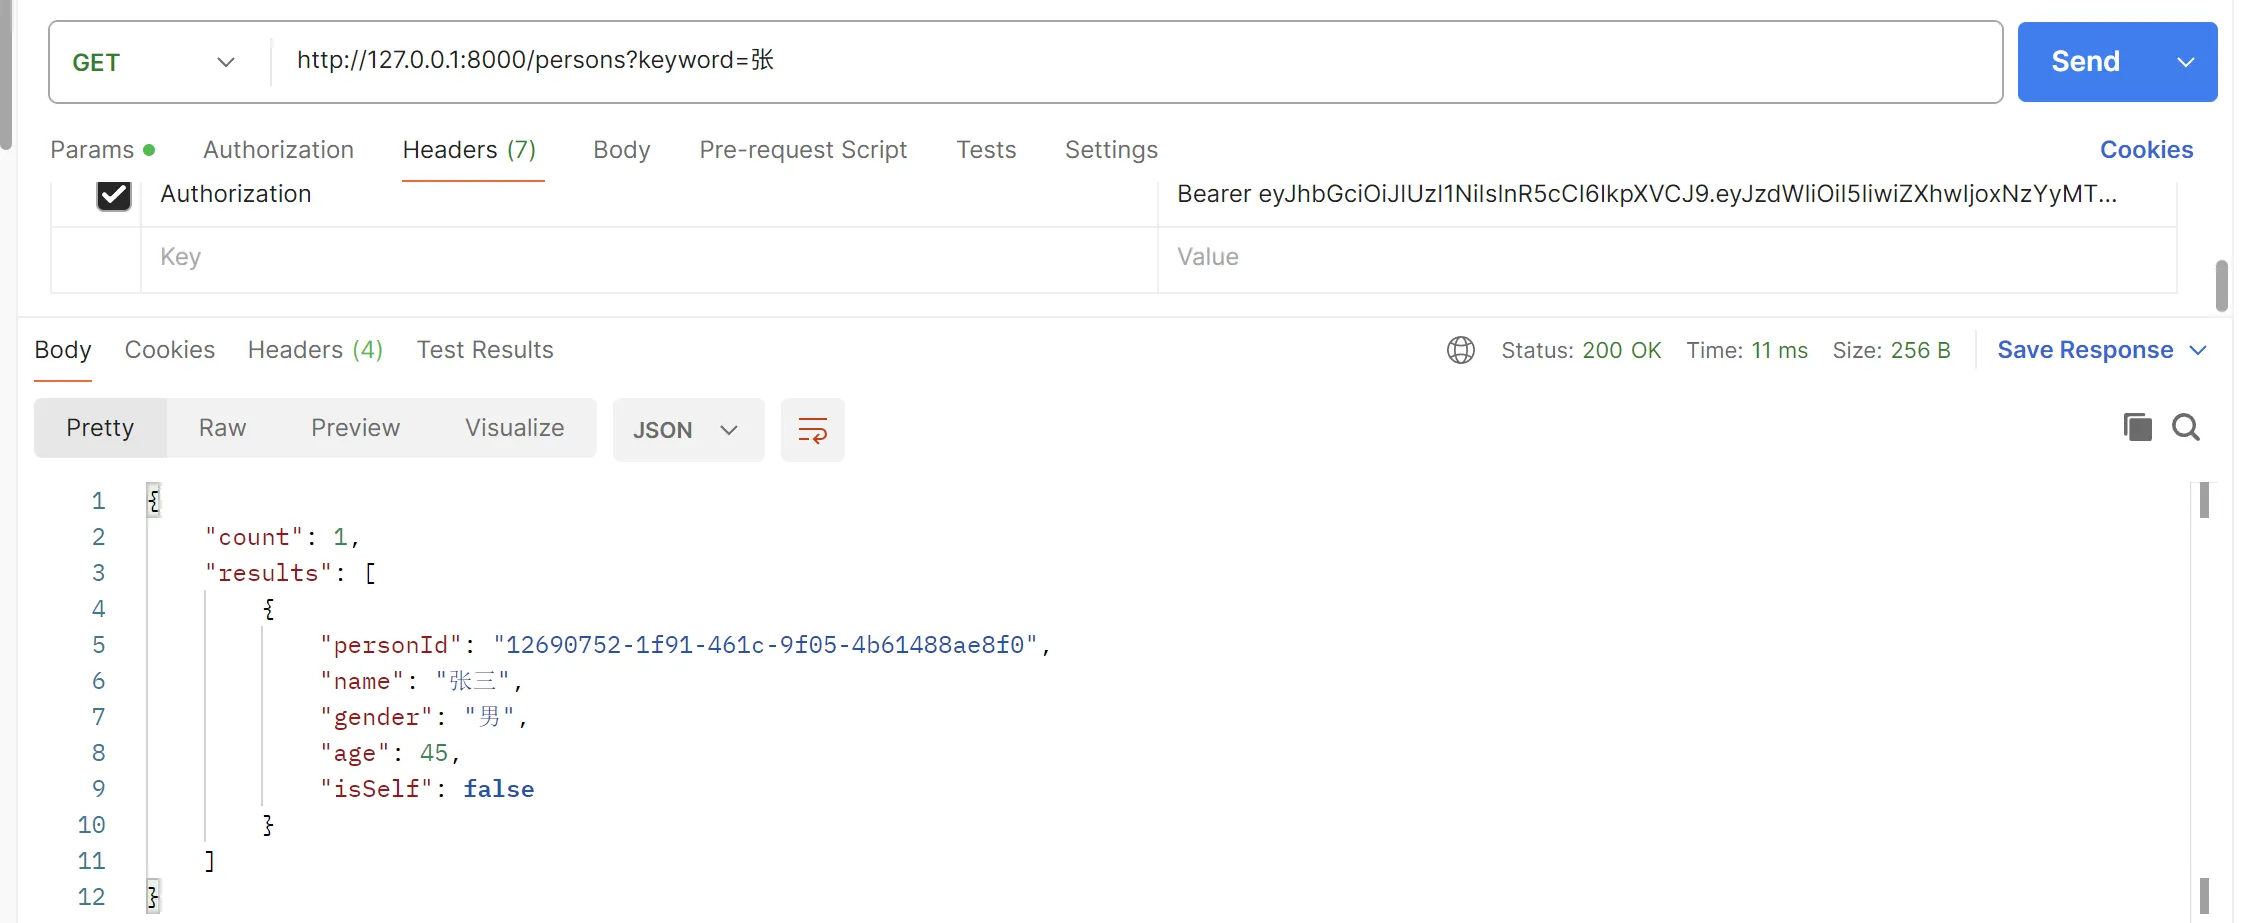
    # 去掉首尾空白,再按姓名搜索    if query_params.get("keyword") and query_params["keyword"].strip():        # 若存在keyword且去掉空格后仍有实质内容,则将通配符%加到值里用于模糊查询        keyword = f"%{query_params['keyword'].strip()}%"        query = query.filter(Person.name.ilike(keyword))  # ilike 表示不区分大小写的匹配
    # 获取总数    count = query.count()
    # 处理排序    query = apply_sorting(query, query_params.get("sort", ""))
    # 分页    page = query_params.get("page", 1)    page_size = query_params.get("page_size", 20)    # 根据页码和每页条数计算偏移量    skip = (page - 1) * page_size    # 根据偏移量和每页条数进行分页查询,offset(x)表示跳过前x条数据,limit(x)表示只查询x条数据    # 例如进行模糊查询后拿到了20条数据,offset(10).limit(5)获取到的是11~15的5条数据,这就表示查询的是第三页数据,每页5条    persons = query.offset(skip).limit(page_size).all()
    # 转换为响应模型    results = []    for person in persons:        results.append({            "personId": person.person_id,            "name": person.name,            "gender": person.gender,            "age": person.age,            "isSelf": person.is_self        })
    # 返回完整的响应对象    return {        "count": count,        "results": results    }
a. 根据关键词模糊查询#
| 场景 | 写法 | 对应 SQL |
|---|---|---|
| 以关键字开头 | User.name.like('张%') | WHERE name LIKE '张%' |
| 以关键字结尾 | User.name.like('%张') | WHERE name LIKE '%张' |
| 包含关键字 | User.name.like('%张%') | WHERE name LIKE '%张%' |
| 单个字符匹配 | User.name.like('张_') | WHERE name LIKE '张_' |
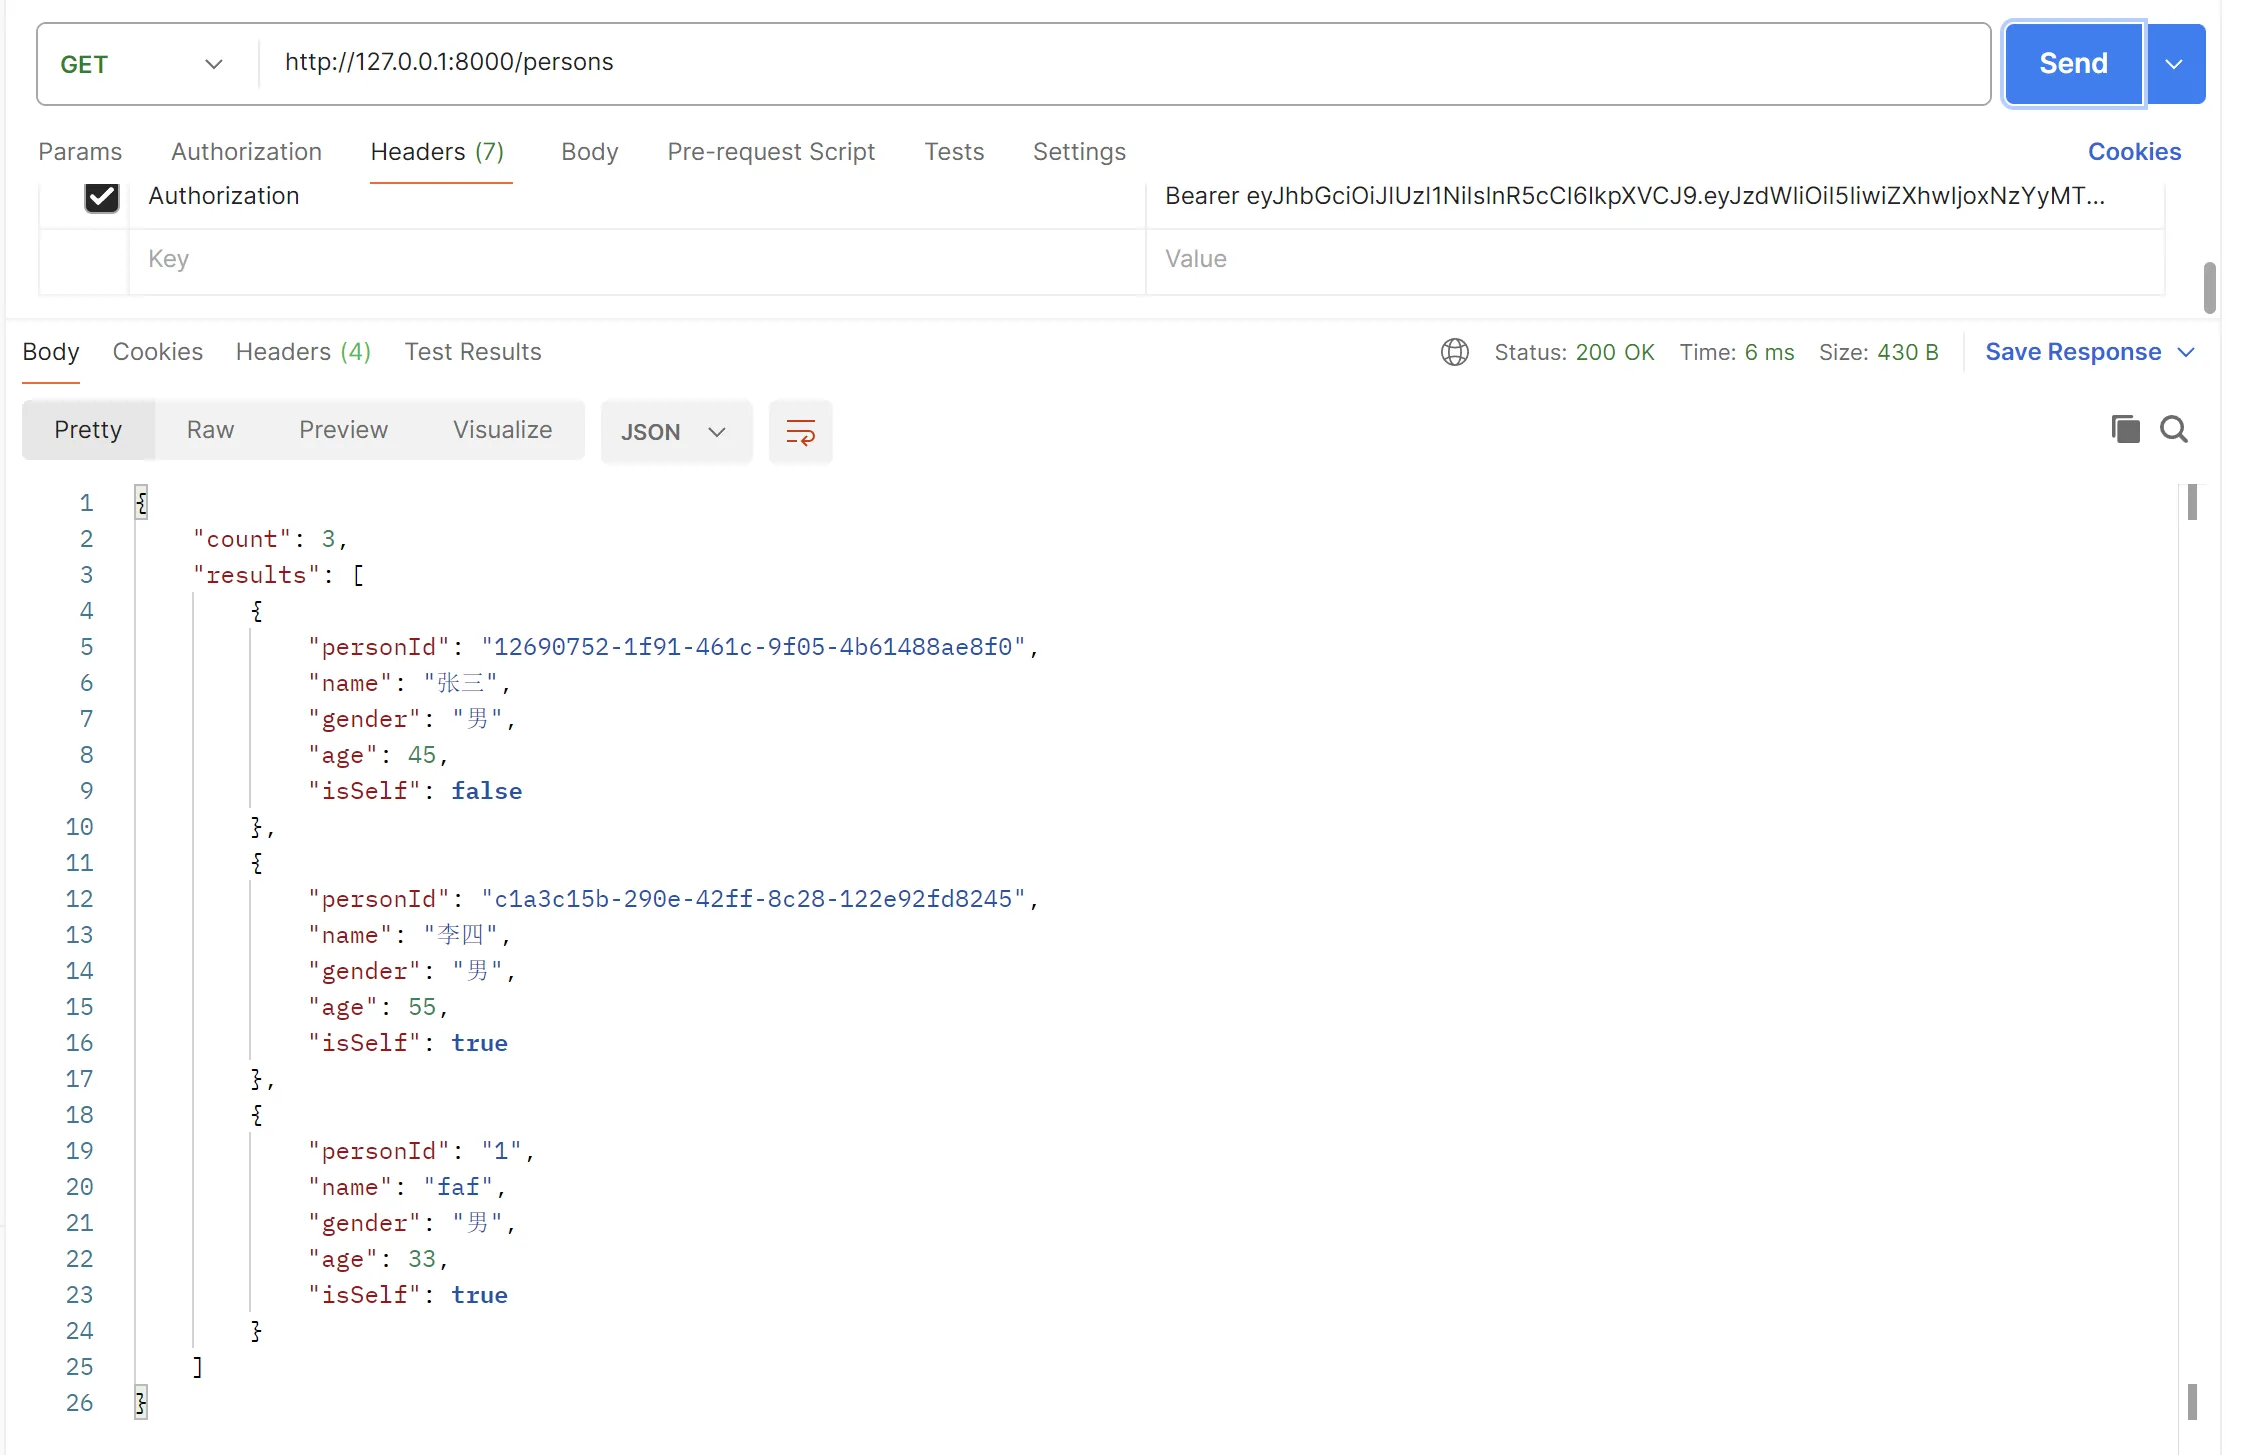
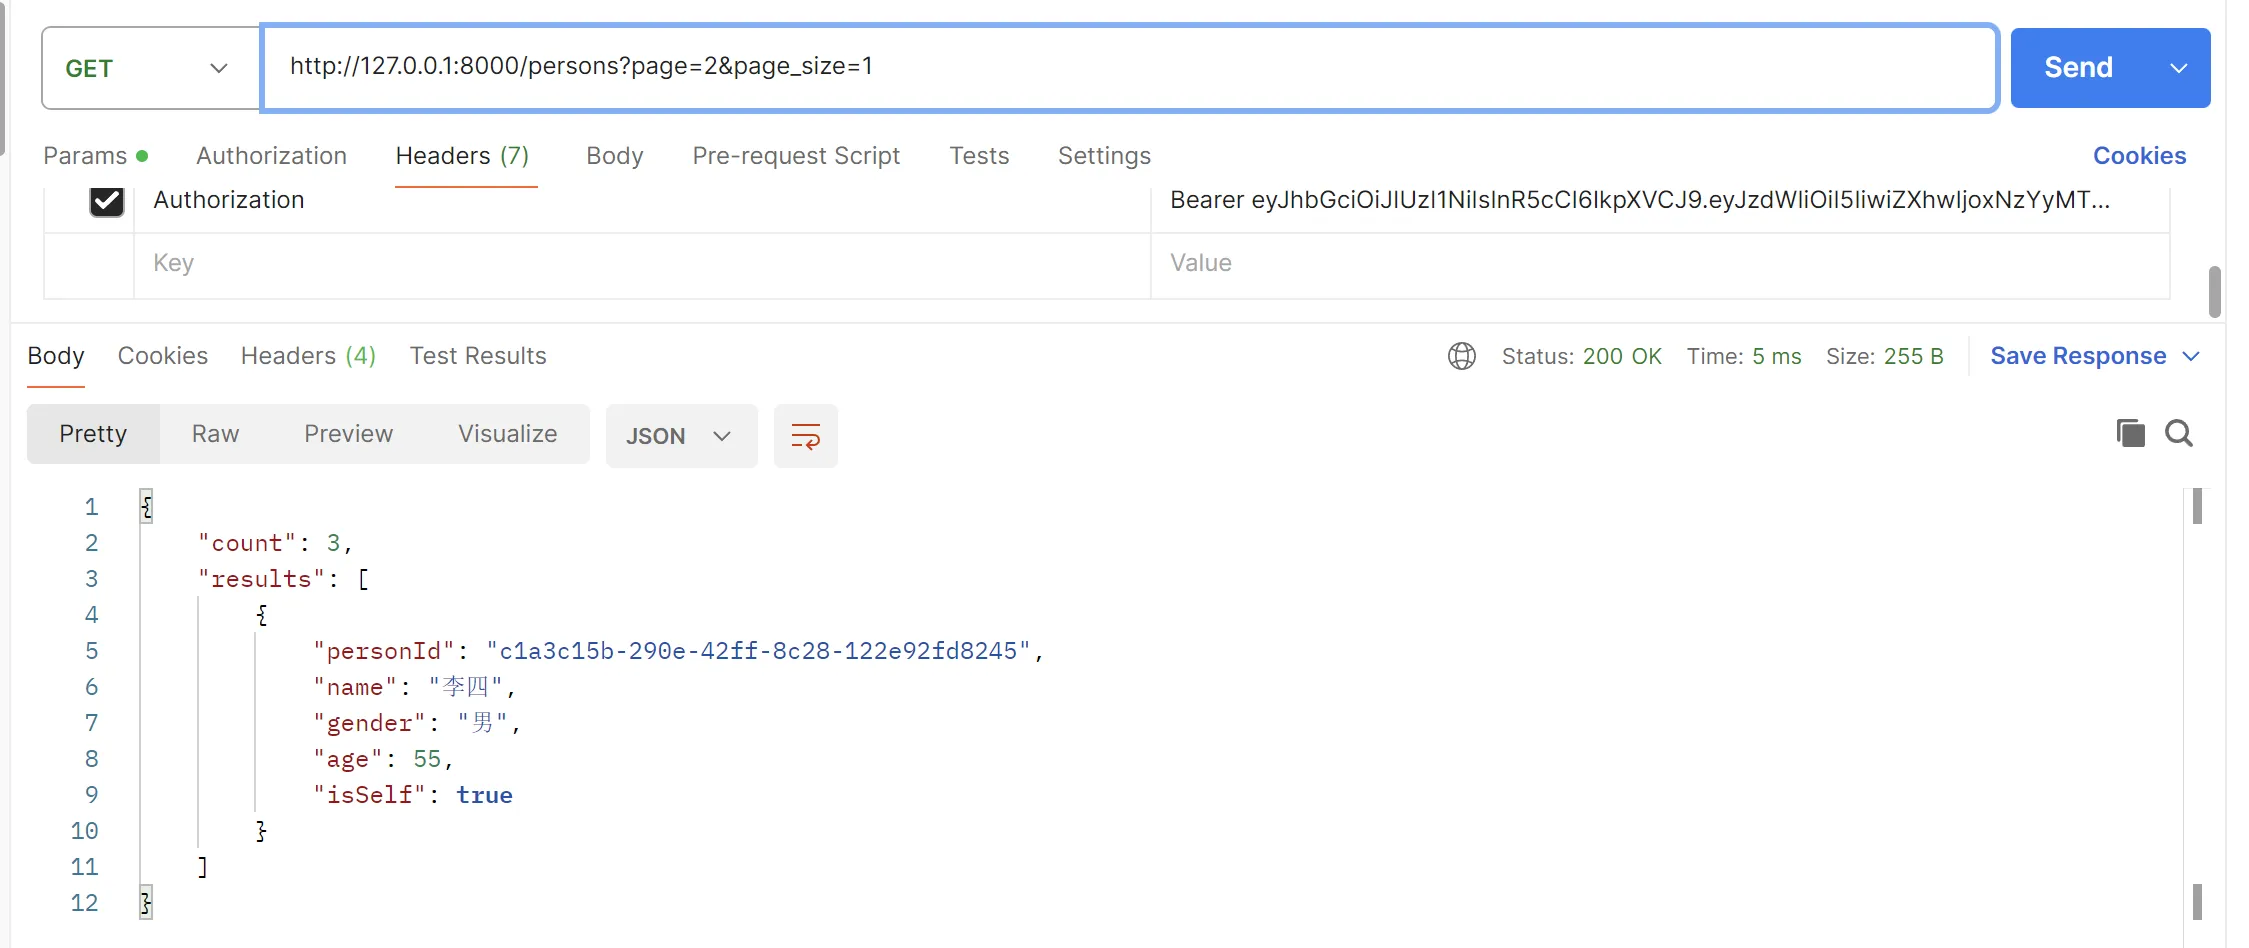
b. 根据页码与每页显示数进行分页查询#
不分页的总数据
每页一条数据,第二页
11.用户认证#
11.1 登录认证概述#
登录后,客户端保存服务器签发的凭据,后续请求携带它;服务器验证凭据,再确认当前用户。常见方式有:
| 方式 | 登录与后续验证 | 服务端状态 |
|---|---|---|
| Session | 生成随机 session_id,后续按它查找用户 | 保存会话与用户的映射;多实例部署通常共享会话存储 |
| 签名 JWT | 签发包含用户标识等声明的令牌,后续验证签名与有效期 | 单纯验证令牌可不保存会话;用户状态、撤销和刷新机制仍可能需要数据库或 Redis |
Token 是令牌的泛称,也可以是服务端保存的随机字符串。JWT 是其中一种格式;这里使用的是签名 JWT,签名防篡改,不等于加密,载荷可被读取。两种方案各有适用场景,不是 Session 必然被 JWT 取代。
11.2 OAuth2 与 Bearer 令牌提取#
OAuth2 是授权框架,不负责规定 JWT 的签名算法。Bearer 令牌通常通过请求头传递,Bearer 与令牌之间用空格分隔:
Authorization: Bearer token_stringFastAPI 的 OAuth2PasswordBearer 声明密码流相关的 OpenAPI 信息,并作为依赖提取请求头中的令牌:
from fastapi import Dependsfrom fastapi.security import OAuth2PasswordBearer
oauth2_scheme = OAuth2PasswordBearer(tokenUrl="/login")
async def verify_token(token: str = Depends(oauth2_scheme)): ... # 下一节补充真正的 JWT 验证- 请求头缺失或不是 Bearer 方案时,默认返回带
WWW-Authenticate: Bearer的 401。 - 提取出的字符串原样传给
verify_token;它不保证令牌是 JWT,也不验证签名或有效期。 tokenUrl描述获取令牌的接口,不会替你创建登录路由。若要使用 Swagger 的密码流授权按钮,登录接口需要匹配对应的表单请求与令牌响应约定;不能随意填写地址。
下一节的业务登录片段采用自定义数据模型与响应字段,可由客户端调用后自行携带 Bearer 令牌。
11.3 JWT 认证#
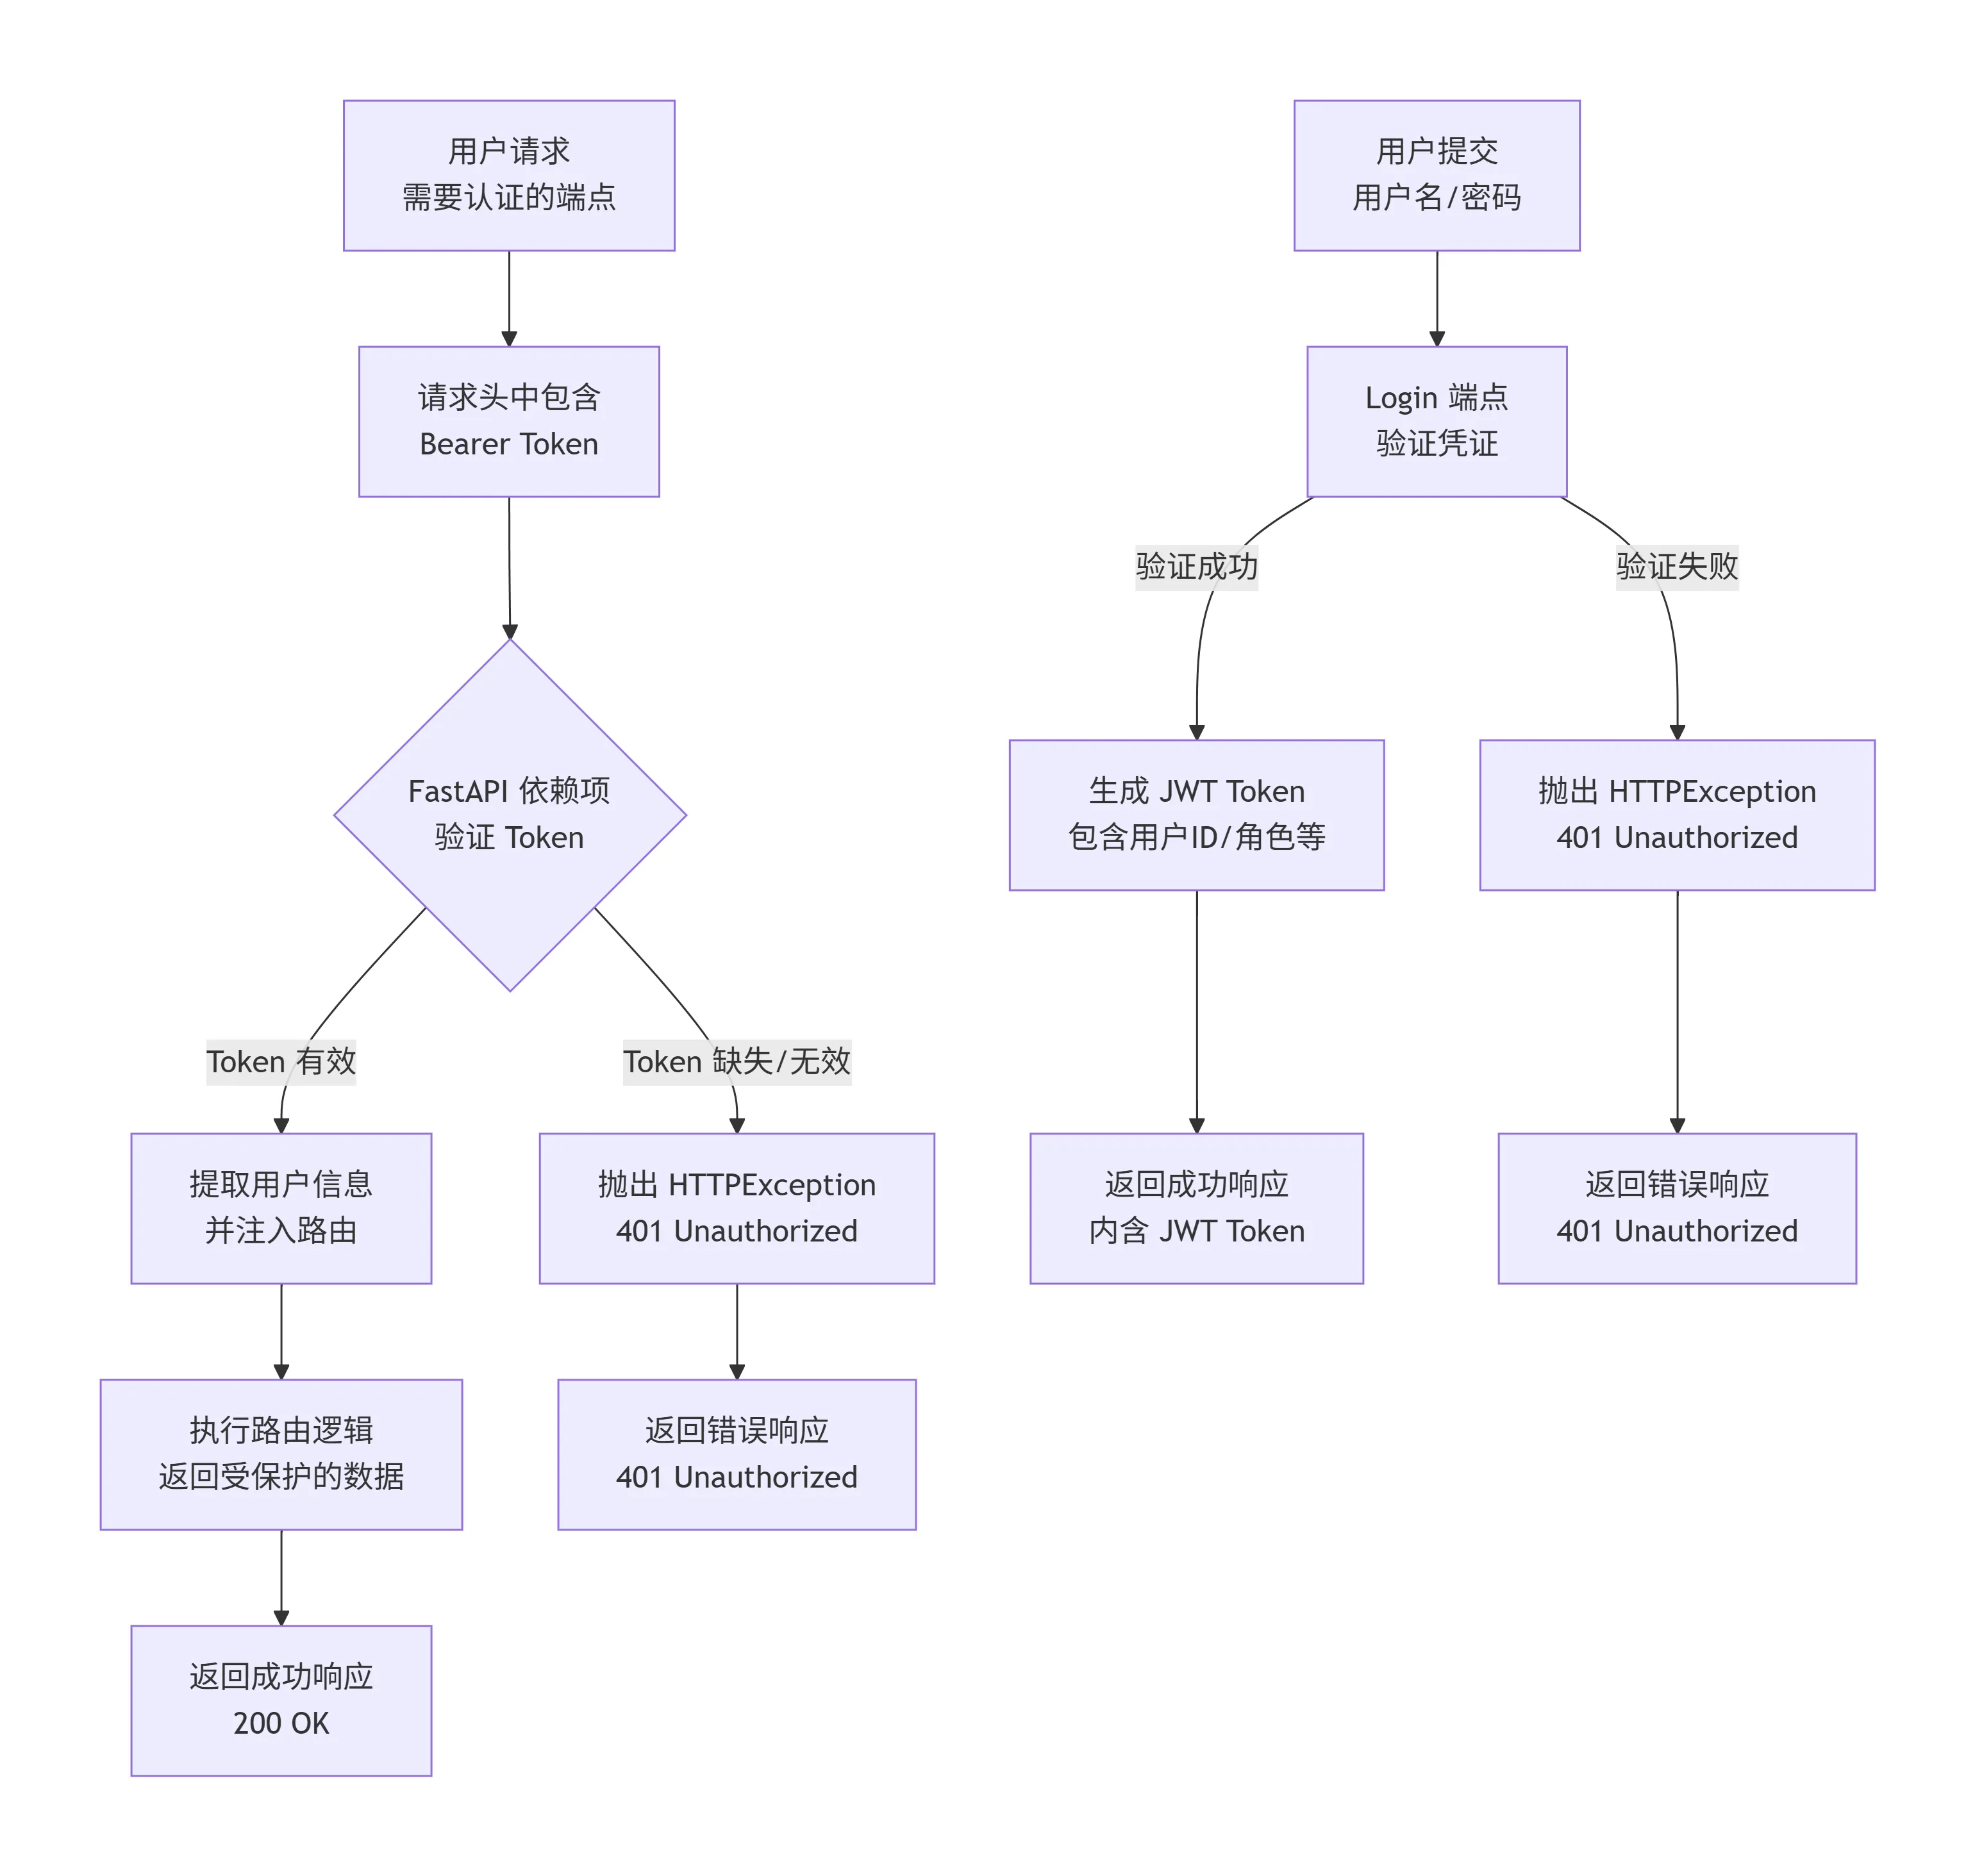
JWT 全称是 Json Web Token,在 python 中我们一般使用 PyJWT 这个包实现 JWT 的编解码操作
安装依赖:
pip install PyJWTa. FastAPI + JWT 认证核心概念#
签名 JWT 由 Header.Payload.Signature 三部分组成:Header 声明类型和签名算法,Payload 保存 sub(主体标识)、exp(过期时间)、iat(签发时间)等声明,Signature 用来验证内容是否被篡改。
密码应保存为哈希并通过密码库验证;JWT 用来证明一次登录后的身份,不代替密码哈希。下面统一使用前面安装的 PyJWT,把签发、验证与当前用户查询分别封装。刷新令牌见“11.4 Refresh_token”。
b. 基本使用#
步骤一:首先在 .env 文件中配置 jwt 环境变量
SECRET_KEY=替换为足够长的随机密钥 # 不要直接使用这个占位值ALGORITHM=HS256 # 签名算法ACCESS_TOKEN_EXPIRE_MINUTES=240 # 过期时间在第 2 章的 Settings 中同时声明 SECRET_KEY: str、ALGORITHM: str、ACCESS_TOKEN_EXPIRE_MINUTES: int。
步骤二:在 security.py 中编写签发与验证函数
from datetime import UTC, datetime, timedelta
import jwtfrom jwt.exceptions import InvalidTokenErrorfrom fastapi import Depends, HTTPExceptionfrom fastapi.security import OAuth2PasswordBearerfrom src.app.core.config import settings
oauth2_scheme = OAuth2PasswordBearer(tokenUrl="/login")

def create_access_token(data: dict) -> str:    payload = data.copy()    payload["exp"] = datetime.now(UTC) + timedelta(minutes=settings.ACCESS_TOKEN_EXPIRE_MINUTES)    return jwt.encode(payload, settings.SECRET_KEY, algorithm=settings.ALGORITHM)

def verify_token(token: str = Depends(oauth2_scheme)) -> dict: try: return jwt.decode( token, settings.SECRET_KEY, algorithms=[settings.ALGORITHM], options={"require": ["sub", "exp"]}, ) except InvalidTokenError as exc: raise HTTPException( status_code=401, detail="令牌无效或已过期", headers={"WWW-Authenticate": "Bearer"}, ) from exc签名算法由服务端配置限定,不能照单全收令牌头声称的算法。sub 使用字符串,exp 在验证时检查。FastAPI JWT 示例、PyJWT 用法
步骤三:在登录视图中,当账号密码校验通过后 create_access_token() 函数生成 jwt 令牌并以 json 数据形式返回
# 项目片段:crud 负责查询账号,verify_password 负责比对密码哈希。from fastapi import HTTPExceptionfrom src.app.core.security import verify_password, create_access_token

def login(db, data):    user = crud.get_user_by_phone(db, data)    if not user or not verify_password(data.password, user.hashed_password):        raise HTTPException(status_code=400, detail="用户名或密码错误")    token = create_access_token({"sub": str(user.user_id)})    return {"token": token, "userId": user.user_id, "phoneNumber": user.phone_number}
步骤四:在 get_current_user() 中通过依赖注入使用 verify_token() 函数
# src/app/core/dependencies.py,项目片段from fastapi import Depends, HTTPExceptionfrom sqlalchemy.orm import Sessionfrom src.app.core.database import get_dbfrom src.app.core.security import verify_tokenfrom src.app.modules.users import crud

def get_current_user(payload=Depends(verify_token), db: Session = Depends(get_db)):    user = crud.get_user(db, payload["sub"])    if user is None:        raise HTTPException(            status_code=401, detail="用户不存在",            headers={"WWW-Authenticate": "Bearer"},        )    return user
这里约定 crud.get_user(db, user_id) 按业务字段 user_id 查询。令牌错误由 verify_token 处理,数据库连接等异常不应被笼统转换成认证失败。
步骤五:在路由中添加全局认证依赖来保护接口
from fastapi import APIRouter, Dependsfrom src.app.core.database import get_dbfrom sqlalchemy.orm import Sessionfrom src.app.core.dependencies import get_current_userfrom src.app.modules.users.models import Userfrom typing import Annotated
person = APIRouter()

@person.get('/persons/self')# 通过依赖注入将get_current_user函数注入,current_user是get_current_user函数返回的对象def get_person_self(current_user: Annotated[User, Depends(get_current_user)], db: Session = Depends(get_db)): return service.get_person_self(current_user, db)这条依赖链是:oauth2_scheme 提取令牌 → verify_token 验证声明 → get_current_user 查询用户 → 路由使用 current_user。任何认证步骤失败,都不会进入业务函数。
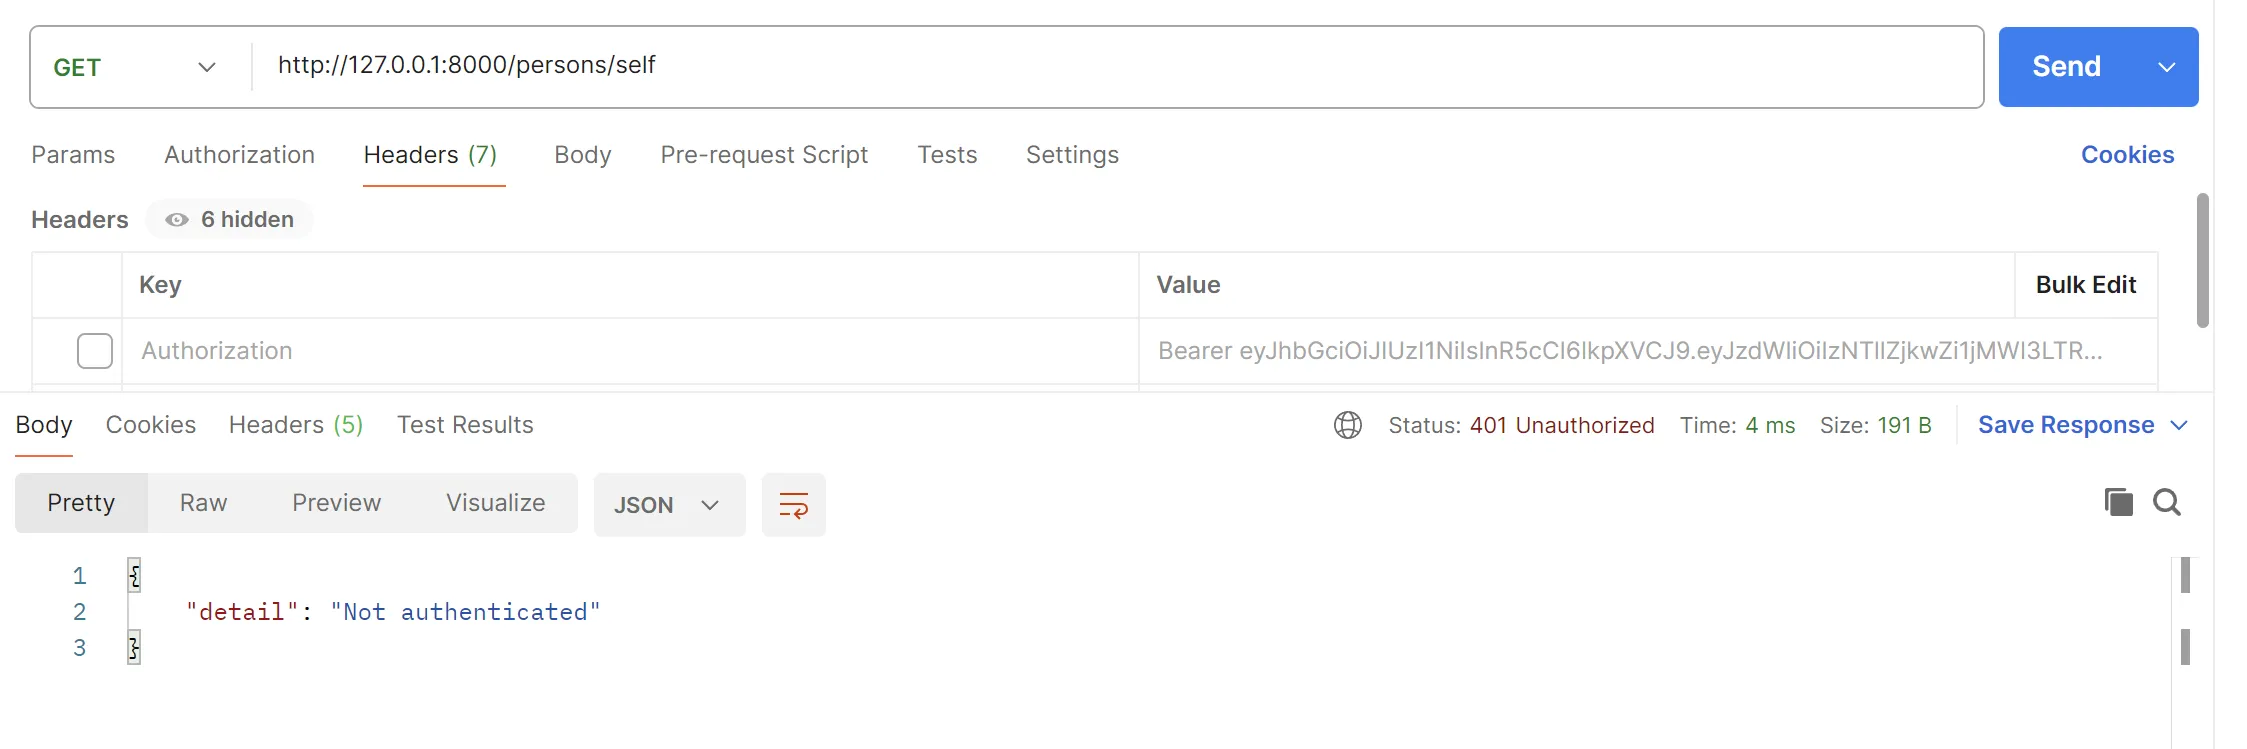
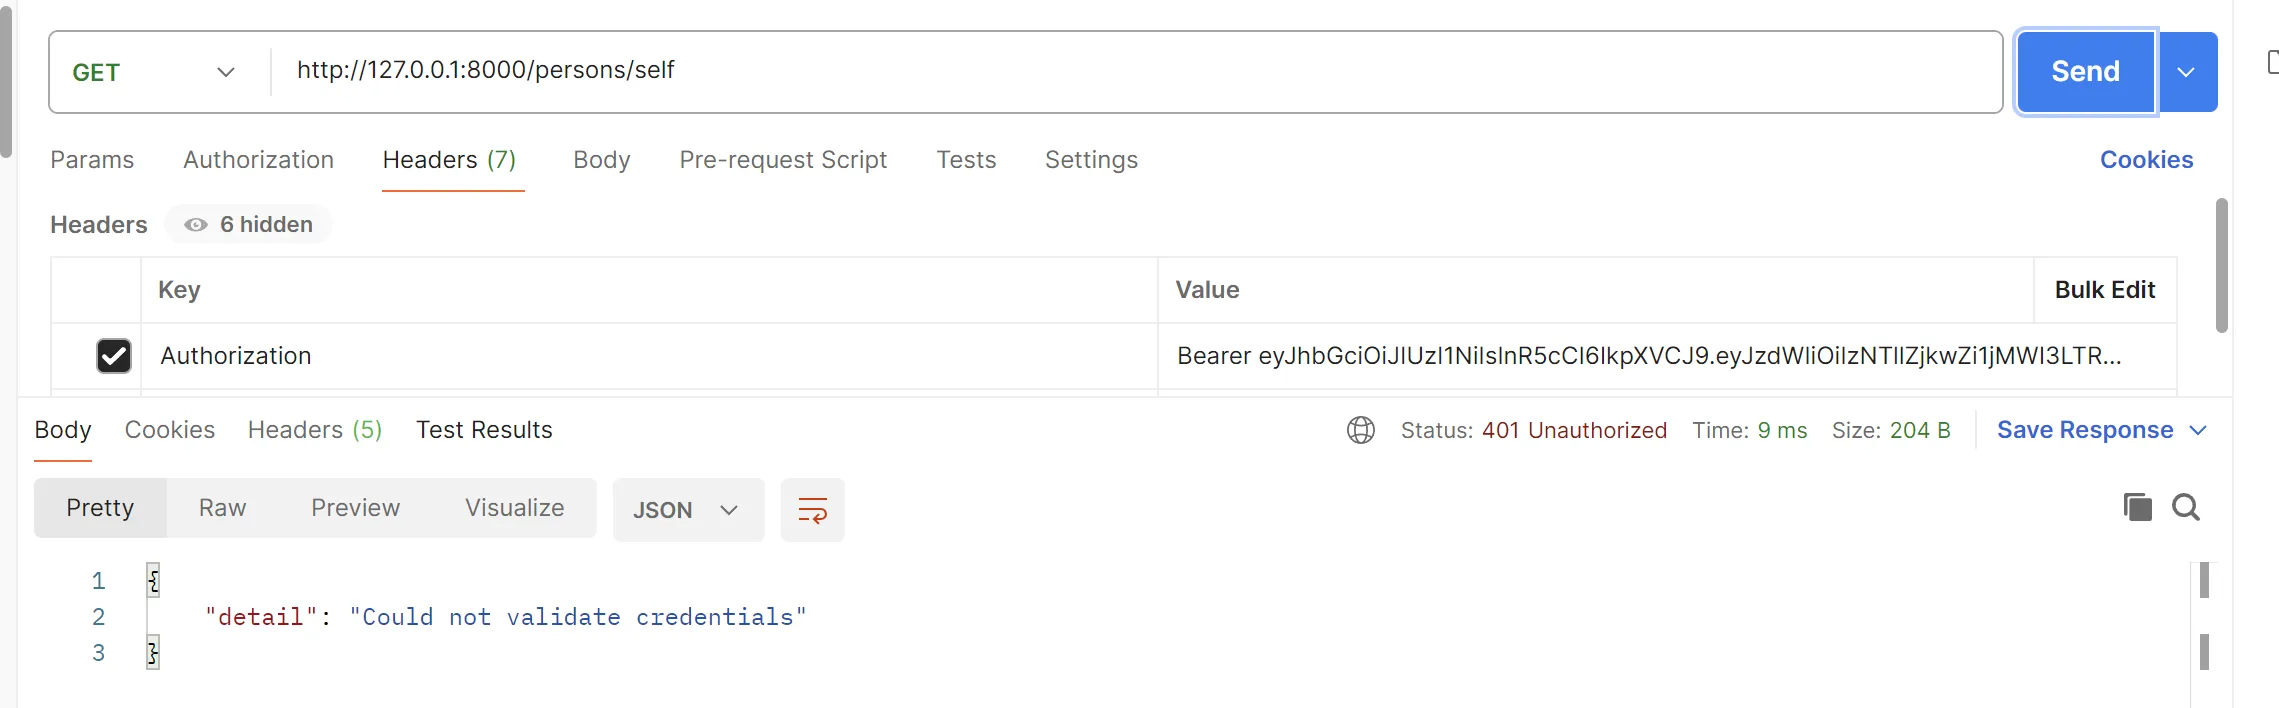
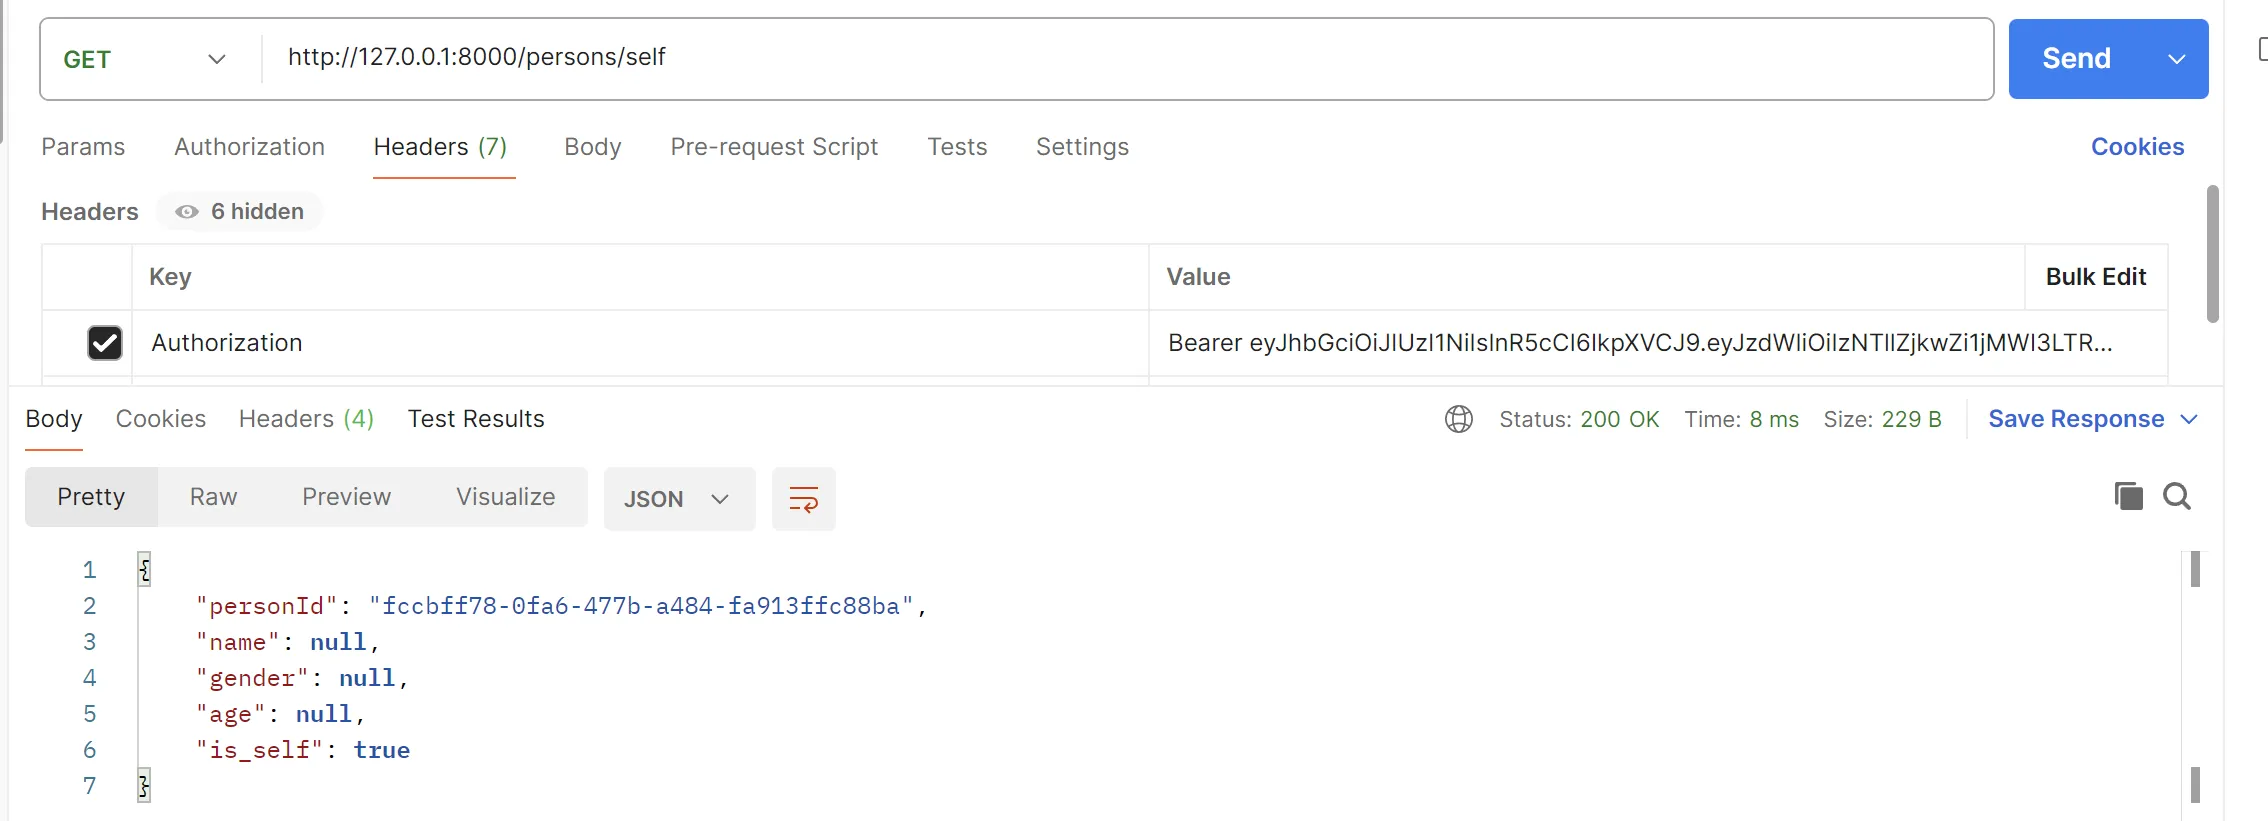
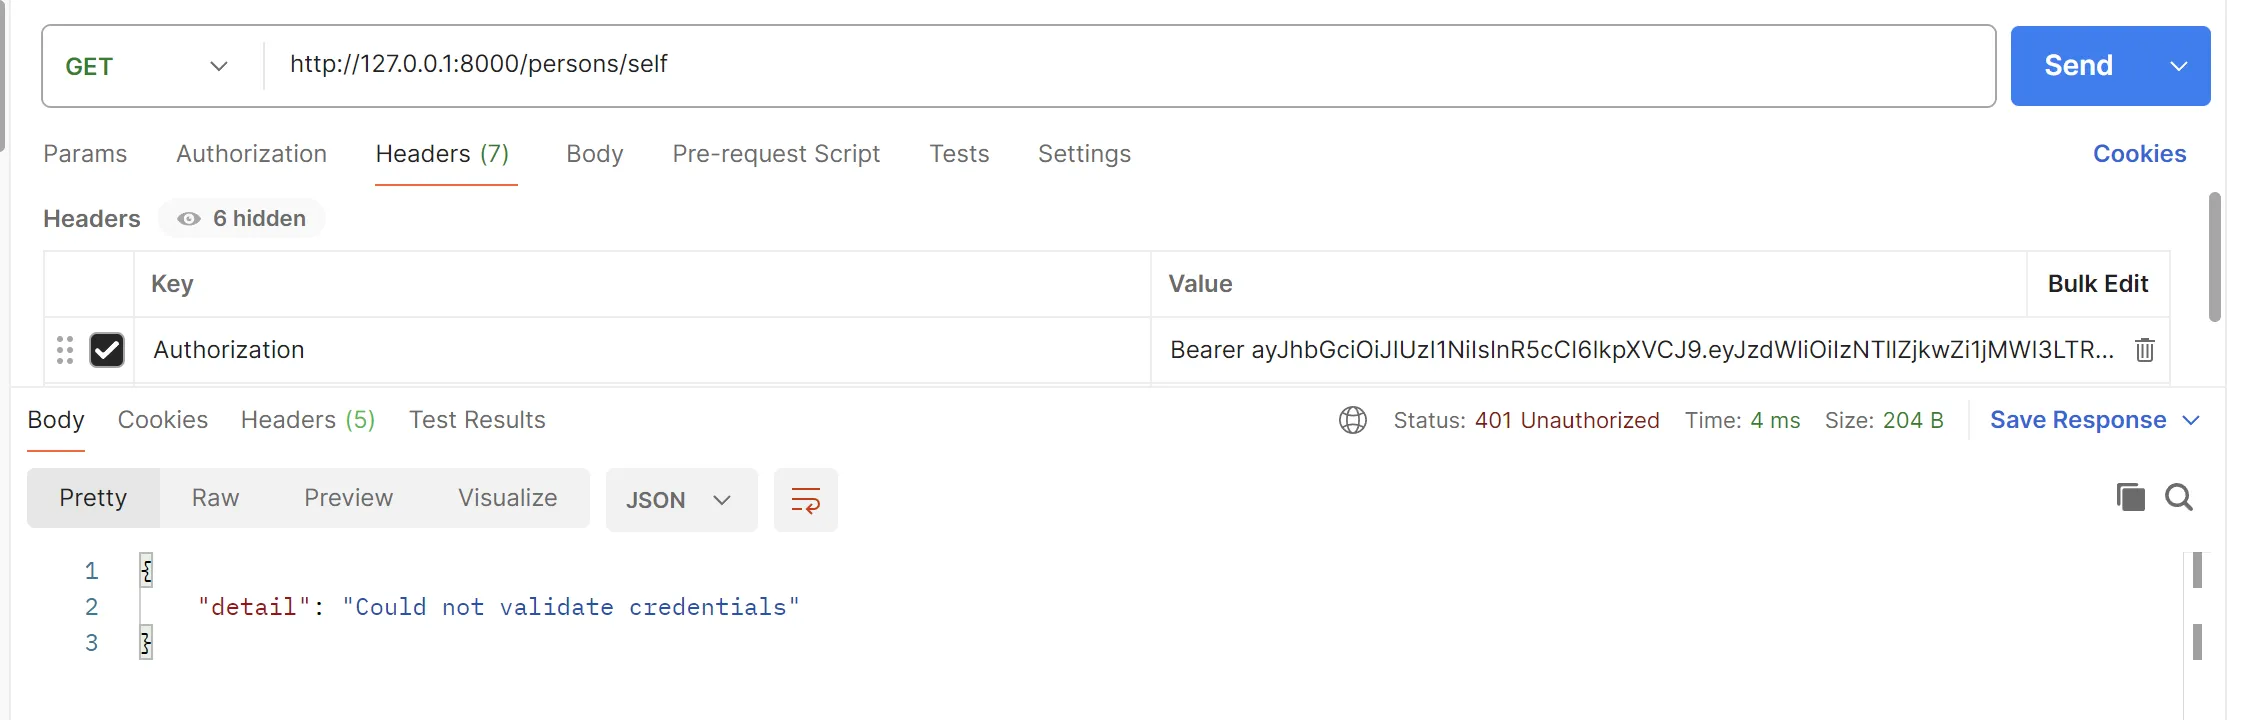
以下截图展示请求测试场景;错误文本和响应字段以当前代码为准。
未携带令牌(即未携带 Authorization 请求头):
携带过期令牌(距发放令牌时间已超过设置的时间):
携带正确未过期令牌:
携带错误令牌(令牌被篡改):
11.4 Refresh_token#
“Access-Token 只有 5 分钟”不等于“用户每 5 分钟就要重新登录”。短期访问令牌配合长期刷新令牌,可以缩短访问令牌泄露后的使用窗口,同时维持登录体验。
a. 双令牌分工#
| 令牌 | 示例有效期 | 作用 | 使用频率 |
|---|---|---|---|
| Access-Token | 5–15 分钟 | 访问受保护资源 | 每次 API 请求 |
| Refresh-Token | 7–30 天 | 换取新的 Access-Token | 需要续期时 |
有效期由业务风险决定。Access-Token 可保存在客户端内存中,通过 Bearer 请求头传递;Refresh-Token 可使用 HttpOnly Cookie,移动端也可使用系统安全存储,例如 Keychain。
b. 自动续期流程#
- 登录成功后,后端签发访问令牌与刷新令牌。
- 客户端访问业务接口时携带访问令牌。
- 访问令牌过期后,客户端调用
/refresh;不要把所有 401 都无限重试为刷新。 - 服务端验证刷新令牌,签发新的访问令牌;客户端更新凭据并重试原请求。
- 刷新令牌也过期或被撤销时,要求重新登录。
刷新成功后,是否也换 Refresh-Token? 可以采用两种策略:
| 策略 | 行为 |
|---|---|
| 固定刷新令牌 | 只签发新 Access-Token,原 Refresh-Token 持续有效直到过期或撤销 |
| 刷新令牌轮换(Rotation) | 同时签发新的 Refresh-Token,并使旧令牌失效;需处理并发刷新和重复使用检测 |
轮换不等于无限延长登录时间,绝对有效期仍可单独限制。两种方式都可以通过服务端保存的状态实现撤销;轮换本身也不等于已经完整解决重放问题。OAuth 2.0 安全实践
c. 如何传递,以及为什么不把访问令牌设得很长?#
刷新令牌可以放在 HttpOnly、Secure Cookie 中,SameSite 根据跨站需求选择;也可以通过请求体或请求头传递。使用 Cookie 时浏览器会自动携带凭据,需要考虑 CSRF;HttpOnly 限制 JavaScript 直接读取 Cookie,但不能消除全部 XSS 风险。传输都应使用 HTTPS。
请求体形式例如:
POST /refreshContent-Type: application/json
{"refreshToken": "xxxxx"}
访问令牌在业务请求中频繁出现,短有效期能限制泄露后的滥用时间。若只验证无状态 JWT 的签名与有效期,服务端就不会知道它已经被撤销;若需立即失效,还要检查黑名单、会话版本或其他服务端状态。
刷新令牌使用频率较低,适合在数据库或 Redis 中保存可撤销的记录,并关联设备信息以辅助异常检测。删除对应记录会阻止后续续期,不会自动让已经签发的 Access-Token 立即失效。
d. 代码实践#
下面采用固定刷新令牌:登录时生成随机刷新令牌,只把它的哈希及用户 ID 存入 Redis,并设置 TTL;刷新时查找该记录,存在则签发新的访问令牌。
这是项目片段,复用前面的 create_access_token、密码校验和数据库依赖;另外需要初始化同步 redis_client,在配置中声明 REFRESH_TOKEN_EXPIRE_DAYS,并准备含 refreshToken: str 字段的请求模型 RefreshToken。
# router.py,项目片段:其他项目依赖同前面的登录示例import hashlibimport jsonimport uuidfrom datetime import timedelta

def refresh_key(token: str) -> str:    return "refresh_token:" + hashlib.sha256(token.encode()).hexdigest()

@user.post("/login")def login(data: UserData, db: Session = Depends(get_db)):    account = crud.get_user_by_phone(db, data)    if not account or not verify_password(data.password, account.hashed_password):        raise HTTPException(status_code=400, detail="用户名或密码错误")
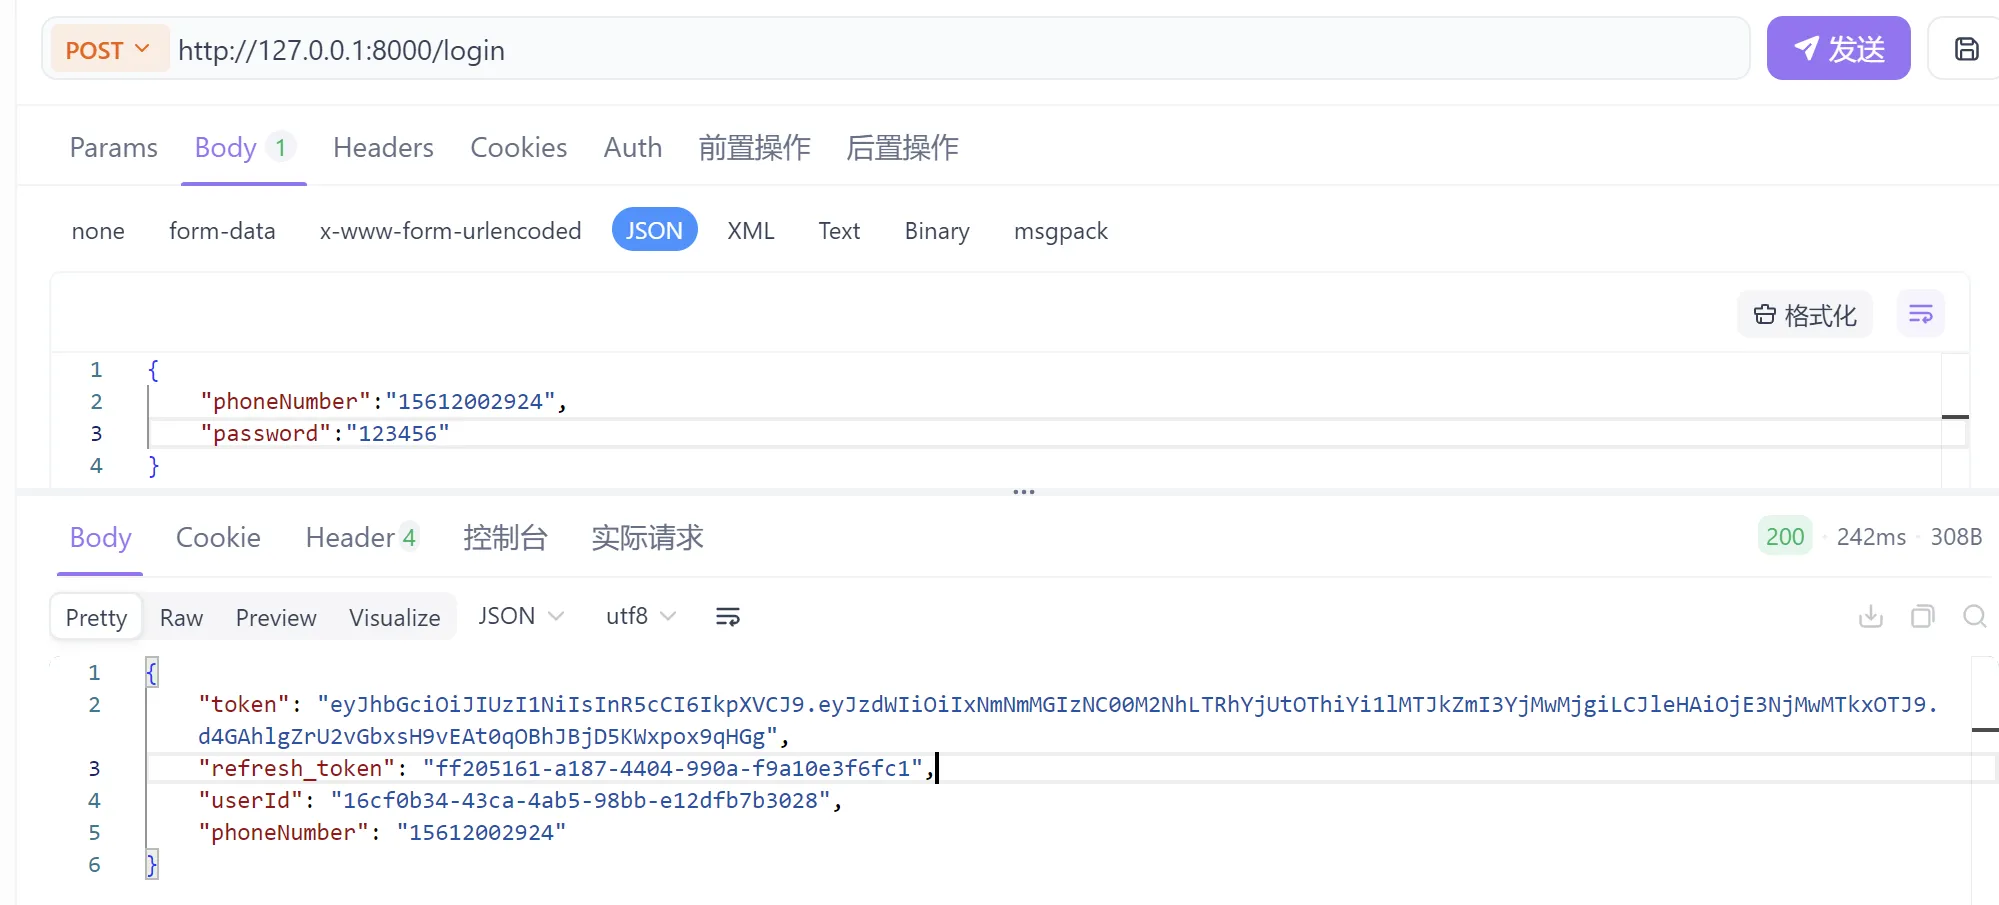
    access_token = create_access_token({"sub": str(account.user_id)})    refresh_token = str(uuid.uuid4())    redis_client.setex(        refresh_key(refresh_token),        timedelta(days=settings.REFRESH_TOKEN_EXPIRE_DAYS),        json.dumps({"user_id": str(account.user_id)}),    )    return {        "accessToken": access_token, "refreshToken": refresh_token,        "userId": account.user_id, "phoneNumber": account.phone_number,    }

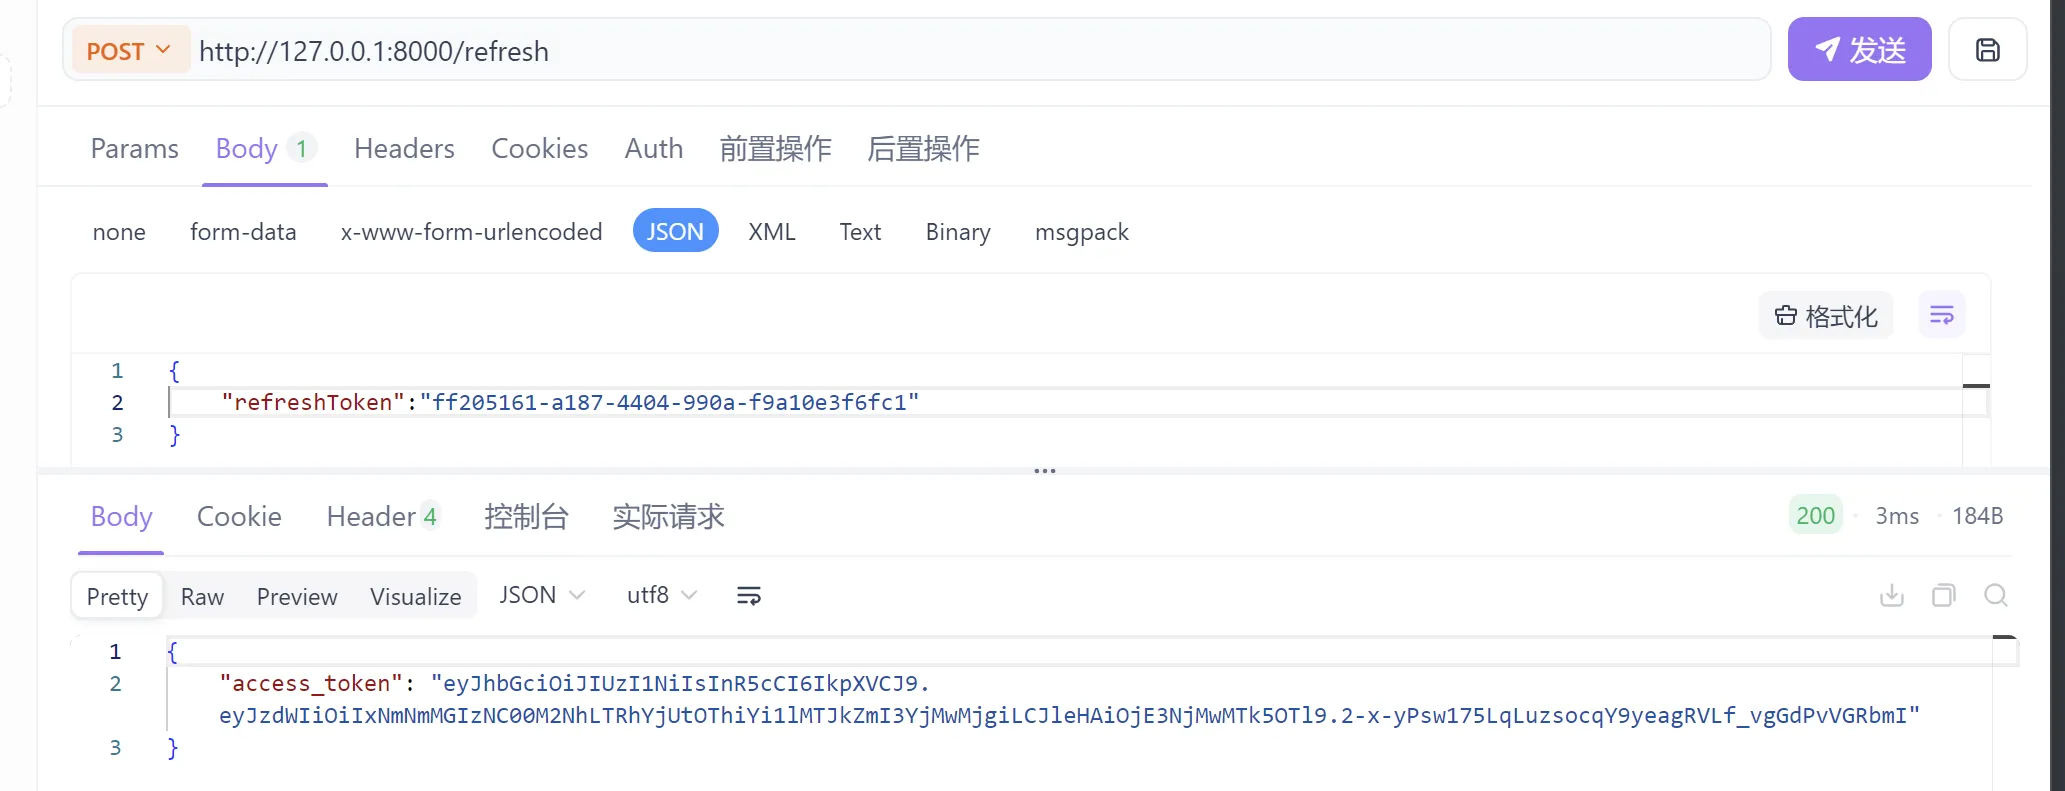
@user.post("/refresh")def get_access_token(data: RefreshToken):    stored_data = redis_client.get(refresh_key(data.refreshToken))    if stored_data is None:        raise HTTPException(status_code=401, detail="刷新令牌无效或已过期")    user_id = json.loads(stored_data)["user_id"]    return {"accessToken": create_access_token({"sub": user_id})}
这段登录路由替换前面仅发单令牌的登录实现,不要同时注册两份 /login。需要撤销时删除相应 Redis 记录;多设备登录则需要额外记录令牌与设备或会话的对应关系。
访问接口进行测试:
登录:
获取新访问令牌:
12.中间件#
12.1 中间件与请求流程#
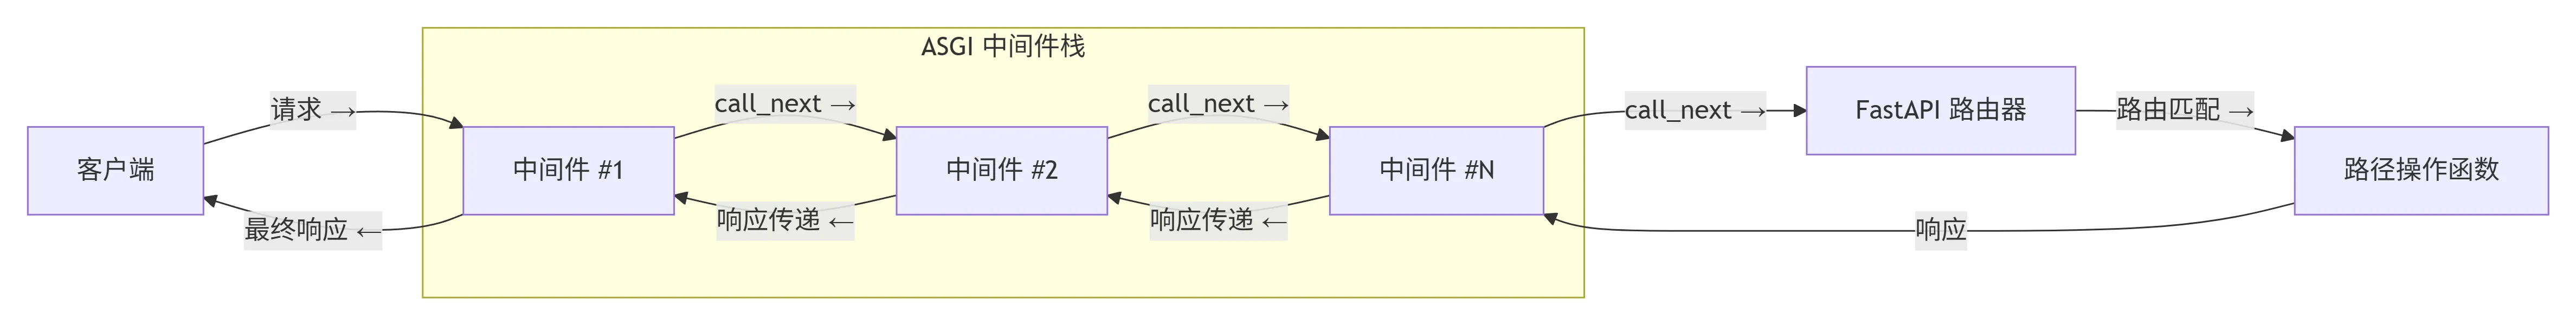
中间件是在请求到达路由前、响应返回客户端前执行的通用逻辑,适合记录日志、计算耗时、处理跨域等。多个中间件形成栈:请求从外向内进入,响应按相反顺序返回。
12.2 基本使用#
a. 使用 @app.middleware("http") 装饰器#
from fastapi import FastAPI, Requestimport time
app = FastAPI()
@app.middleware("http")async def add_process_time_header(request: Request, call_next): start_time = time.perf_counter() response = await call_next(request) process_time = time.perf_counter() - start_time response.headers["X-Process-Time"] = str(process_time) return responsecall_next(request):将请求传递给下一个中间件或路由处理器。- 必须是 异步函数(
async def)。
b. 使用 Starlette 的 BaseHTTPMiddleware 类#
FastAPI 基于 Starlette,因此可以直接使用其提供的中间件基类。注意,使用这种方法需要我们手动将定义的中间件注册到应用中(在 main.py 中使用 app.add_middleware)
from fastapi import FastAPIfrom starlette.middleware.base import BaseHTTPMiddlewarefrom starlette.requests import Request
class CustomMiddleware(BaseHTTPMiddleware):    async def dispatch(self, request: Request, call_next):        # 请求前逻辑        print("Before request")
        response = await call_next(request)
        # 响应后逻辑        print("After response")        return response
app = FastAPI()app.add_middleware(CustomMiddleware)
子类需要重写 async def dispatch(self, request, call_next)。如果只新增 handle() 等其他方法,框架不会调用它;没有提供有效的 dispatch 实现时会报错。这种写法适合复用或封装较复杂的中间件逻辑。
12.3 中间件执行顺序#
后注册的中间件在最外层:请求先经过它,响应最后经过它。 装饰器和 add_middleware() 都遵守注册顺序,没有固定的“装饰器永远在内层”规则。
app.add_middleware(FirstMiddleware)app.add_middleware(SecondMiddleware)# 请求:Second → First → 路由# 响应:路由 → First → Second这里的顺序指应用自行添加的中间件。详情见 FastAPI 中间件文档。
13.权限控制#
13.1 什么是 RBAC?#
RBAC 是一种权限管理模型,通过将权限分配给角色,再将角色分配给用户来实现访问控制。这种模型简化了权限管理,提高了系统的安全性和可维护性。例如系统用户可以是管理员,也可以是普通用户,当是管理员时就可以访问那些需要管理员权限的接口。
13.2 基本使用#
在第 10 章的用户模型中增加角色字段,并通过 Alembic 迁移到数据库:
# 添加到已有 User 模型中,不必重新定义一份用户表。role = Column(String(20), default="user", nullable=False)复用第 11 章的 get_current_user 取得当前用户,再检查角色:
# dependencies.py,项目片段from fastapi import Depends, HTTPExceptionfrom src.app.core.dependencies import get_current_user

async def require_admin(current_user=Depends(get_current_user)):    if current_user.role != "admin":        raise HTTPException(status_code=403, detail="需要管理员权限")    return current_user
# router.py,项目片段:crud、get_db 等由项目提供from .dependencies import get_current_user, require_admin
@user.get("/users")def get_users(db: Session = Depends(get_db), current_user=Depends(get_current_user)): return crud.get_users(db)
@user.get("/users/{user_id}")def get_user(user_id: str, db: Session = Depends(get_db), current_user=Depends(require_admin)): return crud.get_user(db, user_id)get_users 在这个示例中只要求登录;get_user 通过 require_admin → get_current_user 依赖链同时检查身份和管理员角色。实际接口的权限按业务设置,不必照搬这里的访问范围。
14.使用 Docker 部署 fastapi 项目#
14.1 构建 Dockerfile#
# 基础镜像FROM python:3.13-slim# 工作目录WORKDIR /app
COPY requirements.txt .# 安装所有依赖RUN pip install --no-cache-dir -r requirements.txt -i https://mirrors.aliyun.com/pypi/simple/# 拷贝项目COPY . .# 暴露端口EXPOSE 8000
# 启动命令CMD ["uvicorn", "src.app.main:app", "--host", "0.0.0.0", "--port", "8000"]
14.2 基于 Dockerfile 生成项目镜像#
在项目根目录执行,-t 指定镜像名和标签,. 是构建上下文,决定 Docker 能读取哪些文件:
docker build -t ivf-service:latest .14.3 基于镜像运行容器并加载环境变量#
docker run -d -p 8000:8000 --env-file .env --name ivf-app ivf-service:latest| 参数 | 含义 |
|---|---|
-d | 后台运行 |
-p 8000:8000 | 主机端口映射到容器端口,可通过 http://localhost:8000 访问 |
--env-file .env | 将文件中的配置作为环境变量传入容器,并非把文件挂载进去 |
--name ivf-app | 容器名称 |
ivf-service:latest | 用于创建容器的镜像 |
容器启动时执行 Dockerfile 的 CMD,运行 Uvicorn 并监听容器内的 0.0.0.0:8000。
14.4 部署到 linux 主机上#
部署顺序:构建镜像 → 导出并上传 → 在服务器加载镜像 → 准备 Compose、环境变量和前端文件 → 启动服务 → 执行数据库迁移。以下命令中的镜像名需要与实际构建结果一致。
a. 使用 docker save 将项目镜像转为 tar 文件#
docker save -o <输出文件名.tar> <镜像名:标签># 示例docker save -o my-app-v1.0.tar my-app:v1.0执行后,当前目录下就会生成 my-app-v1.0.tar 文件。
b. 使用 scp 将 tar 文件传到主机#
基本语法
scp [选项] <源文件路径> <用户名>@<目标主机IP或域名>:<目标路径># ~ 表示远端登录用户的家目录;root 用户通常是 /rootscp my-app-v1.0.tar root@192.168.50.16:~/c. 将 tar 文件转为本地镜像#
基本语法:
docker load -i <文件名.tar>执行成功后,用 docker images 命令就可以看到被加载进来的镜像。
d. 编写 docker-compose.yml 文件#
services:  frontend:    image: nginx:latest    ports:      - "9980:80"    volumes:      - ./frontend:/usr/share/nginx/html:ro      - ./nginx.conf:/etc/nginx/conf.d/default.conf:ro    depends_on:      - backend    restart: unless-stopped
  backend:    image: ivf-service:latest    ports:      - "8000:8000"    env_file: .env    depends_on:      - mysql    restart: unless-stopped
  mysql:    image: mysql:8.0    ports:      - "3306:3306"    env_file: .env    volumes:      - mysql_data:/var/lib/mysql    command: --character-set-server=utf8mb4 --collation-server=utf8mb4_unicode_ci    restart: unless-stopped
  minio:    image: minio/minio    ports:      - "9000:9000"      - "9001:9001"    env_file: .env    volumes:      - minio_data:/data    command: server /data --console-address ":9001"    restart: unless-stopped
volumes:  mysql_data:  minio_data:
各服务在 Compose 默认网络内可通过服务名通信,例如后端连接数据库时主机名使用 mysql。先准备下面的 .env 以及前端目录、nginx.conf,再启动服务。
e. 编写 .env 文件#
我们的 docker-compose.yml 文件中,容器环境变量的加载方式是 env_file: .env,容器启动时会从同级目录的 .env 文件中加载环境变量。
执行 nano .env 填写应用、MySQL、MinIO 所需的配置,准备完成后运行:
docker compose up -df. 进入项目服务容器进行数据模型的迁移#
执行 docker ps 查看正在运行的容器
执行 docker exec -it 容器id bash 进入容器内部
执行 alembic upgrade head 进行数据模型的迁移
14.5 将前端静态资源部署到 linux 主机上#
前端会将静态资源打包发来,只需接收解压到本地。
a. 将静态资源从本机传输到 linux 主机上#
前面的 Compose 已将 ./frontend 挂载到 Nginx 的 /usr/share/nginx/html。在服务器上创建与 docker-compose.yml 同级的 frontend 目录,再从本机上传构建产物:
scp -r dist/* root@主机ip:frontend目录位置目录内应直接包含 index.html,不要额外套一层 dist/。
b. 编写 nginx.conf 配置文件#
server {    listen 80;    server_name localhost;    client_max_body_size 50M;    location / {        root /usr/share/nginx/html;        index index.html index.htm;        try_files $uri $uri/ /index.html;    }
    location /api/v1/ {        proxy_pass http://backend:8000/api/v1/;        proxy_set_header Host $host;        proxy_set_header X-Real-IP $remote_addr;        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;        proxy_set_header X-Forwarded-Proto $scheme;    }}
c. 修改 nginx 用户对 frontend 目录及其内容的读取权限#
若完成上述步骤后,访问服务发现页面打不开,报下面错误,可能是权限问题
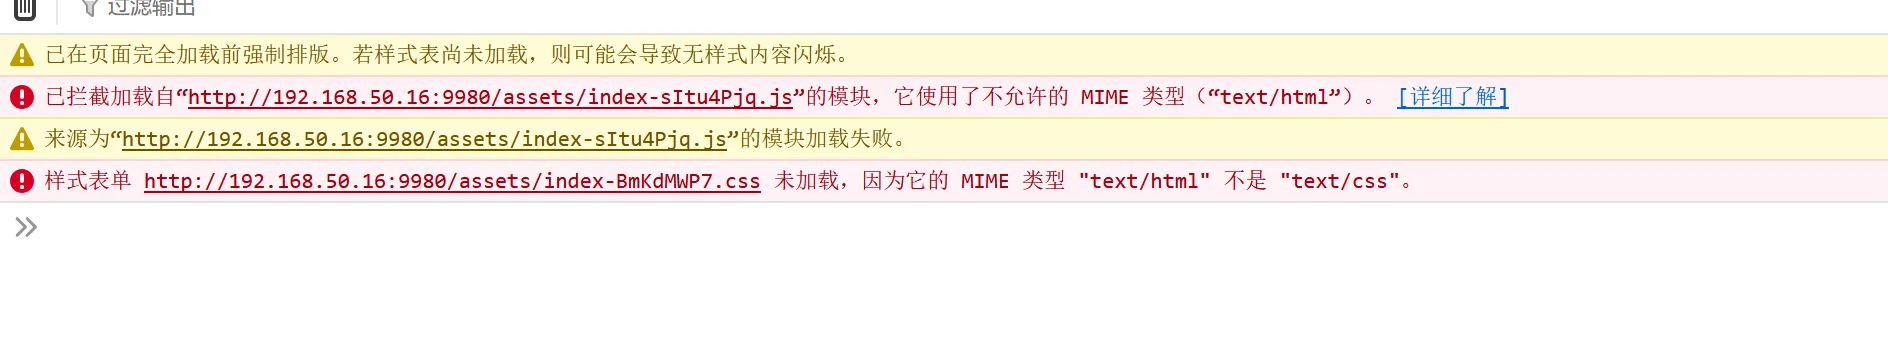
修改权限:
chmod -R 755 frontend/ # 替换为实际静态资源目录14.6 端口、挂载与静态文件访问#
a. 前端服务配置怎样对应实际访问?#
| Compose 配置 | 实际作用 |
|---|---|
ports: ["9980:80"] | 将主机 9980 映射到 Nginx 容器 80 端口,访问服务器的 http://IP:9980 |
./frontend:/usr/share/nginx/html:ro | Nginx 从容器网站根目录读取主机上的前端文件,容器内只读 |
./nginx.conf:/etc/nginx/conf.d/default.conf:ro | 使用主机配置替换容器默认站点配置,容器内只读 |
depends_on: [backend] | 按依赖顺序启动容器,但不保证后端已经准备好接受请求 |
restart: unless-stopped | 容器退出后自动重启,用户手动停止的除外 |
同理,后端的 depends_on: [mysql] 不等于 MySQL 已可连接;需要就绪保证时,使用健康检查及相应依赖条件。Compose 启动顺序
b. 挂载的本质与用途#
挂载让容器内的路径指向外部存储,在 Linux 上与挂载命名空间配合实现。它可以挂载文件,也可以挂载目录:
- 绑定挂载(Bind Mount):映射主机的指定路径,例如
./frontend和./nginx.conf,适合管理静态资源与配置。 - 命名卷(Named Volume):由 Docker 管理,例如
mysql_data、minio_data,适合持久化业务数据。
容器被删除后,其可写层中的数据通常也被删除;外部挂载的数据可独立保留。这样既能持久化数据,也能从主机维护配置,而不必进入容器修改文件。
c. frontend 挂到 html 后,里面看到什么?#
/usr/share/nginx/html 是容器内的目录,也是此 Nginx 配置中的静态网站根目录。挂载后,路径对应关系如下:
主机项目目录 容器内路径frontend/index.html → /usr/share/nginx/html/index.htmlfrontend/style.css → /usr/share/nginx/html/style.cssfrontend/app.js → /usr/share/nginx/html/app.jsnginx.conf → /etc/nginx/conf.d/default.conf这里是让同一份文件通过容器路径可见,不是复制两份后再同步。 镜像里该目录原有的文件会被挂载内容遮住,并未被删除。:ro 只限制容器内写入,主机仍可修改文件。
可进入容器确认内容:
docker exec -it <container_name> ls -la /usr/share/nginx/html主机更新前端文件后通常不需要重建镜像;浏览器缓存可能影响看到更新的时间。修改 Nginx 配置则需要重新加载配置或重启服务。若挂载目录为空、没有 index.html 或缺少读取权限,可能出现 403/404,应检查目录、index 指令和权限。Docker 绑定挂载说明
d. 一次页面访问的完整流程#
- 浏览器访问服务器的
9980端口,经 Docker 端口映射进入frontend容器的80端口。 - Nginx 的工作进程处理请求。访问
/时,根据root、index、try_files找到/usr/share/nginx/html/index.html,该路径对应主机上的frontend/index.html。 - Nginx 读取文件、生成 HTTP 响应并发回浏览器。访问
/api/v1/时,则按proxy_pass转交backend:8000。
端口转发的具体实现取决于 Docker 网络环境;Nginx 也不会为每个请求重新创建一个 worker。
14.7 查看 docker 日志#
# 查看实时日志docker logs -f <容器名或容器ID>
# 查看最近的100行日志docker logs --tail 100 <容器名>
# 查看特定时间段的日志docker logs --since 10m <容器名>
# 查看完整日志docker logs <容器名> > fastapi.log
进入容器内部查看
# 进入容器shelldocker exec -it <容器名> /bin/bash
# 查看应用日志文件(如果FastAPI配置了文件日志)cd /appls -la logs/cat logs/app.log
# 查看系统日志cat /var/log/syslog | grep fastapi