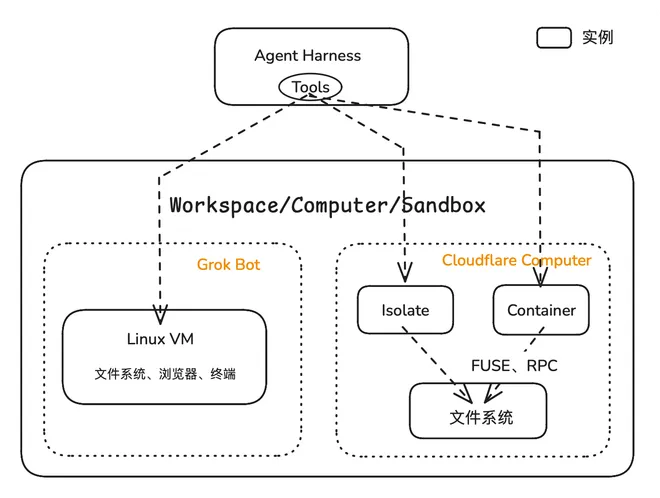
云端 Agent 的差异不在“是不是跑在云上”,而在运行时(Runtime)与工作区(Workspace/Sandbox)是否绑定在同一个实例上。本文从这条主线出发,对比持久化 VM 与存算分离两条路线,并逐层拆解 Grok Bot 与 Cloudflare Computer 的实现。
- 主流模式(存算一体):这类 Agent 本质上是运行在云端虚拟机(VM)或容器里的完整应用。因为要进行文件读写、浏览器自动化等复杂操作,应用环境和数据天然绑定在一起,所以“存”和“算”是合一的。
- 例子:Grok Bot 就是典型,每个 Bot 都运行在一台持久化的云端 Linux 虚拟机上,拥有独立的浏览器、文件系统和终端,计算和存储都在这个云端环境里完成。
- 进阶模式(存算分离):这是一种更高级的架构,将“存储”和“计算”分开管理。计算节点可以按需创建和销毁,数据则存放在独立的、高可用的存储服务中。这种模式成本更低、扩展性更强,但架构也更复杂,多见于企业级平台。
你的理解非常精准,之前的“存算一体 vs 存算分离”这个二分法确实太粗糙了,掩盖了更本质的差异。根据你提供的分析,重新梳理后的准确框架应该是这样:
云端 Agent 的本质是“运行时”与“工作区”的解耦#
云端 Agent 架构有两类,区别在于 Agent 的推理/规划进程(Runtime) 与 Agent 的执行环境(Workspace/Sandbox) 是否绑定在同一个实例上,也就是“存算是否分离”。
| 维度 | Agent Runtime | Workspace(工作区) |
|---|---|---|
| 职责 | 思考、规划、调用工具、决策(LLM 推理 + 编排逻辑) | 读写文件、执行命令、安装依赖、运行代码、访问浏览器 |
| 状态性 | 无状态(不保存任何持久化数据) | 有状态(存储产物、文件、环境配置) |
| 生命周期 | 请求来则拉起,响应完即可销毁 | 常驻云端,无 Agent 实例时自动休眠 |
模式一:运行时 + 工作区绑定(传统云端 Agent)#
传统云端 Agent 和本地单机 agent 一样,这是最直接的实现方式,也就是“存算一体”:
- 形态:一个持久化的云端 VM 或容器,里面同时跑着 Agent 的逻辑代码和完整的执行环境(文件系统、终端、浏览器)。
- 特点:运行时和工作区强绑定,Agent 进程常驻,随时待命。
- 问题:
- Agent 不是 7x24 小时都在思考,但 VM 必须一直开着,计算资源浪费严重。
- 如果 VM 崩溃,状态和产物一起丢失(因为存算绑在同一个实例上)。
- 典型例子:Grok Bot。n 个 Bot 对应一台持久化的云端 Linux VM,Agent 运行时和执行环境都在同一台机器上。
Grok Bot 确实部分解决了你提到的两个问题,但它的解决思路和你设想的“存算分离”模式不同。它选择了一条更直接的路径。
问题一:计算资源浪费#
你没有理解错,Grok Bot 确实解决了“VM 一直开着”的资源浪费问题,但方式不是“存算分离”,而是将成本完全转嫁给了用户。
- 对用户而言,没有浪费:用户支付的订阅费(如 SuperGrok Heavy 约 $300/月)买到的就是“Bot 7×24 小时在线”的服务。对用户来说,资源被充分利用了。
- 对 xAI 而言,风险可控:xAI 承担着底层 VM 持续运行的成本。他们通过较高的订阅价格和多租户隔离的底层架构来对冲风险,因为一个用户的 VM 崩溃不会影响其他用户。
所以,Grok Bot 没有在技术上解决资源浪费,而是在商业模式上解决了它——让愿意付费的用户来承担这个成本。
问题二:状态和产物丢失#
在这个问题上,Grok Bot 通过“持久化 VM”的设计,从根本上解决了问题。
它的 VM 不会在任务间重置,其核心设计就是持久化。所有状态——文件、浏览器登录态、终端会话、长期记忆等——都保存在这个持久化的云端环境里。
- VM 崩溃怎么办? xAI 官方文档指出,VM 本身是持久化(persistent) 的,通常会配备持久化存储,即使底层实例重启,数据也能恢复。
- 状态不丢:正是因为这种设计,Bot 才能实现“合上电脑照样干活”,因为所有工作和状态都在云端的 VM 里持续运行。
总结#
总而言之,Grok Bot 并没有采用“存算分离”的架构来解决问题。它的方案是:
- 针对资源浪费:用商业模式解决,将成本转嫁给付费用户,让“一直开着”成为一种付费服务。
- 针对状态丢失:用持久化云 VM 解决,通过一个永不重置的云端环境来保存所有状态和产物。
因此,可以把它看作 “运行时与工作区绑定”模式的一个商业化、高可用实现。它通过付费订阅和强大的基础设施,让“资源浪费”成为用户可以接受的“服务成本”,并确保了状态的持久性。
模式二:运行时 + 工作区分离(现代云端 Agent)#
这是你第一段描述的“进阶模式”,也是 Cloudflare Computer 等项目正在做的事:
- 形态:Agent Runtime 是无状态的计算实例,按需拉起,处理完请求即可销毁。Workspace 是独立的有状态存储/执行层,常驻在云端,Agent 实例通过 API 或远程协议(如 SSH、文件系统挂载)访问它。
- 关键机制:
- Agent 实例不保存任何状态,所有持久化数据(文件、会话、环境配置)都写回 Workspace。
- Workspace 在没有 Agent 实例连接时自动休眠,节省资源。
- 即使 Agent 实例崩溃,Workspace 中的数据完好无损,新的实例可以无缝接管。
- 优势:
- 资源弹性:无状态实例可以快速扩缩容,按请求付费。
- 状态持久化:工作区独立于计算实例,数据安全有保障。
- 故障隔离:计算实例崩溃不影响存储层。
- 典型例子:Cloudflare Computer、E2B(提供云端代码执行沙箱)、Modal。
最终总结(一句话区分)#
- 绑定模式(Grok Bot):把 Agent 当成一台“永远开着的电脑”,运行时和工作区绑在一起。
- 分离模式(Cloudflare Computer):把 Agent 拆成“按需调用的脑”(无状态 Runtime)和“常驻休眠的笔记本”(有状态 Workspace),两者通过网络通信协作。
你之前说的“存算分离”是这种分离模式的一个子集(存储层分离),但更准确的表述应该是“运行时与工作区解耦”,因为 Workspace 不仅仅是存储层,它还可以执行命令、安装依赖,是一个完整的执行沙箱。
“Your agent needs a computer, not a container.”#
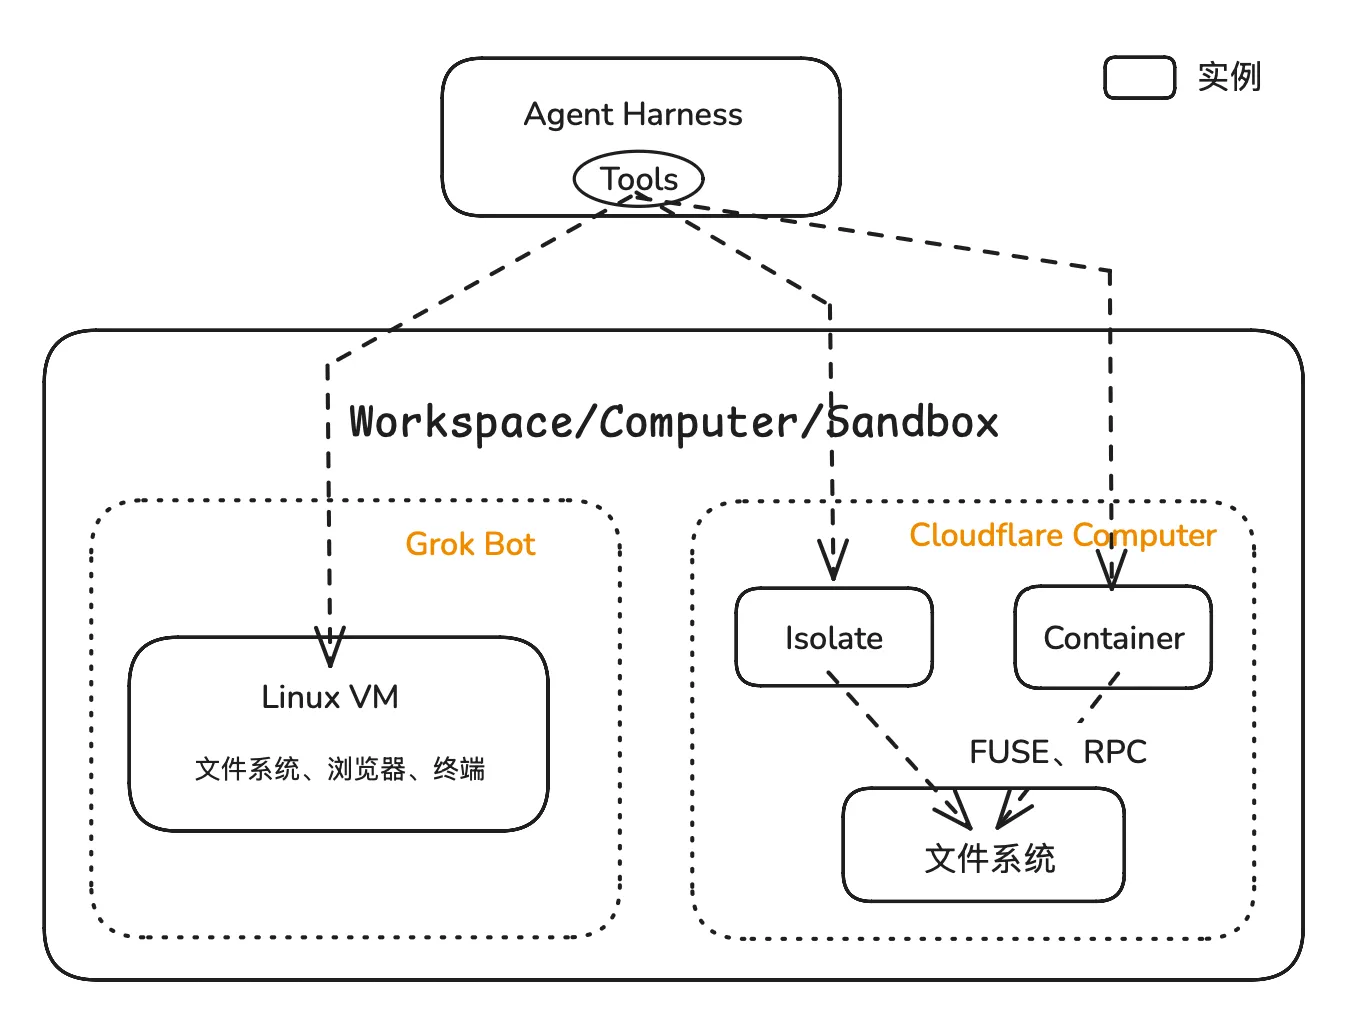
云端 Agent 比较直接的理解是存算分离,这里的算是 agent 运行所需的运算,存是各种状态、产物的存储,也就是将本地 Agent 的‘状态存储’与‘计算推理’从同一进程实例中解耦。
但实际上更准确来说云端 agent 是把 agent 运行中思考、规划、调用工具和执行工作的工作区 sandbox 分开。因为外部工作区不只是存储层,也可以是既能读写文件、又能执行命令、安装依赖的容器环境。云端 Agent 的无状态运行实例可以随时拉起,有状态的存储实例则常驻在云端,没有 Agent 实例运行时自动休眠。
至于为什么不是存算一体,那样的话 agent 运行时和执行工作区绑定在同一个实例上,由于 Agent 肯定不是一直在运行,常驻实例会导致计算资源的浪费,同时一旦实例崩溃了会导致持久化的状态包括存储产物丢失。
Agent Harness 是“大脑”,Tools 是“手”,Computer/Workspace/Sandbox 是“操作环境”。
Agent 有两部分工具,一部分是 Agent 自带的,一部分则是外部 sandbox 提供的,RPC、HTTP、MCP 等。
标题这句话不是说 Container 没用,而是说 Agent 需要的是一个持续存在、可观察、可操作的工作环境,而不只是一次性的命令执行器。
Computer 关注 Agent 的体验和状态:
- 有持久文件;
- 有 shell、浏览器和工具;
- 有登录会话;
- 可以暂停后恢复;
- 可以在同一个环境中继续工作。
Container 只是实现这些能力的一种底层后端,而且通常比较重。
- Cloudflare Computer 的方向是把 Cloudflare 服务器提供的 Durable Object(其实就是一个有状态的 Worker 实例)封装成一个 workspace 统一工作区,提供了执行命令的运行后端和以 SQLite 为基础的文件系统,也可以链接远程的 R2 对象存储来保存大文件。让 Agent 先使用便宜的 Isolate 运行后端,只有少数操作切换到 Container。
- Grok Bot 项目的工作区更重,直接就是一个完整的 Linux VM 系统,包含文件系统、浏览器、终端等,Agent 可以通过 MCP、Browser Use、Computer Use 等方式操作这台电脑。
| 对比维度 | Container | Cloudflare Computer |
|---|---|---|
| 本质 | 隔离的 Linux 命令执行环境 | 面向 Agent 的完整电脑抽象 |
| 主要能力 | Shell、进程、系统工具、依赖安装 | 文件系统、持久化工作区、命令执行、Git、工具封装 |
| 状态 | 默认随容器生命周期变化 | 工作区状态由 DO SQLite/R2 持久化 |
| 关系 | 可以作为 Computer 的运行后端 | 可以选择 Container,也可以选择其他运行后端 |
隔离层次#
Sandbox、Container、Linux VM、Computer/Workspace 不是同一层概念:
Linux VM 运行环境 / 虚拟硬件边界Container 运行环境 / 共享宿主内核Sandbox 权限与影响范围的控制机制或产品封装Computer / Workspace Agent 可持续工作的用户抽象其中 Sandbox 是最容易被误解的词:它可能由操作系统权限、Container、MicroVM 或完整 VM 实现。
运行流程#
- 网关接收用户 WebSocket / SSE 请求
- 从数据库加载 Prompt 和配置
- 创建临时的 Worker
- 从向量库检索记忆,拼接上下文
- 调用 LLM,调用工作区/Sandbox 提供的各类工具
- 中间状态写入 Checkpoint(支持断点恢复)
- 空闲时回收 Sandbox Worker,产物上传对象存储
用户关闭前端不会停止云端 Agent 的运行,唯一终端的方式是用户发起中断或者云端的任务执行完成、结果写入存储,当用户端不在运行时,可以配置主动通知通过邮件或者 IM(Instant Messaging) 主动推送。
存算分离#
存算分离,简单来说就是把 Agent 的”记忆和状态”(存)与”思考和执行”(算)从同一个进程/实例中拆分开来,让它们各自独立管理、独立伸缩。
1、为什么要分离?
在本地或早期的 Agent 架构中,提示词、工具、对话记录、推理逻辑全部跑在同一个进程里——存算一体。这种方式简单直接,但一旦放到云端、面向多用户、长时间运行的场景,就会暴露出一系列根本性矛盾:
- 生命周期错配:Agent 任务可能持续数小时甚至数天,中间还可能暂停等待用户确认。但传统云服务的实例生命周期往往被 HTTP 连接绑定,连接一断实例就回收,中间状态全丢。
- 资源浪费严重:为了维持连接不让实例被回收,只能让执行实例”永远在线”,实际计算时间可能只占一小部分,造成高达 18 倍的资源浪费。
- 扩缩容不灵活:存储需求(对话历史、记忆向量)和计算需求(LLM 推理、工具执行)的增长曲线完全不同,绑在一起就无法各自按需伸缩。
| 维度 | 存算一体 | 存算分离 |
|---|---|---|
| 弹性 | 存储和计算一起扩缩,不灵活 | 各自按需伸缩 |
| 成本 | 实例常驻,资源浪费严重 | 计算按需使用,存储按量付费 |
| 可靠性 | 连接断开即任务死亡 | 状态持久化,支持断点续跑 |
| 安全 | 工具执行可能影响宿主机 | 沙箱隔离,零信任管控 |
| 升级 | 牵一发动全身 | 各层独立升级,互不影响 |
2、分离之后是什么样子?
宏观上,云端 Agent 的架构被拆成两大层:
1、存储层(“存”)
负责一切需要持久化的东西,按数据类型进一步细分:
-
热状态(当前任务的 Step、Plan、Checkpoint)→ Redis 等内存数据库
-
对话/任务记录 → 关系型数据库(如 Postgres)
-
长期记忆 → 向量数据库(如 Milvus、pgvector)
-
工作产物(用户文件、工具、动态 Skills)→ 对象存储(如 S3/OSS)
对象存储的本质是一个“扁平的、全球性的键值对(Key-Value)仓库”。
S3 是 AWS 提供的对象存储,R2 是 Cloudflare 提供的、兼容 S3 API 的对象存储。两者都按 Bucket 和 Object 管理文件。还有阿里云的 OSS 等。
Terminal window Bucket(桶)└── Object(对象)├── Key:文件名/路径字符串(如 `/workspace/index.js` 或 `user-123/photo.jpg`)├── Value:文件的实际二进制内容(字节流)└── Metadata:附加属性(元数据),如 Content-Type、ETag、大小、上传时间它能存啥?能存一切二进制字节流(Anything as bytes)。
- 文本文件(.txt, .js, .json)
- 图片/视频(.jpg, .mp4)
- 压缩包(.zip)
- 甚至整个 SQLite 数据库文件本身!
它不能存啥?
不能存“正在被高频随机读写”的数据(比如 Redis 缓存),也不能存“需要原地修改某一行”的数据(比如 MySQL 的表)。因为对象存储是“整体写入,整体覆盖”(PutObject),不支持在文件中间追加内容(除非分片上传,但那也是全量替换)。
2、计算层(“算”)
负责一切需要”动起来”的东西:
- LLM 推理调用
- 上下文拼接与 Prompt 组装
- 工具调用与代码执行
- 决策与规划逻辑
计算层通常是无状态的,运行在云端沙箱(Sandbox)中,按需创建、用完即回收。
mini-swe-agent#
mini-SWE-agent 本质上是“让语言模型持续生成 Bash 命令,并在某个执行环境中运行这些命令”。用来验证一个问题:
如果给语言模型一个 Shell,并提供可靠的执行环境,模型本身是否已经能够完成大部分软件工程任务?
执行环境可以是:
- 宿主机:
subprocess.run - Docker:
docker exec - Bubblewrap
- SWE-ReX、Modal 等远程沙箱
核心循环是:
任务 ↓模型生成 Bash 命令 ↓沙箱环境执行命令 ↓环境返回 stdout、stderr、return code ↓模型根据结果生成下一条命令沙箱环境的生命周期:
Agent 初始化 └── docker run 创建一个长期存活的容器每个动作 └── docker exec 在同一个容器中执行Agent 结束 └── stop / rm 清理容器不过“沙箱”主要解决的是执行隔离,不代表系统自动具备完整安全性。实际安全程度取决于 Docker 权限、网络、挂载目录、环境变量和用户权限配置。
这种设计可以概括为:
- 只有 Bash 一个工具;
- 每次动作通过独立进程执行;
- 历史消息线性追加;
- Agent 本身只负责协调模型和环境。
命令行 / 运行脚本 │ ▼一个 Agent: 控制循环、历史、限制、终止+ 一个 Model 接口: 请求模型、解析动作、格式化观察结果+ 一个 Environment 接口: 执行 Bash 命令 ├── LocalEnvironment └── DockerEnvironment+ 一个 Bash 动作+ 一条线性消息历史minisweagen├── agents/ Agent 控制流程├── environments/ 命令执行环境├── models/ 大模型接口和动作处理├── run/ CLI 和批处理入口└── config/ 默认配置和提示词典型的 Python 调用方式如下:
agent = DefaultAgent(    model=LitellmModel(...),    env=LocalEnvironment(),)
result = agent.run("修复项目中的 bug")
Cloudflare Computer#
- DO 是 Cloudflare 的有状态基础设施,提供实例身份、生命周期和 SQLite 持久化存储;
- Cloudflare Computer SDK 基于 DO 的持久化层(额外的 R2)及具体运行后端,封装一套统一的文件、命令和 Git 操作 API 作为 Workspace 工作区,即 Agent 的“云端电脑”;
- Agent 不直接操作 DO,也不直接操作 SQLite/R2,而是通过 Workspace API 控制云端电脑,操作文件、执行命令和调用 Git。
1、Worker、DO(Durable Object)#
Cloudflare 在全球有成千上万台物理机,收到你的请求后,它会随机抓一个闲着没事干的“临时工”(Worker 进程)来跑你的代码。
普通 Worker 更像一次性的无状态请求处理器:请求来了就执行,执行结束后内存中的状态不能依赖。而 Durable Object(DO)是一种特殊类型的 Cloudflare Worker。
这里的“特殊”,主要在于它是按唯一名称或 ID 寻址的、有状态(带持久化存储)的 Worker:
- 每个 DO 实例有自己的持久化状态,底层可以使用 DO 自带的 SQLite 存储。
- 同一个 DO 实例由同一个唯一 ID 标识;同一个用户的请求可以始终路由到同一个实例。
- 任意数量的 Worker 都可以通过绑定访问同一个 DO。
- DO 内部以单线程方式处理请求,适合做单个用户、房间、任务或工作区的状态协调。
- 实例空闲时可以被回收,但 SQLite 中的数据仍然保留;下次请求到来时,实例会重新唤醒。
Worker 配置中的绑定,就是 Worker 访问 DO 的“门禁卡”:
{ "compatibility_flags": ["nodejs_compat"], "durable_objects": { "bindings": [ { "name": "Agent", "class_name": "Agent" } ] }, "migrations": [ { "tag": "v1", "new_sqlite_classes": ["Agent"] } ]}定位和调用 DO 的过程可以概括为:
- Worker 用
env.Agent.idFromName("user-123")为用户生成稳定的实例 ID。 - Worker 用
env.Agent.get(id)取得DurableObjectStub。 - Worker 通过 stub 调用 DO 的方法;实例如果尚未运行,会被 Cloudflare 唤醒。
- DO 在自己的执行环境中完成逻辑,并把状态写入 SQLite。
- DO 返回结果;空闲后实例可以回收,数据下次仍可继续使用。
因此,Worker 是无状态的入口和路由层,DO 是有状态的执行和协调层。Worker 可以负责鉴权、参数校验和定位,DO 负责修改自己的持久化状态。
2、Cloudflare Computer#
Cloudflare Computer 则是一个 npm SDK,基于 DO 的持久化层(额外的 R2)及具体运行后端,封装一套统一的文件、命令和 Git 操作 API 作为 Workspace 工作区,即 Agent 的“云端电脑”。让 Agent 可以像使用一台电脑一样完成工作,并把工作产物持久化下来。
| 能力 | 作用 |
|---|---|
Workspace | 一台云端电脑的总控台 |
ws.fs | 读取、写入和编辑文件 |
ws.runtime.exec | 把命令交给 Isolate、Container 等 runtime 后端执行 Shell 或程序 |
ws.git | 执行 Git 相关操作 |
createAITools(workspace) | 把电脑能力包装成 LLM 工具 |
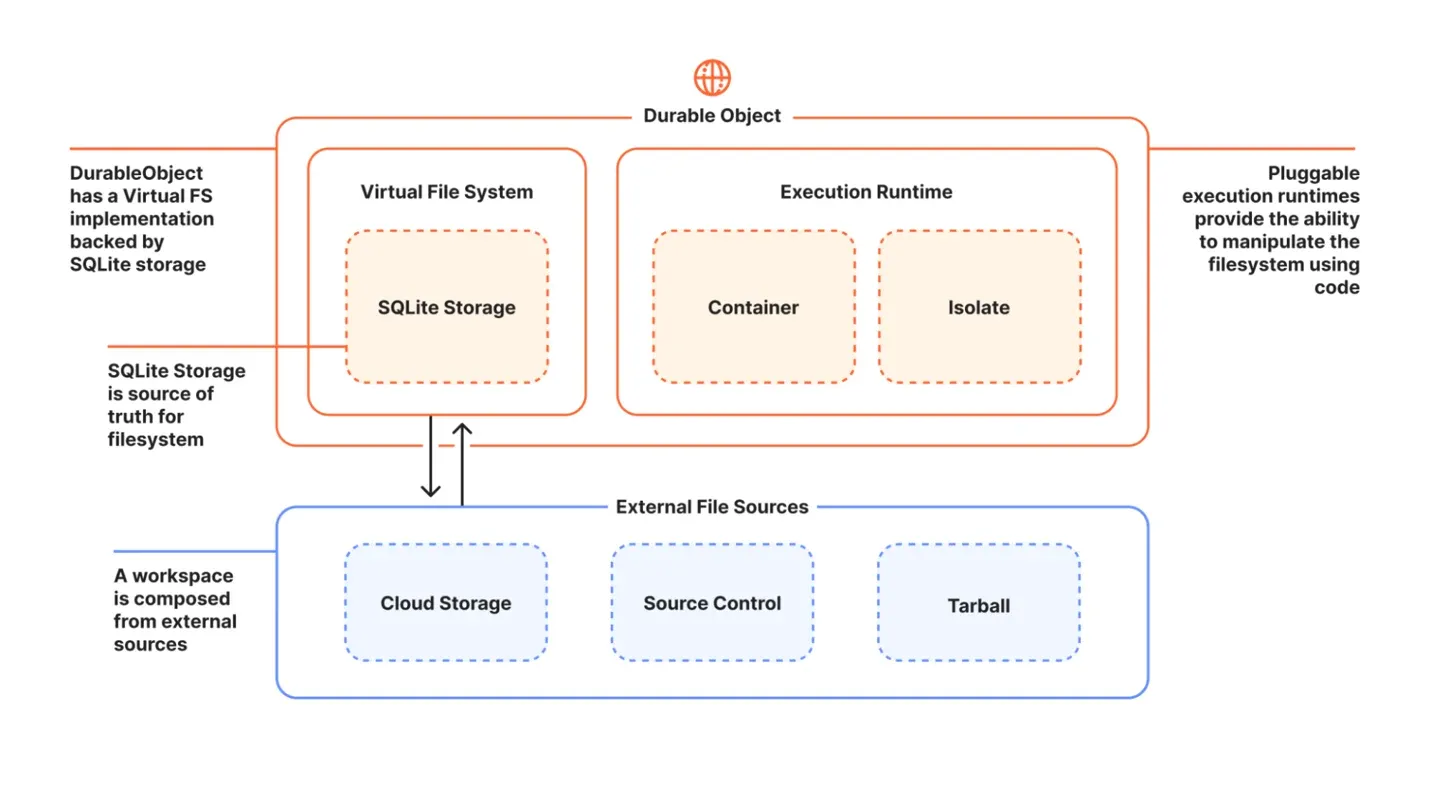
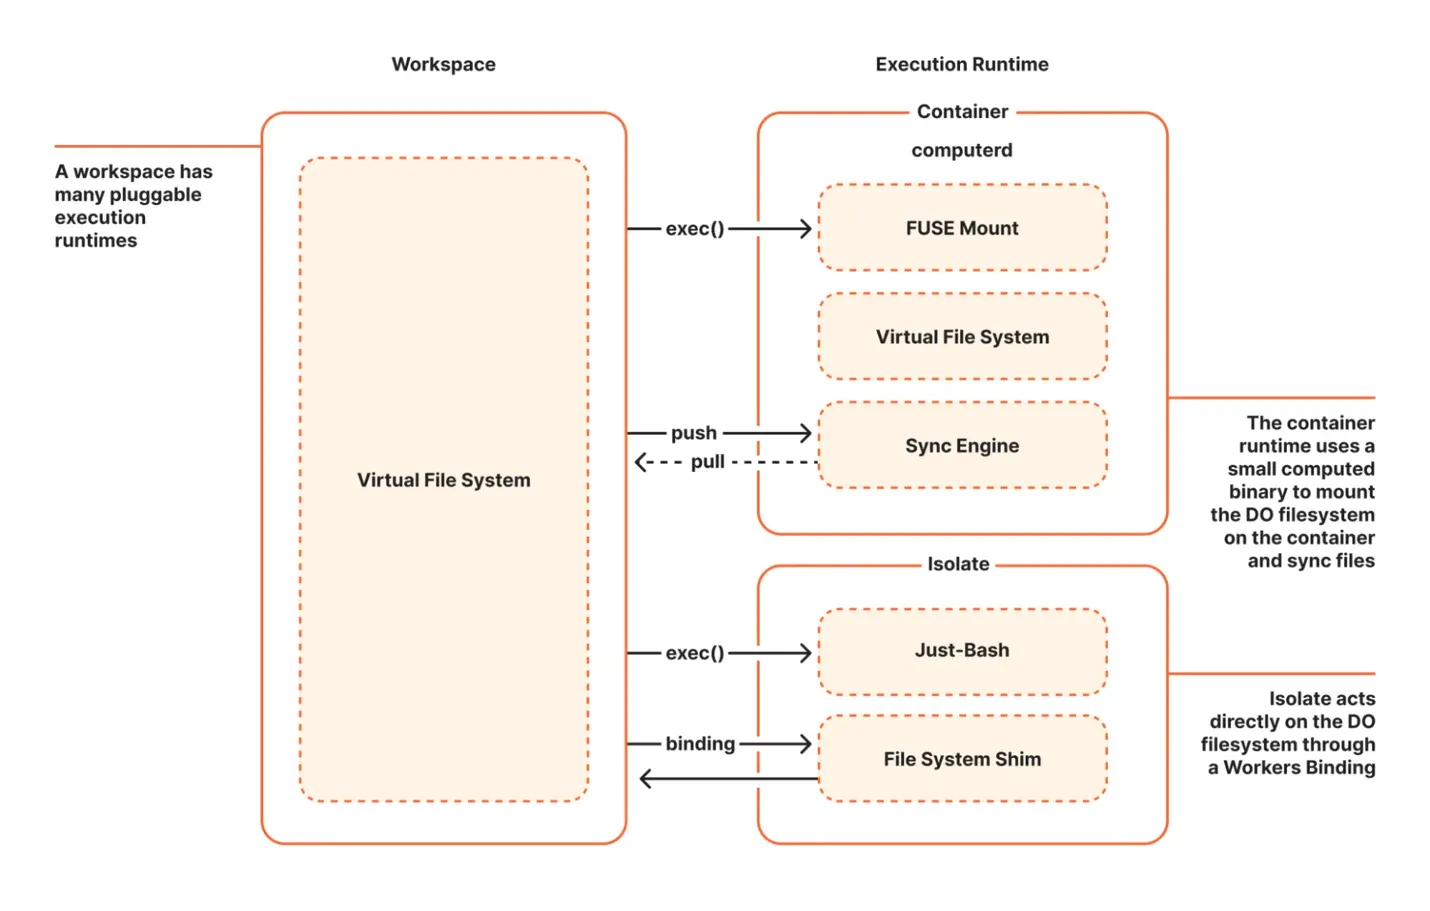
工作区还支持可选的执行运行时 Workspace.runtime,使您能够在文件系统上运行代码。所有运行时都支持相同的接口 exec(string, options),提供了两种默认选项:
-
Isolate:一个基于隔离环境的运行环境,使用 just-bash 将 shell 代码转换为 JavaScript,并在一个动态 Worker中运行。此处,文件系统可以通过 Worker 绑定直接访问。
适合场景:文件检索、简单脚本、轻量命令
-
Container:一个容器运行时,使用 Cloudflare Containers 提供完整的 Linux 环境。在此处,文件系统通过用户空间文件系统(FUSE)挂载提供,确保文件对容器可用,并将更改同步回去。
适合场景:
npm install、编译项目、需要 Shell/系统依赖的命令
FUSE(Filesystem in Userspace,用户态文件系统)允许程序在用户空间实现文件系统,不需要修改 Linux 内核。它可以把远端工作区表现成沙箱或容器中的普通目录。
computerd是 Cloudflare Computer 在 Container 后端里的一个沙箱内文件系统守护进程。名字可以理解为:
也就是“Computer 的后台服务”。
它主要做三件事:
computerd在容器/沙箱里运行。它通过 FUSE 把
/workspace挂载成一个普通目录。容器执行:
Terminal window Linux 将这个文件写入操作交给 FUSE。
computerd捕获变更,通过 RPC 发回 Workspace/DO。DO 将变更提交到 SQLite;大文件场景再写入 R2。
SQLite、R2#
在 Cloudflare 的设计文档中,文件系统的核心就是 SQLite 中的一张表:
CREATE TABLE cf_workspace_{namespace} ( path TEXT PRIMARY KEY, -- 文件路径 parent_path TEXT NOT NULL, -- 父目录路径,用于加速目录列表 name TEXT NOT NULL, type TEXT NOT NULL, -- 'file' | 'directory' | 'symlink' size INTEGER DEFAULT 0, storage_backend TEXT DEFAULT 'inline', -- 'inline' 或 'r2' r2_key TEXT, -- 当 storage_backend = 'r2' 时,存储 R2 的 Key content TEXT, -- 小文件的内容 (inline) created_at INTEGER, modified_at INTEGER -- ... 其他元数据);可以看到,content 字段既可以直接存小文件的文本或 Base64 编码的二进制数据,也可以配合 storage_backend 和 r2_key 字段,指向存储在 R2 的大文件。
为什么 SQLite 能支撑整个文件系统?#
因为文件系统本质上就是一张“巨大的映射表(元数据)”,而 SQLite 正是存储“映射关系”的绝佳数据库。
一个文件系统(如 ext4/NTFS)在硬盘上无非就是两样东西:
- 元数据(Metadata):文件名、路径、大小、创建时间、权限(755)、以及这些数据块在硬盘上的物理地址(指针)。
- 数据块(Data Blocks):文件的实际二进制内容(比如
console.log("hi")的 ASCII 码)。
在 Cloudflare Computer 的架构中,SQLite 直接把“硬盘物理地址”替换成了“数据库行(Row)”
并且 SQLite 支持 BLOB(二进制大对象) 类型,可以直接存储文件的内容(字节流)。加上 SQLite 是嵌入式数据库,不需要独立的服务器进程,且支持 ACID 事务(保证写入原子性,防止断电丢数据),所以在单机或单租户场景下,它完全可以充当“文件系统的存储引擎”。
分层存储(Tiered Storage)策略#
- SQLite(热数据存储):存小文件(< 1MB) 和所有文件的元数据(路径、权限、修改时间)。因为 SQLite 查路径特别快(B-Tree 索引)。
- 对象存储(S3/R2,冷数据存储):存大文件(> 1MB),比如图片、视频、
.tar.gz包。
配合机制:
-
当你
writeFile一个大文件时:- 大文件的二进制流上传到 S3,S3 返回一个唯一的
Key(比如uuid-v4.bin); - 在 SQLite 的
files表里,content字段不存二进制,而是存字符串:s3://bucket/uuid-v4.bin,同时标记size。
- 大文件的二进制流上传到 S3,S3 返回一个唯一的
-
当你
readFile时:- SQLite 查出这条记录,发现
content以s3://开头; - 守护进程向 S3 发起
GET请求,把数据流拉下来喂给 Agent。
- SQLite 查出这条记录,发现
3、云端 Agent#
1、项目结构与部署:
本地项目├── frontend/ # 聊天框、终端 UI│ ├── src/│ └── package.json│├── src/│ ├── index.ts # Worker 入口、Agent 循环│ └── agent-do.ts # Durable Object 类│├── package.json # @cloudflare/computer、ai 等依赖├── wrangler.jsonc # Worker、DO、SQLite、R2 配置└── tsconfig.json ↓npm installnpm run build / wrangler deploy ↓Cloudflare 部署产物├── Worker 代码├── DO 代码├── 打包后的 Computer SDK└── 前端静态资源(如果由 Worker 托管) ↓请求到来或 DO 被唤醒 ↓直接加载已部署代码运行同一个项目只需要安装一次:
npm install @cloudflare/computer aiComputer SDK 会部署到 Worker 和 DO 类,但两边的代码职责不同:
- Worker 侧导入
getWorkspace、createAITools,负责找到 DO、取得 Workspace,并把 Workspace 包装成 LLM 工具。 - DO 侧导入
withWorkspace,把 Durable Object 类增强成能够承载 Workspace 状态的 DO。
2、运行形态与流程:
用户界面 └── 浏览器里的聊天框 / 终端 UI ↓ HTTP / WebSocket / SSECloudflare Worker 接收请求、鉴权、运行 Agent 循环 ├── env.Agent.idFromName(userId):根据用户 ID 找到对应的 DO id ├── env.Agent.get(id) → DurableObjectStub:获得 DO stub └── getWorkspace(stub):把 DO stub 包装成可操作的 Workspace └── createAITools(workspace):把电脑能力包装成 LLM 工具 └── 调用 Computer Workspace 工具 ├── ws.fs.writeFile():读写文件 ↓ RPC DO 文件 API → 持久化到 DO SQLite / R2(较大的二进制) ├── ws.runtime.exec("npm test"):选择运行后端执行命令 ↓ RPC Isolate / Container / Worker JavaScript └── git:Git 操作因此,Cloudflare Computer 在这里主要承担的是工作产物的存储和执行环境,而不是 LLM 本身。它让云端 Agent 拥有一台可恢复的云端电脑:Worker 可以回收,DO 实例可以休眠,Agent 下次仍能从同一个用户的工作区继续工作。
4、代码示例#
定义 Agent DO 和 Workspace#
import { withWorkspace } from "@cloudflare/computer";import { DurableObject } from "cloudflare:workers";
export class Agent extends withWorkspace(  class extends DurableObject<Env> {},  (self) => ({ storage: self.ctx.storage }),) {}
在 Worker 中运行 Agent#
import { getWorkspace } from "@cloudflare/computer";import { createAITools } from "@cloudflare/computer/tools";import { generateText } from "ai";
export default {  async fetch(req, env) {    const userId = "user-123"; // 实际项目中应来自鉴权结果    const id = env.Agent.idFromName(userId);    const stub = env.Agent.get(id);
    using workspace = await getWorkspace(stub);    const tools = createAITools({ workspace });
    const { text } = await generateText({      model,      tools,      prompt: "读取当前工作区,完成用户交代的任务。",    });
    return new Response(text);  },} satisfies ExportedHandler<Env>;
idFromName(userId) 使每个用户拥有稳定的工作区;createAITools(workspace) 把 read、write、edit、exec 等能力交给模型;using 用于在调用完成后释放 Workspace/stub 资源。
Grok Bot#
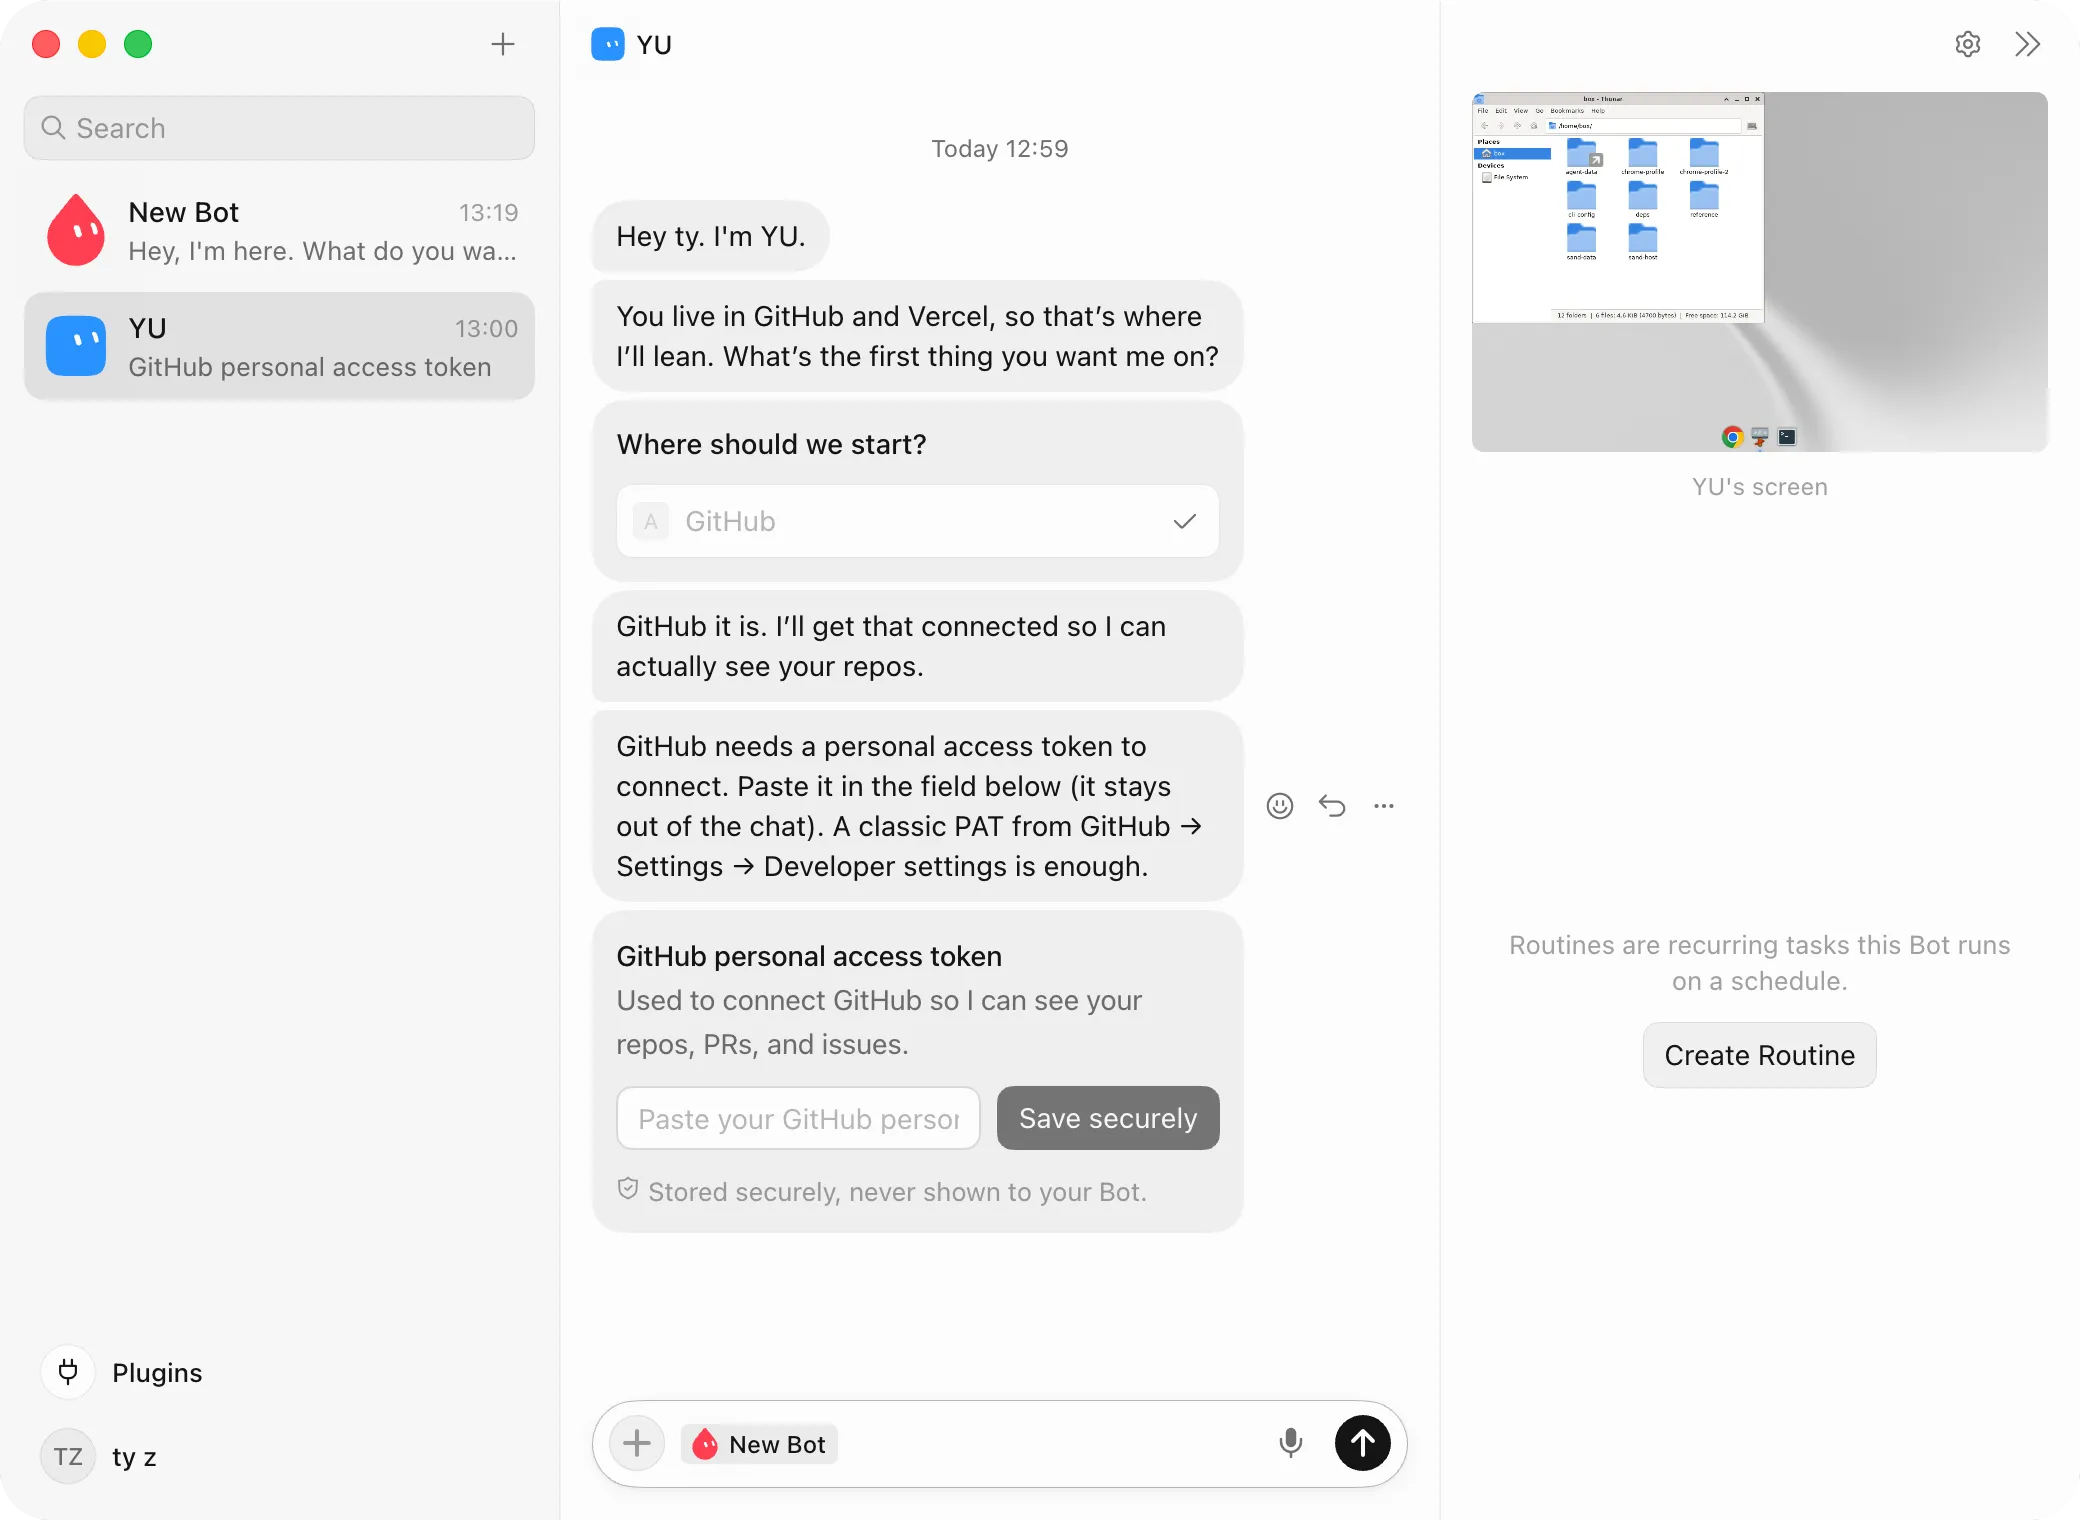
Grok Bot 的官方定义是:每个用户拥有一台持久化的托管 Linux VM,里面有 browser、filesystem、terminal;多个有名字、有持久状态的 Agent Bot 共享这台电脑、文件和登录会话。Grok Bot 官方说明
Cloudflare Computer 更像一层“Agent 工作空间运行时”:文件状态由 Durable Object + SQLite 持久化;简单任务可以在 isolate 中执行,需要真实 Linux、npm 或原生二进制时,再挂到 Container 中运行。官方 README 也明确把它定义为 virtual filesystem,并提供 container、isolate shell、isolate JavaScript 三种后端。Cloudflare 官方博客
所以一句话:
Grok Bot 是“给 Agent 一台已经存在的云端电脑”;Cloudflare Computer 是“给开发者一套组装 Agent 电脑的基础设施”。
存算分离如何落地#
笔记的核心论点——把「状态存储」和「计算推理」从同一进程解耦——Grok Bot 用「一台持久电脑 + 无状态大脑」来实现:
| 笔记里的概念 | Grok Bot 的对应实现 |
|---|---|
| 存算一体(进程绑定) | 传统「工作流 builder / 一次性会话」:任务结束环境即销毁,上下文清零 |
| 存储层(持久状态) | 一台持久化云端 VM:浏览器、文件系统、终端、登录态、记忆、偏好 |
| 计算层(无状态执行) | Bot 的推理 + 工具/电脑操作;关闭 App 或笔记本不停止,云端继续跑 |
| 断点续跑 / Checkpoint | Update / Recover / Reset Agent Computer,三者都「preserve durable state」 |
存储层:一台「电脑」就是全部状态#
Grok Bot 没有把存储拆成 Redis / Postgres / 向量库暴露给用户,而是把整个状态抽象成一个文件系统:
/workspace= 共享工作区,对应笔记里的「工作产物 → 对象存储」,要求 Bot 把耐久文件放这里- 浏览器 cookies / 登录态 = 一种长期记忆(登录一次,其他 Bot 复用)
- 记忆 + 偏好 + 文件 + 浏览器会话 跨 turn 持久
- 「临时目录、手装的包、未提交的应用状态」明确标注为可丢弃,重要结果必须拷进
/workspace
这和 Cloudflare Computer 的「对外暴露普通文件系统、内部持久化状态」思路相近;FUSE 是否参与,取决于具体执行后端是否把工作区挂载成容器内目录。
计算层:双通道执行#
笔记里执行层是「沙箱里跑工具」,Grok Bot 把执行拆成两条优先级明确的路径:
- Connector / MCP(首选)——结构化调用,比「点网页」可靠
- Browser Use / Computer Use(兜底)——对没有干净 API 的应用/网站,直接操作浏览器和桌面,browser use 使用 playwright-core + Chrome CDP
文档明确说 “Prefer a connector when one is available”,这回答了「什么时候用 API、什么时候用电脑操作」的工程取舍。
多 Agent 协作:人不当路由器#
- Bot 之间互相发消息、在线程/群聊里共享上下文、传递任务所有权(handoff)
- 多个 Bot 并行跑
- 交接时「无需重复 setup」(因为共享电脑)
自动化:Skill / Routine / 演示学习#
- Skill = 可复用的指令集(何时用、输入、步骤、验证、返回、审批边界)——对应笔记里的「动态 Skills」
- Routine = 定时/事件触发的自动化(一个 Bot 最多 50 个 routine)
- Teach by demonstration:录下你实际操作电脑的步骤(最长 10 分钟,不录麦克风),Bot 学成 skill
- 事件触发靠 Cursor 账户集成(Slack / GitHub)
评论
欢迎交流,使用 GitHub 账号登录后即可留言。
在 GitHub Discussions 中查看讨论 ↗