来源:X 文章 KV, Prefix, Prompt and Semantic Caching in LLMs, clearly explained
Context Engineering 最重要的工程技巧之一就是不要重复算同样的前缀。这里有几个层层递进的概念:
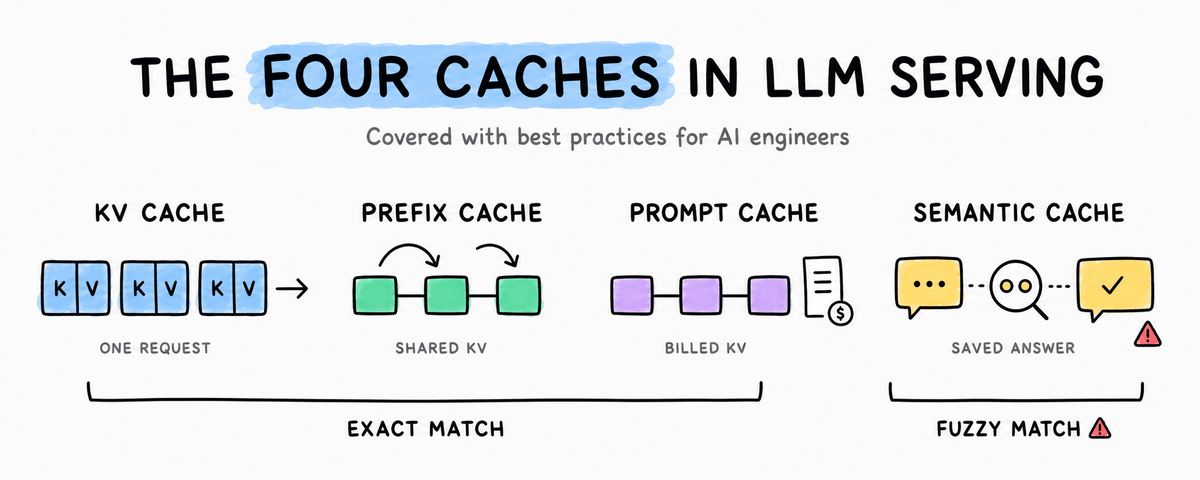
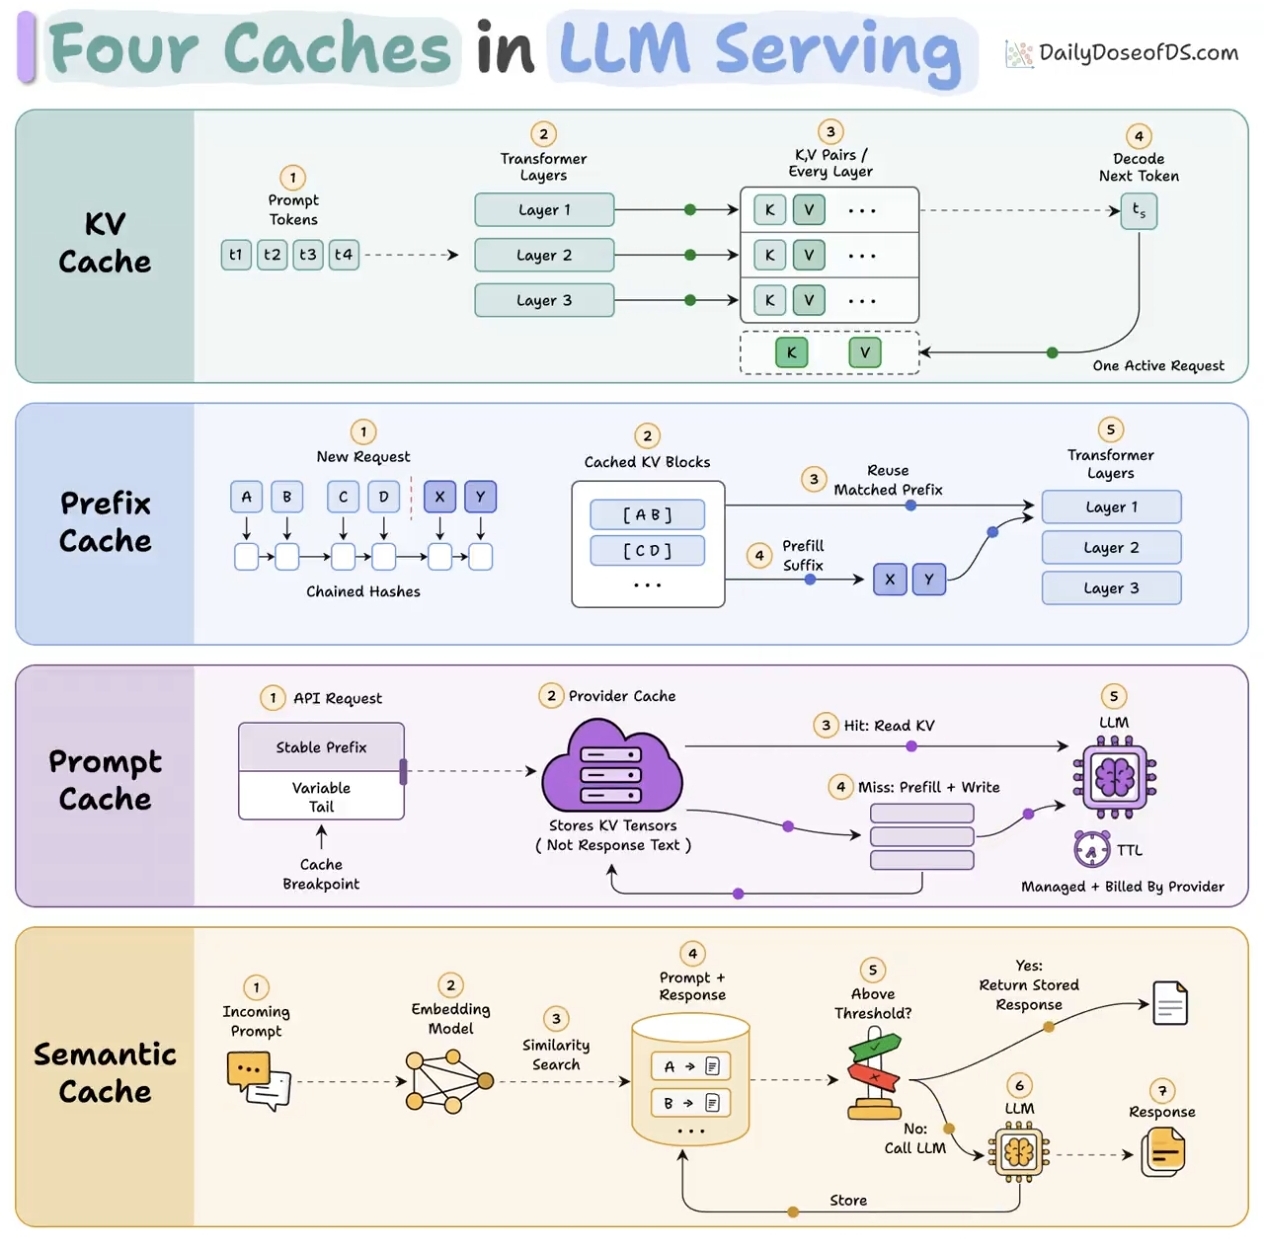
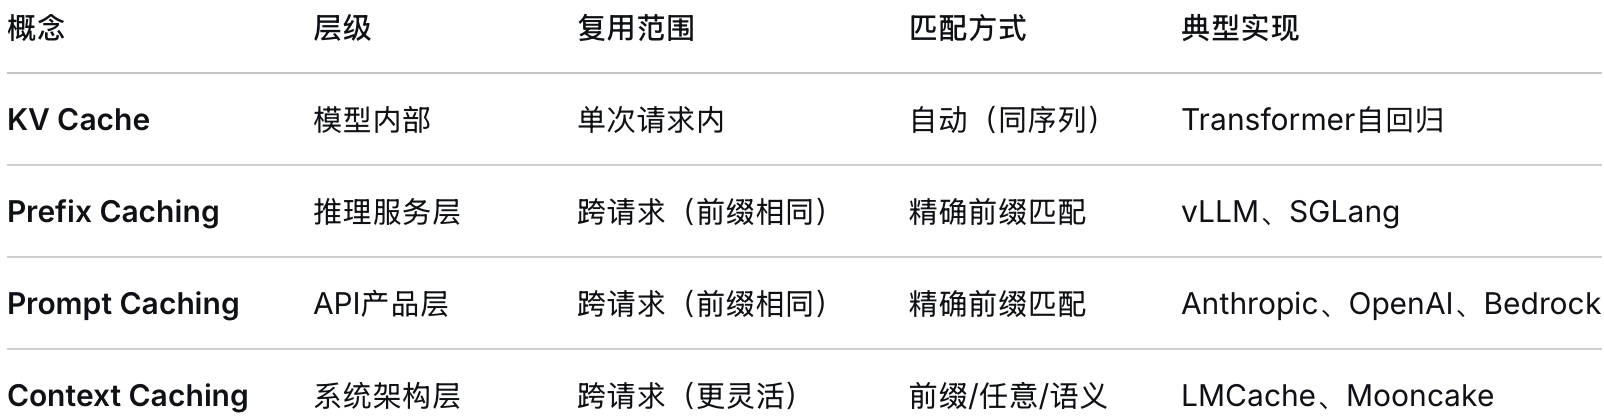
- KV Cache(算法层):单请求内的动态规划,算完就扔。
- Prefix Caching / Prompt Caching(引擎层/商业层):单机内的块级复用 + API 计费包装,解决“同前缀省钱”。
- Context Caching(系统层):分布式缓存中间件。它向下接管存储引擎(内存/SSD/网络),向上对接调度器(Conductor),横向支持任意位置匹配(CacheBlend)。它的终极目标是——让长文本输入的 Prefill 计算趋近于 O(1) 的读取开销,彻底抹平“输入长度”对推理延迟和成本的影响。
“这四个概念底层都是 K/V tensor 的复用,但作用域不同。KV Cache 解决模型内部单个请求解码时的重复计算,在减少计算量的同时也会增加显存和内存带宽的要求,降低显存大小的方式有 GQA 分组注意力(主流模型都在用)、MLA 多头潜在注意力(deepseek 系列)、量化 cache;Prefix Caching 把复用范围扩大到多个请求之间相同前缀,请求结束后推理引擎不释放 KV 块,而是保留在 GPU 内存中并建立索引,比如 vLLM KV 按固定 16-token 切块,每块的哈希 = hash(父块哈希 + 本块 16 个 token),形成哈希链;Prompt Caching 是云服务商把 Prefix Caching 包装成计费 API,cache read/write 价格不同;Context Caching 则是一个更高层的概念,存储角度从单机的 GPU 显存到分布式存储,比如说 Moocake 就像是一个分布式 KV 数据库,生命周期角度从模型厂商会有 TTL 过期时间变更加灵活、可以长时保存,匹配角度从“绝对前缀”到“灵活定位”,比如说 LMCache 的 CacheBlend 技术就是通过更新位置编码、选择性注意力重算的技术实现任意位置 KV 的复用。“
一、KV Cache:一切的基础,但只服务”一个请求的一次解码”#
本质#
模型内部的解码是自回归的:每生成一个新 token,都要让它去 attention 之前所有 token。如果不缓存,前面每个 token 的 K/V 每步都要重算,总计算量随序列长度平方级增长。
KV Cache 就是把每一步算好的 key/value 张量存下来,生成时只算新 token 的那一份,前面的直接复用。效果:单步计算量大降,代价是显存随 token 数线性增长。
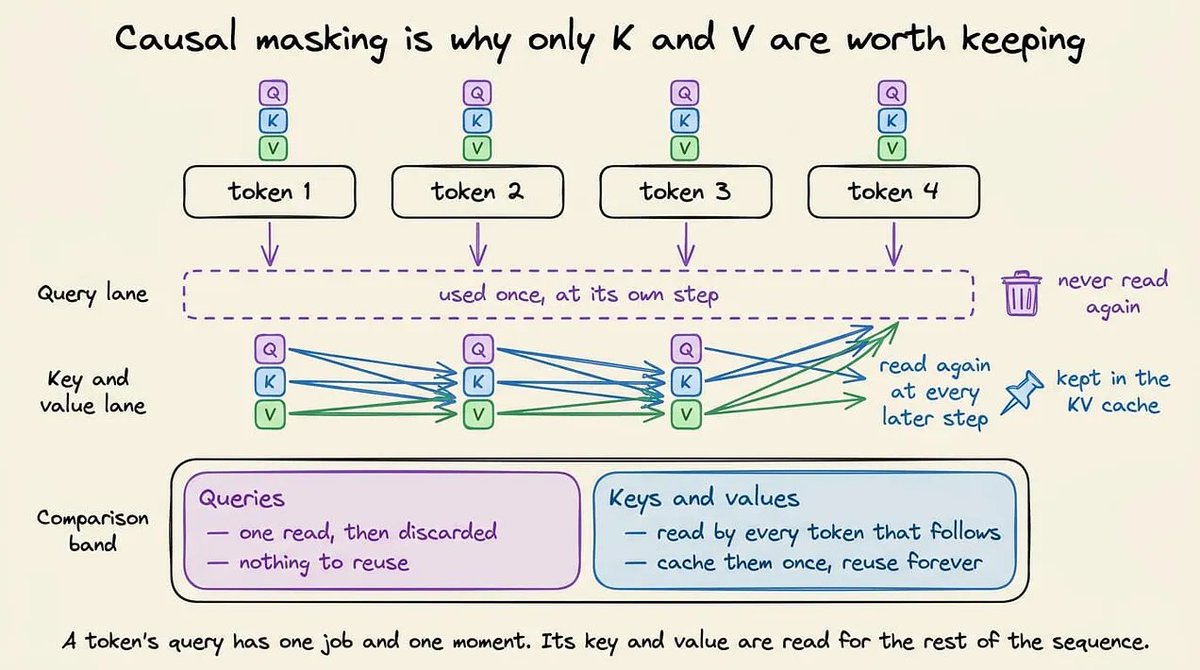
KV cache├── layer 1│ ├── token 1: K, V│ ├── token 2: K, V│ └── ...├── layer 2│ ├── token 1: K, V│ ├── token 2: K, V│ └── ...└── layer N每个 token 在每一层都有自己的 K/V,实际还会按 attention head 组织。
增长方式:每解码一步 +1#
cache 里每个见过的 token 占一条位置(每层、每个 KV head 各一份 K 和 V),动态扩容、不预分配——短请求不会为用不到的内存预留空间。
代码示例:自己构造 DynamicCache 传给 generate,生成结束后还能检查它:
import torchfrom transformers import AutoTokenizer, AutoModelForCausalLM, DynamicCache
model_id = "HuggingFaceTB/SmolLM2-360M-Instruct"tokenizer = AutoTokenizer.from_pretrained(model_id)model = AutoModelForCausalLM.from_pretrained(model_id, dtype=torch.bfloat16, device_map="auto")
inputs = tokenizer("The capital of France is", return_tensors="pt").to(model.device)past_key_values = DynamicCache(config=model.config)
out = model.generate(**inputs, do_sample=False, max_new_tokens=20, past_key_values=past_key_values)
print(tokenizer.decode(out[0], skip_special_tokens=True))# The capital of France is Paris. It is the largest city in France and the second-largest city in the European Union.print("prompt tokens:", inputs["input_ids"].shape[1])    # 5print("total tokens:", out.shape[1])                     # 25print("cache length:", past_key_values.get_seq_length()) # 24
注意 get_seq_length() = prompt 数 + 生成数 − 1:最后一个 token 的 K/V 被算出来了,但不会有任何后续 token 去 attention 它,所以不进 cache。
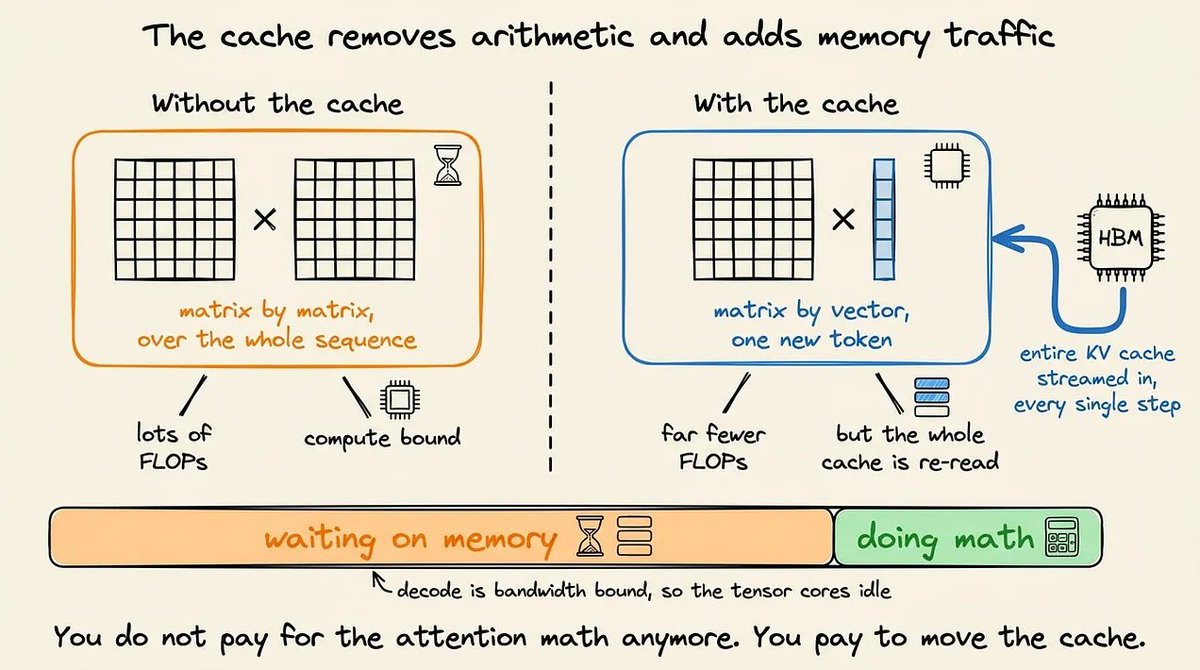
代价:瓶颈从计算变成显存和内存带宽#
虽然单步计算量小了,但每一步仍要把整个 cache 从 HBM 加载出来。注意力内核算得比缓存加载快,GPU 在解码时大部分时间在等内存——decode 受内存带宽限制,不再受计算限制。
长上下文主要是显存问题#
长下文的显存问题主要来自两方面:
- 显存杀手 1:KV Cache(存储杀手)→ GQA 出手
- 显存杀手 2:注意力矩阵(计算/激活杀手)→ Sparse Attention 出手
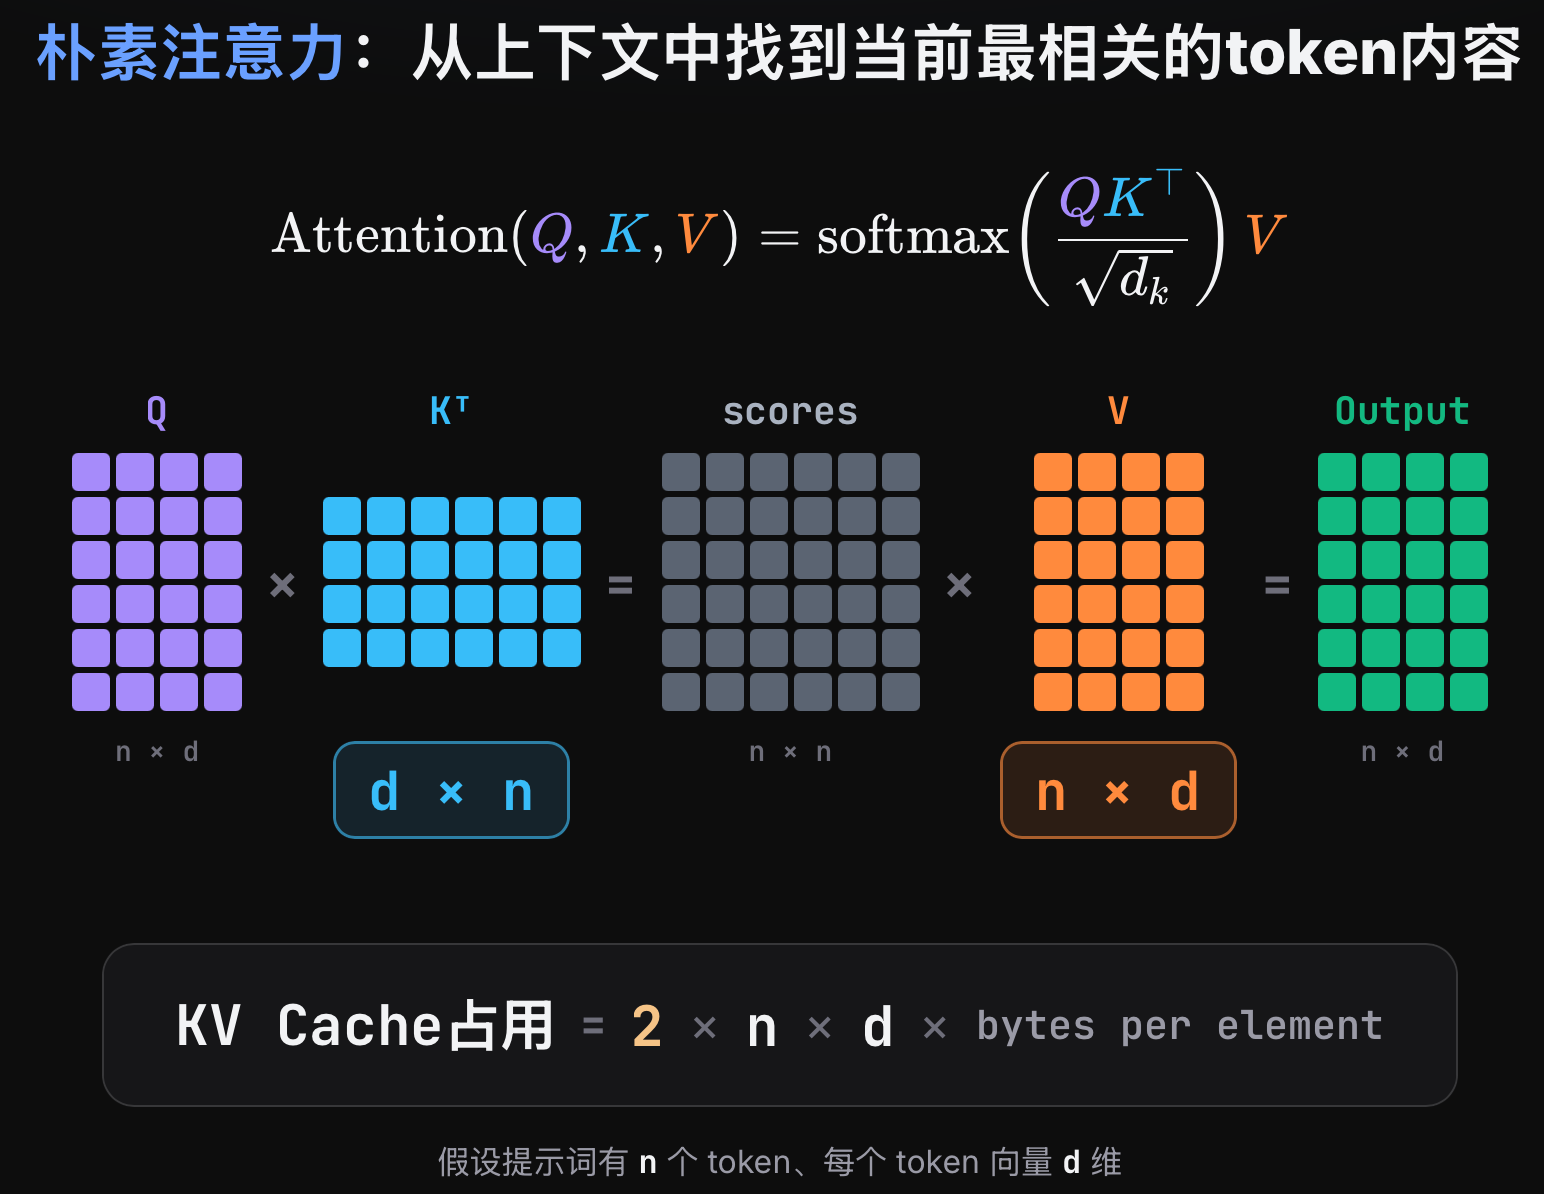
KV cache 大小由模型形状决定,随 token 数线性增长。70B 模型、BF16 精度下,单个 128K 上下文的 cache 约 40GB,接近整个模型 4-bit 量化后的体积。
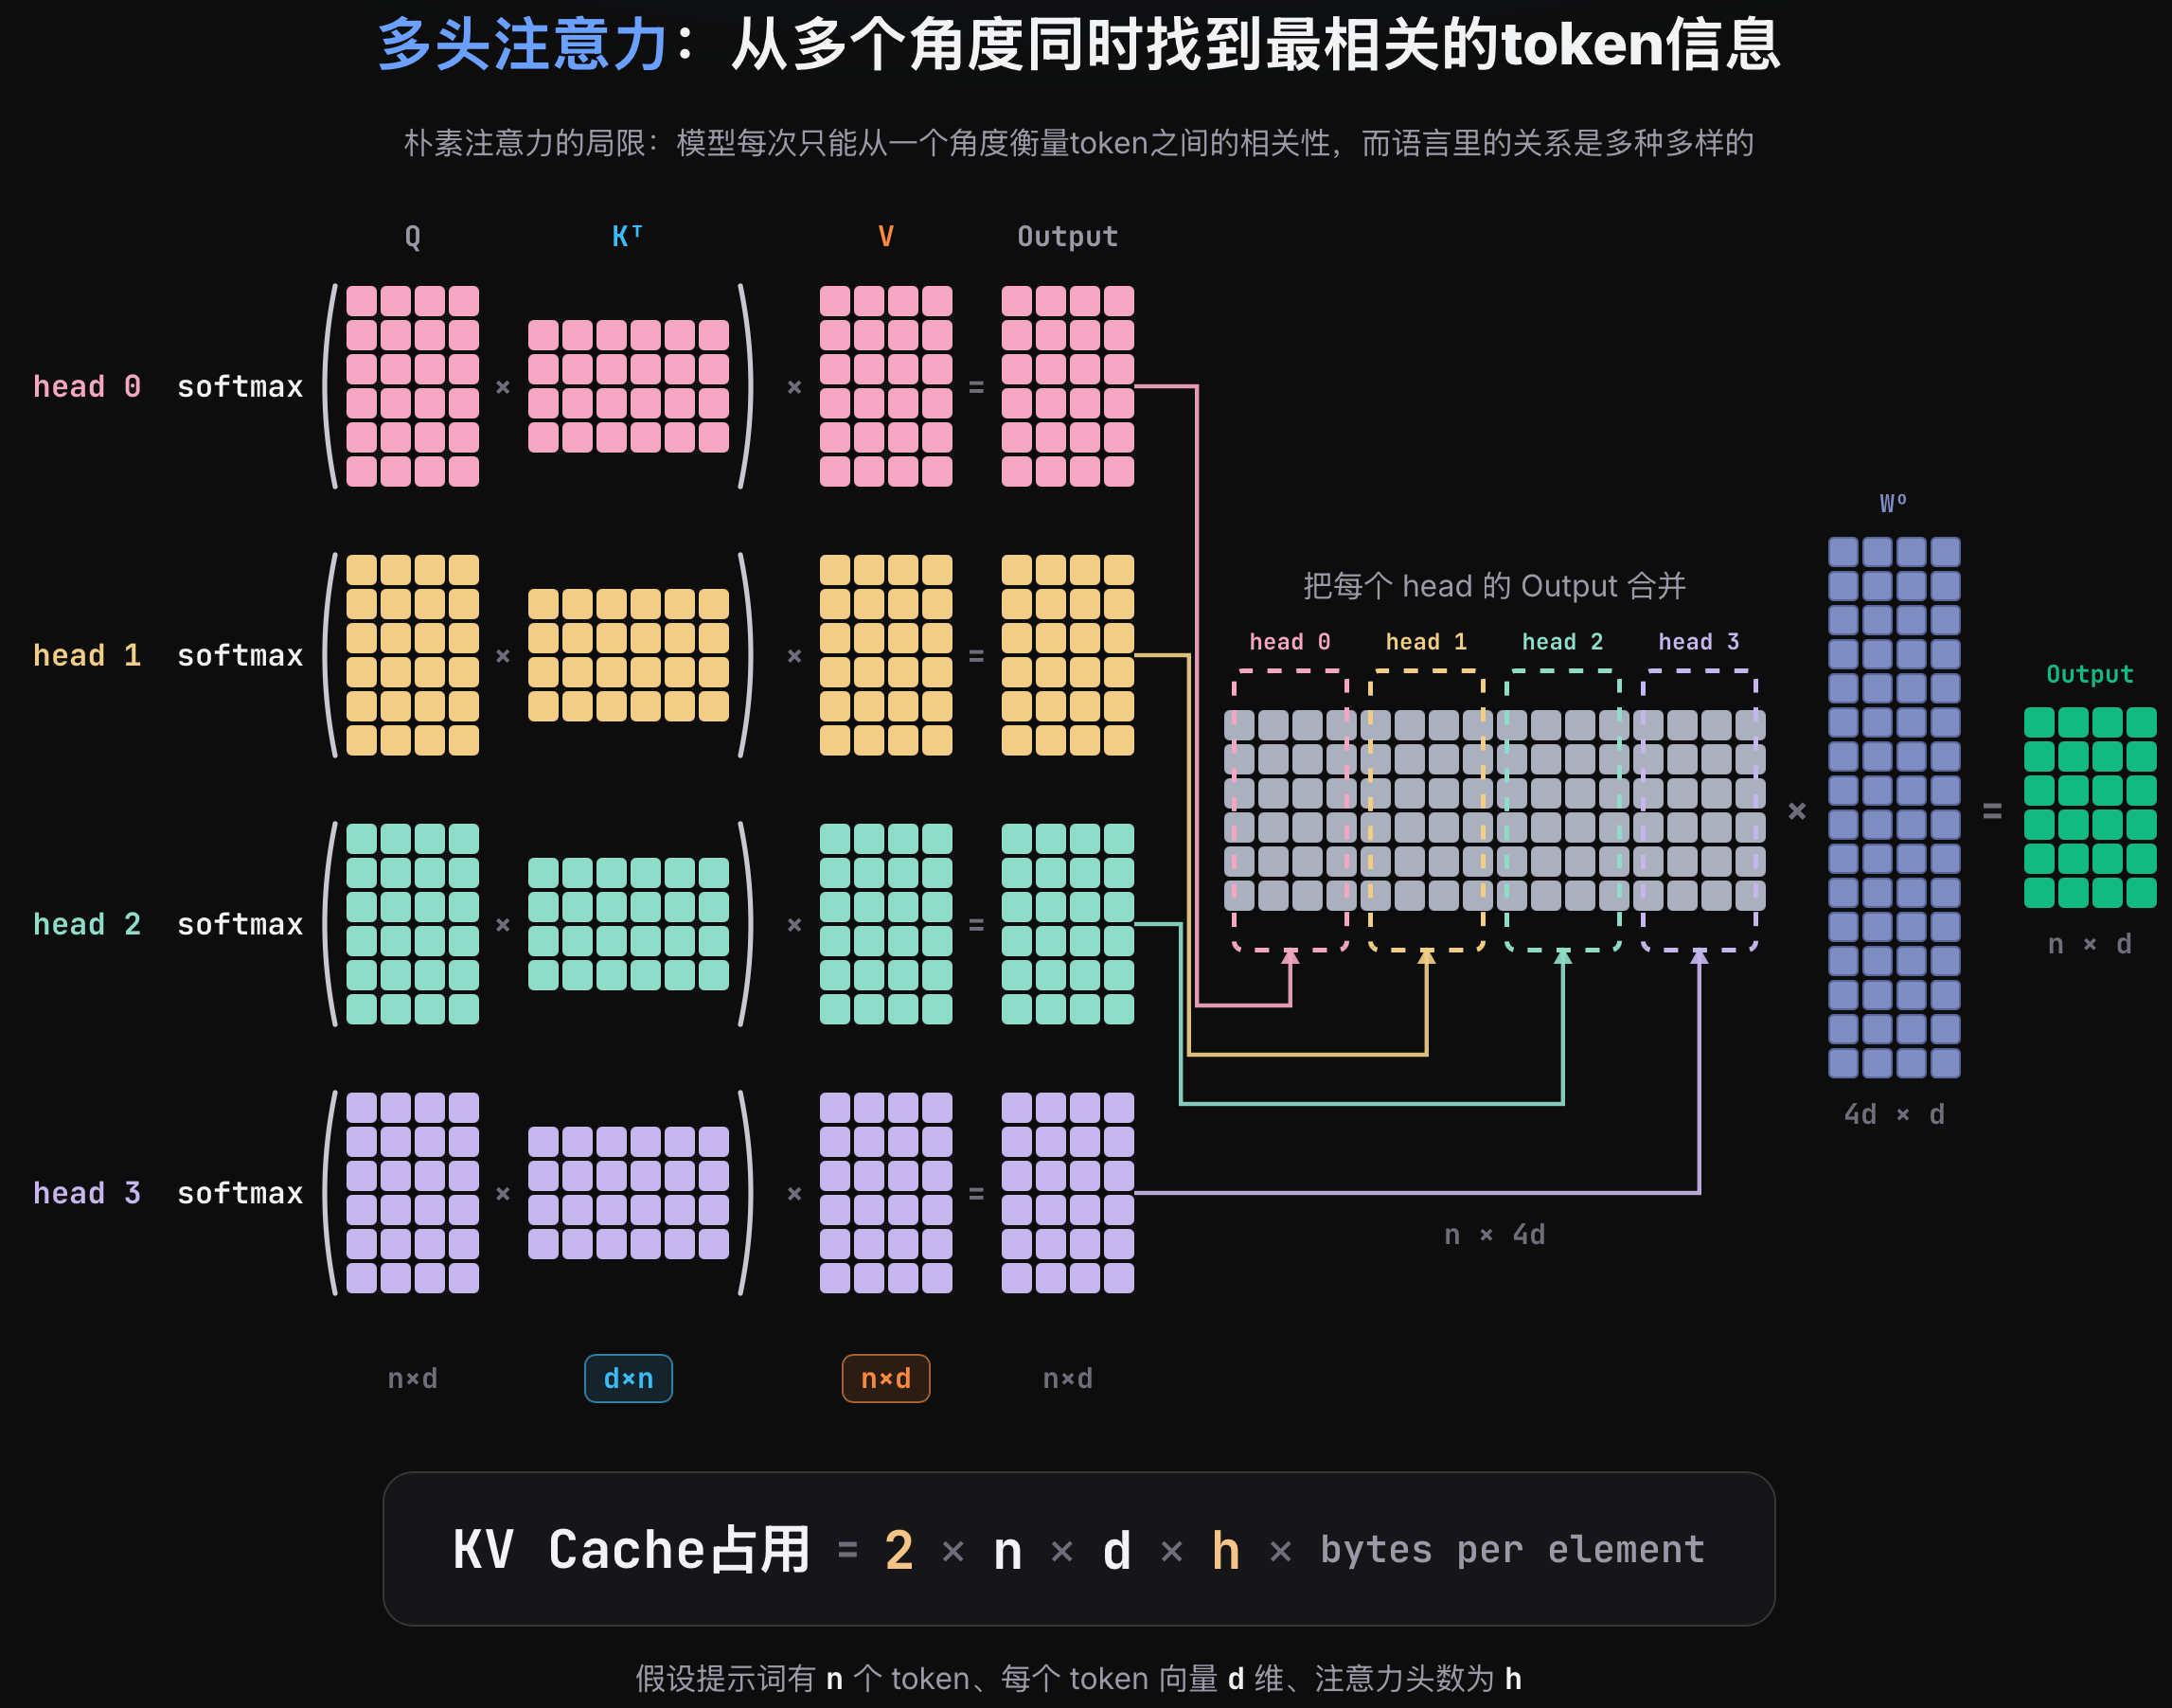
KV Cache 到底占多少显存#
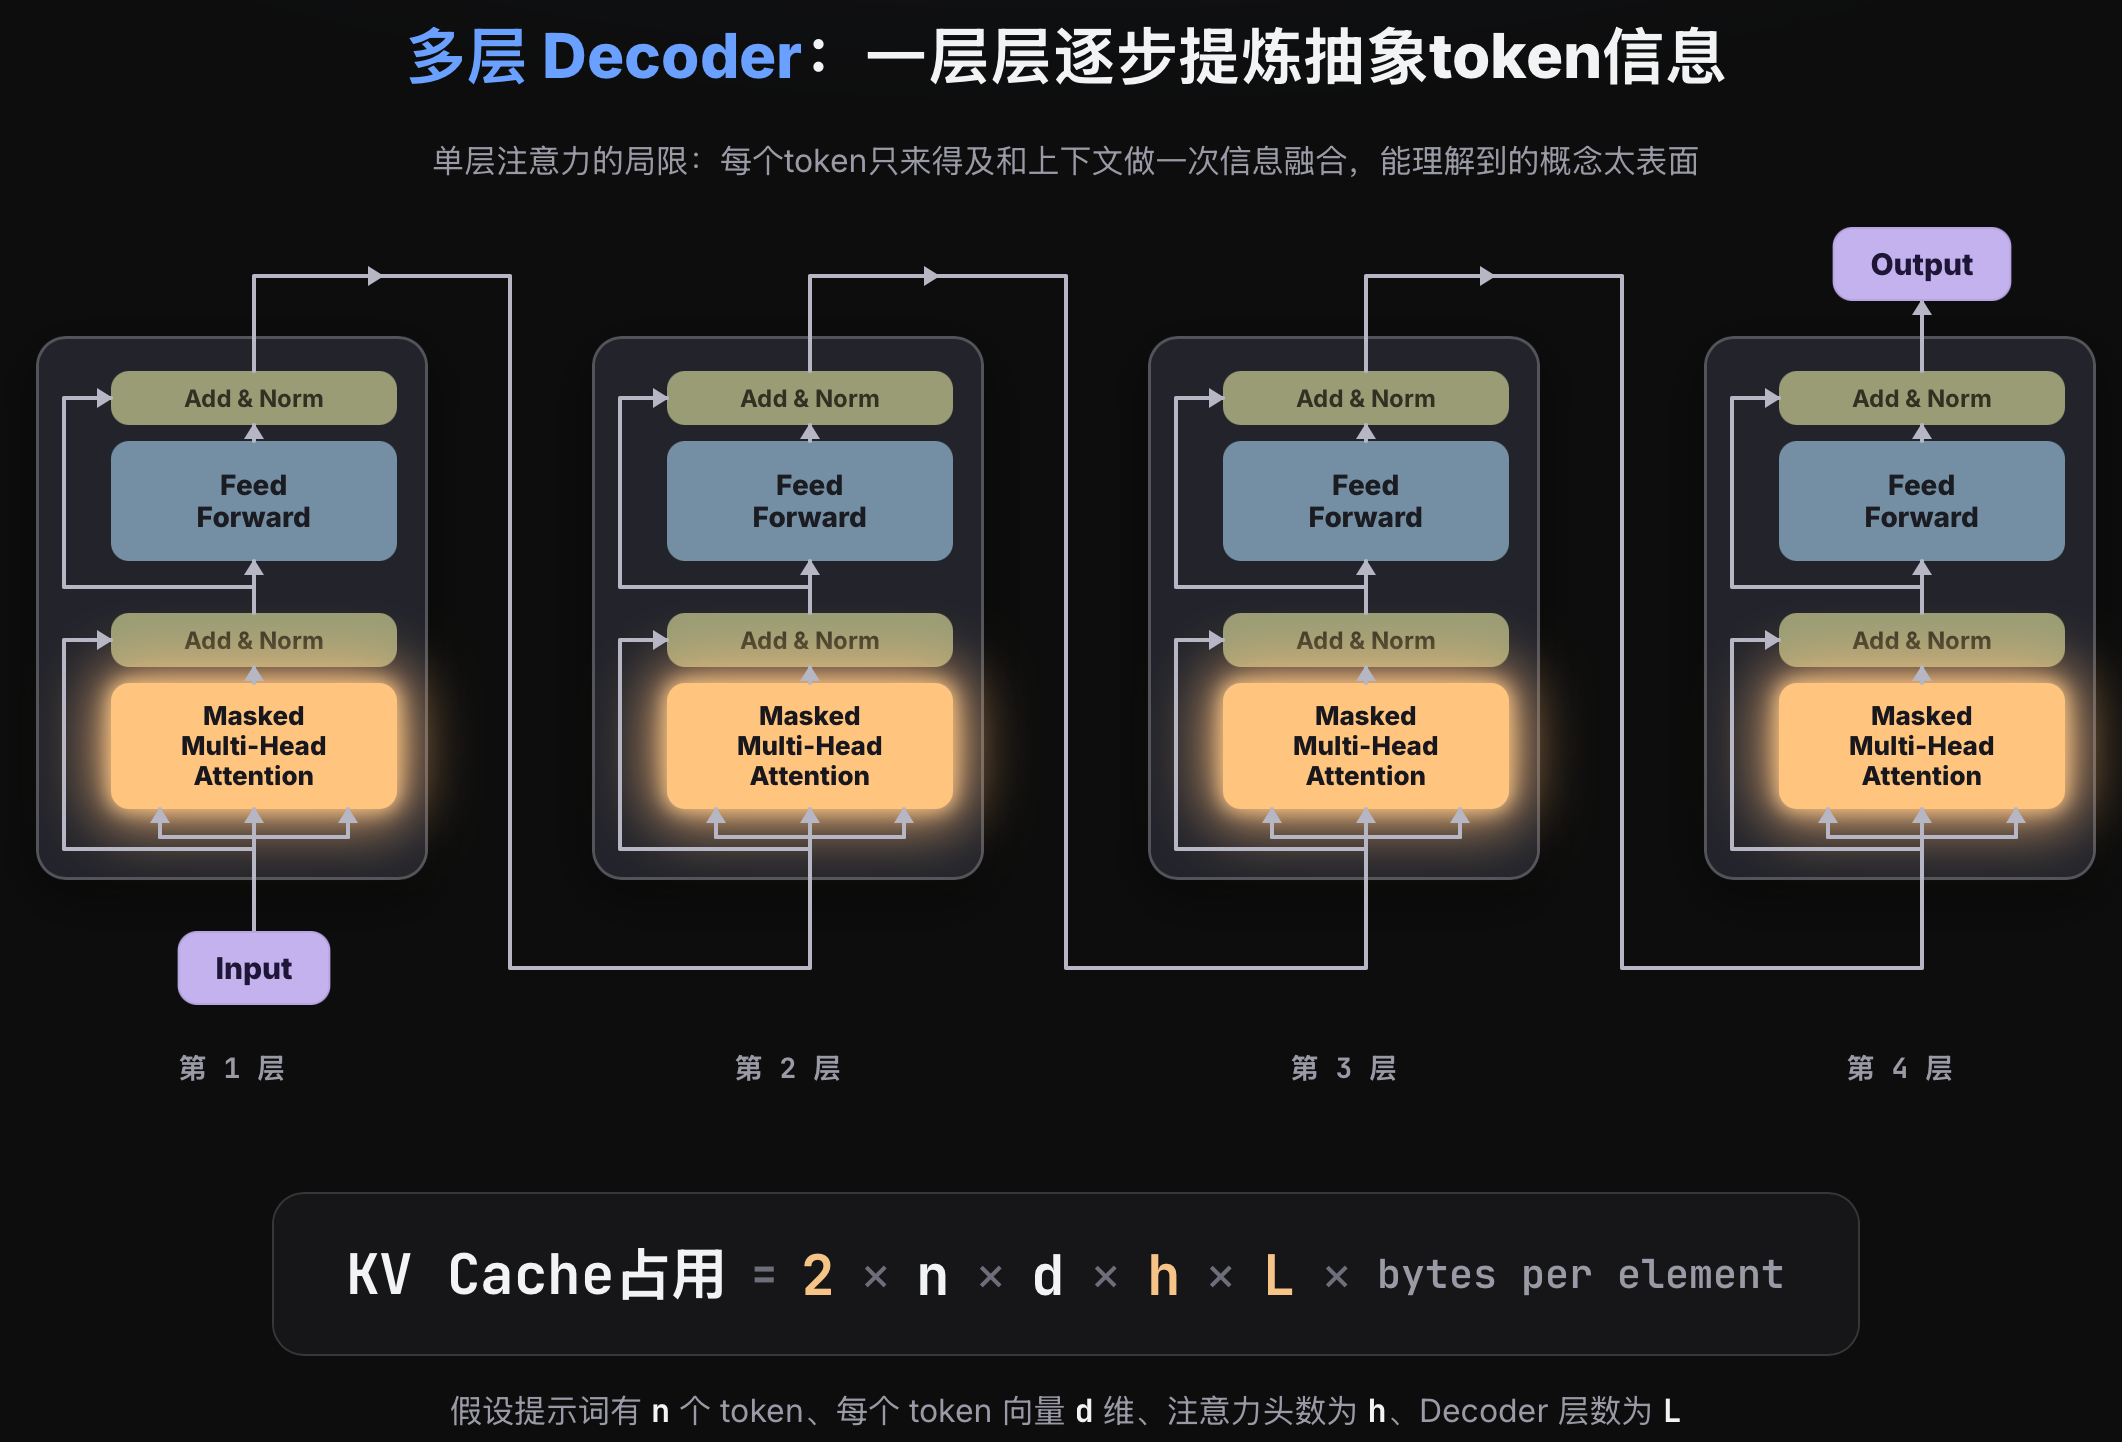
KV Cache 的瘦身手段#
| 手段 | 本质 | 思路 | 取舍 |
|---|---|---|---|
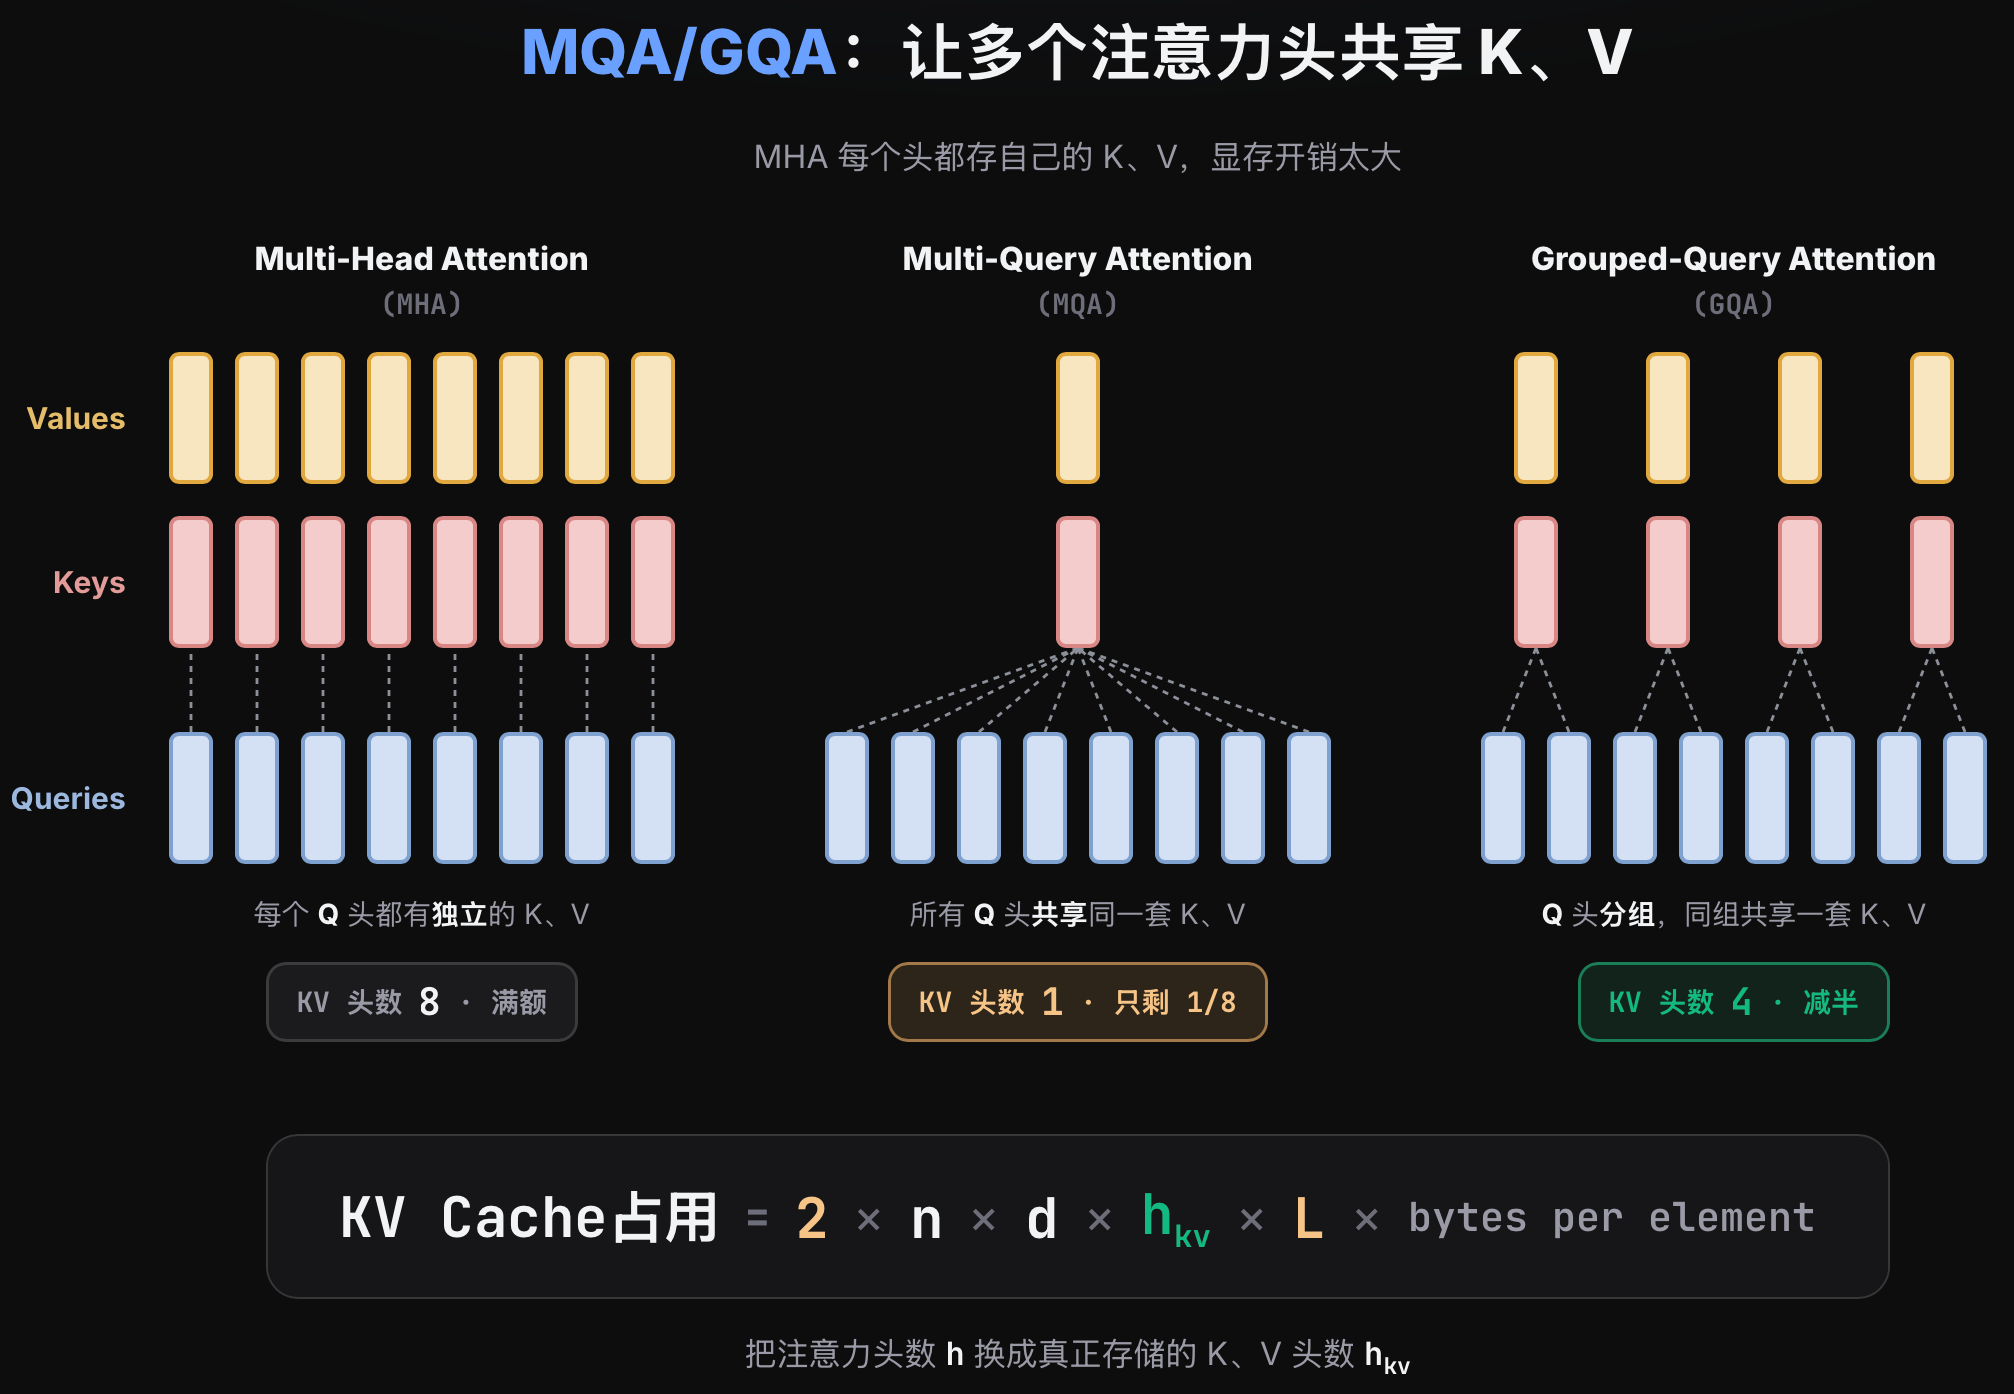
| MHA ➡️ GQA(分组查询注意力) | 减少份数 | 一组 query head 共享一个 key/value head | 好处:cache 变小,同时每字节数据的 FLOPs(浮点运算次数) 变高,这在带宽受限的解码阶段是好事,等于把有限的带宽用在刀刃上 |
| MLA(多头潜在注意力,DeepSeek 系) | 减每份的体积 | 把整套 K/V 压缩成一个潜在向量 | 好处:cache 大幅缩小;代价:每次 attention 前要先做一次投影运算把 latent 还原成 K/V,多一步计算换大量内存 |
| Cache 量化 | 减每份的位数 | KV 存成低精度(如 4-bit) | 好处:容量约翻倍;代价比权重量化更大:K/V 直接参与每步 attention 的计算,误差会一步步累积,不像权重那样能被其他参数抵消,每次访问要量化/反量化,短上下文可能更慢,内存吃紧时用 |
现在的主流模型(Llama 3、Mistral、Qwen 系列)默认就是 GQA。
在标准的 MHA 中,假设有 8 个头:
- 内存里有 8 个 W
Q矩阵(Q0 ~ Q7)。 - 内存里有 8 个 W
K矩阵(K0 ~ K7)。 - 内存里有 8 个 W
V矩阵(V0 ~ V7)。
现在来看 GQA。假设有 8 个 Q 头,但只有 4 个 KV 头(分组为:Q0,Q1 共享 KV0;Q2,Q3 共享 KV1……)。
cache 的生命周期:默认随请求释放,多轮对话会全额重算#
generate 内部创建的 cache 在请求结束时释放。一个 20 轮聊天,到第 20 轮时前 19 轮的内容全部重新 prefill,成本全量。
解法:在循环外持有 DynamicCache,每轮传同一个进去,跨轮复用:
import torchfrom transformers import AutoTokenizer, AutoModelForCausalLM, DynamicCache
model_id = "HuggingFaceTB/SmolLM2-360M-Instruct"tokenizer = AutoTokenizer.from_pretrained(model_id)model = AutoModelForCausalLM.from_pretrained(model_id, dtype=torch.bfloat16, device_map="auto")
past_key_values = DynamicCache(config=model.config)messages = []questions = ["What is the capital of France?", "And its population?"]
for prompt in questions:    messages.append({"role": "user", "content": prompt})    inputs = tokenizer.apply_chat_template(        messages, add_generation_prompt=True, return_tensors="pt", return_dict=True    ).to(model.device)    input_length = inputs["input_ids"].shape[1]    outputs = model.generate(**inputs, do_sample=False, max_new_tokens=64,                             past_key_values=past_key_values)    completion = tokenizer.decode(outputs[0, input_length:], skip_special_tokens=True)    messages.append({"role": "assistant", "content": completion})    print(f"turn tokens in: {input_length} | cache now: {past_key_values.get_seq_length()}")
# turn tokens in: 42 | cache now: 55# turn tokens in: 71 | cache now: 92
关键理解:
- 第二轮输入 71 个 token,但 cache 已有 55,真正要 prefill 的只有 92 − 55 = 37 个新 token
- 复用成立的前提:第二轮的前缀 token 序列必须与第一轮逐位完全一致。历史只能是纯追加,任何更早的修改都会让整个 cache 失效
- 这里 cache 属于单个 Python 进程;在 serving 引擎里,它属于跨请求共享的内存池(就是下一节的 Prefix Caching)
二、Prefix Caching:把 KV Cache 的复用范围扩大到”多个请求”#
核心机制#
这是推理引擎层的优化。请求结束后引擎不释放 KV 块,而是保留在 GPU 内存中并建立索引,让后续请求按前缀查找——这就是 prefix caching。复用规则和上一章单进程 demo 完全一致:前缀 token 必须逐位一致。缓存对象是 KV 张量,不是 prompt 文本。
假设 token 序列是:
请求 1:A B C请求 2:A B D计算请求 1 时:
K(A)、V(A) 只依赖 AK(B)、V(B) 依赖 A BK(C)、V(C) 依赖 A B C所以请求 2 可以直接复用:
K(A)、V(A)K(B)、V(B)然后只对 D 做新的计算:
A B 的 KV:复用D 的 KV:重新计算A B 的 KV 还能复用的关键原因是 Transformer 的 self-attention 通常是因果/自回归的:某个 token 的 K/V 只依赖它自己和前面的 token,不依赖后面的 token。如果 A B 是中间的一段,那就没法复用。
有两种情况决定了前缀 token 的缓存与复用需要更细的粒度(块大小)和机制,一种是同一会话内切换分支,此时相当于会话本身是一颗会话树,说明前缀缓存要考虑保留足够短的前缀保证分支也能被覆盖,并且这个前缀缓存还不能被淘汰;还有一种是从节点 Fork 出新会话,说明缓存不能只绑定某个 session,而应该按照“前缀内容”组织,这样不同会话只要前缀相同,也能共享 KV。
两种实现#
-
vLLM APC(Automatic Prefix Caching 自动前缀缓存):采用固定大小的 KV block
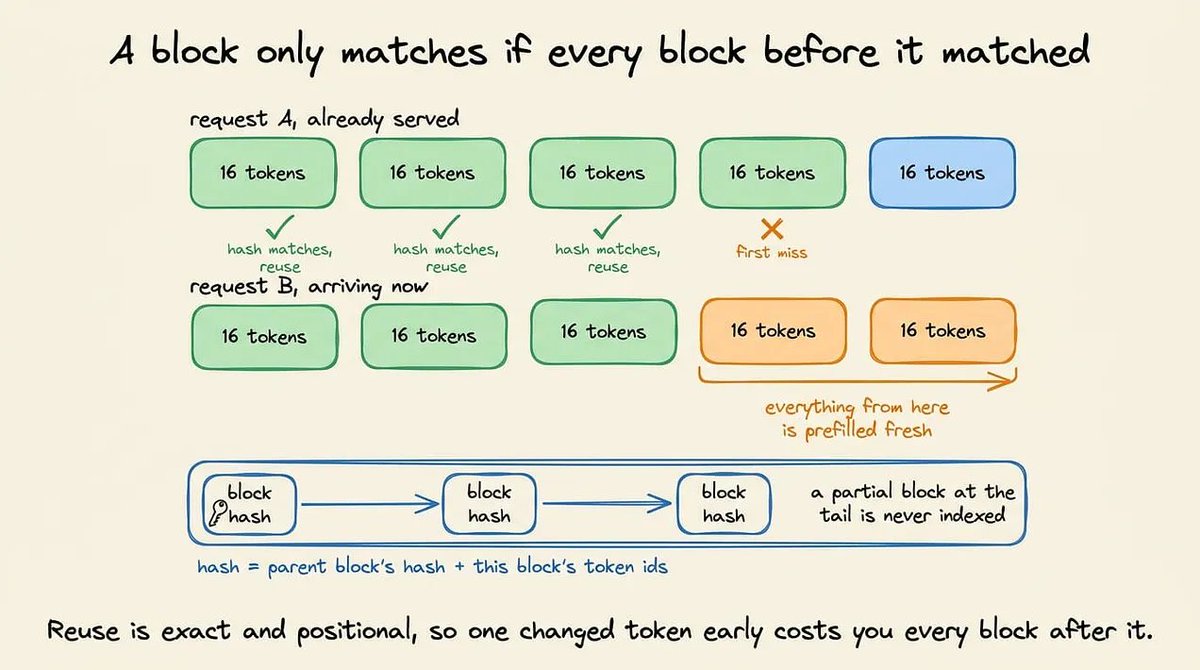
block 1:token 1~16 的所有层 K/Vblock 2:token 17~32 的所有层 K/Vblock 3:token 33~48 的所有层 K/V每个 block 的哈希依赖父 block:
block 1 = hash(token 1~16)block 2 = hash(block 1 + token 17~32)block 3 = hash(block 2 + token 33~48)因此第 3 个 block 命中,意味着前面第 1、2 个 block 也一定命中。
它的特点是:
- 块级缓存;
- 查找简单;
- 第一个 miss 之后停止;
- 从 miss 位置开始重新 prefill;
- 用引用计数防止正在使用的缓存被淘汰。
-
SGLang RadixAttention:使用 token 级 radix tree
公共前缀├── 分支 A└── 分支 B它更适合:
- 多轮对话;
- 同一会话的分支;
- 从历史节点 fork 新会话;
- 多个请求共享不同长度的前缀。
vLLM 机制查找与调度伪代码#
核心流程是:
输入 token ↓切成 16-token block ↓逐块计算链式 hash ↓从第一个 block 开始查缓存 ↓命中:复用 KVmiss:停止查找 ↓miss 之后的 token 重新 prefillBLOCK_SIZE = 16
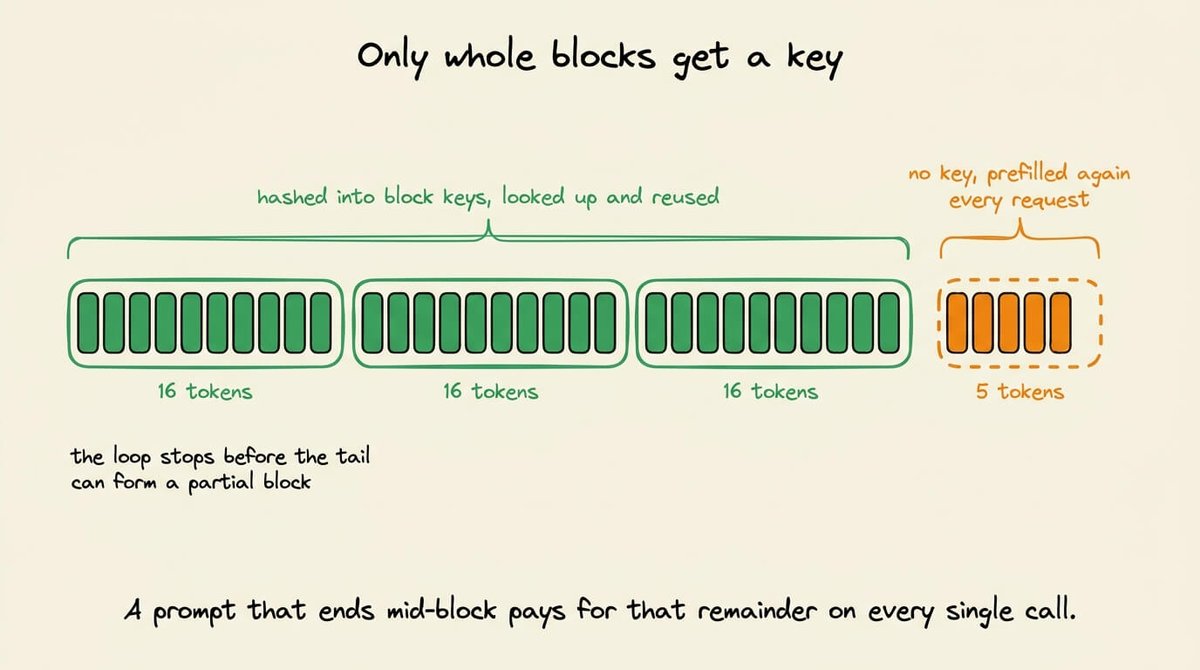
def block_hashes(token_ids, salt=None): """把 token 序列切成块并链式哈希,得到每块的 key。""" hashes, parent = [], hash(salt) # 只哈希完整块,尾部不足 16 的残块跳过 for start in range(0, len(token_ids) - BLOCK_SIZE + 1, BLOCK_SIZE): block = tuple(token_ids[start : start + BLOCK_SIZE]) parent = hash((parent, block)) hashes.append(parent) return hashes
def schedule(token_ids, cache): """返回可复用多少 token,其余重新分配。""" matched_blocks = 0 for h in block_hashes(token_ids): if h not in cache: break # 第一个 miss 结束全部复用 cache[h].ref_count += 1 # 钉住,防止被淘汰 matched_blocks += 1 reused_tokens = matched_blocks * BLOCK_SIZE to_prefill = token_ids[reused_tokens:] return reused_tokens, to_prefill要点:
- 链式哈希:第 5 个块的 key 编码的是第 1~5 块,不是第 5 块自己。保证匹配的是完整前缀;
- 尾部残块跳过:
range停在len - BLOCK_SIZE + 1,说明块大小会造成命中损失; ref_count:淘汰只碰 ref_count 为 0 的块,说明缓存复用和缓存淘汰之间存在生命周期管理。
租户隔离:salt#
- 相同文本 → 相同块 key → 指向 GPU 上同一份物理 KV,多个请求共享读(同应用内正是想要的)
- 不同租户传不同 salt → 首级哈希不同 → 相同文本也产生不同 key,永不共享 → 每租户一份,费内存和命中率,但做到隔离
transformers demo实现:prefill 一次、每请求深拷贝#
把前面的引擎机制降级成一个最小实验:
先计算共享前缀 ↓保存 prefix KV ↓每个请求复制一份 prefix KV ↓在各自副本后面继续生成证明两件事:
- 共享前缀只需要 prefill 一次;
- 每个请求生成时必须有独立的后续 KV 状态。
import copyimport torchfrom transformers import AutoModelForCausalLM, AutoTokenizer, StaticCache
# ---------- 1. 加载模型和分词器 ----------model_id = "HuggingFaceTB/SmolLM2-360M-Instruct"tokenizer = AutoTokenizer.from_pretrained(model_id)model = AutoModelForCausalLM.from_pretrained(    model_id,    torch_dtype=torch.bfloat16,    device_map="auto")
# ---------- 2. 定义共享的前缀(所有请求共用的系统指令) ----------SHARED_PREFIX = """You are a careful assistant.                   Answer in one short sentence."""
# ---------- 3. 创建静态 KV 缓存对象 ----------# StaticCache 是 transformers 提供的 KV 缓存容器,可预先分配固定长度的内存,# 避免动态扩展带来的开销。这里指定最大缓存长度为 1024 个 token。prompt_cache = StaticCache(    config=model.config,   # 从模型配置中读取层数、头数、维度等参数    max_cache_len=1024)
# ---------- 4. 对共享前缀进行分词,并移到模型设备 ----------prefix_inputs = tokenizer(SHARED_PREFIX, return_tensors="pt").to(model.device)
# ---------- 5. 第一次前向传播:只处理前缀(Prefill),不生成新 token ----------# 目的:将前缀的所有 token 对应的 Key/Value 计算出来并填入 StaticCache 中。# 之后所有请求都可以复用这份已计算好的 KV 缓存,避免重复计算前缀部分的注意力。with torch.no_grad():  # 禁用梯度计算,节省显存和计算    # 调用模型时传入 past_key_values=prompt_cache,模型会将当前输入的 KV    # 追加到缓存中(而不是覆盖)。返回的 past_key_values 就是更新后的缓存。    prompt_cache = model(        **prefix_inputs,        past_key_values=prompt_cache    ).past_key_values
# ---------- 6. 准备多个不同的用户问题 ----------questions = ["What is the capital of France?", "Name one ocean."]
# ---------- 7. 对每个问题分别生成回答 ----------for question in questions:    # 7.1 将共享前缀和当前问题拼接后分词    # 注意:此时 tokenizer 会把整个字符串(前缀+问题)一起编码,    # 但由于前缀部分已经在缓存中,后续生成时会自动跳过重复计算。    inputs = tokenizer(        SHARED_PREFIX + question,        return_tensors="pt"    ).to(model.device)
    # 7.2 **关键操作:深拷贝(deepcopy)共享缓存**    # 原因:每个请求的生成过程会不断向缓存中追加新的 KV(生成的新 token),    # 如果直接使用同一个缓存对象,多个请求会互相污染(串行时也会保留其他请求的生成历史)。    # 深拷贝确保每个请求拥有自己独立的缓存副本,初始状态完全一致(仅含前缀内容)。    past_key_values = copy.deepcopy(prompt_cache)
    # 7.3 生成答案    # 传入 past_key_values 后,模型知道前导 token 的 KV 已经存在,    # 因此只需处理“问题部分”(即 inputs 中除前缀以外的 token)并逐步生成新 token。    # do_sample=False 表示使用贪心解码(确定性)。    outputs = model.generate(        **inputs,        past_key_values=past_key_values,        do_sample=False    )
    # 7.4 解码并打印完整回复(包含用户问题)    print(tokenizer.decode(outputs[0], skip_special_tokens=True))
生产引擎一般不做整份张量拷贝,而是:
共享物理 KV block + 每个请求维护自己的逻辑路径 + 引用计数管理生命周期所以这段代码和前面的 vLLM 实现之间是:
Transformers demo:复制缓存,容易理解生产推理引擎:共享物理块,节省内存要点:
- 用 StaticCache 而非 DynamicCache:需要一份固定大小、能被复制的分配
model(...)是纯 prefill,只为把缓存填起来- 每个 question 拼接在相同前缀后,前缀部分的 token ID 每次完全一致——正是引擎哈希链检查的条件
- 为什么要 deepcopy:generate 会原地追加,不拷贝的话第一个问题就把前缀污染给第二个。生产引擎不拷贝张量,而是共享物理块 + 引用计数,所以复用近乎零成本(而不是与前缀长度成正比)
块大小与缓存总量的权衡#
前面已经说明缓存怎么命中,这一节讨论:
缓存机制有效,但应该缓存多少、块切多大?
主要有两个权衡。
块大小#
块小:
- 尾部浪费少;
- 部分前缀更容易命中;
- 哈希条目更多;
- 管理成本更高。
块大:
- 哈希和查找成本低;
- 管理简单;
- 尾部残块浪费更多;
- 只要块内有变化,整个块都不能复用。
缓存和运行请求争抢显存#
KV cache 不是额外无限内存,而是和正在运行的请求共用 GPU 内存池:
缓存占得越多→ 留给新请求的 block 越少→ 并发能力可能下降所以缓存不是越大越好,而是要在:
命中收益vs显存占用和并发损失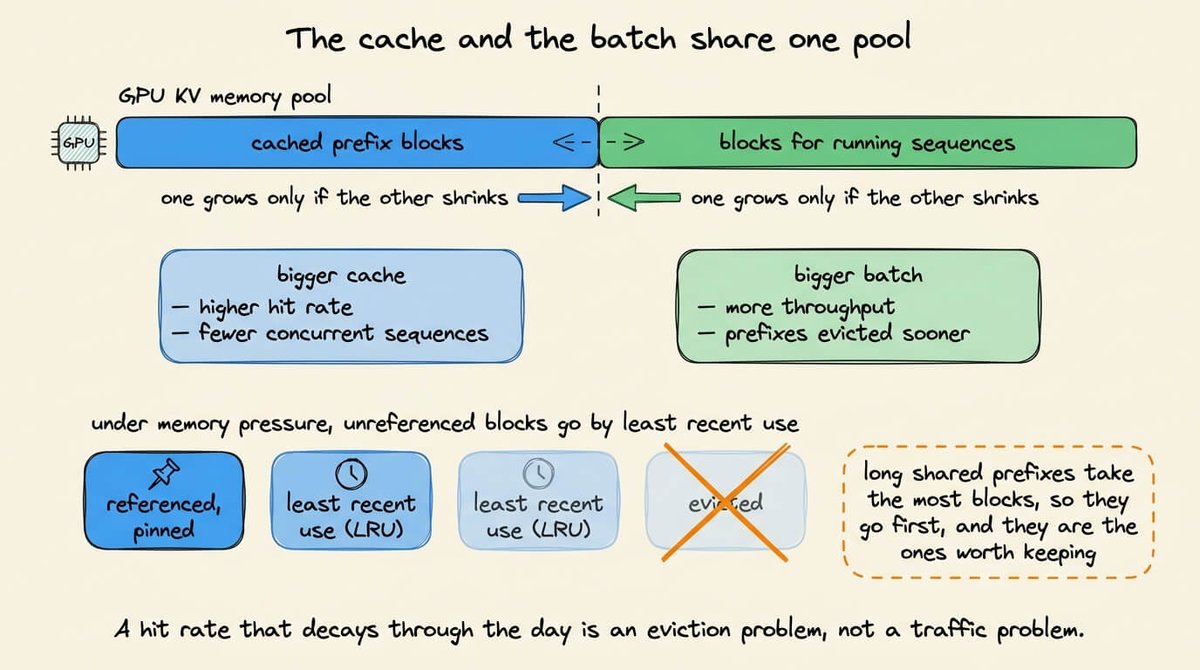
两个边界#
-
只省 prefill,不省 decode:
Prefix caching 只能跳过已经算过的输入前缀。
它不能直接减少生成阶段每个新 token 的计算,所以:
长 prompt、短回答 → 收益可能明显短 prompt、长回答 → 收益可能有限 -
哈希本身有成本:如果每个 prompt 都不同:
没有缓存命中但仍然付出了哈希、查表、管理缓存的成本结果可能反而变慢。
因此要先确认流量是否具有较高的前缀重复率。
三、Prompt Caching:Provider 把 Prefix Caching 商品化#
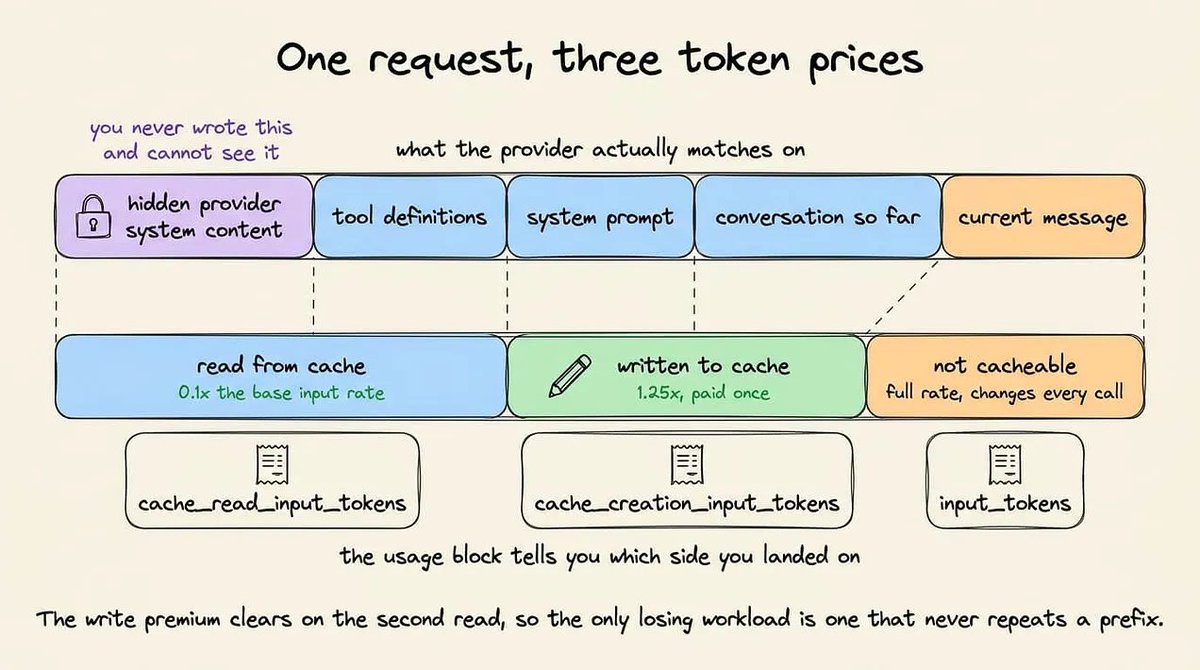
这是云服务商在API层暴露的计费优化。本质就是 prefix caching,但加上了:
- 计费语义:cache write 缓存写入收溢价,cache read 缓存读取大幅折扣
- TTL管理:缓存存活时间(OpenAI 5-10分钟,Anthropic可选5分钟或1小时,Gemini按小时收存储费)
- 匹配规则:必须是前缀精确匹配,包括空格和格式。一个字符差异就全 miss。
OpenAI 是全自动(≥1024 token自动触发),Anthropic 需要显式 cache_control 标记,Gemini 是显式创建缓存对象。
代码示例:Anthropic 的 cache_control#
import anthropic
client = anthropic.Anthropic()   # 从环境变量读 ANTHROPIC_API_KEY
# 必须超过模型的最小可缓存长度,否则什么都不会被缓存LONG_INSTRUCTIONS = "You are a precise technical editor. " * 400
def ask(question: str):    return client.messages.create(        model="claude-sonnet-4-6",        max_tokens=512,        system=[            {                "type": "text",                "text": LONG_INSTRUCTIONS,                "cache_control": {"type": "ephemeral"},   # 标记以上全部可缓存            }        ],        messages=[{"role": "user", "content": question}],    )
for question in ["Summarize section 3.", "Now rewrite it for a beginner."]:    resp = ask(question)    u = resp.usage    print(f"write={u.cache_creation_input_tokens} read={u.cache_read_input_tokens} uncached={u.input_tokens}")
# write=2823  read=0     uncached=14# write=0     read=2823  uncached=17
四、Context Caching#
Context Caching 没有准确的定义概念,它是将 KV Cache 从“临时计算产物”提升为“系统级数据资产”的架构范式。
1、存储维度:从“显存暂存”到“分布式持久化”
- 传统 KV Cache:绑定在 GPU 显存中,随请求结束而物理释放(即使 Prefix Caching 保留块,也仅限于单机显存)。
- Context Caching:将存储层下沉并池化。它利用集群中的 CPU 内存、NVMe SSD 甚至远端对象存储,构建全局共享的 KV 缓存池(如 Mooncake 的 L2/L3 层)。
2、匹配维度:从“绝对前缀”到“灵活定位”
- 传统 Prefix Caching:只能复用输入文本开头完全一致的 Token 序列(Hash 链必须从头对齐)。
- Context Caching(LMCache 为代表):引入 CacheBlend等机制,允许复用文本中间任意一段的 KV。即使上下文前缀不同,只要命中中间某段长文本,就能通过位置编码重映射(RoPE 修正)和部分 Attention 重算(掩码修正)来让这段 KV “合法”地插入当前请求。
3、生命周期维度:从“单次会话”到“跨时域复用”
- 传统/云服务 Prompt Caching:虽能跨请求复用,但通常有 TTL(存活时间,如 5-10 分钟),且严格绑定同一业务租户。
- Context Caching:生命周期极其灵活。它可以跨会话(Cross-Session)、跨用户、甚至跨天持久化。例如,将企业内部的庞大知识库(如全部财报 PDF)预先计算成 KV 存入缓存池,未来任何员工在任何新建会话中提问,都能瞬间命中这段预处理好的缓存。
- 本质:将“实时计算”转变为“预计算+离线更新”,KV 成了可长期持有的业务数据。
Mooncake 更像是一个“分布式 KV 缓存数据库”,解决的是大规模集群下 KV 缓存“存不下、搬不动”的问题。而 LMCache 更像是一个“智能缓存管理中间件”,解决的是“如何更灵活地复用”的问题,特别是通过 CacheBlend 技术突破前缀限制。两者可以协同工作:LMCache 负责决策和管理,Mooncake Store 负责高性能的分布式存储与传输。
RAG 的问题:顺序变化的检索块#
普通 prefix caching 假设:
系统指令 + 固定上下文 + query前面的内容大体稳定。
但 RAG 通常是:
系统指令 + 检索块 A/B/C + query每次检索结果可能不同,或者顺序变化:
请求 1:A + B + C请求 2:C + A + B虽然 A、B、C 这些块的内容可能相同,但由于链式哈希依赖顺序:
A → B → CC → A → B它们会形成完全不同的前缀链,普通 APC 可能几乎无法复用。
接着原文否定了一个看似简单的方案:
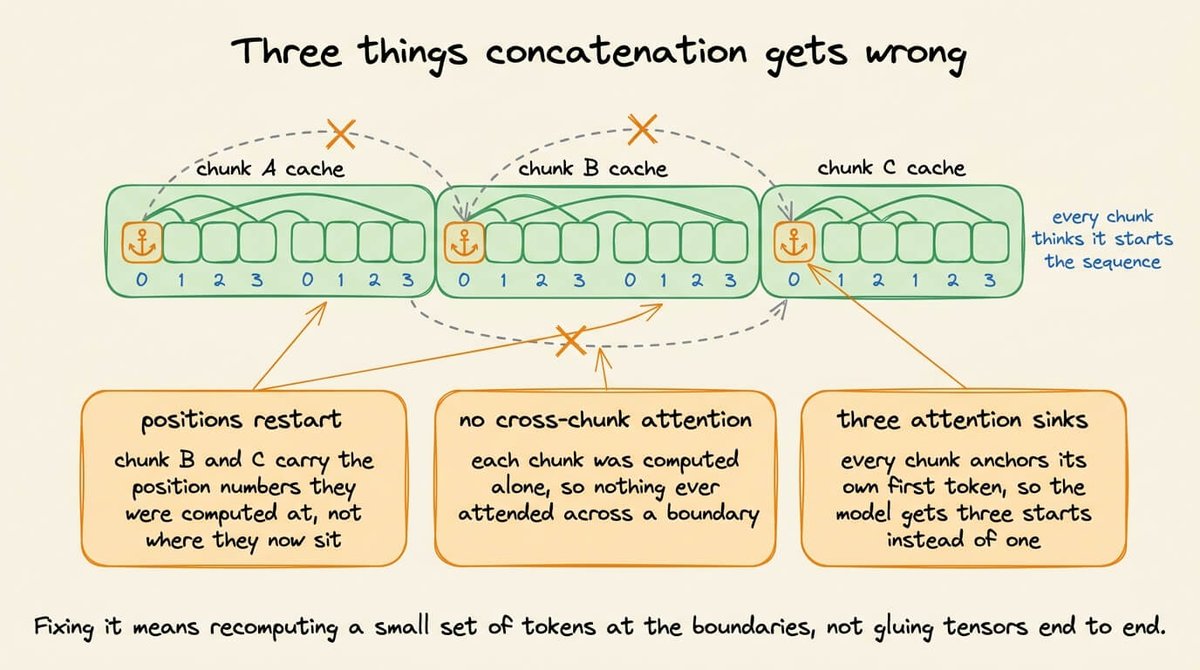
把每个检索块分别 prefill,再把 KV 拼起来。
原因是 KV 不是普通文本片段,不能随便拼接。每个块的注意力计算依赖:
- 它在完整序列中的位置;
- 它是否 attend 到其他块;
- 跨块 attention 的结果;
- position encoding。
所以独立计算后的 KV 不能直接当作完整 prompt 的 KV。
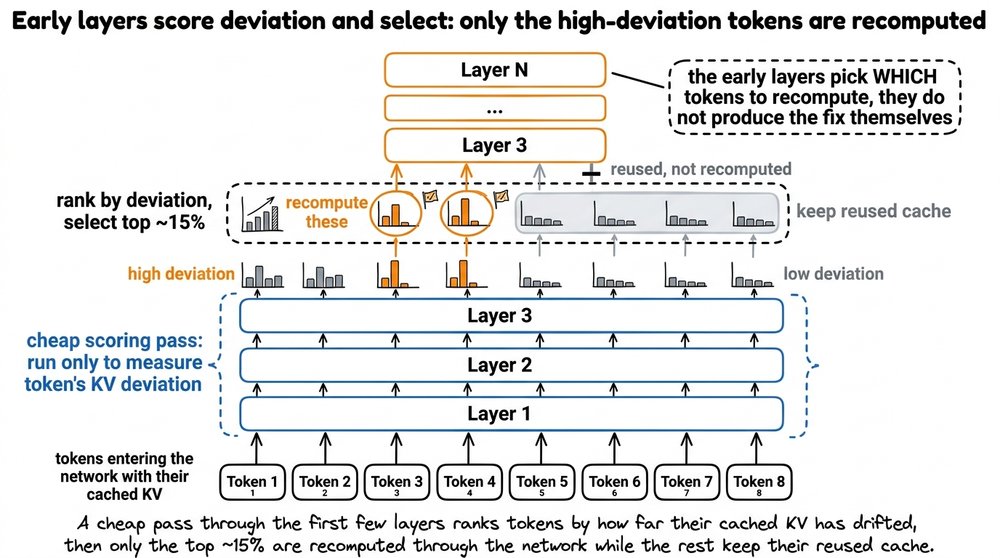
最后引出现成方案:LMCache 的 CacheBlend github.com/LMCache/LMCache
工作流程:
- 预计算与存储:系统会预先计算并存储知识库中每个独立文本块(如一篇文档、一段 FAQ)的 KV Cache。
- 请求到达与检索:当用户提问时,RAG 系统检索出相关的文本块。
- 拼接与复用:CacheBlend 将检索到的文本块的 KV Cache 按新顺序拼接起来。
- 修正与融合:
- 自动更新位置编码,解决“位置错位”。
- 对拼接边界处的少量 token 进行选择性注意力重算,解决“语义错位”。
- 生成回答:将修正融合后的 KV 直接用于后续的 Decode 阶段,大幅节省 Prefill 时间。
它解决的是:
普通 prefix caching:只能复用连续前缀CacheBlend:可以复用乱序、分散的检索块