(下)北邮研究生不吃不喝耗时两个月倾力制作!大模型架构超详细精讲
ALL in Transformer | 全网最清晰、最易懂的transformer讲解(上)编码器层
llm 是一个非常强的条件概率模型:
P(next_token | previous_tokens, parameters)这条公式背后藏着三层重要认识:
- 第一,模型能力高度依赖上下文组织方式,这就是为什么 prompt/context engineering 重要。
- 第二,模型输出不是一个唯一答案,而是一个概率分布,所以采样参数会影响生成风格与稳定性。
- 第三,模型参数里存的是压缩后的统计规律,不是一条条可显式索引的事实表,所以它会幻觉、会过时、会在缺证据时自信生成。
模型可以仅通过上下文里的指令和示例,在不更新参数的情况下快速适应新任务。这种能力通常被称为 in-context learning。
根据 Scaling Law,模型能力通常会随规模增长,但要注意参数规模只是一部分,还有数据规模等。
- 没有经过充足训练,即使参数规模很大,这个模型仍然是 undertrained 欠拟合;
- 如果数据规模远超参数容量,会发生“过拟合”。
为什么 Transformer 能替代 RNN/CNN?
- Transformer 在训练阶段的并行性非常好,因为整个输入序列可以同时经过线性变换、同时计算 attention score、同时做前馈网络。这使得它更适配 GPU/TPU 这种大规模并行硬件;
- trade-off 是注意力的计算随序列长度增长会带来较高的时间与显存开销,这也是长上下文、KV Cache、prefix cache 等工程优化出现的背景。

阶段一:输入准备#
原始文本 → Tokenizer切成token → Embedding映射到向量 → 加入位置信息
1、模型并不直接读取字和词,而是读取 token。同样内容在不同 tokenizer 下 token 数可能差很多,成本与效果都会变。
2、Embedding 层把每个 token 映射成高维向量,让模型可以在连续空间里学习相似语义、相似模式、相似上下文角色
3、Position Encoding 位置编码:因为注意力机制本身对顺序是不敏感的
- 绝对位置编码:模型在训练时见过的最大长度是固定的(比如 512)。如果推理时遇到更长的序列(比如 1024),编码表里没有对应的位置向量,要么截断、要么插值,效果往往很差。
- 正余弦位置编码
- RoPE(旋转位置编码):不是给 token 加一个位置向量,而是通过 旋转矩阵 来修改 query 和 key 向量,使得内积结果自动包含相对位置信息。优点是更适合外推到更长上下文。

RoPE 原论文:RoFormer: Enhanced Transformer with Rotary Position Embedding
阶段二:核心计算#
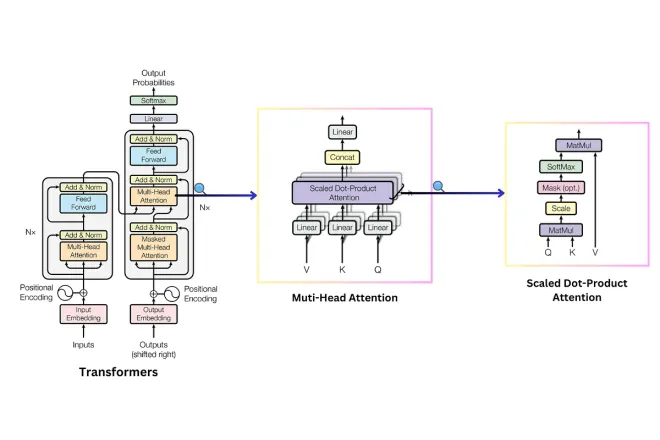
Transformer Blocks(组成大模型的“基本计算单元层”)→ 无论编码器块还是解码器块,每个Transformer Block都严格包含两大核心组件:
-
多头自注意力(Multi-Head Self-Attention)——负责“信息路由”。让每个token去“看”并“聚合”其他token的信息。
-
前馈神经网络(FFN)——负责“局部加工”。让每个token独立地对自己已经聚合好的信息进行非线性变换(相当于一个两层的全连接网络)。
4、Self-Attention(自注意力)是 Transformer 模型的核心组件。为每个 token 生成三个不同的向量 Q、K、V,通过 Q、K 这两个参数计算每个 token 与序列中其他 token 的关联强度,从而得到一组注意力权重,从而更新自己的 V 值,作为新的表示,它包含了与其他 token 之间的关联信息。
- Q(Query,查询):代表当前 token 想查询什么的信息。
- K(Key,键):代表当前 token 自身提供什么标签供别人查询。
- V(Value,值):代表当前 token 实际携带的内容,最终按注意力权重聚合。
这三个向量是通过三个可学习的权重矩阵 W_Q, W_K, W_V 与输入向量相乘得到的。
注意力权重的计算流程:对于序列中的第 i 个 token,它的 Query 向量记作 q_i,所有 token 的 Key 向量为 k_j(j 从 1 到 n)
-
计算分数:
score_{i,j} = q_i · k_j(点积),表示 token i 对 token j 的原始关注程度。 -
缩放:除以
√d_k(d_k是 Key 向量的维度),防止点积值过大导致梯度消失。 -
Softmax 归一化:对第
i行所有n个分数应用 Softmax,得到注意力权重α_{i,j},满足∑_j α_{i,j} = 1。α_{i,j}表示 token i 应该从 token j 处提取多少信息。 -
加权求和 Value:用注意力权重对每个 token 的 Value 向量
v_j加权求和,得到 token i 的新输出向量:output_i = ∑_j α_{i,j} · v_j
整个过程可以用矩阵运算一次性完成所有 token 的输出计算:
Attention(Q, K, V) = softmax(Q K^T / √d_k) V其中 Q, K, V 是分别将各 token 的 q, k, v 堆叠成的矩阵。


误区:“得到自己新的 v,给下一个 token 用”
你需要区分 “序列位置(第 i 个)” 和 “网络层数(第 L 层)”:
- 错误理解:第
i个 token 算出的新输出,是传给第i+1个 token 去用的。
- 事实:同一层内,所有 token 是并行计算的。第
i个 token 的输出不会传给第i+1个 token 作为输入。它们彼此独立地并行用原始的 Q、K、V 算出自己的新表示。- 正确理解:第
i个 token 算出的新向量output_i,是作为下一层网络层(Layer L+1)的输入,传给同一个位置(第 i 个位置)的 token 使用的。
5、Encoder-Only 编码器
- 输入:上一层的输出(或原始嵌入)
X,形状(L, d_model)。 - 层归一化1(Pre-LN):对
X做 LayerNorm,得到X_norm1。作用:稳定数值分布,加速训练。 - 多头自注意力(Multi-Head Self-Attention):输入
X_norm1,分别计算 Q、K、V,然后做多头注意力,输出AttnOut。作用:让每个 token 融合整个序列的信息(“信息路由”)。 - 残差连接1:
X + AttnOut,得到X1。作用:梯度捷径,防止退化。 - 层归一化2(Pre-LN):对
X1做 LayerNorm,得到X_norm2。 - 前馈神经网络(FFN):通常是两层全连接,中间激活函数(ReLU/GELU),输出
FFNOut。作用:对每个 token 独立进行非线性变换(“局部加工”),使得模型能够学习复杂、非线性的特征。 - 残差连接2:
X1 + FFNOut,得到该层的最终输出X_out,传递给下一层。
每一层都通过残差和归一化稳定训练,使得深度堆叠成为可能。
6、Decoder-Only 解码器
输入:X (形状 [L, d_model]),来自上一层的输出
- 层归一化 (Pre-LN) →
X_norm1 - 掩码多头自注意力 (Masked Self-Attention) →
attn_out- Q、K、V 全部来自
X_norm1(自己和自己算注意力) - 带有因果掩码(只能看到当前及之前的 token)
- Q、K、V 全部来自
- 残差连接1:
X + attn_out→X1 - 层归一化 (Pre-LN) →
X_norm2 - 前馈神经网络 (FFN) →
ffn_out - 残差连接2:
X1 + ffn_out→X_out(作为下一解码器层的输入)
7、Encoder-Decoder 解码器
输入: X_dec (形状 [L_target, d_model]),来自解码器上一层的输出或初始嵌入。另外还有编码器的最终输出: enc_mem (形状 [L_src, d_model]),所有解码器层共享。
- 层归一化 (Pre-LN) → X_norm1
- 掩码多头自注意力 (Masked Multi-Head Self-Attention) → attn_out1
- 残差连接: X_dec + attn_out1 → X1
- 层归一化 (Pre-LN) → X_norm2
- 交叉注意力 (Cross-Attention) → cross_attn_out
- 查询来自 X_norm2,键/值来自 enc_mem
- 残差连接: X1 + cross_attn_out → X2
- 层归一化 (Pre-LN) → X_norm3
- 前馈神经网络 (FFN) → ffn_out
- 残差连接: X2 + ffn_out → X_out (作为下一解码器层的输入)
交叉注意力在干什么?
解码器并不是要“得到”编码器的结果,而是把编码器的结果当作一个外部知识库(Key 和 Value)来查询。
具体矩阵运算如下(针对解码器当前生成的某个位置,比如正在生成第
t个英文单词):
- Query(Q) 来自于解码器自己上一层的输出(代表“我现在想生成什么”)。
- Key(K)和 Value(V) 全部来自编码器的
enc_mem(代表“输入中文里有哪些语义特征”)。- 计算
Attention(Q, K) = softmax(Q · K^T),得到一个注意力权重分布(长度等于中文句子长度,比如 3)。
- 如果权重中,“爱”对应的位置得分最高,说明解码器当前想生成的内容与“爱”的语义最相关。
- 加权求和:用这个权重对
V(编码器的值向量)进行加权求和,得到交叉注意力的输出向量。
阶段三:输出决策#
输出隐藏状态 → Linear 改变向量维度 + Softmax 得到概率分布 → 采样/贪心选择 → 生成下一个token
8、生成具体 token 的流程
解码器最后一层输出 X_out (L_t, d_model) │ ▼ ┌───────────────┐ │ 线性层 (d_model → vocab_size) │ └───────────────┘ │ ▼ logits (L_t, vocab_size) │ │ 取最后一个位置 ▼ last_logits (vocab_size,) │ ▼ Softmax → probs │ ▼ ┌───────────────┐ │ 采样策略 (greedy / top‑k / top‑p) │ └───────────────┘ │ ▼ next_token (整数 id) │ ├─ 如果是 <eos> → 停止 │ └─ 否则: 将其转化为嵌入 + 位置编码 │ ▼ 追加到解码器输入序列 │ ▼ 回到解码器第一层,重复-
解码器最后一层输出通过线性层映射到词汇表上的 logits,将每个位置的
d_model维向量转换成词表大小的分数。含义:
logits[i, v]表示第i个位置(即第i个 token)预测下一个 token 为词汇表中第v个词时的未归一化分数。 -
对于推理,我们通常只关心最后一个位置(即当前已经生成的最后一个 token),因为它要预测的是下一个 token。
所以实际取
last_logits = logits[-1, :],形状(vocab_size,)。 -
Softmax 得到概率分布
probs = softmax(last_logits) # 形状 (vocab_size,)probs[v]表示下一个 token 是词汇表中第v个词的概率。所有概率之和为 1。 -
采样策略(决定具体生成哪个 token):
-
贪心搜索(Greedy):
next_token = argmax(probs)最简单,但缺乏多样性。 -
多项式采样(Multinomial): 按
probs分布随机抽取。温度系数T可调节平滑度:probs' = softmax(logits / T)-
T=1:原始分布 -
T>1:更平滑(更随机) -
T<1:更尖锐(更倾向于高概率词)
-
-
Top‑k 采样:只保留概率最高的 k 个 token,重新归一化后抽样。
-
Top‑p(核采样):保留累积概率超过 p 的最小 token 集合,再抽样。
实际生成时,还会处理结束标志
<eos>:一旦抽到<eos>,停止生成。 -
-
生成下一个 token 并更新解码器输入
- 将
next_token(一个整数 id)转换为对应的词嵌入向量(加上位置编码)。 - 将这个新 token 追加到解码器的输入序列末尾。
- 重复上述步骤(从解码器第一层到输出映射),直到遇到
<eos>或达到最大长度。
- 将
三种主流 Transformer 架构及对比#
| 架构 | 注意力类型 | 是否有交叉注意力 | 是否有内置输出头 | 训练时输入 | 推理时输入 | 核心任务 |
|---|---|---|---|---|---|---|
| Encoder-Only(BERT) | 双向(无掩码) | 无 | 无(特征向量直接输出) | 完整句子(如 [CLS]我爱中国) | 完整句子(直接提取特征) | 理解(适合“判别式”任务:文本分类、完形填空、情感分析) |
| Decoder-Only(GPT) | 单向(因果掩码) | 无 | 有(Linear + Softmax) | 完整标签序列右移(如 [start]我爱中) | 长度从 1 开始,自回归拼接到 L | 生成(续写、对话、代码生成) |
| Encoder-Decoder 解码器(原始 Transformer) | 单向(因果掩码) | 有(Q来自自己,KV来自编码器) | 有(Linear + Softmax) | 完整标签序列右移(如 [start] I love) | 长度从 1 开始,自回归拼接到 L | 转换(机器翻译、文本摘要) |
Decoder-Only 架构去掉了负责理解输入的编码器,以及解码器中的交叉注意力模块,只保留了带有“因果掩码”的自注意力和前馈网络,专注于自回归的生成任务。
在通用聊天、代码生成、Agent 执行、开放式续写这些场景里,decoder-only 最终成为主流,原因是:
- 极致的灵活性:去掉了交叉注意力(需要依赖编码器输入),意味着模型不依赖于输入格式。你可以做对话(输入是前文),可以做代码补全(输入是前半段代码),甚至可以处理超长文本。而 Encoder-Decoder 必须同时处理“源文本”和“目标文本”,灵活性受限。
- 极致的规模化(Scaling Law):Decoder-Only 结构最简洁,没有编码器,参数全部用来堆叠“解码器块”。在相同的参数量和数据量下,它能堆得更深,效果更好。
- 训练目标统一:decoder-only 直接做自回归的因果语言建模,和实际生成任务非常一致,互联网上所有的文本(无论百科、小说、代码)都是天然的训练数据。
- 产品接口简单:对上层应用来说,给上下文,继续生成就是一个足够统一的接口。
- 生态成熟:推理框架、KV Cache、prefix cache、流式输出、采样控制、函数调用等能力基本都围绕 decoder-only LLM 形成了完整工业链。
Encoder-Only 架构(以 BERT 为例)#
核心本质:只做特征提取,不生成序列。没有掩码(双向注意力),没有交叉注意力,没有线性输出头(核心架构到特征向量就结束)。
输入:原始文本序列的 Token 嵌入 + 位置编码(形状 [L, d_model],如 [CLS] 我 爱 中 国 [SEP])
重复 N 次 Encoder 后(经过最后一层),最终输出:上下文语义向量矩阵(形状 [L, d_model])
特别注意:Encoder-Only 的“输出”就是这组特征向量。如果你想做分类任务(如情感分析),就在这个输出上取 [CLS] 位置对应的向量,额外接一个随机初始化的分类头(Linear → Softmax)单独训练;如果你想做词性标注,就取全部 L 个向量接分类头。但在架构层级上,Encoder 本体到此为止,没有内置的 Linear→Softmax 输出层。
1、预训练阶段(本质:破坏+重建):
它的训练机制是“完形填空”(Masked Language Modeling, MLM),而不是“写作文”(自回归)。
这是BERT等模型学会“理解语言”的核心阶段。它的操作极其反直觉:
- 输入怎么处理:在原始输入
[CLS] 我 爱 中 国 [SEP]中,随机选择 15% 的位置,把这些位置的词盖住。比如把“中”字替换成特殊的[MASK]标记。输入变成了:[CLS] 我 爱 [MASK] 国 [SEP]。 - 模型在干什么:把被破坏的句子丢进 Encoder。因为有双向注意力,“中”字左边的“我爱”和右边的“国”都能看到。Encoder 输出的特征向量里,
[MASK]位置对应的那一行向量,已经融合了“我爱”和“国”的上下文信息。 - 关键机制:临时挂载“输出头”:虽然核心架构没有输出头,但在预训练时,会在
[MASK]这个位置的上方,临时搭建一个Linear → Softmax分类器。- 这个分类器只做一件事:拿着
[MASK]位置的特征向量,在词表(10万个词)里猜概率,猜这个空位原本是哪个词。 - 真实答案是“中”,计算交叉熵损失,反向传播。注意:反向传播的梯度会穿过这个临时的分类头,一直传回底层的 Encoder 层,更新 Encoder 的权重。
- 这个分类器只做一件事:拿着
2、微调阶段(本质:嫁接新头):
当你拿到预训练好的 Encoder 核心(特征提取器)去做具体任务(比如情感分类)时:
- 重新搭建新头:对于分类任务,我们取出
[CLS]位置的特征向量,重新随机初始化一个Linear → Softmax新头(比如 2 分类,输出“好评/差评”的概率)。 - 训练参数的区别:
- 方式一(特征提取):冻结 Encoder 所有权重不动,只训练新加的
Linear → Softmax头。这个头学得很快,因为它相当于在“现成的、高质量的语义空间”里画一条分割线。 - 方式二(微调):不仅训练新头,同时用较小的学习率更新 Encoder 底层的权重,让 Encoder 提取的特征更贴合“情感分析”这个特定任务。
- 方式一(特征提取):冻结 Encoder 所有权重不动,只训练新加的
Decoder-Only 架构(以 GPT 为例)#
核心本质:只做自回归生成。没有交叉注意力,有因果掩码(只能看左边),自带输出头(Linear + Softmax)。
| 训练维度 | Encoder-Only (BERT) | Decoder-Only (GPT) |
|---|---|---|
| 本质任务 | 去噪(Denoising):修复被破坏的句子 | 预测(Prediction):续写未来的词 |
| 输入形态 | 完整句子,但内部随机关掉 15% 的词([MASK]) | 句子左半边(标准答案右移,看不到右侧词) |
| 注意力视野 | 双向(左右都能看),否则猜不出“中” | 单向(因果)(只能看左边),模拟真实写作 |
| 训练时的输出头 | 临时挂载在 [MASK]位置,用完即扔 | 永久内置在架构最后(LM Head),训完即用 |
| 训练 Loss 计算 | 只计算被 [MASK] 盖住的那 15% 位置的损失 | 计算每个位置(全部)预测下一个词的损失 |
-
训练时:“并行预测”,整个
L个位置的概率分布一次性算出(并行),与真实标签计算交叉熵损失。- 输入是什么:完整的标准答案序列(右移一位),比如
[<start>, 我, 爱, 中]。 - 模型在干什么:矩阵乘法是并行的。模型同时计算出 4 个位置的输出 logits。
- 位置 1(对应输入
<start>)预测“我”; - 位置 2(对应输入“我”)预测“爱”;
- 位置 3(对应输入“爱”)预测“中”;
- 位置 4(对应输入“中”)预测“国”。
- 位置 1(对应输入
- 关键本质:模型并没有把位置 1 预测出的“我”拿去作为位置 2 的输入。位置 2 的输入依然是标准答案里的“我”,而不是模型自己猜的“我”。这就是教师强制(Teacher Forcing)。
- 输入是什么:完整的标准答案序列(右移一位),比如
-
推理时:“串行生成”,只取最后一个位置(位置
L)的概率分布,选出概率最大的词 ID 输出,然后将这个词拼接到输入末尾,循环执行。- 输入是什么:一开始只有
[<start>]。 - 模型在干什么:第一次前向传播,只取位置 1 的 logits,输出“我”。(此时位置 2、3、4 虽然矩阵运算时存在,但因为输入没有对应的词,算出的结果是废的,直接丢弃)。
- 关键动作:模型把输出的“我”拼接到输入末尾,变成
[<start>, 我],重新跑一遍整个解码器。第二次前向传播,只取位置 2 的 logits,输出“爱”。 - 本质:推理时,模型必须使用自己上一步的输出作为下一步的输入,因为没有任何标准答案可以提供。
- 输入是什么:一开始只有

Encoder-Decoder 架构#
输入(目标端嵌入 + 位置编码 + 编码器内存) ↓解码器层 1(掩码自注意力 → 交叉注意力 → FFN) ↓解码器层 2(同上,输入来自上一层) ↓...(重复 N 次) ↓最终 LayerNorm ↓线性投影层(Linear) → 得到 logits ↓Softmax → 得到概率分布 ↓最终输出(训练时是完整序列 logits,推理时是一个 token)
训练和推理#
训练和推理的最本质区别是权重是否更新:
- 训练:模型计算完输出后,会拿输出结果(预测的概率分布)与真实标签计算交叉熵损失(Loss),然后进行反向传播(链式求导),更新所有层的
W_Q, W_K, W_V, W_O以及 FFN 层的权重矩阵。权重在变。 - 推理:没有反向传播,没有梯度计算。所有权重矩阵被冻结(固定不变)。模型只是把输入数据拿过来做一次或多次前向传播(Forward Pass),算出结果就结束。
1、损失是“所有权重”的函数
整个网络(几亿个参数)可以看作一个巨大的复合函数 F。输入是词向量,输出是损失值 L = F( W1, W2, W3, ..., Wn )。
虽然你只看到一个数字 0.916,但在数学上,它是关于每一个权重的多元函数值。
2. 反向传播就是链式求偏导(核心本质)
我们要算出:如果我把第 k 个权重稍微增大一点点,损失 L 会变大还是变小?变多少?
这个问题用数学表达就是求偏导数 ∂L / ∂W_k。
- 如果
∂L / ∂W_k是正数(比如 +2.5):意味着权重增加,损失增加。为了让损失下降,我们就要减小这个权重(减去一个正数)。 - 如果
∂L / ∂W_k是负数(比如 -0.3):意味着权重增加,损失反而下降。为了降低损失,我们就要增大这个权重(减去一个负数)。
3. 针对“每一个”权重,链式法则一路乘回去
从输出层的损失 L,往前倒推:
- 损失
L对输出层 logits 求导; - 输出层 logits 对线性层权重
W_out求导; W_out的梯度进一步传回给 FFN 层;- FFN 的梯度再传给 Cross-Attention 的 QKV 投影矩阵;
- 直到第一层的 embedding 表。
整个过程是矩阵的梯度链式乘法(雅可比矩阵连乘)。
4. 最后统一更新(梯度下降)
算出所有偏导数后,执行一步更新:W_new = W_old - 学习率 × ∂L/∂W_old。
推理机制与采样参数#

一次完整生成通常是循环式的:输入上下文,模型算出 logits,解码器根据采样策略选 token,把新 token 再追加到上下文里,然后继续下一轮。直到命中停止条件,比如生成到终止符、达到最大 token 数、输出完整结构、或者工具调用流程结束。
采样参数控制的是怎么从概率分布里拿答案
- temperature 可以理解为放大或压缩概率分布差异的旋钮:温度低时,高概率 token 更容易被选中,输出更集中、更像最保守续写;温度高时,低概率 token 更有机会被选中,输出更发散、更有创造性。
- top-p 按累计概率质量截断候选集,top-k 按固定候选数量截断
推理预算 reasoning effort / thinking budget 控制的是模型在拿答案前愿意花多少计算去想
把 temperature 调成 0,结果是不是就一定正确?
低温度只会让模型更偏向高概率 token,并不能把错误知识变成正确知识,也不能弥补缺失上下文、错误工具结果、差的 prompt 或模型本身的能力上限。
长上下文主要是显存问题#
长下文的显存问题主要来自两方面:
- 显存杀手 1:KV Cache(存储杀手)→ GQA 出手
- 显存杀手 2:注意力矩阵(计算/激活杀手)→ Sparse Attention 出手
Dense Attention vs Sparse Attention#
这里的稀疏和密集指的是 Attention(注意力)层的关注范围(Token视野)。
- Dense Attention(全注意力):每个 Token 必须和序列中所有其他 Token 计算注意力分数(复杂度 O(n²))。
- Sparse Attention(稀疏注意力):每个 Token 只和序列中部分 Token 计算。
| 维度 | MSA (MiniMax) | DSA (DeepSeek) |
|---|---|---|
| 选择粒度 | 块级(一组连续 Token) | Token 级(单个 Token) |
| 筛选方式 | 基于 GQA 分组,每组独立选择相同的 KV 块 | 为每个查询 Token 动态选择不同的重要 Token |
| 底层架构 | 必须依赖 GQA 架构 | 可与 MHA/MQA/GQA 任意搭配 |
| 核心优势 | 索引开销极低,硬件友好(块状读取) | 选择精度极高,细粒度保留关键信息 |
DSA Deepseek Sparse Attention:
- 筛选(Lightning Indexer):对于每一个当前的查询 Token,DSA 使用一个轻量级的“闪电索引器”,为序列中所有历史 Token 计算一个相关性得分。这个得分衡量了每个历史 Token 对当前查询 Token 的重要程度。
- 选择(Token Selector):根据上一步计算出的得分,DSA 只挑选出得分最高的 K 个 Token。这里的 K 远小于总序列长度 L。
- 计算:标准的注意力机制仅在这 K 个被选中的 Token 上执行。

MSA Minimax Sparse Attention:通过将长序列划分为 KV 块,只为每个 GQA 组动态挑选出最重要的 Top-K 个块进行精确计算,从而将标准注意力的复杂度从 O(L²) 降至 O(L·K)。
GQA + MSA:GQA 先把“头数”砍掉(8变2),MSA 再把“长度”砍掉(1024变192)。这是 “双重瘦身” ,显存带宽压力呈指数级下降。
- GQA 分组:2 个 Q 头(
Q0,Q1)共享 1 个 KV 头(KV0),这 3 个脑袋绑在一起,被称为“一组 GQA”。 - 历史序列:当前你已经写了 1024 个 Token。
- MSA 设置:把 1024 个 Token 切成 16 个 KV 块(每块 64 个 Token),设定只选 Top-3(最重要的 3 块)。
第 1 步:生成当前 Token 的“问题”(Q)
现在你要生成第 1025 个 Token。
Q0和Q1各自用自己的独立权重矩阵,把当前输入变成两个不同的查询向量。
第 2 步:“这一组”的索引分支开始干活(粗筛)
此时,索引分支只跑一次,服务于 Q0 和 Q1 这一整组。
- 拿谁的 Q 去打分? 通常 MSA 会把
Q0和Q1合并一下(比如直接拼接或相加压缩),变成一个代表这组“综合口味”的查询向量。 - 对着 KV0 去打分:
KV0手上持有 16 块 历史数据(块1~块16)。 - 选出 Top-3:索引分支给 16 个块打分。
第 3 步:主分支开始计算(精算)
- 主分支计算
Q0:Q0拿着自己的问题,去跟这 3 个块里的 192 个 Key 做点积。 - 主分支计算
Q1:Q1拿着自己的问题,去跟同一批 192 个 Key 做点积。
最后,把 Q0 和 Q1 算出来的结果拼在一起,生成最终的第 1025 个 Token。
MoE:如何实现超大规模参数模型#
这里的稀疏和密集指的是 FFN(前馈神经网络)层的参数激活方式。
- Dense(稠密):每个 Token 流过前馈神经网络 FFN 全部神经元/参数(如 GPT-3);
- Sparse / MoE (Mixture of Experts)(稀疏):每个 Token 只激活 Top-k 个“专家”(如 Mixtral 8x7B)。


残差连接——注意力残差#

图中不断在原始输入中加上各层输出的操作叫做残差连接 Residuals (Residual Connections),这是现代大语言模型的基本范式,后续 deepseek 把前馈神经网络换成了 MoE,QWEN 把注意力改成了 GQA 等。
Kimi 的《AttentionResiduals》这篇论文动了深度学习十年没人碰的底层架构——残差连接。传统残 差是逐层把输入加到输出上往后传,层数一多,早期信息就被稀释了。Kimi的做法是让每一层通过注意力机制回头看所有前序层,按重要性加权聚合,而不是无脑累加。

Thinking 不是外挂的算法,是模型在训练里多走的一步#
Anthropic Messages API 的 thinking 配置:
"thinking": { type: "adaptive" } // 允许在 content 数组里输出 thinking 块,adaptive 表示由模型自己判断这一轮要不要进行 extended thinking实际深度还可以用:
{ "output_config": { "effort": "high" }}控制。

评论
欢迎交流,使用 GitHub 账号登录后即可留言。
在 GitHub Discussions 中查看讨论 ↗