核对日期:2026-09-23。本文先解释相对稳定的浏览器原理,再说明项目定位。项目内部实现以文末所列提交为观察点;安装命令和 API 会随版本变化,实际运行前以对应版本的官方文档为准。
综述:先建立一张图#
浏览器自动化的基础能力是读取当前页面、向浏览器发出操作、取得操作结果。Playwright 等库让程序能可靠地做这件事。Browser Agent 在上面增加了一个决策循环:模型根据任务目标和刚观察到的页面,选择下一步动作;程序执行并重新观察,直到有证据表明任务完成或必须停止。
用户目标(例如:找到某份报告并下载) ↓Agent:观察页面 → 选择动作 → 执行 → 检查结果 → 再观察 ↓ ↑页面表示:DOM / 可访问性树 / 截图 / URL / 事件 ↓自动化能力:Playwright、CDP、WebDriver 等 ↓浏览器进程与会话:Chromium / Firefox / WebKit,tab、cookie、下载 ↓网页:HTML、JavaScript、CSS、Canvas、网络请求这张图回答两个核心问题:
- CDP、Playwright 和 Agent 的关系是什么? CDP 是 Chromium 暴露的调试与控制协议;Playwright 是提供定位、等待和动作 API 的自动化库;Agent 使用这类能力执行自己选出的步骤。Playwright 跨浏览器运行,不能简单理解成“每个 API 都翻译为 CDP”。
- Agent 究竟看见什么、怎样点到目标? 它可以读 DOM、可访问性树和截图,也可以取得 URL、下载和弹窗事件。执行时既能按元素定位,也能按坐标发送输入。它通常不会直接“理解浏览器内部的一切”,而是依据工具整理出的有限页面表示做决定。
一个实用的分工是:已知且稳定的步骤写确定性脚本;页面或步骤未知时,让模型选下一步;动作的权限、超时和完成判定尽量由程序约束。 下面按网页本身、控制通道、Agent 循环、项目选型的顺序展开。
一、浏览器里到底有什么:DOM、可访问性树与截图#
1. 从 HTML 到页面#
网页服务器返回 HTML,浏览器解析出 DOM(Document Object Model,文档对象模型)。DOM 是可被 JavaScript 查询和修改的节点树。浏览器还会结合 CSS 计算样式和布局,形成屏幕上的像素;JavaScript 与网络请求可以在之后继续改变节点或画面。
以这个按钮为例:
<button id="download" aria-label="下载报告">↓</button>同一对象有几种不同表示:
| 表示 | 能读到什么 | 本例会看到什么 | 主要盲区 |
|---|---|---|---|
| DOM | 标签、属性、文本、节点关系 | button、id=download、aria-label | 原始树噪声多;有节点不代表用户能看见或点到 |
| 可访问性树 | 给辅助技术使用的角色、名称、状态等语义 | button "下载报告" | 依赖页面的语义标注;不提供完整视觉布局 |
| 截图 | 某时刻屏幕上的像素 | 一个向下箭头及其位置 | 不直接给出稳定的元素身份或业务语义 |
可访问性树(Accessibility Tree,简称 AX Tree)由浏览器根据 DOM、HTML 语义、ARIA 属性及渲染状态计算。它会省略一些没有语义的结构节点,也可能重组信息,因此不是 DOM 的逐节点拷贝。role=button 说明这是按钮,name=下载报告 说明它对用户的可访问名称;名称可以来自文本、关联标签或 ARIA。
截图是像素结果,不是另一棵 DOM。Canvas 绘图、图片里的文字、图标和遮挡层可能只有在截图里才容易识别。反过来,截图上的一个箭头也可能没有清楚的语义;此时 DOM 属性或 AX 名称更有帮助。实际工具常把几种表示合在一起,但不应假定每个项目都读取同样的数据。
2. 元素、布局框和坐标不是一回事#
浏览器经过样式和布局计算后,才知道元素在视口中的位置及尺寸,即 bounding box(布局框)。自动化程序可以先找到按钮,再从布局结果挑一个可点击点;也可以让视觉模型从截图估计坐标,直接发送 (x, y) 鼠标事件。后者不要求先识别 DOM 节点。
两条路径可以概括为:
语义路径:"下载报告" → 定位 button → 检查能否点击 → 浏览器发送输入事件视觉路径:截图中的箭头 → 估计视口坐标 → 浏览器发送输入事件坐标必须和当时的视口、缩放、滚动位置及截图尺寸一致。页面滚动、弹窗出现或动画移动后,旧坐标可能点到别处。元素定位也不是万能的:Canvas 内部对象往往没有独立 DOM 节点,而语义路径也会受错误标注、重复名称和重渲染影响。
3. 下载、弹窗与新标签页属于“事件和状态”#
页面观察不止是树和图片。点击下载按钮之后,可能没有 DOM 成功提示,而是浏览器发出一个下载事件;点击链接可能打开新 tab;登录可能重定向并更新 cookie。Agent 工具需要把这些结果返回给上层,否则模型容易把“点击命令已执行”误当成“任务已完成”。
二、程序如何控制浏览器:CDP 与 Playwright#
1. CDP:Chromium 的底层控制协议#
CDP(Chrome DevTools Protocol)是一套给 Chromium 系浏览器使用的调试协议。外部客户端通常通过 WebSocket 发送带 ID、方法名和参数的 JSON 命令,浏览器返回结果或推送事件。能力按 domain 划分,例如:
| CDP domain | 典型能力 |
|---|---|
DOM、Accessibility | 查询节点、取得可访问性信息 |
Page | 导航、截图、页面事件 |
Input | 发送鼠标和键盘事件 |
Network | 观察请求与响应 |
Runtime | 在页面上下文执行 JavaScript |
例如 Input.dispatchMouseEvent 接受坐标;Page.captureScreenshot 返回截图数据。CDP 提供的是协议原语,应用仍需决定目标是哪一个 tab、何时等待、怎样选元素、如何处理失败。它与浏览器开发者工具使用的控制能力密切相关,但不是“专为 Agent 设计的 API”。开放远程调试地址也意味着交出了很强的浏览器控制权。
2. Playwright:面向开发者的自动化库#
Playwright 提供 page.goto()、getByRole()、locator.click()、page.screenshot()、下载事件等较高层 API,也管理浏览器进程、隔离的 BrowserContext 和 Page。它支持 Chromium、Firefox、WebKit;正常连接有自己的驱动和协议。chromium.connectOverCDP() 是接入已有 Chromium 的一种可选方式,官方注明其能力保真度低于 Playwright 自身协议连接。因此“Playwright 只是 CDP 的语法糖”不准确。
Locator 是“如何再次找到目标”的描述,不是永远绑定在旧 DOM 节点上的指针。执行 locator.click() 时,Playwright 会等待唯一匹配、可见、位置稳定、能接收事件、已启用等条件;超时则报错。自动等待保证动作前的一组可操作条件,不保证点击后业务目标完成。
// 以下是已有 Playwright page 对象时的两种动作写法。const button = page.getByRole("button", { name: "下载报告" });await button.click();
// 已知截图坐标且确实需要视觉操作时,也可以直接点击坐标。await page.mouse.click(420, 310);第一种写法适合有语义的普通网页;第二种写法适合缺少可定位元素的画面。两者最后都使浏览器收到输入,差别是如何选择目标、动作前能检查什么。上面两行展示两种选择方式,不应在同一次任务中无故连续点击。对于下载,应该在触发动作前注册等待,再取得下载对象,而不是凭按钮点击成功推断文件已经出现。
3. 还有 WebDriver、直接 JS 与其他路径#
CDP 和 Playwright 不是仅有的选项。WebDriver 是浏览器自动化的标准协议路线;有的工具还会在页面中执行 JavaScript、通过浏览器扩展或浏览器内置接口操作。element.click() 这样的页面脚本调用与真实鼠标输入也不完全等价:它可能跳过命中测试或不同的输入事件链。理解 Agent 时应先问观察从哪里来、动作最终由哪个后端执行,不要把项目名称直接当成底层协议。
三、为什么要 Agent:把未知步骤变成观察与决策循环#
1. Playwright 已经准确,为什么还需要模型?#
Playwright 能准确执行你写出的步骤,但不会自行推断“报告藏在哪个菜单”“搜索结果哪个是目标”“遇到登录页下一步怎么办”。如果页面和步骤已知,直接写脚本通常更快、成本更低,也更容易验证。若多个站点的布局不同、目标由自然语言给出、步骤无法事先穷举,模型可以利用页面信息选择下一步。
这不意味着 Agent 天然更稳。页面小改版可能仍会使它误读目标;模型还会带来延迟、费用和误操作。常见的折中是固定部分用脚本,不确定部分交给模型判断,然后由程序检查动作是否合法、结果是否可信。
2. 一轮 Agent 是怎样运行的#
任务目标 + 当前 URL、tab、页面快照、可选截图、历史 → 模型选择受约束动作(例如 click(ref=e2)) → 程序校验参数、权限和预算 → 浏览器工具执行并返回结果 → 等待可观察条件,重新读取页面 → 检查是否已达成任务,否则进入下一轮snapshot(页面快照)通常是工具为模型整理的文本,不等于完整 HTML,也不必等于浏览器原生 AX Tree。工具可能过滤非交互节点、合并 DOM 属性和 AX 语义,再为候选元素分配短 ref(引用):
@e1 textbox "关键词"@e2 button "搜索"@e3 link "2026 年度报告"模型输出 click(@e2),执行器把 ref 映射回当前页面中的目标。这样减少了模型自行编造 CSS selector 的机会。ref 的寿命由具体工具决定:有的 ref 在原节点存活时可跨快照复用,有的只属于一次快照;导航、tab 或 frame 切换后要按工具规则重新取快照,不把 ref 当永久 ID。
一个最小概念循环如下。它展示职责分界,不是可直接运行的完整框架源码:
for step in range(MAX_STEPS): state = observe() # URL、tab、紧凑快照、可选截图 action = model_choose(task, state) # 只输出允许的工具和参数 validate(action) # schema、域名、风险、预算 result = execute(action) evidence = observe_effect(result) # 新 URL、页面状态、下载等 if verified_done(task, evidence): return evidenceraise TaskFailed("未能在步数限制内确认完成")3. “页面状态漂移”具体发生在哪里#
模型看到的是一次观察,执行发生在稍后的时刻。两者之间页面可能改变,这就是这里说的观察与操作之间的状态漂移;它与编程中“检查时和使用时不是同一状态”的问题相似。常见情况有:
| 情况 | 会发生什么 | 合理处理 |
|---|---|---|
| 页面重渲染 | 旧节点消失,ref 或 selector 指向失效 | 重新观察,重新定位 |
| 弹窗或遮罩 | 目标仍在,但点击被覆盖层接收 | 识别并处理覆盖层,再定位目标 |
| 网络慢或异步加载 | 看到旧内容,或按钮还不能操作 | 等 URL、元素、下载等具体条件,设置超时 |
| iframe / 新 tab | 目标在另一个 frame 或页面 | 明确切换上下文,保留边界信息 |
| 滚动、缩放、动画 | 截图坐标与执行时画面不一致 | 重新截图和校准坐标,动作后验证 |
| 语义缺失的 Canvas | DOM/AX 没有内部按钮 | 使用截图与坐标,谨慎验证画面变化 |
Playwright 的自动等待能处理部分“元素尚不可点”的问题,却无法判断模型是否选对业务对象,也无法保证服务器接受了提交。一个动作至少分三个层次:命令已执行、页面出现预期变化、业务目标被证据确认。条件等待和动作后观察分别解决后两层的一部分;固定 sleep 不能可靠代替它们。
四、各开源项目分别站在哪一层#
这些项目可以组合,并非同一层的互斥竞品。下表的内部实现以文末固定提交为参考,选型时还要查看所安装版本。
| 项目 | 核心定位 | 谁决定下一步 | 它主要补哪一层 |
|---|---|---|---|
| Playwright | 通用浏览器自动化库与测试工具 | 开发者脚本,或上层 Agent | 可靠定位、动作、等待、浏览器会话 |
| browser-use | Python 浏览器 Agent 框架 | 内置 Agent 调用模型 | 观察、模型循环、动作工具和历史 |
| agent-browser | 面向外部 Agent 的 CLI/MCP 浏览器工具 | 默认由 Codex 等外部 Agent 决定;另有可选 chat | 紧凑快照、ref、命令式操作和会话 |
| Steel Browser | 可自托管的浏览器服务 | 外部脚本或 Agent | 远程浏览器、Session、连接地址和资源管理 |
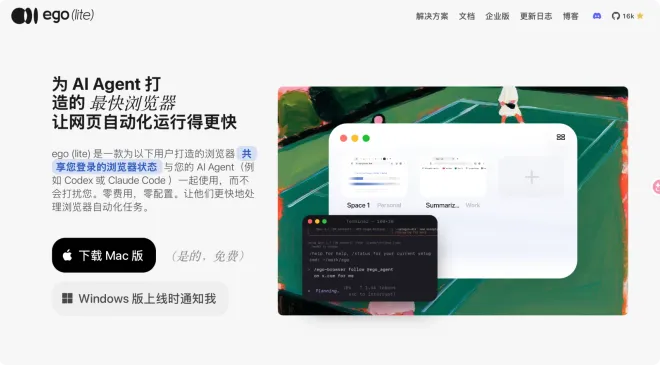
| ego-lite / ego-browser | 人与 Agent 共用浏览器身份及任务空间 | 外部 Agent,且有人机控制权交接 | Profile、TaskSpace、tab 与所有权 |
Playwright:确定性动作的基线#
调用链是“脚本或上层 Agent → Locator / Page API → 驱动 → 浏览器”。它能让浏览器动作更可靠,但不负责解释自然语言任务。已有固定流程时,先用它解决问题即可。
browser-use:把模型循环和浏览器工具装在一起#
在本文参考的 0.13.10 提交中,Agent 组织每步上下文、模型调用、工具执行与后处理;BrowserSession 管浏览器连接和页面状态;DOM 相关组件把 DOM、可访问性与布局信息整理成可用的页面表示;工具注册层把动作暴露给模型。这个版本的主要执行链已使用 cdp-use,不能概括成“Agent 最终全部调用 Playwright”。是否把截图发给模型还取决于视觉配置。
它适合在 Python 程序里直接运行一个完整 Browser Agent。若只需给现有 Agent 加一个浏览器工具,完整内置 Agent 反而可能重复已有编排。
agent-browser:给外部 Agent 一套紧凑的浏览器命令#
在参考的 0.37.1 提交中,CLI 与后台 daemon 保留浏览器会话,通过 CDP 等路径控制浏览器,输出可访问性快照与 @eN 引用。外部 Agent 读取 snapshot,选 ref,再调用 click、fill 等命令。项目也有可选 chat 入口,但主要价值是可组合的工具面。
Steel Browser:浏览器基础设施#
Steel 管理远程 Chromium Session,对外提供 REST/SDK 与浏览器连接地址,还提供截图、抓取、录制等能力。它自身不替模型决定“下一步点哪里”。典型组合是“browser-use 或自研 Agent → Playwright/CDP 客户端 → Steel Session”。自托管实例的隔离与并发能力应按实际版本和部署模式验证,不能由产品名称推断。
ego-lite / ego-browser:共享登录态与控制权边界#
ego-lite 把 Profile(cookie、站点存储与登录身份)和 TaskSpace(某任务的窗口及 tabs)做成浏览器侧概念。ego-browser 给外部 Agent 提供 snapshot、页面操作和更底层能力。它特别关注人与 Agent 共享登录态时的任务隔离、控制权交接,适合研究“Agent 用我的浏览器工作,但不要抢占我正在操作的页面”。
五、按层运行三个最小例子#
三个例子分别展示确定性脚本、Agent 工具面和完整 Agent。示例访问公开的 example.com,不涉及登录或写操作。
例 1:Playwright 读取一个已知页面#
npm init -ynpm install playwrightnpx playwright install chromiumimport { chromium } from "playwright";
const browser = await chromium.launch({ headless: true });try { const context = await browser.newContext(); const page = await context.newPage(); await page.goto("https://example.com"); console.log(await page.getByRole("heading").textContent());} finally { await browser.close();}运行 node demo.mjs,预期输出 Example Domain。这里 Browser 是浏览器进程句柄,BrowserContext 隔离 cookie 等会话状态,Page 是一个标签页;getByRole() 按可访问语义定位标题。无头模式仍会渲染页面,只是不显示浏览器窗口。
例 2:agent-browser 的“观察 → ref → 动作”#
npm install -g agent-browseragent-browser installagent-browser open https://example.comagent-browser snapshot运行 snapshot 后会看到标题和链接等节点及其 ref。若要点击链接,先从实际输出读出它的 @eN,再单独执行 agent-browser click @eN,最后重新 snapshot 检查目标页;做完运行 agent-browser close。不要把示例里的 ref 数字硬编码到真实任务。当前官方 CLI 还有 snapshot -i,它只保留交互元素,可在页面很大时缩短输出。
例 3:browser-use 运行完整 Agent#
uv init --python 3.12uv add browser-use python-dotenv在 .env 中放入 BROWSER_USE_API_KEY=...,然后运行:
import asynciofrom browser_use import Agent, ChatBrowserUsefrom dotenv import load_dotenv
load_dotenv()
async def main():    agent = Agent(        task="打开 example.com,只返回页面主标题,不访问其他站点",        llm=ChatBrowserUse(),    )    history = await agent.run(max_steps=10)    print(history.final_result())
asyncio.run(main())
运行 uv run agent.py。这里的模型服务需要 API key,可能产生费用;页面标题是可观察的结果,但模型的最终文本仍应与页面证据核对。max_steps 是这个示例明确设置的步数上限。
Steel 和 ego-browser 是可选的下一步:前者在需要远程浏览器时接到执行层,后者在需要真实登录态和人与 Agent 交接时接到浏览器环境层。先跑通上面三例,更容易看清各层各自解决的问题。
六、真正做成系统时检查什么#
可靠性。 每步记录任务 ID、URL、tab/frame、快照或截图、模型输出、实际动作、耗时、错误和动作后证据。导航或明显重渲染后重新观察;对下载、弹窗和新 tab 显式等待;为步骤数、耗时与重复失败设上限。调试时才能分清模型选错、元素失效、页面没稳定与浏览器服务故障。
完成判定。 不以模型说“完成了”或 click() 返回成功作为唯一依据。读取业务上可观察的结果,例如目标页标题、成功提示、数据字段、订单号或确实存在的下载文件。页面如果没有可自动核对的信号,就明确报告证据不足。
权限与不可信页面。 网页文本可能包含诱导 Agent 改目标的指令;它应作为数据而非上级命令。由模型外的代码约束可访问域名、工具参数、敏感操作、下载与文件访问;远程 CDP 地址应限制可达范围。截图、DOM 和 trace 也可能包含密码或个人信息,保存前要考虑脱敏与访问控制。
学习顺序与资料#
建议依次实践:①用 Playwright 写一个固定页面的读取脚本;②用 agent-browser 手动走一遍 snapshot → ref → action → snapshot;③运行 browser-use 并观察每一步输入和结果;④故意加入弹窗、慢加载或新 tab,比较自动等待与重新观察各自能解决什么;⑤需要远程部署或共用登录态时,再研究 Steel 或 ego-lite。
原有的学习材料可作项目导读:Playwright、Steel Browser、browser-use。关键事实和 API 以以下一手资料为准: