十、贪心算法#
贪心算法(greedy algorithm)是一种常见的解决优化问题的算法,其基本思想是在问题的每个决策阶段,都选择当前看起来最优的选择,即贪心地做出局部最优的决策,以期获得全局最优解
贪心算法和动态规划都常用于解决优化问题。它们之间存在一些相似之处,比如都依赖最优子结构性质,但工作原理不同
- 动态规划会根据之前阶段的所有决策来考虑当前决策,并使用过去子问题的解来构建当前子问题的解
- 贪心算法不会考虑过去的决策,而是一路向前地进行贪心选择,不断缩小问题范围,直至问题被解决
先通过例题“零钱兑换”了解贪心算法的工作原理。这道题已经在“完全背包问题”章节中介绍过
给定 n 种硬币,第 i 种硬币的面值为 coins[i-1],目标金额为 amt,每种硬币可以重复选取,问能够凑出目标金额的最少硬币数量。如果无法凑出目标金额,则返回 -1。
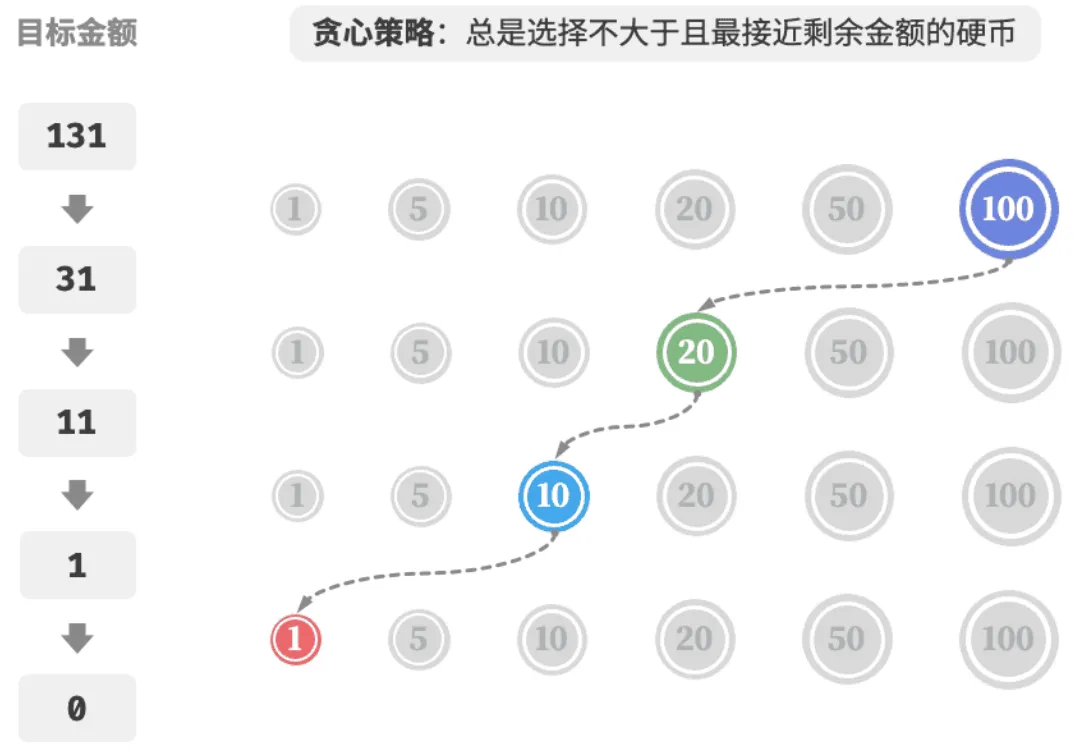
本题采取的贪心策略如下图所示。给定目标金额,我们贪心地选择不大于且最接近它的硬币,不断循环该步骤,直至凑出目标金额为止
/* 零钱兑换:贪心 */int coinChangeGreedy(int[] coins, int amt) { // 假设 coins 列表有序 int i = coins.length - 1; int count = 0; // 循环进行贪心选择,直到无剩余金额 while (amt > 0) { // 找到小于且最接近剩余金额的硬币 while (i > 0 && coins[i] > amt) i--; // 选择 coins[i] amt -= coins[i]; count++; } // 若未找到可行方案,则返回 -1 return amt == 0 ? count : -1;}贪心算法不仅操作直接、实现简单,而且通常效率也很高。在以上代码中,记硬币最小面值为 min,则贪心选择最多循环 amt/min 次,时间复杂度为 O(amt/min)。这比动态规划解法的时间复杂度 O(n*amt) 小了一个数量级
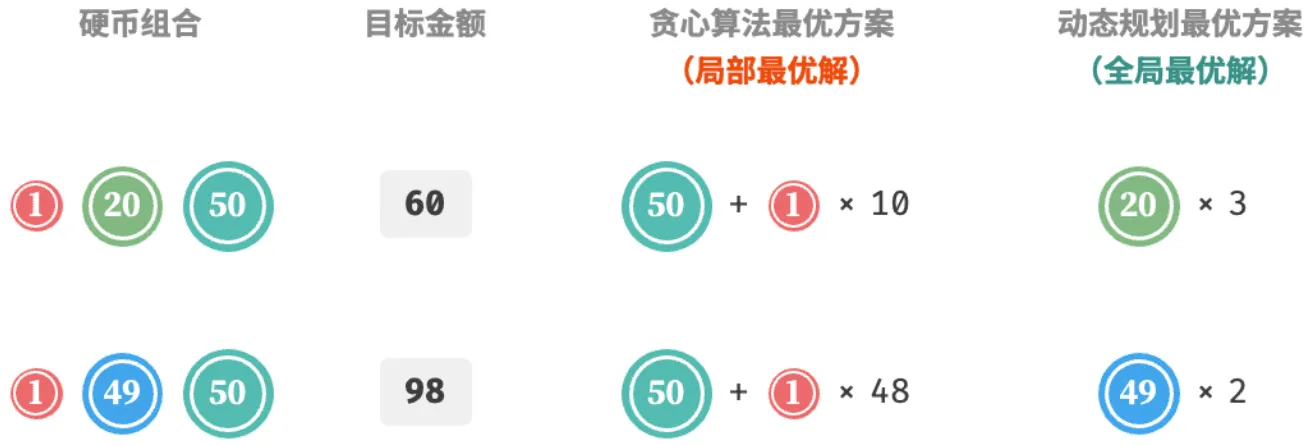
然而,对于某些硬币面值组合,贪心算法并不能找到最优解
相较于动态规划,贪心算法的使用条件更加苛刻,其主要关注问题的两个性质
- 贪心选择性质:只有当局部最优选择始终可以导致全局最优解时,贪心算法才能保证得到最优解
- 最优子结构:原问题的最优解包含子问题的最优解
一般可以举反例,要进行严谨的数学证明,通常需要用到反证法或数学归纳法
贪心算法一般分为如下四步:
- 将问题分解为若干个子问题
- 找出适合的贪心策略
- 求解每一个子问题的最优解
- 将局部最优解堆叠成全局最优解
简单题#
简 455分发饼干#
假设你是一位很棒的家长,想要给你的孩子们一些小饼干。但是,每个孩子最多只能给一块饼干。
对每个孩子
i,都有一个胃口值g[i],这是能让孩子们满足胃口的饼干的最小尺寸;并且每块饼干j,都有一个尺寸s[j]。如果s[j] >= g[i],我们可以将这个饼干j分配给孩子i,这个孩子会得到满足。你的目标是满足尽可能多的孩子,并输出这个最大数值。
为了满足更多的小孩,就不要造成饼干尺寸的浪费
大尺寸的饼干既可以满足胃口大的孩子也可以满足胃口小的孩子,那么就应该优先满足胃口大的
这里的局部最优就是大饼干喂给胃口大的,充分利用饼干尺寸喂饱一个,全局最优就是喂饱尽可能多的小孩
可以尝试使用贪心策略,先将饼干数组和小孩数组排序,然后从后向前遍历小孩数组,用大饼干优先满足胃口大的,并统计满足小孩数量
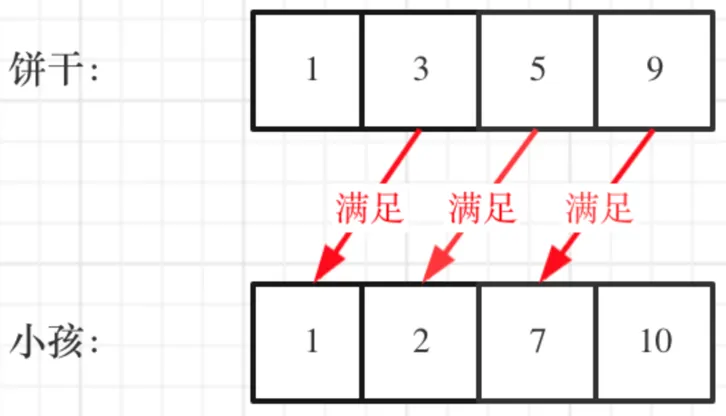
public int findContentChildren(int[] g, int[] s) { Arrays.sort(g); Arrays.sort(s); int count = 0; int start = s.length - 1; // 遍历胃口,先喂饱大胃口 for (int index = g.length - 1; index >= 0; index--) { if(start >= 0 && g[index] <= s[start]) { start--; count++; } } return count;}简 860柠檬水找零#
在柠檬水摊上,每一杯柠檬水的售价为
5美元。顾客排队购买你的产品,(按账单bills支付的顺序)一次购买一杯。每位顾客只买一杯柠檬水,然后向你付
5美元、10美元或20美元。你必须给每个顾客正确找零,也就是说净交易是每位顾客向你支付5美元。注意,一开始你手头没有任何零钱。
给你一个整数数组
bills,其中bills[i]是第i位顾客付的账。如果你能给每位顾客正确找零,返回true,否则返回false。
有如下三种情况:
- 情况一:账是5,直接收下
- 情况二:账是10,消耗一个5,增加一个10
- 情况三:账是20,优先消耗一个10和一个5,如果不够,再消耗三个5
账单是20的情况,为什么要优先消耗一个10和一个5呢?
因为美元10只能给账单20找零,而美元5可以给账单10和账单20找零,美元5更万能!
所以局部最优:遇到账单20,优先消耗美元10,完成本次找零。全局最优:完成全部账单的找零
public boolean lemonadeChange(int[] bills) { int five = 0; int ten = 0; for (int i = 0; i < bills.length; i++) { if (bills[i] == 5) five++; else if (bills[i] == 10) { five--; ten++; } else if (bills[i] == 20) { if (ten > 0) { ten--; five--; } else { five -= 3; } } if (five < 0 || ten < 0) return false; } return true;}中等题:两个维度权衡问题#
在出现两个维度相互影响的情况时,两边一起考虑一定会顾此失彼,要先确定一个维度,再确定另一个一个维度。
难 135分发糖果#
n个孩子站成一排。给你一个整数数组ratings表示每个孩子的评分。你需要按照以下要求,给这些孩子分发糖果:
- 每个孩子至少分配到
1个糖果。- 相邻两个孩子中,评分更高的那个会获得更多的糖果。
请你给每个孩子分发糖果,计算并返回需要准备的 最少糖果数目 。
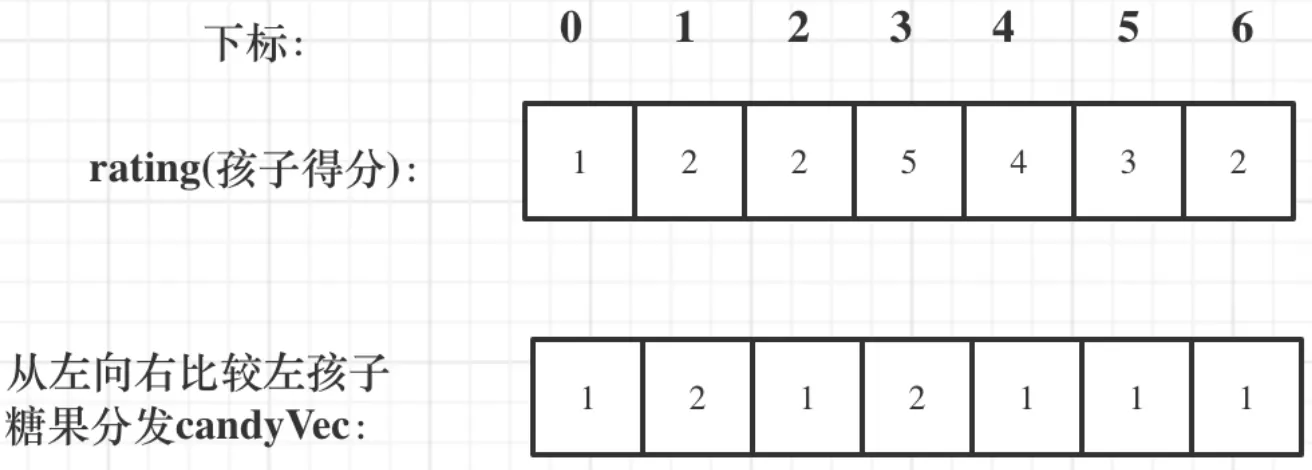
1、先确定右边评分大于左边的情况(也就是从前向后遍历)
此时局部最优:只要右边评分比左边大,右边的孩子就多一个糖果;全局最优:相邻的孩子中,评分高的右孩子获得比左边孩子更多的糖果
// 从前向后for (int i = 1; i < ratings.size(); i++) { if (ratings[i] > ratings[i - 1]) candy[i] = candy[i - 1] + 1;}
2、再确定左孩子大于右孩子的情况(从后向前遍历)
如果 ratings[i] > ratings[i + 1],此时 candy[i](第 i 个小孩的糖果数量)就有两个选择,一个是 candy[i + 1] + 1(从右边这个加1得到的糖果数量),一个是 candy[i](之前比较右孩子大于左孩子得到的糖果数量)
那么贪心取局部最优:candy[i + 1] + 1 和 candy[i] 的最大值,保证第 i 个小孩的糖果数量既大于左边的也大于右边的;全局最优:相邻的孩子中,评分高的孩子获得更多的糖果
// 从后向前for (int i = ratings.size() - 2; i >= 0; i--) { if (ratings[i] > ratings[i + 1] ) { candy[i] = max(candy[i], candy[i + 1] + 1); }}public int candy(int[] ratings) { int len = ratings.length; int[] candy = new int[len]; candy[0] = 1; for (int i = 1; i < len; i++) { candy[i] = (ratings[i] > ratings[i - 1]) ? candy[i - 1] + 1 : 1; } for (int i = len - 2; i >= 0; i--) { if (ratings[i] > ratings[i + 1]) { candy[i] = Math.max(candy[i], candy[i + 1] + 1); } } int res = 0; for (int num : candy) res += num; return res;}中 406根据身高重建队列#
假设有打乱顺序的一群人站成一个队列,数组
people表示队列中一些人的属性(不一定按顺序)。每个people[i] = [hi, ki]表示第i个人的身高为hi,前面 正好 有ki个身高大于或等于hi的人。请你重新构造并返回输入数组
people所表示的队列。返回的队列应该格式化为数组queue,其中queue[j] = [hj, kj]是队列中第j个人的属性(queue[0]是排在队列前面的人)。
遇到两个维度权衡的时候,一定要先确定一个维度,再确定另一个维度
1、先按照身高h来排序,从大到小排(身高相同的话则k小的站前面)
2、再优先按身高高的 people 的 k 来插入,后序插入节点也不会影响前面已经插入的节点,最终按照 k 的规则完成了队列
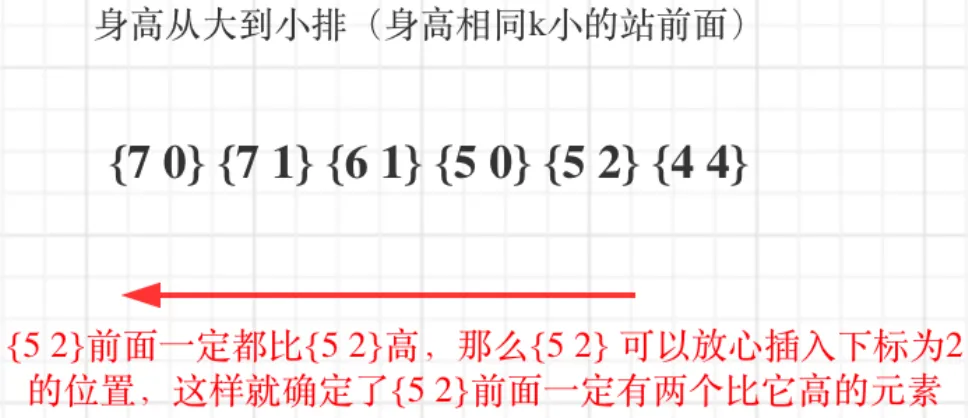
排序完的people: [[7,0], [7,1], [6,1], [5,0], [5,2], [4,4]]
插入的过程:
- 插入[7,0]:[[7,0]]
- 插入[7,1]:[[7,0],[7,1]]
- 插入[6,1]:[[7,0],[6,1],[7,1]]
- 插入[5,0]:[[5,0],[7,0],[6,1],[7,1]]
- 插入[5,2]:[[5,0],[7,0],[5,2],[6,1],[7,1]]
- 插入[4,4]:[[5,0],[7,0],[5,2],[6,1],[4,4],[7,1]]
局部最优:优先按身高高的people的k来插入。插入操作过后的people满足队列属性
全局最优:最后都做完插入操作,整个队列满足题目队列属性
public int[][] reconstructQueue(int[][] people) { // 身高从大到小排(身高相同k小的站前面) Arrays.sort(people, (a, b) -> { if (a[0] == b[0]) return a[1] - b[1]; // a - b 是升序排列,故在a[0] == b[0]的狀況下,會根據k值升序排列 return b[0] - a[0]; // b - a 是降序排列,在a[0] != b[0],的狀況會根據h值降序排列 }); LinkedList<int[]> que = new LinkedList<>(); for (int[] p : people) { que.add(p[1],p); // Linkedlist.add(index, value),會將value插入到指定index裡 } return que.toArray(new int[0][]);}(a, b) -> a - b
a - b的数学特性决定了:当 a 小的时候小于零,小于则 a 留前面,当 a 大的时候大于零,大于则 a 去后面。这就形成了升序的排列(a, b) -> b - a
b - a的数学特性决定了:当 a 小的时候大于零,大于则 a 去后面,当 a 大的时候小于零,小于则 a 留前面。这就形成了降序的排列
难题:贪心解决区间问题#
【🔥中】55跳跃游戏#
给你一个非负整数数组
nums,你最初位于数组的 第一个下标 。数组中的每个元素代表你在该位置可以跳跃的最大长度。判断你是否能够到达最后一个下标,如果可以,返回
true;否则,返回false。
当前位置元素如果是 3,究竟跳几步才是最优呢?其实跳几步无所谓,关键在于可跳的覆盖范围!
那么这个问题就转化为跳跃覆盖范围究竟可不可以覆盖到终点!
贪心算法局部最优解:每次取最大跳跃步数(取最大覆盖范围);整体最优解:最后得到整体最大覆盖范围,看是否能到终点
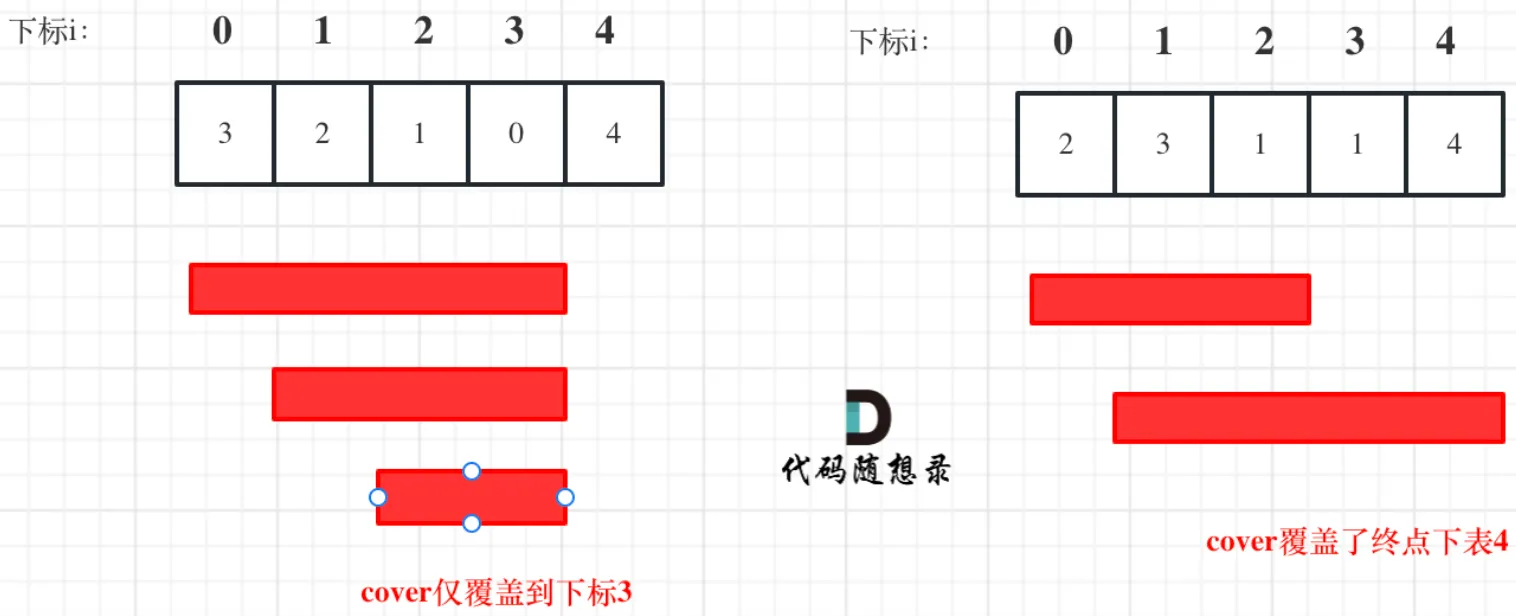
i 每次移动只能在 cover 的范围内移动,每移动一个元素,cover 得到该元素数值(新的覆盖范围)的补充,让 i 继续移动下去
public boolean canJump(int[] nums) { if (nums.length == 1) return true; // 覆盖范围, 初始覆盖范围应该是0,因为下面的迭代是从下标0开始的 int cover = 0; // 在覆盖范围内更新最大的覆盖范围 for (int i = 0; i <= cover; i++) { cover = Math.max(cover, i + nums[i]); if (cover >= nums.length - 1) return true; } return false;}【🔥中】45跳跃游戏 II#
给定一个长度为
n的 0 索引整数数组nums。初始位置在下标 0。每个元素
nums[i]表示从索引i向后跳转的最大长度。换句话说,如果你在索引i处,你可以跳转到任意(i + j)处:
0 <= j <= nums[i]且i + j < n返回到达
n - 1的最小跳跃次数。测试用例保证可以到达n - 1。
本题要计算最少步数,那么就要想清楚什么时候步数才一定要加一呢?
贪心的思路,局部最优:如果移动下标达到了当前这一步的最大覆盖最远距离了,还没有到终点的话,那么就必须再走一步来增加覆盖范围,直到覆盖范围覆盖了终点;整体最优:一步尽可能多走,从而达到最少步数
这里需要统计两个覆盖范围,当前这一步的最大覆盖和下一步最大覆盖
可以把这个过程想象成“加油站”:
- 你当前有一箱油(
curDistance),能跑一定的距离。 - 在这箱油跑完之前,你会沿途观察所有的加油站(
i从 0 到curDistance),看哪个加油站加满油后能跑得最远(nextDistance)。 - 当你当前的油刚好用完(
i == curDistance),你必须进站加油(count++),并且你肯定会选择那个能跑得最远的加油站(curDistance = nextDistance)。 - 一旦发现加满油能直接冲到终点,任务就完成了。
int jump(int[] nums) { if (nums.length == 1) return 0; int curDistance = 0; // 当前覆盖最远距离下标 int count = 0; // 记录走的最大步数 int nextDistance = 0; // 下一步覆盖最远距离下标 for (int i = 0; i < nums.length; i++) { nextDistance = Math.max(nums[i] + i, nextDistance); // 更新下一步覆盖最远距离下标 if (i == curDistance) { // 遇到当前覆盖最远距离下标 count++; // 需要走下一步 curDistance = nextDistance; // 更新当前覆盖最远距离下标 if (nextDistance >= nums.length - 1) break; // 当前覆盖最远距到达集合终点,不用做count++操作了,直接结束 } } return count;}【🔥中】763划分字母区间#
给你一个字符串
s。我们要把这个字符串划分为尽可能多的片段,同一字母最多出现在一个片段中。例如,字符串"ababcc"能够被分为["abab", "cc"],但类似["aba", "bcc"]或["ab", "ab", "cc"]的划分是非法的。注意,划分结果需要满足:将所有划分结果按顺序连接,得到的字符串仍然是
s。返回一个表示每个字符串片段的长度的列表。
核心目标是:将字符串划分为尽可能多的片段,使得同一个字母只出现在一个片段中
- 记录边界:首先,我们需要知道每个字符的“势力范围”,即每个字符最后一次出现在哪里。如果我们在片段中遇到了字符
'a',而'a'最后一次出现在下标 10,那么无论我们怎么切分,当前的片段必须至少延伸到下标 10 - 动态扩展:我们从左到右遍历字符串
- 维护一个变量
idx表示当前片段必须达到的最远边界 - 当我们遍历到下标
i的字符时,查看该字符的最后出现位置edge[char] - 如果
edge[char] > idx,说明当前片段必须延长,更新idx = edge[char]
- 维护一个变量
- 确定分割点:
- 当我们遍历到的位置
i等于当前最远边界idx时,说明当前片段内的所有字符,它们的最后一次出现都在i或i之前 - 此时,我们可以安全地在这里切一刀,形成一个片段
- 当我们遍历到的位置
假设输入字符串 S = "ababcbacadefegdehijhklij"
- 预处理记录最后出现位置:
a: 8,b: 5,c: 7,d: 14,e: 15,f: 11,g: 13,h: 19,i: 22,j: 23,k: 20,l: 21
- 遍历过程:
- i=0 (‘a’):
a最后出现在 8。当前片段边界idx更新为 8 - i=1 (‘b’):
b最后出现在 5。idx保持 8 (8 > 5) - …
- i=8 (‘a’): 此时
i追上了idx(8 == 8)。说明从 0 到 8 之间的所有字符(a, b, c)都不会在 8 之后出现 - 切分: 第一个片段长度为
8 - (-1) = 9 - 接着处理剩下的字符串,以此类推
- i=0 (‘a’):
public List<Integer> partitionLabels(String S) { List<Integer> list = new LinkedList<>(); // 用于存储每个片段的长度 // 1. 预处理:记录每个字符在字符串中出现的【最后一次】下标位置 int[] edge = new int[26]; // 对应26个小写字母 char[] chars = S.toCharArray(); // 遍历字符串,更新每个字符的最后出现位置 for (int i = 0; i < chars.length; i++) { edge[chars[i] - 'a'] = i; } // 2. 贪心策略:遍历字符串,确定分割点 int idx = 0; // 当前片段中所有字符能到达的【最远边界】 int last = 0; // 当前片段的开始位置,用于计算长度 for (int i = 0; i < chars.length; i++) { // 获取当前字符的最远边界,并更新当前片段的整体最远边界 idx = Math.max(idx, edge[chars[i] - 'a']); // 如果当前位置 i 达到了当前片段的最远边界 idx // 说明从 "last + 1" 到 "i" 这一段包含的所有字符,都不会在 i 之后出现 // 这就是一个合法的分割点 if (i == idx) { // 计算长度:当前位置 - 开始位置 + 1 list.add(i - last + 1); // 更新上一次结束位置 last = i + 1; } } return list;}中 56合并区间#
以数组
intervals表示若干个区间的集合,其中单个区间为intervals[i] = [starti, endi]。请你合并所有重叠的区间,并返回 一个不重叠的区间数组,该数组需恰好覆盖输入中的所有区间 。
本题是判断区间重叠后要进行区间合并
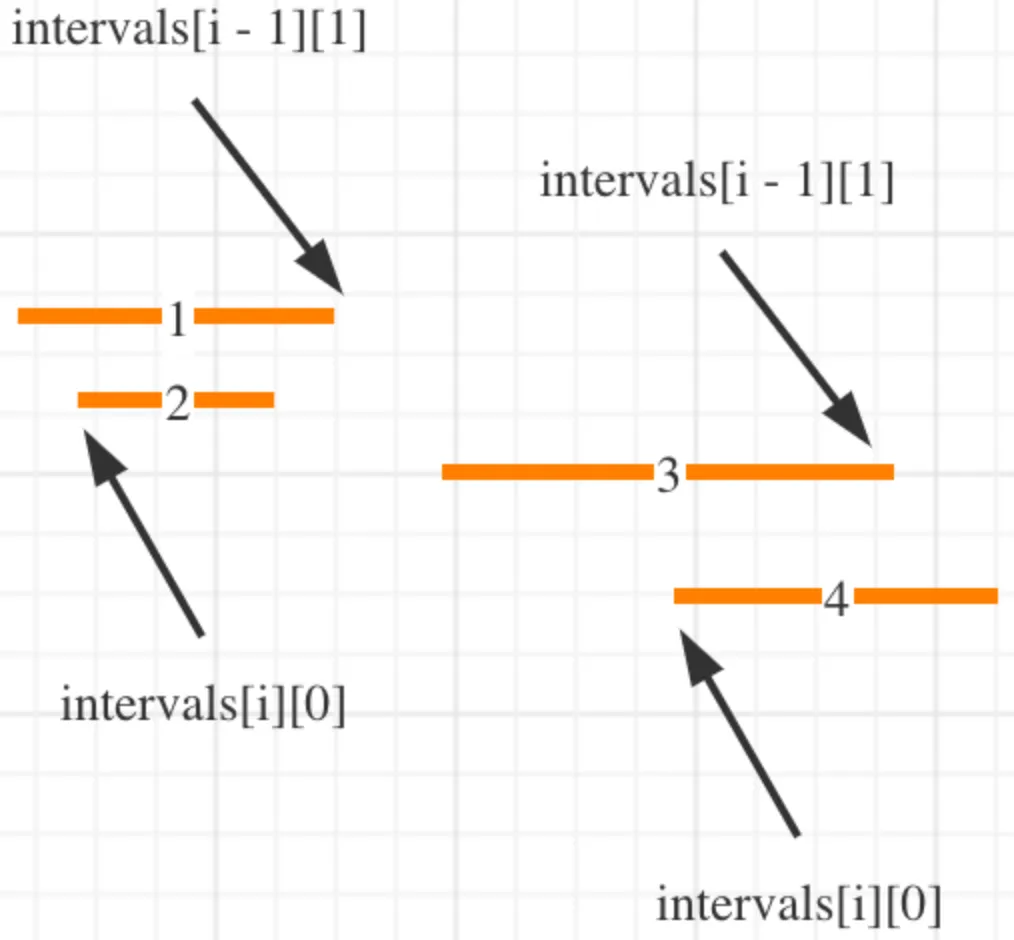
先按左边界排序,让所有的相邻区间尽可能的重叠在一起,如果 intervals[i - 1][1] >= intervals[i][0],则一定有重叠
注意图中区间已经按照左边界排序:
判断重复之后,如何去模拟合并区间呢?
新的左边界仍为左区间的左边界不变,新的右边界取两个区间右边界的最大值,加入到 result 数组;如果没有合并就把原区间加入到 result 数组
public int[][] merge(int[][] intervals) { List<int[]> result = new ArrayList<>(); // 如果区间集合为空,直接返回空数组 if (intervals == null || intervals.length == 0) return result.toArray(new int[0][]); // 1. 排序:按照区间的起始位置(左边界)进行升序排序 Arrays.sort(intervals, (a,b)->a[0]-b[0]); // 2. 将第一个区间加入结果集 result.add(intervals[0]); // 3. 遍历剩余区间 for (int i = 1; i < intervals.length; i++) { // 获取结果集中最后一个区间(当前正在合并的区间) int[] lastInterval = result.get(result.size() - 1); // 情况一:如果 "最后一个区间的右边界" >= "当前遍历区间的左边界",则说明重叠 if (lastInterval[1] >= intervals[i][0]) lastInterval[1] = Math.max(lastInterval[1], intervals[i][1]); // 合并区间:更新右边界,取两者的最大值,因为左边界已经是最小的(已排序) // 情况二:区间不重叠,直接将当前区间加入结果集 else result.add(intervals[i]); } // 将 List<int[]> 转换为二维数组返回 return result.toArray(new int[0][]);}中 452用最少数量的箭引爆气球#
有一些球形气球贴在一堵用 XY 平面表示的墙面上。墙面上的气球记录在整数数组
points,其中points[i] = [xstart, xend]表示水平直径在xstart和xend之间的气球。你不知道气球的确切 y 坐标。一支弓箭可以沿着 x 轴从不同点 完全垂直 地射出。在坐标
x处射出一支箭,若有一个气球的直径的开始和结束坐标为xstart,xend, 且满足xstart ≤ x ≤ xend,则该气球会被 引爆 。可以射出的弓箭的数量 没有限制 。 弓箭一旦被射出之后,可以无限地前进。给你一个数组
points,返回引爆所有气球所必须射出的 最小 弓箭数 。
本题和56题一样,需要判断区间是否重叠
public int findMinArrowShots(int[][] points) { // 1. 排序:根据气球直径的【起始坐标】从小到大排序 Arrays.sort(points, (a, b) -> Integer.compare(a[0], b[0])); // 2. 初始化箭的数量,只要数组不为空,至少需要一支箭 int count = 1; // 3. 遍历气球数组,从第二个气球开始 for (int i = 1; i < points.length; i++) { // 情况一:当前气球的左边界 > 前一个气球的右边界,说明两个气球完全没有重叠(甚至不挨着),一支箭无法同时射爆它们,需要增加一支箭 // 注意:这里必须是 >,如果是 = 说明刚好挨着,一支箭在交界处也能射爆 if (points[i][0] > points[i - 1][1]) count++; // 情况二:当前气球的左边界 <= 前一个气球的右边界,说明两个气球有重叠部分,可以用同一支箭射爆 else points[i][1] = Math.min(points[i][1], points[i - 1][1]); // 贪心策略:更新重叠区域的最小右边界 } return count;}中 134加油站#
在一条环路上有
n个加油站,其中第i个加油站有汽油gas[i]升。你有一辆油箱容量无限的的汽车,从第
i个加油站开往第i+1个加油站需要消耗汽油cost[i]升。你从其中的一个加油站出发,开始时油箱为空。给定两个整数数组
gas和cost,如果你可以按顺序绕环路行驶一周,则返回出发时加油站的编号,否则返回-1。如果存在解,则 保证 它是 唯一 的。
public int canCompleteCircuit(int[] gas, int[] cost) {    int n = gas.length;    int i = 0; // i 代表我们尝试作为起点的那个加油站的下标
    // 外层循环:尝试每一个可能的起点    // 注意:这里的 i 不是简单的 i++,而是跳跃式的    while (i < n) {        int sumOfGas = 0; // 记录当前尝试的路径中,累计获得的汽油量        int sumOfCost = 0; // 记录当前尝试的路径中,累计消耗的汽油量        int cnt = 0;     // 记录当前从起点 i 出发,成功走过的加油站数量
        // 内层循环:模拟从起点 i 出发,尝试走完一圈 (n 个站)        while (cnt < n) {            // 计算当前到达的加油站的实际下标            // 使用取模运算 % n 来处理环形数组(即走完最后一个回到第一个)            int j = (i + cnt) % n;
            sumOfGas += gas[j];   // 加上当前站的油            sumOfCost += cost[j]; // 减去去下一站的路费
            // 核心判断:如果累计消耗 > 累计油量,说明油不够了,车跑不动了            if (sumOfCost > sumOfGas) {                break; // 当前起点 i 失败,跳出内层循环            }            cnt++; // 如果油够,继续尝试下一个站        }
// 如果 cnt == n,说明内层循环完整跑完了一圈都没有 break if (cnt == n) { return i; // 找到了合法的起点,直接返回 } else { // 如果没跑完一圈就失败了,我们需要更换起点 // 关键优化:i = i + cnt + 1 // 解释:从 i 到 i+cnt 这些站点都不可能作为起点(见下方原理解析) // 所以下一个尝试的起点直接跳到失败点的下一个位置 i = i + cnt + 1; } } // 如果所有可能的起点都试过了(或者跳过了),都没成功,返回 -1 return -1;}关键优化(跳跃策略):
- 当从起点
i出发,在到达i + cnt时失败(油不够了) - 结论:起点
i到i + cnt之间的任何一个站点,都不可能是合法的起点 - 为什么?
- 如果从
i能走到i+1,说明gas[i] >= cost[i](或者累积油量非负) - 如果从
i出发能走到k,但在k处断油了,说明i到k的总油量是负的 - 假设我们尝试从中间的
i+1出发,因为i到i+1是正收益(或0),抛弃i的油量只会让后面的累积油量更少,更不可能通过k点 - 所以,如果
i到k走不通,那么i到k之间的任何点作为起点,也一定走不到k后面
- 如果从
- 操作:直接将下一个尝试的起点设为
i + cnt + 1(即失败点的下一个站)
十一、十大排序#
选择排序#
工作原理非常简单:开启一个循环,每轮从未排序区间选择最小的元素,将其放到已排序区间的末尾
设数组的长度为 n,选择排序的算法流程:
- 初始状态下,所有元素未排序,即未排序(索引)区间为 [0,n-1]
- 选取区间 [0,n-1] 中的最小元素,将其与索引 0 处的元素交换。完成后,数组前 1 个元素已排序
- 选取区间 [1,n-1] 中的最小元素,将其与索引 1 处的元素交换。完成后,数组前 2 个元素已排序
- 以此类推。经过 n-1 轮选择与交换后,数组前 n-1 个元素已排序
- 仅剩的一个元素必定是最大元素,无须排序,因此数组排序完成
/* 选择排序 */void selectionSort(int[] nums) { int n = nums.length; // 外循环:未排序区间为 [i, n-1] for (int i = 0; i < n - 1; i++) { // 内循环:找到未排序区间内的最小元素 int k = i; // 用k来记录未排序区间内的最小元素 for (int j = i + 1; j < n; j++) { if (nums[j] < nums[k]) k = j; } // 将该最小元素与未排序区间的首个元素交换 int temp = nums[i]; nums[i] = nums[k]; nums[k] = temp; }}-
时间复杂度为 O(n^2^)、非自适应排序:外循环共 n-1 轮,第一轮的未排序区间长度为 n,最后一轮的未排序区间长度为 2,即各轮外循环分别包含 n、n-1、…、3、2 轮内循环,求和为 (n-1)(n+2)/2
-
空间复杂度为 O(1)、原地排序:指针 i 和 j 使用常数大小的额外空间
-
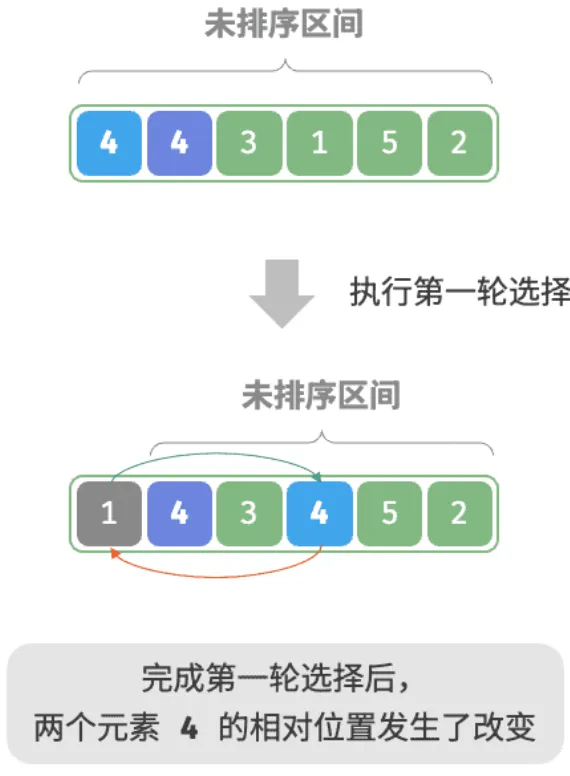
非稳定排序:如下图所示,元素
nums[i]有可能被交换至与其相等的元素的右边,导致两者的相对顺序发生改变
冒泡排序#
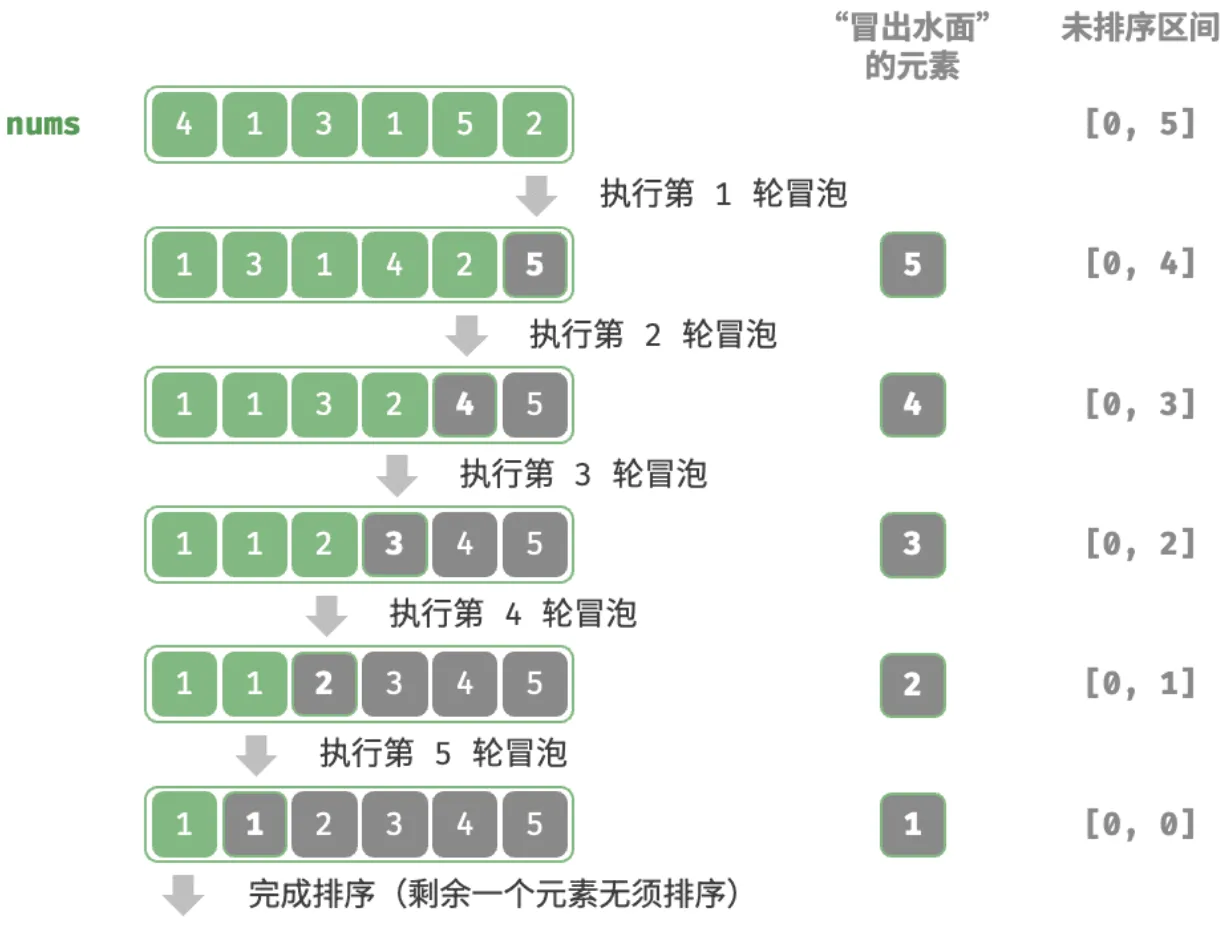
从数组最左端开始向右遍历,依次比较相邻元素大小,如果“左元素 > 右元素”就交换二者。遍历完成后,最大的元素会被移动到数组的最右端。每轮遍历都将剩余数组中的最大元素移动到最右端
- 首先,对 n 个元素执行“冒泡”,将数组的最大元素交换至正确位置
- 接下来,对剩余 n-1 个元素执行“冒泡”,将第二大元素交换至正确位置
- 以此类推,经过 n-1 轮“冒泡”后,前 大的元素都被交换至正确位置
- 仅剩的一个元素必定是最小元素,无须排序,因此数组排序完成
/* 冒泡排序 */void bubbleSort(int[] nums) { // 外循环:未排序区间为 [0, i] for (int i = nums.length - 1; i > 0; i--) { boolean flag = false; // 内循环:将未排序区间 [0, i] 中的最大元素交换至该区间的最右端 for (int j = 0; j < i; j++) { if (nums[j] > nums[j + 1]) { // 交换 nums[j] 与 nums[j + 1] int tmp = nums[j]; nums[j] = nums[j + 1]; nums[j + 1] = tmp; boolean = true; } } if(!flag) break; }}改进:boolean flag = false; boolean = true; if (!flag) break;
添加是否交换的标志,倘若某次循环未发生任何交换,说明排序已经完成,可以直接跳出循环
- 时间复杂度为 O(n^2^)、自适应排序:各轮“冒泡”遍历的数组长度依次为 n-1、n-2、…、2、1,总和为 (n-1)n/2。在引入
flag优化后,最佳时间复杂度可达到 O(n) - 空间复杂度为 O(1)、原地排序:指针 i 和 j 使用常数大小的额外空间
- 稳定排序:由于在“冒泡”中遇到相等元素不交换
冒泡排序的核心在于
if语句中的比较符号。你是希望把“大”的往后送,还是把“小”的往后送,完全由这个符号决定如果你希望数组从小到大排列,你需要把大的元素像气泡一样浮到后面
- 比较逻辑:如果 前一个 > 后一个,则交换
- 结果:大的元素会被不断交换到右边,每一轮结束后,当前未排序部分中最大的那个元素会固定在末尾
如果你希望数组从大到小排列,你需要把小的元素挤到后面去
- 比较逻辑:如果 前一个 < 后一个,则交换
- 结果:小的元素会被不断交换到右边,每一轮结束后,当前未排序部分中最小的那个元素会固定在末尾
插入排序#
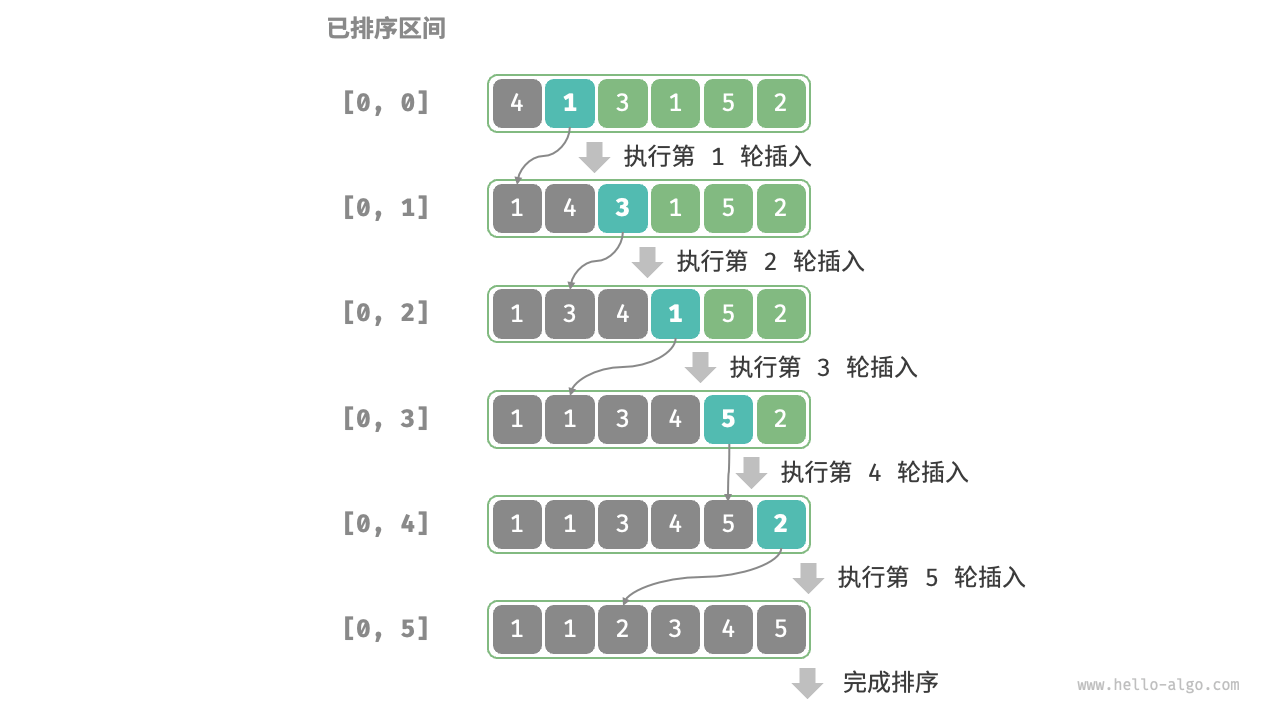
在未排序区间选择一个基准元素,将该元素与其左侧已排序区间的元素逐一比较大小,并将该元素插入到正确的位置
- 初始状态下,数组的第 1 个元素已完成排序
- 选取数组的第 2 个元素作为
base,将其插入到正确位置后,数组的前 2 个元素已排序 - 选取第 3 个元素作为
base,将其插入到正确位置后,数组的前 3 个元素已排序 - 以此类推,在最后一轮中,选取最后一个元素作为
base,将其插入到正确位置后,所有元素均已排序
/* 插入排序 */void insertionSort(int[] nums) {    // 外循环:未排序区间为 [i, n-1]    // i 指向当前待插入的元素(摸到的这张“牌”)    for (int i = 1; i < nums.length; i++) {        // 暂存当前待插入的元素,防止在后续移动过程中被覆盖        int base = nums[i];        // j 指向“已排序”区间的最后一个元素        int j = i - 1;
        // 内循环:在已排序区间 [0, i-1] 中寻找插入位置        // 只要 j 还在数组范围内,且已排序区的元素比 base 大,说明 base 应该插在这个元素的前面,所以把这个大元素向后挪一位        while (j >= 0 && nums[j] > base) {            nums[j + 1] = nums[j]; // 元素后移(腾位置)            j--;                   // 指针前移(继续向前寻找更小的元素)        }
// 循环结束时,j 指向的是第一个“小于或等于” base 的元素,所以 j + 1 就是 base 应该插入的正确空位 nums[j + 1] = base; }}- 时间复杂度为 O(n^2^)、自适应排序:在最差情况下,每次插入操作分别需要循环 n-1、n-2、…、2、1 次,求和得到 (n-1)n/2,因此时间复杂度为 O(n^2^)。在遇到有序数据时,插入操作会提前终止。当输入数组完全有序时,插入排序达到最佳时间复杂度 O(n)
- 空间复杂度为 O(1)、原地排序:指针 i 和 j 使用常数大小的额外空间
- 稳定排序:在插入操作过程中,我们会将元素插入到相等元素的右侧,不会改变它们的顺序
优势:
插入排序的时间复杂度为 O(n^2^),而快速排序的时间复杂度为 O(nlogn)。尽管插入排序的时间复杂度更高,但在数据量较小的情况下,插入排序通常更快
这个结论与线性查找和二分查找的适用情况的结论类似。快速排序这类 O(nlogn) 的算法属于基于分治策略的排序算法,往往包含更多单元计算操作。而在数据量较小时,n^2^ 和 nlogn 的数值比较接近,复杂度不占主导地位,每轮中的单元操作数量起到决定性作用
实际上,许多编程语言(例如 Java)的内置排序函数采用了插入排序,大致思路为:对于长数组,采用基于分治策略的排序算法,例如快速排序;对于短数组,直接使用插入排序
虽然冒泡排序、选择排序和插入排序的时间复杂度都为 O(n^2^),但在实际情况中,插入排序的使用频率显著高于冒泡排序和选择排序,主要有以下原因:
- 冒泡排序基于元素交换实现,需要借助一个临时变量,共涉及 3 个单元操作;插入排序基于元素赋值实现,仅需 1 个单元操作。因此,冒泡排序的计算开销通常比插入排序更高
- 选择排序在任何情况下的时间复杂度都为 O(n^2^)。如果给定一组部分有序的数据,插入排序通常比选择排序效率更高
- 选择排序不稳定,无法应用于多级排序
快速排序#
快速排序(quick sort)是一种基于分治策略的排序算法,运行高效,应用广泛
快速排序的核心操作是“哨兵划分”,其目标是:选择数组中的某个元素作为“基准数”,将所有小于基准数的元素移到其左侧,而大于基准数的元素移到其右侧
- 选取数组最左端元素作为基准数,初始化两个指针
i和j分别指向数组的两端。 - 设置一个循环,在每轮中使用
i(j)分别寻找第一个比基准数大(小)的元素,然后交换这两个元素。 - 循环执行步骤
2.,直到i和j相遇时停止,最后将基准数交换至两个子数组的分界线
/* 元素交换 */void swap(int[] nums, int i, int j) {    int tmp = nums[i];    nums[i] = nums[j];    nums[j] = tmp;}
/* 哨兵划分 */int partition(int[] nums, int left, int right) {    // 以 nums[left] 为基准数    int i = left, j = right;    while (i < j) {        while (i < j && nums[j] >= nums[left])            j--;          // 从右向左找首个小于基准数的元素        while (i < j && nums[i] <= nums[left])            i++;          // 从左向右找首个大于基准数的元素        swap(nums, i, j); // 交换这两个元素    }    swap(nums, i, left);  // 将基准数交换至两子数组的分界线    return i;             // 返回基准数的索引}
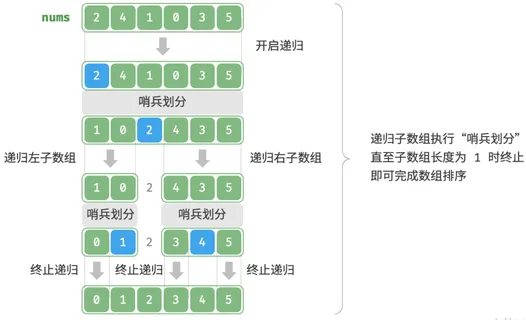
哨兵划分完成后,原数组被划分成三部分:左子数组、基准数、右子数组,且满足“左子数组任意元素 <= 基准数 <= 右子数组任意元素”。因此,接下来只需对这两个子数组进行递归哨兵划分从而实现排序
快速排序的整体流程:
- 首先,对原数组执行一次“哨兵划分”,得到未排序的左子数组和右子数组
- 然后,对左子数组和右子数组分别递归执行“哨兵划分”
- 持续递归,直至子数组长度为 1 时终止,从而完成整个数组的排序
/* 快速排序 */void quickSort(int[] nums, int left, int right) { // 子数组长度为 1 时终止递归 if (left >= right) return; // 哨兵划分 int pivot = partition(nums, left, right); // 递归左子数组、右子数组 quickSort(nums, left, pivot - 1); quickSort(nums, pivot + 1, right);}- 时间复杂度为 O(nlogn)、非自适应排序:在平均情况下,哨兵划分的递归层数为 logn,每层中的总循环数为 n,总体使用 O(nlogn) 时间。在最差情况下,每轮哨兵划分操作都将长度为 n 的数组划分为长度为 0 和 n-1 的两个子数组,此时递归层数达到 n,每层中的循环数为 n,总体使用 O(n^2^) 时间
- 空间复杂度为 O(n)、原地排序:在输入数组完全倒序的情况下,达到最差递归深度 n,使用 O(n) 栈帧空间。排序操作是在原数组上进行的,未借助额外数组
- 非稳定排序:在哨兵划分的最后一步,基准数可能会被交换至相等元素的右侧
基准数优化#
快速排序在某些输入下的时间效率可能降低。举一个极端例子,假设输入数组是完全倒序的,由于我们选择最左端元素作为基准数,那么在哨兵划分完成后,基准数被交换至数组最右端,导致左子数组长度为 n-1、右子数组长度为 0。如此递归下去,每轮哨兵划分后都有一个子数组的长度为 0,分治策略失效,快速排序退化为“冒泡排序”的近似形式
为了进一步改进,我们可以在数组中选取三个候选元素(通常为数组的首、尾、中点元素),并将这三个候选元素的中位数作为基准数。这样一来,基准数“既不太小也不太大”的概率将大幅提升,时间复杂度劣化至 O(n^2^) 的概率大大降低
/* 选取三个候选元素的中位数 */int medianThree(int[] nums, int left, int mid, int right) {    int l = nums[left], m = nums[mid], r = nums[right];    if ((l <= m && m <= r) || (r <= m && m <= l))        return mid; // m 在 l 和 r 之间    if ((m <= l && l <= r) || (r <= l && l <= m))        return left; // l 在 m 和 r 之间    return right;}
/* 哨兵划分(三数取中值) */int partition(int[] nums, int left, int right) { // 选取三个候选元素的中位数 int med = medianThree(nums, left, (left + right) / 2, right); // 将中位数交换至数组最左端 swap(nums, left, med); // 以 nums[left] 为基准数 int i = left, j = right; while (i < j) { while (i < j && nums[j] >= nums[left]) j--; // 从右向左找首个小于基准数的元素 while (i < j && nums[i] <= nums[left]) i++; // 从左向右找首个大于基准数的元素 swap(nums, i, j); // 交换这两个元素 } swap(nums, i, left); // 将基准数交换至两子数组的分界线 return i; // 返回基准数的索引}递归深度优化#
在某些输入下,快速排序可能占用空间较多。以完全有序的输入数组为例,设递归中的子数组长度为 m,每轮哨兵划分操作都将产生长度为 0 的左子数组和长度为 m-1 的右子数组,这意味着每一层递归调用减少的问题规模非常小(只减少一个元素),递归树的高度会达到 n-1,此时需要占用 O(n) 大小的栈帧空间
为了防止栈帧空间的累积,我们可以在每轮哨兵排序完成后,比较两个子数组的长度,仅对较短的子数组进行递归。由于较短子数组的长度不会超过 n/2,因此这种方法能确保递归深度不超过 logn,从而将最差空间复杂度优化至 O(logn)。代码如下所示:
/* 快速排序(递归深度优化) */void quickSort(int[] nums, int left, int right) { // 子数组长度为 1 时终止 while (left < right) { // 哨兵划分操作 int pivot = partition(nums, left, right); // 对两个子数组中较短的那个执行快速排序 if (pivot - left < right - pivot) { quickSort(nums, left, pivot - 1); // 递归排序左子数组 left = pivot + 1; // 剩余未排序区间为 [pivot + 1, right] } else { quickSort(nums, pivot + 1, right); // 递归排序右子数组 right = pivot - 1; // 剩余未排序区间为 [left, pivot - 1] } }}归并排序#
归并排序(merge sort)是一种基于分治策略的排序算法,包含下图所示的“划分”和“合并”阶段
- 划分阶段:通过递归不断地将数组从中点处分开,将长数组的排序问题转换为短数组的排序问题
- 合并阶段:当子数组长度为 1 时终止划分,开始合并,持续地将左右两个较短的有序数组合并为一个较长的有序数组,直至结束
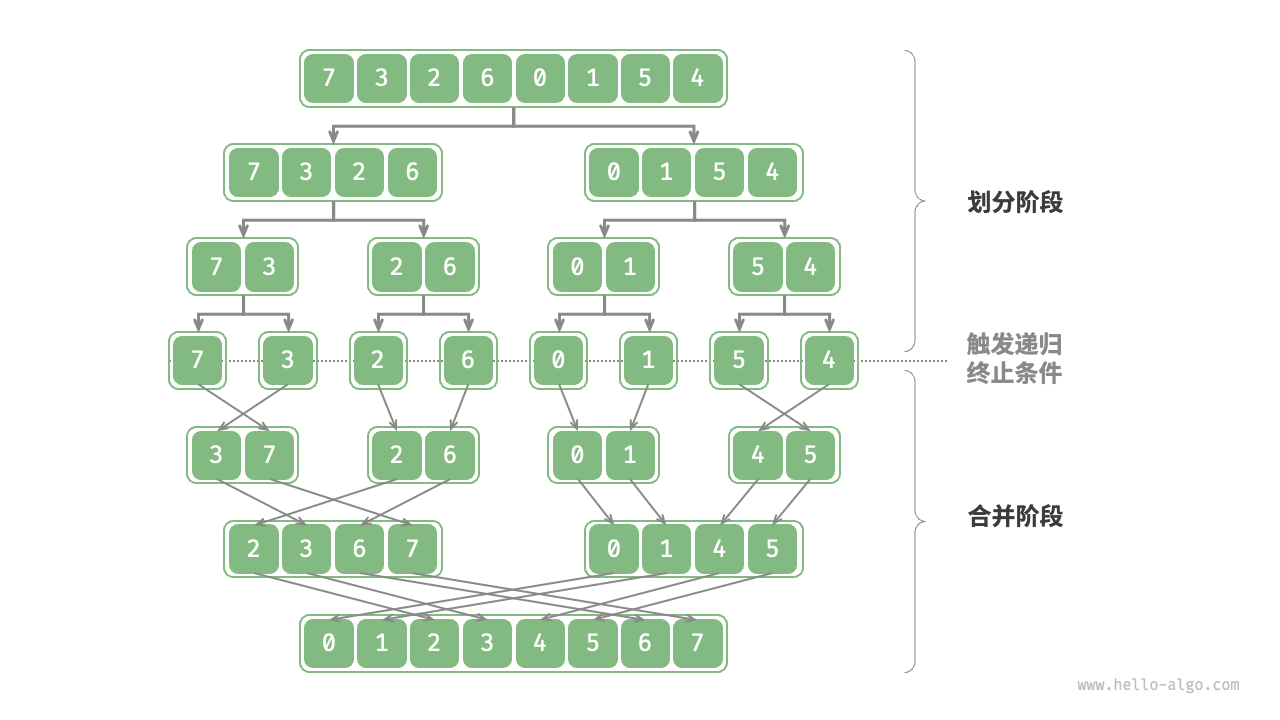
归并排序与二叉树后序遍历的递归顺序是一致的:
- 后序遍历:先递归左子树,再递归右子树,最后处理根节点
- 归并排序:先递归左子数组,再递归右子数组,最后处理合并
/* 合并左子数组和右子数组 */void merge(int[] nums, int left, int mid, int right) {    // 左子数组区间为 [left, mid], 右子数组区间为 [mid+1, right]    // 创建一个临时数组 tmp,对应区间为 [0, right - left],用于存放合并后的结果    int[] tmp = new int[right - left + 1];    // 初始化左子数组和右子数组的起始索引    int i = left, j = mid + 1, k = 0;    // 当左右子数组都还有元素时,进行比较并将较小的元素复制到临时数组中    while (i <= mid && j <= right) {        if (nums[i] <= nums[j])            tmp[k++] = nums[i++];        else            tmp[k++] = nums[j++];    }    // 将左子数组和右子数组的剩余元素复制到临时数组中    while (i <= mid) tmp[k++] = nums[i++];    while (j <= right) tmp[k++] = nums[j++];    // 将临时数组 tmp 中的元素复制回原数组 nums 的对应区间    for (k = 0; k < tmp.length; k++) nums[left + k] = tmp[k];}
/* 归并排序 */void mergeSort(int[] nums, int left, int right) { // 终止条件 if (left >= right) return; // 当子数组长度为 1 时终止递归 // 划分阶段 int mid = left + (right - left) / 2; // 计算中点 mergeSort(nums, left, mid); // 递归左子数组 mergeSort(nums, mid + 1, right); // 递归右子数组 // 合并阶段 merge(nums, left, mid, right);}- 时间复杂度为 O(nlogn)、非自适应排序:划分产生高度为 logn 的递归树,每层合并的总操作数量为 n,因此总体时间复杂度为 O(nlogn)
- 空间复杂度为 O(n)、非原地排序:递归深度为 logn,使用 O(logn) 大小的栈帧空间。合并操作需要借助辅助数组实现,使用 O(n) 大小的额外空间
- 稳定排序:在合并过程中,相等元素的次序保持不变
对于链表,归并排序相较于其他排序算法具有显著优势,可以将链表排序任务的空间复杂度优化至 O(1)
- 划分阶段:可以使用“迭代”替代“递归”来实现链表划分工作,从而省去递归使用的栈帧空间
- 合并阶段:在链表中,节点增删操作仅需改变引用(指针)即可实现,因此合并阶段(将两个短有序链表合并为一个长有序链表)无须创建额外链表
【🔥中】148排序链表#
给你链表的头结点
head,请将其按 升序 排列并返回 排序后的链表 。
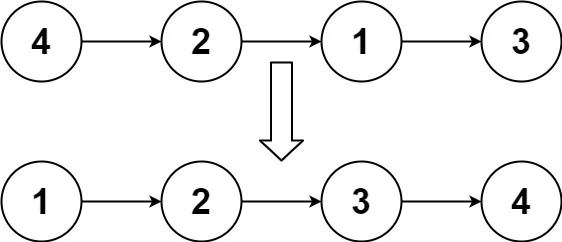
时间复杂度是 O(nlogn) 的排序算法包括归并排序、堆排序和快速排序(快速排序的最差时间复杂度是 O(n^2^),其中最适合链表的排序算法是归并排序
一、由先总问题后子问题(自顶向下)递归实现的归并排序,考虑到递归调用的栈空间,空间复杂度是 O(logn)
-
找到链表的中间结点 head
2的前一个节点,并断开 head2与其前一个节点的连接。这样我们就把原链表均分成了两段更短的链表。 -
分治,递归调用 sortList,分别排序 head(只有前一半)和 head
2 -
排序后,我们得到了两个有序链表,那么合并两个有序链表,得到排序后的链表,返回链表头节点
class Solution {    public ListNode sortList(ListNode head) {        // 如果链表为空或者只有一个节点,无需排序        if (head == null || head.next == null) return head;        // 找到中间节点 head2,并断开 head2 与其前一个节点的连接        // 比如 head=[4,2,1,3],那么 middleNode 调用结束后 head=[4,2] head2=[1,3]        ListNode head2 = middleNode(head);        // 分治        head = sortList(head);        head2 = sortList(head2);        // 合并        return mergeTwoLists(head, head2);    }
    // 876. 链表的中间结点(快慢双指针迭代法)    private ListNode middleNode(ListNode head) {        ListNode pre = head;        ListNode slow = head;        ListNode fast = head;        while (fast != null && fast.next != null) {            pre = slow; // 记录 slow 的前一个节点            slow = slow.next;            fast = fast.next.next;        }        pre.next = null; // 断开 slow 的前一个节点和 slow 的连接        return slow;    }
    // 21. 合并两个有序链表(独立双指针迭代法)    private ListNode mergeTwoLists(ListNode list1, ListNode list2) {        ListNode dummy = new ListNode(); // 用哨兵节点简化代码逻辑        ListNode cur = dummy; // cur 指向新链表的末尾        while (list1 != null && list2 != null) {            if (list1.val < list2.val) {                cur.next = list1; // 把 list1 加到新链表中                list1 = list1.next;            } else { // 注:相等的情况加哪个节点都是可以的                cur.next = list2; // 把 list2 加到新链表中                list2 = list2.next;            }            cur = cur.next;        }        cur.next = list1 != null ? list1 : list2; // 拼接剩余链表        return dummy.next;    }}
二、将其改成先子问题后总问题(自底向上)迭代实现,能优化到 O(1) 的空间复杂度
堆排序#
堆排序(heap sort)基于堆数据结构实现,可以利用“建堆操作”和“元素出堆操作”实现堆排序
- 输入数组并建立小顶堆,此时最小元素位于堆顶
- 不断执行出堆操作,依次记录出堆元素,即可得到从小到大排序的序列
以上方法虽然可行,但需要借助一个额外数组来保存弹出的元素,比较浪费空间。通常使用一种更加优雅的实现方式
设数组的长度为 n,堆排序的流程:
- 输入数组并建立大顶堆。完成后,最大元素位于堆顶
- 将堆顶元素(第一个元素)与堆底元素(最后一个元素)交换。完成交换后,堆的长度减 1,已排序元素数量加 1
- 从堆顶元素开始,从顶到底执行堆化操作(sift down)。完成堆化后,堆的性质得到修复
- 循环执行第
2.步和第3.步。循环 n-1 轮后,即可完成数组排序
实际上,元素出堆操作中也包含第 2. 步和第 3. 步,只是多了一个弹出元素的步骤
/* 堆的长度为 n ,从节点 i 开始,从顶至底堆化 */void siftDown(int[] nums, int n, int i) {    while (true) {        // 判断节点 i, l, r 中值最大的节点,记为 ma        int l = 2 * i + 1;        int r = 2 * i + 2;        int ma = i;        if (l < n && nums[l] > nums[ma]) ma = l;        if (r < n && nums[r] > nums[ma]) ma = r;        // 若节点 i 最大或索引 l, r 越界,则无须继续堆化,跳出        if (ma == i) break;        // 交换两节点        int temp = nums[i];        nums[i] = nums[ma];        nums[ma] = temp;        // 循环向下堆化        i = ma;    }}
/* 堆排序 */void heapSort(int[] nums) { // 建堆操作:堆化除叶节点以外的其他所有节点 for (int i = nums.length / 2 - 1; i >= 0; i--) siftDown(nums, nums.length, i); // 从堆中提取最大元素,循环 n-1 轮 for (int i = nums.length - 1; i > 0; i--) { // 交换根节点与最右叶节点(交换首元素与尾元素) int tmp = nums[0]; nums[0] = nums[i]; nums[i] = tmp; // 以根节点为起点,从顶至底进行堆化 siftDown(nums, i, 0); }}- 时间复杂度为 O(nlogn)、非自适应排序:建堆操作使用 O(n) 时间。从堆中提取最大元素的时间复杂度为 O(logn),共循环 n-1 轮
- 空间复杂度为 O(1)、原地排序:几个指针变量使用 O(1) 空间。元素交换和堆化操作都是在原数组上进行的
- 非稳定排序:在交换堆顶元素和堆底元素时,相等元素的相对位置可能发生变化
桶排序、计数排序、基数排序#
十二、技巧#
单调栈#
单调栈主要用于解决 “下一个更大/更小元素” 或 “左右边界” 类问题
- 从左到右+下一个更大—递减栈(栈底到栈顶递减,遇到大的就弹)
- 从左到右+下一个更小—递增栈
- 从右到左+下一个更大—递增栈
- 从右到左+下一个更小—递减栈
注意处理相等元素和边界条件(如数组末尾补一个0值来强制清空栈)
【🔥中】739每日温度#
给定一个整数数组
temperatures,表示每天的温度,返回一个数组answer,其中answer[i]是指对于第i天,下一个更高温度出现在几天后。如果气温在这之后都不会升高,请在该位置用0来代替。
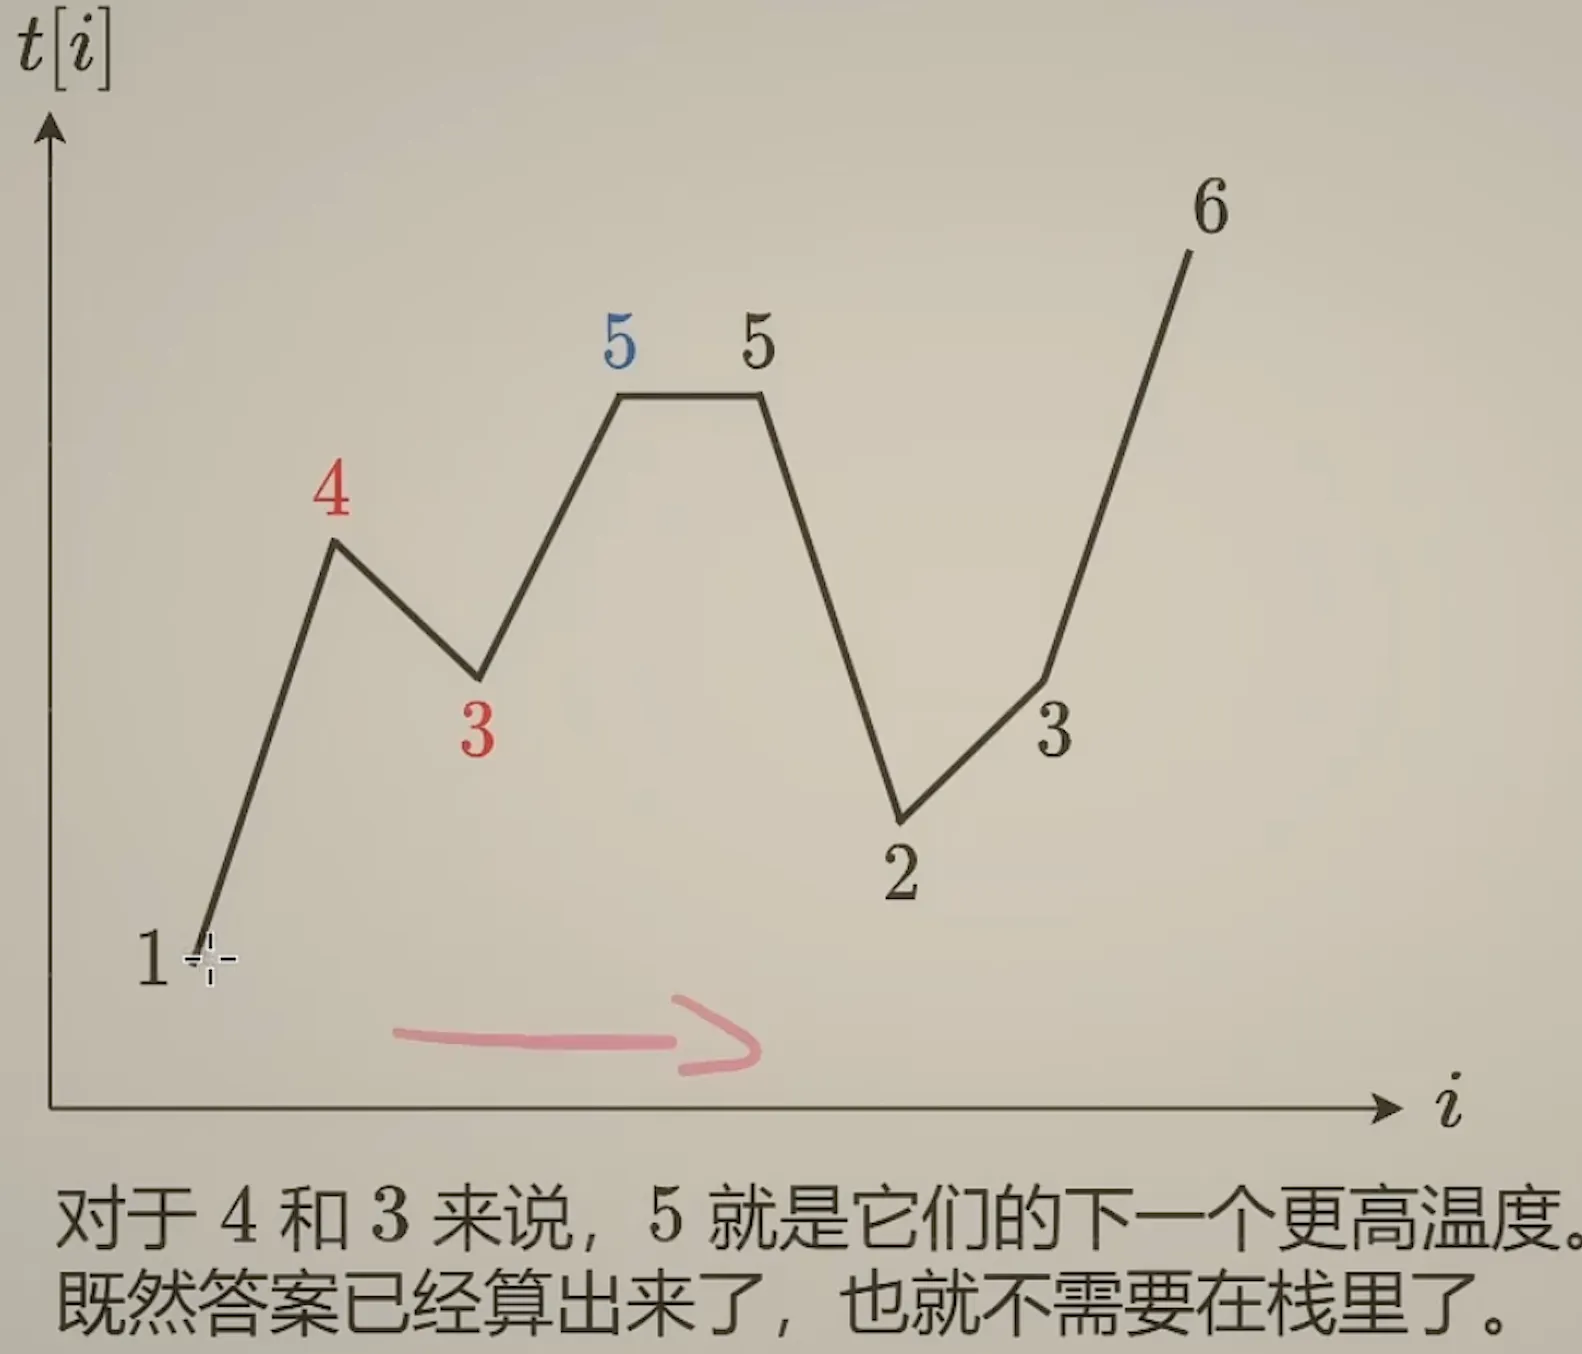
从左到右遍历+下一个更高—用单调递减栈
栈中记录还没找到下一个更大元素的那些数的下标
- 找到更大元素,及时去掉栈中无用元素后入栈
- 没找到,则入栈,始终保持栈单调递减
public int[] dailyTemperatures(int[] temperatures) { int n = temperatures.length; int[] res = new int[n]; Stack<Integer> stack = new Stack<>(); for (int i = 0; i < n; i++) { int t = temperatures[i]; // 【及时循环去掉无用数据,并更新结果】第i天新温度大于栈顶第j天温度,循环弹出栈顶第j天,并且填入第j天的结果 while (!stack.isEmpty() && t > temperatures[stack.peek()]) { int j = stack.pop(); res[j] = i - j; } // 【保持栈单调递减】第i天新温度不大于栈顶第j天温度,将第i天入栈 stack.push(i); } return res;}- 时间复杂度:O(n),其中 n 为 temperatures 的长度。虽然我们写了个二重循环,但站在每个元素的视角看,这个元素在二重循环中最多入栈出栈各一次,因此循环次数之和是 O(n),所以时间复杂度是 O(n)
- 空间复杂度:O(n)。注意这种写法栈中可以有重复元素
【🔥难】42接雨水#
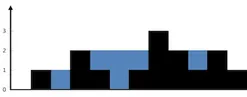
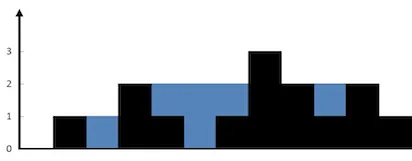
给定
n个非负整数表示每个宽度为1的柱子的高度图,计算按此排列的柱子,下雨之后能接多少雨水。
从左到右遍历+下一个更高—用递减栈
public int trap(int[] height) { int res = 0; Stack<Integer> stack = new Stack<>(); for (int i = 0; i < height.length; i++) { int h = height[i]; // 【及时循环去掉无用数据,并更新结果】右墙柱子高度大于凹槽柱子高度,循环弹出栈顶凹槽柱子,并且结果加上由左墙、凹槽、右墙柱子计算得到的面积 while (!stack.isEmpty() && height[stack.peek()] <= h) { int bottomH = height[stack.pop()]; if (stack.isEmpty()) break; // 如果没有左墙柱子,直接结束该循环 int left = stack.peek(); int height = Math.min(height[left], height[i]) - bottomH; // 面积的高 res += height * (i - left - 1); } // 【保持栈单调递减】 stack.push(i); } return res;}【🔥难】84柱状图中最大的矩形#
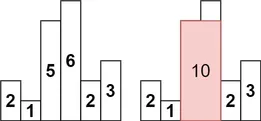
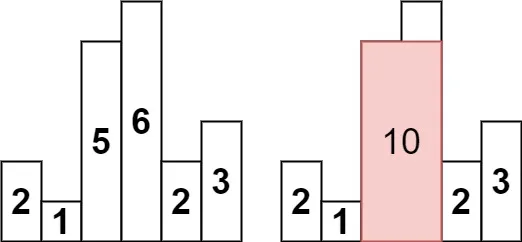
给定 n 个非负整数,用来表示柱状图中各个柱子的高度。每个柱子彼此相邻,且宽度为 1 。
求在该柱状图中,能够勾勒出来的矩形的最大面积。
首先,面积最大矩形的高度一定是 heights 中的元素
枚举每个 h=heights[i],作为矩形的高。那么矩形的宽最大是多少?我们需要知道:
- 在 i 左侧的小于 h 的最近元素的下标 left,如果不存在则为 −1。求出了 left,那么 left+1 就是矩形最左边那根柱子。如果 left=−1,那么加一后是 0,就是整个 heights 最左边的柱子
- 在 i 右侧的小于 h 的最近元素的下标 right,如果不存在则为 n。求出了 right,那么 right−1 就是矩形最右边那根柱子。如果 right=n,那么减一后是 n−1,就是整个 heights 最右边的柱子
比如示例中,选择 i=2 这个柱子作为矩形的高,那么左边小于 heights[2]=5 的最近元素的下标为 left=1,右边小于 heights[2]=5 的最近元素的下标为 right=4。矩形的宽就是 right−left−1=4−1−1=2,矩形面积为 h⋅(right−left−1)=5⋅2=10
如何用代码找到左右边界,则是通过维护一个单调递增栈(栈底到栈顶高度递增)
- 只要新来的柱子比栈顶高,就入栈(说明还没找到右边界)
- 一旦新来的柱子比栈顶矮,说明:
- 说明新来的柱子就是栈顶柱子的右边界!
- 而栈顶下面的那个柱子,就是栈顶柱子的左边界!
计算对应的矩形面积,更新答案的最大值
84题(算矩形):无论左右有没有墙,矩形都客观存在(哪怕延伸到边界),所以需要前后补0作为虚拟边界来强制计算
- 前面补0:相当于在数组最左边放了一个高度为0的“哨兵”。这样,任何柱子左边都至少有一个比它矮的柱子(就是这个0),保证了计算
left时栈永远不会空。- 后面补0:相当于在数组最右边放了一个高度为0的“哨兵”。遍历到这个0时,它会强制把栈里所有剩余的柱子都“挤兑”出来进行计算,确保每个柱子都能被处理到。
42题(接雨水):只有被“夹住”才能接水。左边没墙存不住(判空跳过),右边没墙流走了(不触发计算),所以完全不需要补0
- 左边界不需要“哨兵”,依靠“判空”兜底:栈为空,即没有左墙时直接结束运算 if (stack.isEmpty()) break;
- 右边界天然存在,无需“强制触发”:计算是由右边的“高墙”触发的。如果右边没有高墙,就不会触发计算,这符合物理事实(水会流走)。所以也不需要后面的哨兵来强制计算
public int largestRectangleArea(int[] heights) { // 预处理数组:前后补0 int[] newHeights = new int[heights.length + 2]; newHeights[0] = 0; System.arraycopy(heights, 0, newHeights, 1, heights.length); newHeights[newHeights.length - 1] = 0; Deque<Integer> stack = new LinkedList<>(); int res = 0; for (int i = 0; i < newHeights.length; i++) { int h = newHeights[i]; // 当当前高度小于栈顶高度时,触发面积计算 while (!stack.isEmpty() && h < newHeights[stack.peek()]) { int height = newHeights[stack.pop()]; int width = i - stack.peek() - 1; // 左边界为新栈顶索引,右边界为i res = Math.max(res, height * width); } stack.push(i); } return res;}维护前缀和—解决子数组和问题#
简 303区域和检索 - 数组不可变(前缀和模板题)#
实现
NumArray类:
NumArray(int[] nums)使用数组nums初始化对象int sumRange(int left, int right)返回数组nums中索引left和right之间的元素的 总和 ,包含left和right两点(也就是nums[left] + nums[left + 1] + ... + nums[right])
思路:
比如 nums=[1,2,3,4,5,6],要想计算子数组 [3,4,5] 的元素和,可以用前缀 [1,2,3,4,5] 的元素和,减去另一个前缀 [1,2] 的元素和,就得到了子数组 [3,4,5] 的元素和,即
3+4+5=(1+2+3+4+5)−(1+2)
所以任意子数组的和,都可以表示为两个前缀和的差
于是,预处理 nums 所有的前缀和,就可以 O(1) 计算任意子数组的元素和
nums 有 O(n^2^) 个子数组,如果把每个子数组都算一遍,就太慢了。但注意到 nums 只有 O(n) 个前缀,且子数组可以用两个前缀和之差表示,所以本题解的做法相当于把 O(n^2^) 的信息压缩到 O(n) 个前缀中
具体实现:
为方便描述,把 nums 记作 a,设其长度为 n
对于数组 a,计算它的长为 n+1 的前缀和数组 s,即 a 的前 0 个数的和,前 1 个数的和,前 2 个数的和……前 n 个数的和
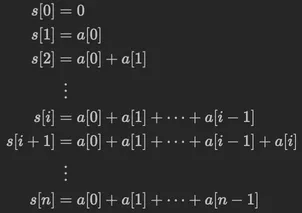
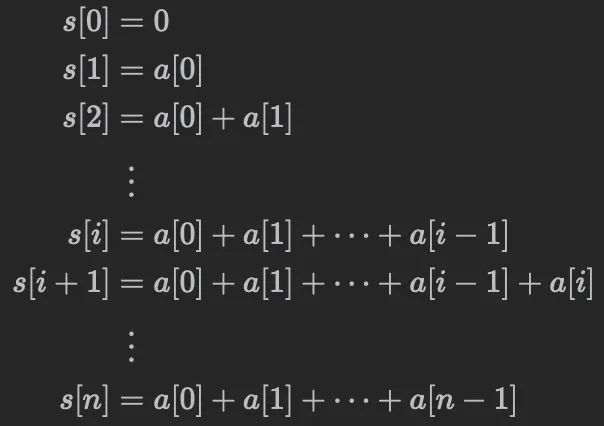
这里定义 s[0] 是为了让 s[1]=s[0]+a[0] 满足 s[i + 1] = s[i] + nums[i] 的公式,同时在后面计算子数组和 left=0 时能直接减去 s[0]
根据这个定义,前 i 个数的和,加上 a[i],就是前 i+1 个数的和,即 s[i+1]=s[i]+a[i]
通过前缀和,我们可以把子数组的元素和转化成两个前缀和的差,下标区间 [left,right] 的元素和等于前缀 [0,right] 的元素和减去另一个前缀 [0,left−1] 的元素和,即 s[right+1]−s[left]
class NumArray { private final int[] s; public NumArray(int[] nums) { s = new int[nums.length + 1]; // 构造前缀和数组 for (int i = 0; i < nums.length; i++) s[i + 1] = s[i] + nums[i]; } public int sumRange(int left, int right) { return s[right + 1] - s[left]; }}- 时间复杂度:初始化是 O(n),其中 n 是 nums 的长度。sumRange 是 O(1)
- 空间复杂度:O(n)
【🔥中】560和为K的子数组(前缀和+1两数之和HashMap)#
给你一个整数数组
nums和一个整数k,请你统计并返回 该数组中和为k的子数组的个数 。子数组是数组中元素的连续非空序列。
前缀和的定义:
s 是一个长为 n+1 的数组,第一个数是 0,s[0]=0
s[i] = nums[0]+nums[1]+⋯+nums[i−1]
s[j]−s[i]=k
1,即从 nums[i] 到 nums[j-1] 的元素和s[j+1]−s[i]=k
2,即从 nums[i] 到 nums[j] 的元素和
问题转化为:s 中有多少对下标 (i, j) 满足 0≤i<j≤n 且 s[j]−s[i]=k?
以 nums=[1,1,−1,1,−1],k=1 为例,其前缀和数组为 s=[0,1,2,1,2,1]。画出前缀和数组的折线图,如下:
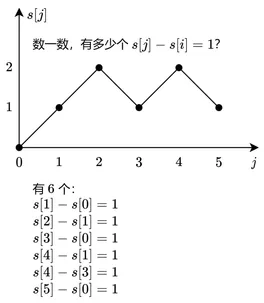
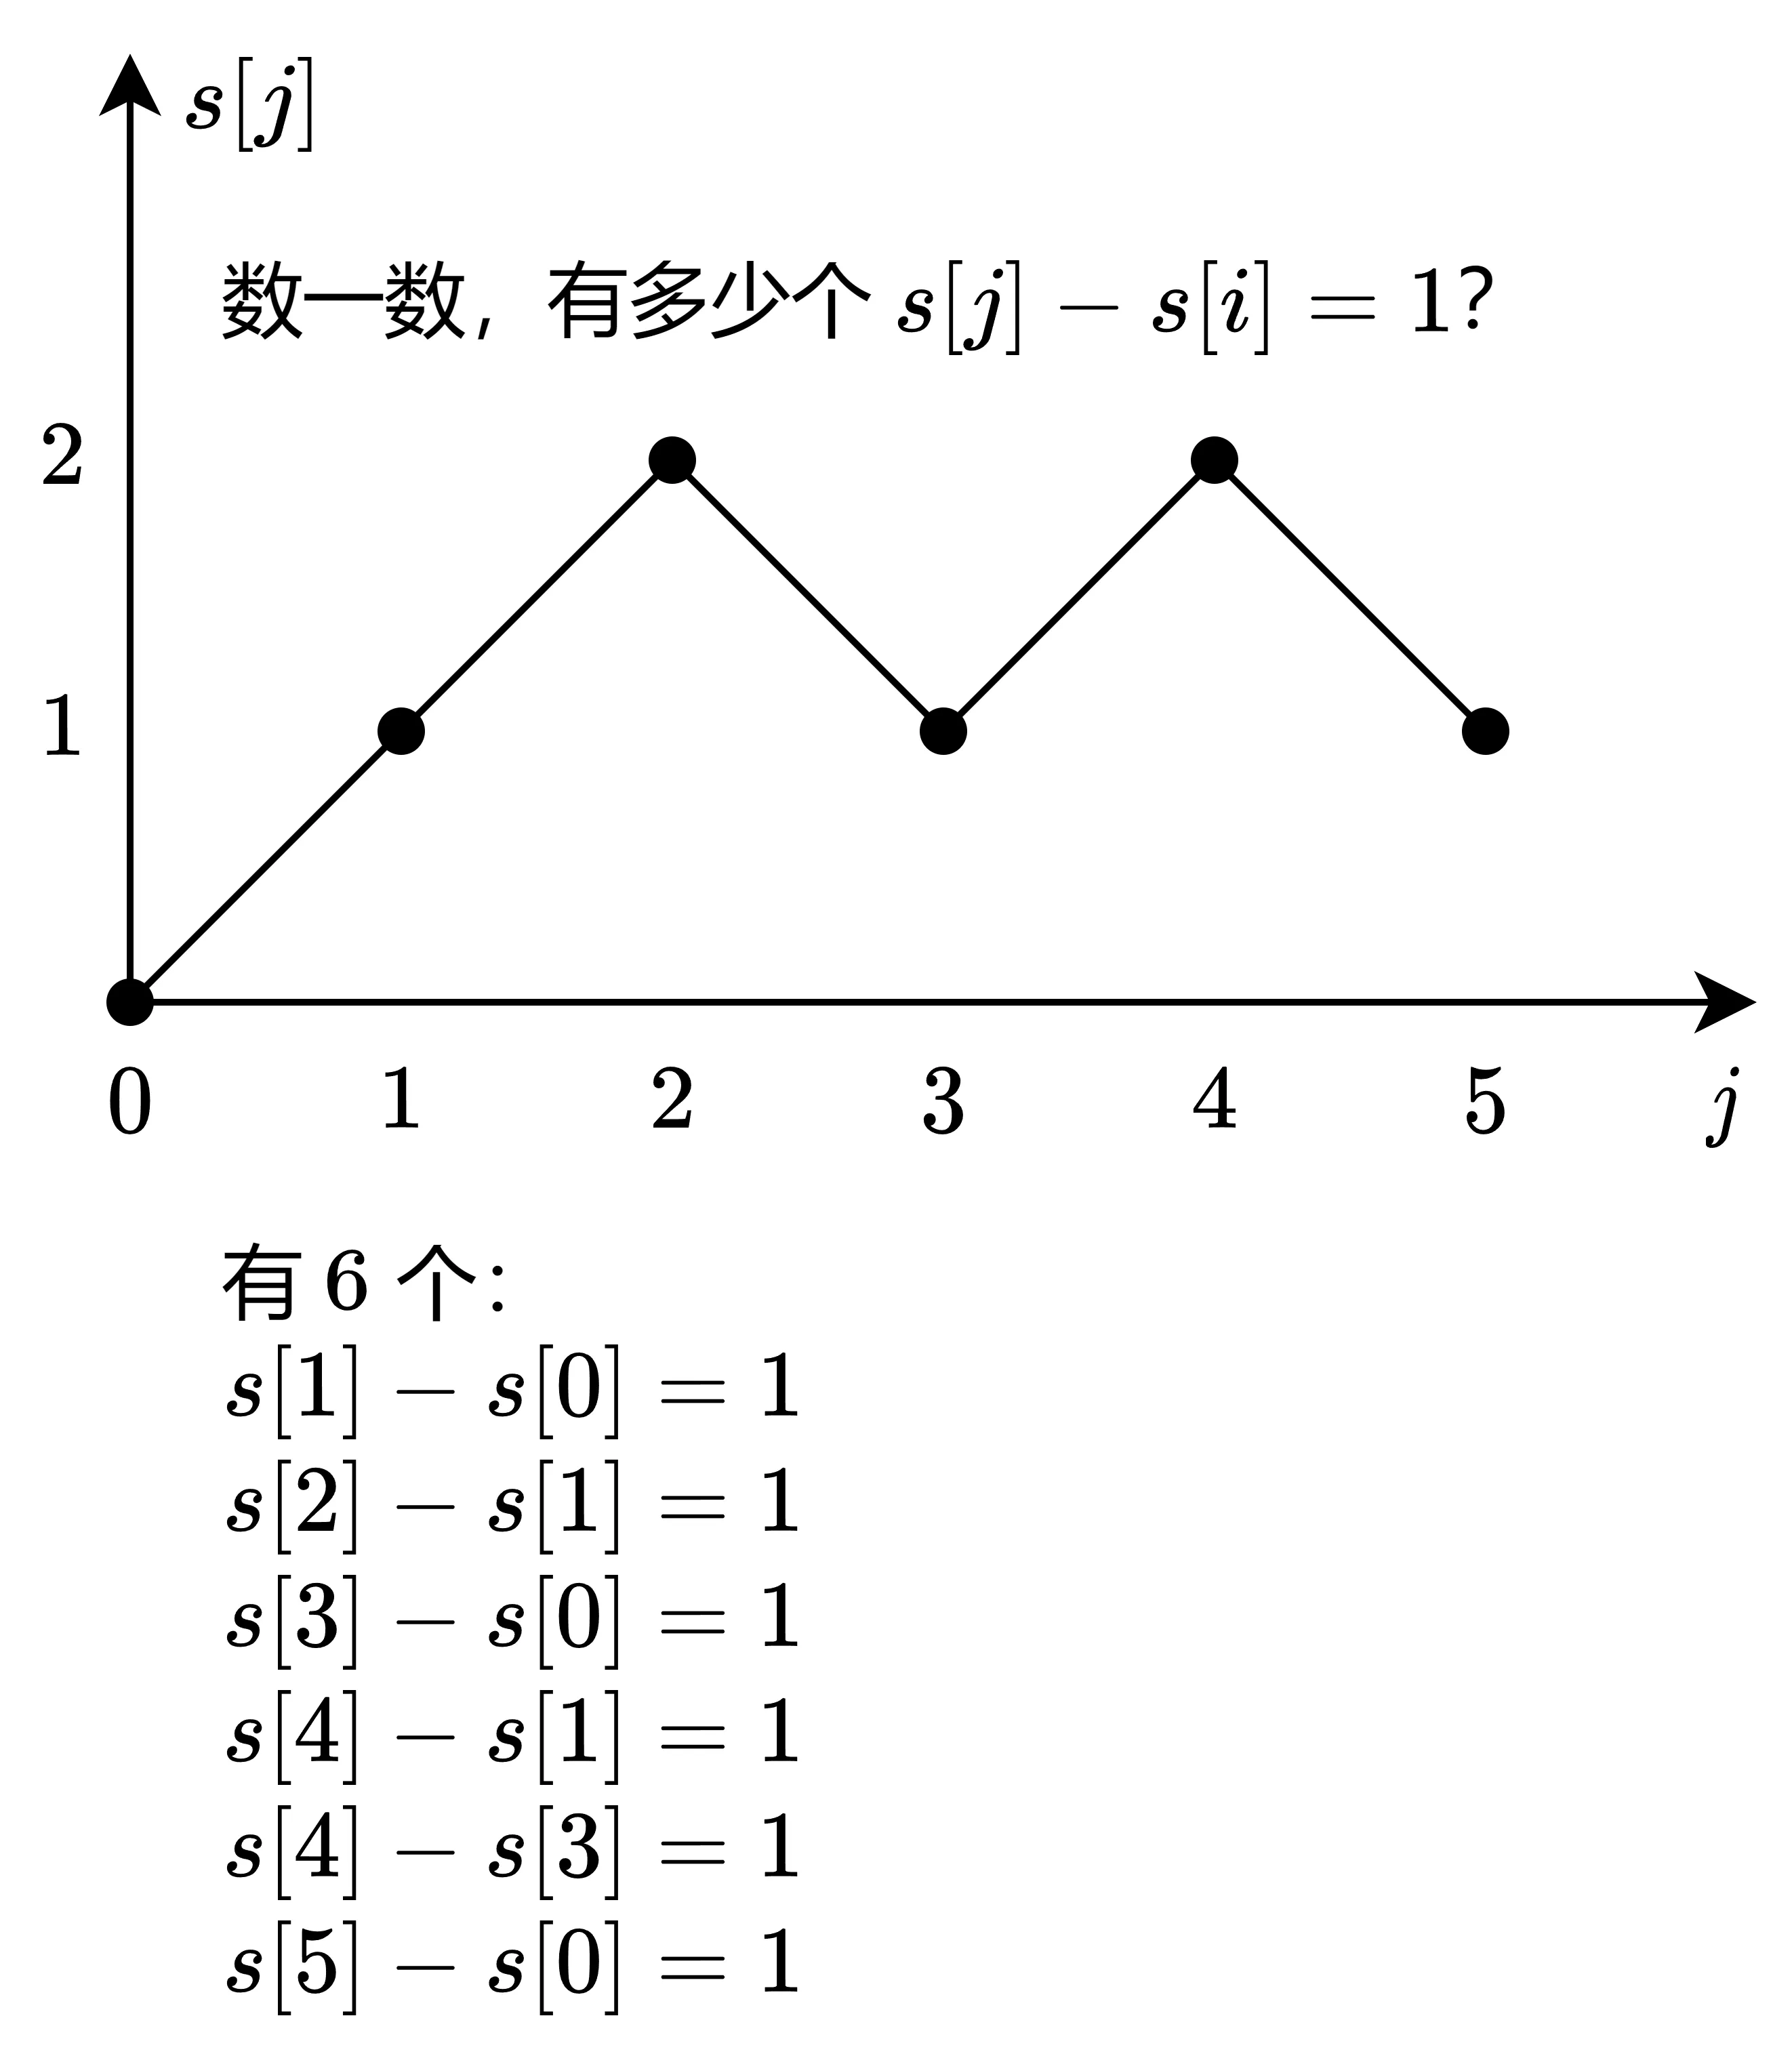
如果用二重循环暴力枚举有多少个 s[j]−s[i]=k,时间复杂度是 O(n^2^),太慢了。如何加速?
借鉴1两数之和的思路,可以把 s[j]−s[i]=k 移项,得 s[i]=s[j]−k 枚举当前的前缀和 s[j],看看曾经有多少个前缀和等于 s[j]−k(配对)。每当我们在左边找到一个值等于 s[j]−k 的前缀和,就找到了一个和为 k 的子数组(因为 s[j]−(s[j]−k)=k)
比如 s[j]=2,那么 s[i]=s[j]−k=2−1=1,我们要找的是 j 左边有多少个 s[i]=1。在上面的例子中,遍历到 s[4]=2 时,我们知道左边有 2 个 s[i]=1,所以新找到了 2 个和为 1 的子数组
用这个视角,再来算算上图中的那 6 个和为 1 的子数组
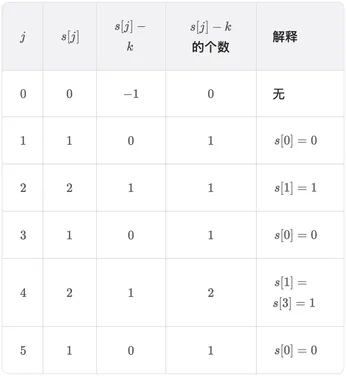
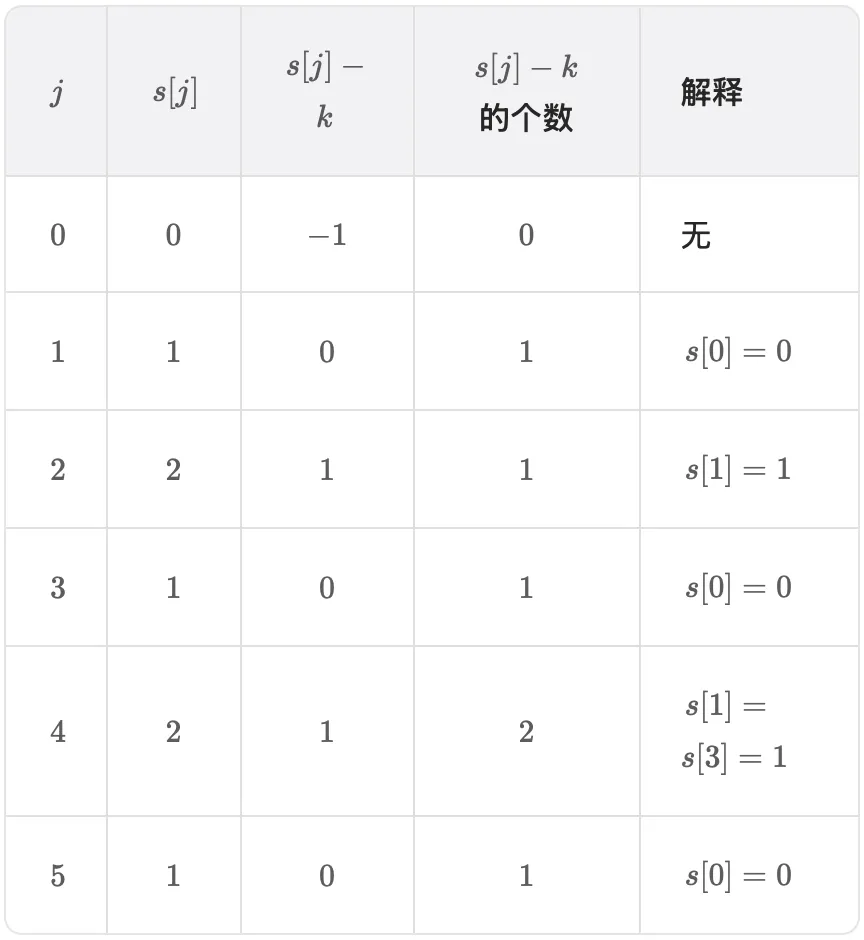
一共有 0+1+1+1+2+1=6 个和为 k=1 的子数组
具体来说,在遍历 s[j] 的同时,用一个哈希表 cnt 统计 s[j] 的个数。哈希表的 key 是 s[j],value 是值为 s[j] 的前缀和的个数。遍历到 s[j] 时,从哈希表中就可以找到有 cnt[s[j]−k] 个 s[i],加入答案
public int subarraySum(int[] nums, int k) {    int n = nums.length;    int[] s = new int[n + 1];    // 构造前缀和数组    for (int i = 0; i < n; i++) s[i + 1] = s[i] + nums[i];
    Map<Integer, Integer> cnt = new HashMap<>(); // 预分配空间    int res = 0;    for (int sj : s) {        res += cnt.getOrDefault(sj - k, 0);        cnt.put(sj, cnt.getOrDefault(sj, 0) + 1);    }    return res;}
可以改用 Java8 提供的 merge 方法优雅地更新 Map 数据
merge(key, value, func):如果 key 不存在,就put;如果存在,就用func把旧值和新值算一下再put
// 含义:将 sj 对应的值与 1 相加,如果不存在则初始值为 0cnt.merge(sj, 1, Integer::sum);【🔥中】437路径总合 III(560的递归回溯版)#
给定一个二叉树的根节点
root,和一个整数targetSum,求该二叉树里节点值之和等于targetSum的 路径 的数目。路径 不需要从根节点开始,也不需要在叶子节点结束,但是路径方向必须是向下的(只能从父节点到子节点)。
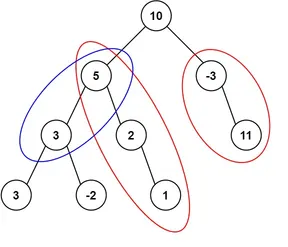
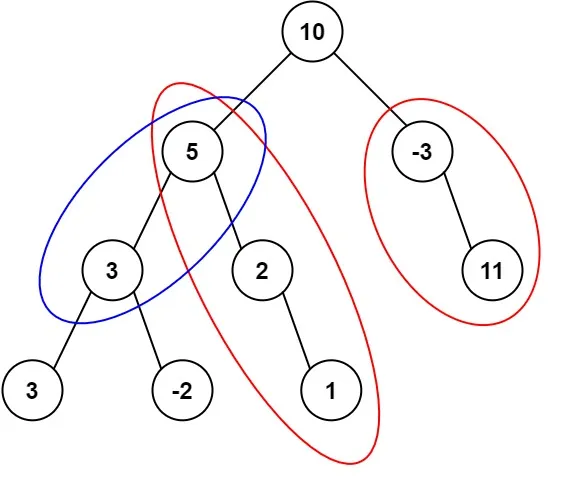
如果二叉树是一条链,本题就和 560. 和为 K 的子数组 完全一样了:统计有多少个非空连续子数组的元素和恰好等于 targetSum
| 560. 和为 K 的子数组 | 437. 路径总和 III |
|---|---|
| 连续子数组 | 方向向下的路径 |
| 前缀 | 从根节点开始的路径 |
| 做法:枚举子数组右端点,统计有多少个左端点 | 做法:枚举路径的终点,统计有多少个起点 |
我们要解决的问题是:DFS 遍历这棵树,遍历到节点 node 时,假设 node 是路径的终点,那么有多少个起点,满足起点到终点 node 的路径总和恰好等于 targetSum?
和 560 题一样的套路:一边遍历二叉树,一边用哈希表 cnt 统计前缀和(从根节点开始的路径和)的出现次数。设从根到终点 node 的路径和为 s,那么起点的个数就是 cnt[s−targetSum],加入答案。对比 560 题,我们在枚举子数组的右端点(终点),统计有多少个左端点(起点),做法完全一致。
class Solution {    private int res;    public int pathSum(TreeNode root, int targetSum) {        // key:从根到 node 的节点值之和        // value:节点值之和的出现次数        // 注意在递归过程中,哈希表只保存根到 node 的路径的前缀的节点值之和        Map<Long, Integer> cnt = new HashMap<>();        cnt.put(0L, 1);        backtrack(root, 0, targetSum, cnt);        return res;    }
    // s 表示从根到 node 的父节点的节点值之和(node 的节点值尚未计入)    private void backtrack(TreeNode node, long s, int targetSum, Map<Long, Integer> cnt) {        if (node == null) return;        // 在递归过程中构建"前缀和数组"(这里没有用数组,而是用s动态存储)        s += node.val;        // 把 node 当作路径的终点,统计有多少个起点        res += cnt.getOrDefault(s - targetSum, 0);
        cnt.merge(s, 1, Integer::sum); // cnt[s]++        backtrack(node.left, s, targetSum, cnt);        backtrack(node.right, s, targetSum, cnt);        cnt.merge(s, -1, Integer::sum); // cnt[s]-- 恢复现场(撤销 cnt[s]++)    }}
⚠️注意:
1、代码中的「恢复现场」用意何在?
答:举个例子,递归完 node 子树,如果接下来要递归 node 父节点的右子树,我们不恢复现场,那么 cnt 中还保存着 node 子树的数据。但对于 node 父节点的右子树来说,要计算的路径并不涉及到 node 子树的任何节点。如果不恢复现场,cnt 中统计的前缀和个数会更多,我们算出来的答案可能比正确答案更大
2、为什么递归参数 s 不需要恢复现场?
答:s 是基本类型,在函数调用的时候会复制一份往下传递,s += node.val 修改的仅仅是当前递归函数中的 s 参数,并不会影响到其他递归函数中的 s。注:如果把 s 声明在递归函数外,全局只有一个 s,那么执行 s += node.val 就会影响全局了,这种情况需要写 s -= node.val 恢复现场
3、560数组版中的初始化只需要 s[0]=0(默认),而437中的初始化还需要 cnt.put(0L, 1);
(1)在560数组版中,你显式地构造了一个前缀和数组 s
-
显式的 0:
int[] s = new int[n + 1];// s[0] 默认就是 0,代表“空数组”的前缀和这个
s[0]是实实在在存在于数组里的第一个元素 -
循环过程:
for (int sj : s) { // 第一次循环时,sj 就是 s[0] (即 0)res += cnt.getOrDefault(sj - k, 0);// 此时 Map 是空的,查不到 sj-k,res 加 0cnt.put(sj, ...);// 紧接着,把 sj (也就是 0) 放入了 Map}结论:数组版通过遍历
s[0]这个动作,自动完成了“把 0 放入 Map”的操作。所以不需要手动初始化
(2)在437递归回溯版中,没有显式的前缀和数组,前缀和是在递归过程中动态计算的
- 没有“第 0 步”的遍历:
递归是从
root节点开始的。当你进入backtrack函数处理第一个节点时,你直接计算了s += node.val- 假设根节点的值是 3,那么
s直接变成了 3 - 此时你需要查找
Map中是否有s - targetSum(即3 - targetSum)
- 假设根节点的值是 3,那么
- 边界情况(从根节点开始的路径):
如果题目要求的路径恰好是从根节点开始,且根节点的值就等于
targetSum(比如3 - 3 = 0)- 代码会去
Map里找0 - 如果不初始化:
Map是空的,找不到0,结果就会漏掉这一条路径
- 代码会去
维护前缀最小值—【🔥中】155最小栈#
设计一个支持
push,pop,top操作,并能在常数时间内检索到最小元素的栈。实现
MinStack类:
MinStack()初始化堆栈对象。void push(int val)将元素val推入堆栈。void pop()删除堆栈顶部的元素。int top()获取堆栈顶部的元素。int getMin()获取堆栈中的最小元素。
给你一个数组 nums,如何计算每个前缀的最小值?
定义 preMin[i] 表示 nums[0] 到 nums[i] 的最小值
这可以从左到右计算:
preMin[0]=nums[0] preMin[1]=min(nums[0],nums[1]) preMin[2]=min(nums[0],nums[1],nums[2])=min(preMin[1],nums[2]) preMin[3]=min(nums[0],nums[1],nums[2],nums[3])=min(preMin[2],nums[3]) …… 一般地,我们有
preMin[i]=min(preMin[i−1],nums[i])
回到本题,把 nums 视作栈,本题相当于在 nums 的末尾动态地添加/删除元素
-
栈中除了保存添加的元素,还保存前缀最小值
-
添加元素:设当前栈的大小是 n。添加元素 val 后,额外维护 preMin[n]=min(preMin[n−1],val),其中 preMin[n−1] 是添加 val 之前,栈顶保存的前缀最小值
-
删除元素:弹出栈顶即可
注意:
-
初始化的时候,在栈底加一个 ∞ 哨兵,确保栈为空 push 时 getMin 仍能得到一个值,这里是 Integer.MAX_VALUE
-
题目保证 pop,top,getMin 都是在非空栈上操作的
class MinStack {    // 注意不要使用 Stack 类,因为它继承自 Vector,是同步的,会导致一些性能问题    private final Deque<int[]> st = new ArrayDeque<>();
    public MinStack() { // 初始化堆栈对象        // 添加栈底哨兵 Integer.MAX_VALUE        // 这里的 0 写成任意数都可以,反正用不到        st.push(new int[]{0, Integer.MAX_VALUE});    }
    public void push(int val) { // 将元素val推入堆栈        st.push(new int[]{val, Math.min(getMin(), val)});    }
    public void pop() { // 删除堆栈顶部的元素        st.pop();    }
    public int top() { // 获取堆栈顶部的元素        return st.peek()[0];    }
public int getMin() { // 获取堆栈中的最小元素 return st.peek()[1]; }}维护分解的前后缀—【🔥中】238除了自身以外数组的乘积#
给你一个整数数组
nums,返回 数组answer,其中answer[i]等于nums中除了nums[i]之外其余各元素的乘积 。题目数据 保证 数组
nums之中任意元素的全部前缀元素和后缀的乘积都在 32 位 整数范围内。请 不要使用除法,且在
O(n)时间复杂度内完成此题。
answer[i] 等于 nums 中除了 nums[i] 之外其余各元素的乘积。换句话说,如果知道了 i 左边所有数的乘积,以及 i 右边所有数的乘积,就可以算出 answer[i]
于是:
- 定义 pre[i] 表示从 nums[0] 到 nums[i−1] 的乘积
- 定义 suf[i] 表示从 nums[i+1] 到 nums[n−1] 的乘积
可以先计算出从 nums[0] 到 nums[i−2] 的乘积 pre[i−1],再乘上 nums[i−1],就得到了 pre[i],即 pre[i]=pre[i−1]⋅nums[i−1]
同理有 suf[i]=suf[i+1]⋅nums[i+1]
初始值:pre[0]=suf[n−1]=1。按照上文的定义,pre[0] 和 suf[n−1] 都是空子数组的元素乘积,我们规定这是 1,因为 1 乘以任何数 x 都等于 x,这样可以方便递推计算 pre[1],suf[n−2] 等
算出 pre 数组和 suf 数组后,有 answer[i]=pre[i]⋅suf[i]
public int[] productExceptSelf(int[] nums) {    int n = nums.length;    int[] pre = new int[n];    pre[0] = 1;    for (int i = 1; i < n; i++) pre[i] = pre[i - 1] * nums[i - 1];
    int[] suf = new int[n];    suf[n - 1] = 1;    for (int i = n - 2; i >= 0; i--) suf[i] = suf[i + 1] * nums[i + 1];
int[] res = new int[n]; for (int i = 0; i < n; i++) res[i] = pre[i] * suf[i]; return res;}- 时间复杂度:O(n),其中 n 是 nums 的长度
- 空间复杂度:O(n)
其他#
【🔥简】136只出现一次的数字(异或运算)#
给你一个 非空 整数数组
nums,除了某个元素只出现一次以外,其余每个元素均出现两次。找出那个只出现了一次的元素。你必须设计并实现线性时间复杂度的算法来解决此问题,且该算法只使用常量额外空间。
利用异或运算 a⊕a=0 的性质,可以用异或来「消除」所有出现了两次的元素,最后剩下的一定是只出现一次的元素
例如 nums=[4,1,2,1,2],把所有元素异或:
4⊕1⊕2⊕1⊕2 = 4⊕(1⊕1)⊕(2⊕2) = 4⊕0⊕0 = 4
其中用到了异或运算的交换律 a⊕b=b⊕a,以及结合律 (a⊕b)⊕c=a⊕(b⊕c)(类比加法)
代码中,初始化 ans=0 是因为 0⊕a=a,相当于我们从第一个数开始,和其他数异或
public int singleNumber(int[] nums) { int ans = 0; for (int x : nums) ans ^= x; return ans;}| 名称 | 运算符 | 规则 | 示例 | 结果 |
|---|---|---|---|---|
| 按位与 | & | 全 1 则 1,否则 0 | 0101 & 0011 | 0001 (1) |
| 按位或 | ` | ` | 有 1 则 1,全 0 则 0 | 0101 |
| 按位异或 | ^ | 相同为 0,不同为 1 | 0101 ^ 0011 | 0110 (6) |
| 按位取反 | ~ | 0 变 1,1 变 0 | ~(0000 0101) | 1111 1010 (-6) |
| 左移 | << | 向左移,低位补 0 | 0000 0011 << 2 | 0000 1100 (12) |
| 右移 | >> | 向右移,高位补符号位 | 1111 0100 >> 2 | 1111 1101 (-3) |
| 无符号右移 | >>> | 向右移,高位补 0 | 1111 0100 >>> 2 | 0011 1101 (61) |
【🔥简】169多数元素(擂台赛)#
给定一个大小为
n的数组nums,返回其中的多数元素。多数元素是指在数组中出现次数 大于⌊ n/2 ⌋的元素。你可以假设数组是非空的,并且给定的数组总是存在多数元素。
尝试设计时间复杂度为 O(n)、空间复杂度为 O(1) 的算法解决此问题。
用「擂台赛」打比方:
- 擂主登场:nums[0] 成为初始擂主,生命值为 1
- 挑战者出现:遍历后续元素,作为挑战者
- 比武:如果挑战者与擂主属于同一门派(值相同),那么擂主生命值加 1,否则擂主生命值减 1
- 擂主更迭:如果比武后,擂主生命值降为 0(同归于尽),那么下一个挑战者成为新的擂主,生命值为 1
- 最后在擂台上的那人,便是武林盟主(绝对众数)
public int majorityElement(int[] nums) { int res = 0; int hp = 0; for (int x : nums) { if (hp == 0) { // x 是初始擂主,生命值为 1 res = x; hp = 1; } else { // 比武,同门加血,否则扣血 int change = x == res ? 1 : -1; hp += change; } } return res;}【🔥中】31下一个排列(下一个字典序算法)#
整数数组的一个 排列 就是将其所有成员以序列或线性顺序排列。
- 例如,
arr = [1,2,3],以下这些都可以视作arr的排列:[1,2,3]、[1,3,2]、[3,1,2]、[2,3,1]。整数数组的 下一个排列 是指其整数的下一个字典序更大的排列。更正式地,如果数组的所有排列根据其字典顺序从小到大排列在一个容器中,那么数组的 下一个排列 就是在这个有序容器中排在它后面的那个排列。如果不存在下一个更大的排列,那么这个数组必须重排为字典序最小的排列(即,其元素按升序排列)。
- 例如,
arr = [1,2,3]的下一个排列是[1,3,2]。- 类似地,
arr = [2,3,1]的下一个排列是[3,1,2]。- 而
arr = [3,2,1]的下一个排列是[1,2,3],因为[3,2,1]不存在一个字典序更大的排列。给你一个整数数组
nums,找出nums的下一个排列。必须 原地 修改,只允许使用额外常数空间。
字典序就是从左到右,逐位比较
排列 [1,3,5,4,2] 的下一个排列是什么?
- 如果 1,3,5 保持不变,只重新排列 4,2,得到 2,4。排列变小了,这不行
- 如果 1,3 保持不变,只重新排列 5,4,2,由于 5 右边都是小于 5 的数,所以重排后,5 这个位置上的数必然变小,导致排列变小,这也不行
- 如果 1 保持不变,只重新排列 3,5,4,2,这是可以的,因为 3 右边有比 3 大的数,重排后可以让 3 这个位置上的数变大,从而得到更大的排列
- 由于要求的是下一个排列,所以 3 这个位置上的数只要「大一点点」就好了。找到 3 右边最小的大于 3 的数,也就是 4,放到 3 这个位置上。于是,下一个排列是 [1,4, - , - , - ]
- 剩余的三个数是 2,3,5。由于只看前两位 [1,4, - , - , - ] 就已经比 [1,3,5,4,2] 大了,所以后三位填最小的排列就行,即按照 2,3,5 的顺序填,得到 [1,4,2,3,5]
回顾是怎么算的:
- 从右向左,找第一个数字 x,满足 x 右边有大于 x 的数,这样可以把 x 变大。我们找到的数是 3。注意到,此时 3 右边的数一定是递减的,否则应该在 3 的右边找到我们要的数,所以 3 右侧相邻数字就是 3 右边最大的数。如果 3 右侧相邻数字小于 3,那么 3 右边必然没有大于 3 的数。因此,这一步可以简化为,从右向左,找第一个小于右侧相邻数字的数 x
- 找 3 右边最小的大于 3 的数,即 4。由于 3 右边的数是递减的,所以从右向左找到的第一个大于 3 的数,就是 3 右边最小的大于 3 的数。然后把 4 放到 3 的位置上,把 3 放到右边的三个位置中。这一步可以简化为交换 3 和 4。交换后得到 [1,4,5,3,2]。因此这一步是,从右向左找第一个大于 x 的数 y,它就是 x 右边最小的大于 x 的数,交换 x 和 y
- 把 4 右边的数从小到大排序。注意到,第二步交换后,4 右边的数 5,3,2 是递减的(证明见下面),所以只需要把 5,3,2 反转,就得到了答案 [1,4,2,3,5]。这一步为反转 y 右边的数,把右边的数变成最小的排列
特别地,如果第一步没有找到这样的 x,说明 nums 是递减的,是最后一个排列(字典序最大的排列)。此时跳过第二步,反转整个 nums,结果一定是递增的,即第一个排列(字典序最小的排列)
问:为什么第二步交换后,右边的序列仍然是递减的?
答:设交换前 nums=[…,x,c,b,a,…] 且 a<x<b<c,那么 x 右边最小的大于 x 的数是 b。交换 x 和 b 后,右边数字为 c,x,a,…,满足 c>x>a>⋯,仍然是递减的
public void nextPermutation(int[] nums) {    int n = nums.length;    // 第一步:从右向左找到第一个小于右侧相邻数字的数 nums[i]    int i = n - 2;    while (i >= 0 && nums[i] >= nums[i + 1]) i--;    // 如果找到了,进入第二步;否则跳过第二步,反转整个数组    if (i >= 0) {        // 第二步:从右向左找到 nums[i] 右边最小的大于 nums[i] 的数 nums[j]        int j = n - 1;        while (nums[j] <= nums[i]) j--;        // 交换 nums[i] 和 nums[j]        swap(nums, i, j);    }    // 第三步:反转 [i+1, n-1](如果上面跳过第二步,此时 i = -1)    reverse(nums, i + 1, n - 1);}
private void swap(int[] nums, int i, int j) {    int tmp = nums[i];    nums[i] = nums[j];    nums[j] = tmp;}
private void reverse(int[] nums, int left, int right) {    while (left < right) swap(nums, left++, right--);
评论
欢迎交流,使用 GitHub 账号登录后即可留言。
在 GitHub Discussions 中查看讨论 ↗