【跳转到上一篇:算法 2(哈希表、字符串、双指针总结、栈与队列)】
六、二叉树#
理论基础#
需要了解 二叉树的种类,存储方式,遍历方式 以及二叉树的定义
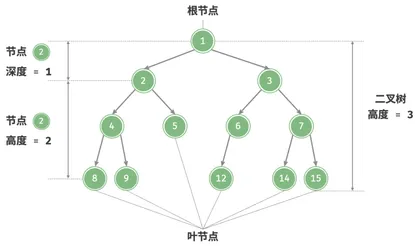
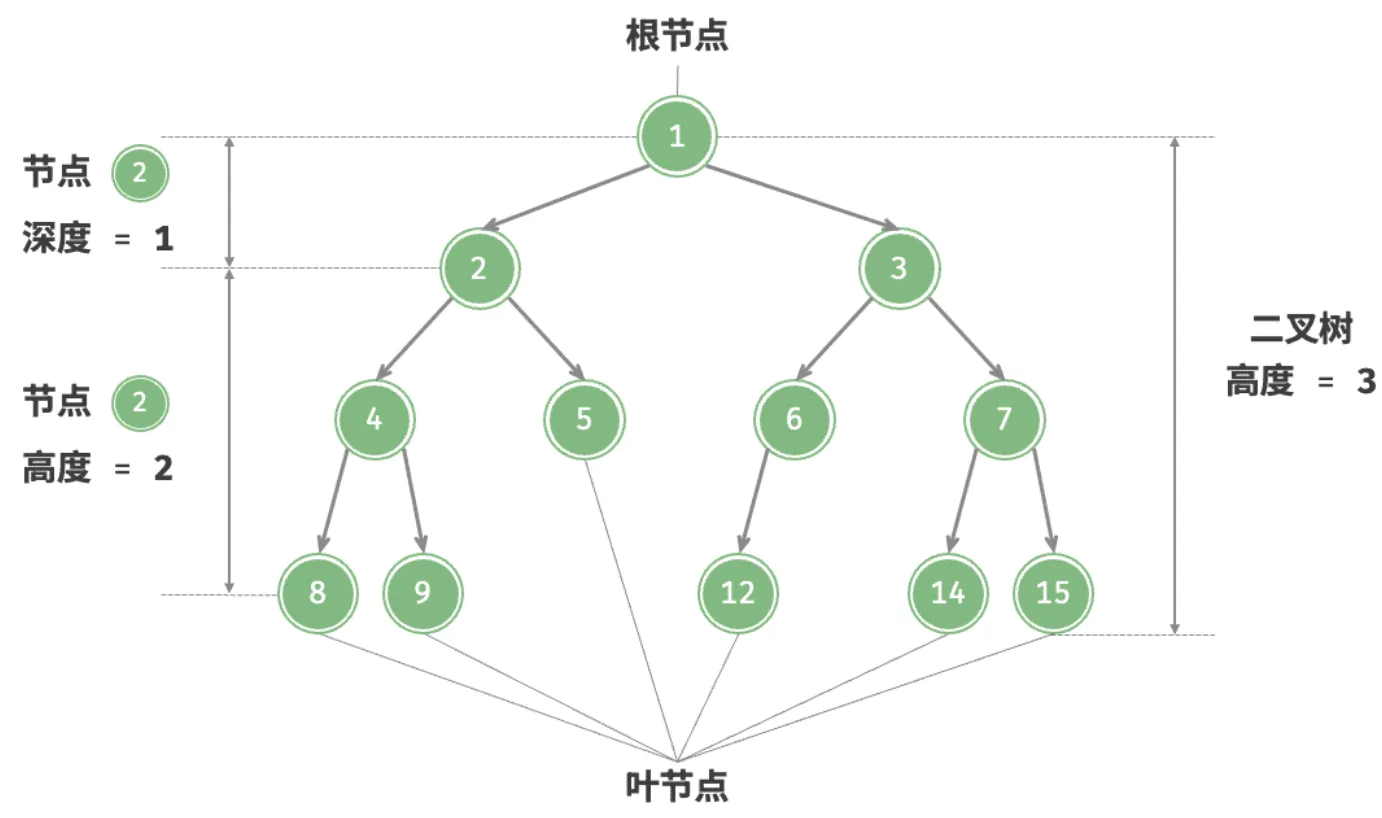
与链表类似,二叉树的基本单元是树节点,每个节点包含值、左子节点引用和右子节点引用。当给定一个二叉树的节点时,我们将该节点的左子节点及其以下节点形成的树称为该节点的左子树,同理可得右子树
/* 二叉树节点类 */class TreeNode { int val; // 节点值 TreeNode left; // 左子节点引用 TreeNode right; // 右子节点引用 TreeNode() {} TreeNode(int val) { this.val = val; } TreeNode(int val, TreeNode left, TreeNode right) { this.val = val; this.left = left; this.right = right; }}常见术语:
- 根节点(root node):位于二叉树顶层的节点,没有父节点。
- 叶节点(leaf node):没有子节点的节点,其两个指针均指向
None。 - 边(edge):连接两个节点的线段,即节点引用(指针)。
- 节点所在的层(level):从顶至底递增,根节点所在层为 1 。
- 节点的度(degree):节点的子节点的数量。在二叉树中,度的取值范围是 0、1、2 。
- 二叉树的高度(height):从根节点到最远叶节点所经过的边的数量。
- 节点的深度(depth):从根节点到该节点所经过的边的数量。
- 节点的高度(height):从距离该节点最远的叶节点到该节点所经过的边的数量。
leetcode将高度和深度定义为“经过的节点的数量”。在这种情况下,高度和深度都需要加 1
基本操作#
1、初始化二叉树
与链表类似,首先初始化节点,然后构建引用(指针)
// 初始化节点TreeNode n1 = new TreeNode(1);TreeNode n2 = new TreeNode(2);TreeNode n3 = new TreeNode(3);TreeNode n4 = new TreeNode(4);TreeNode n5 = new TreeNode(5);// 构建节点之间的引用(指针)n1.left = n2;n1.right = n3;n2.left = n4;n2.right = n5;2、插入与删除节点,通过修改指针
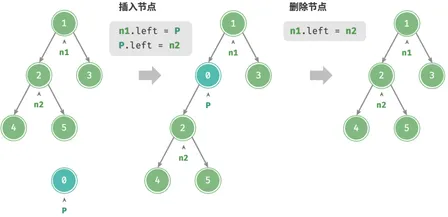
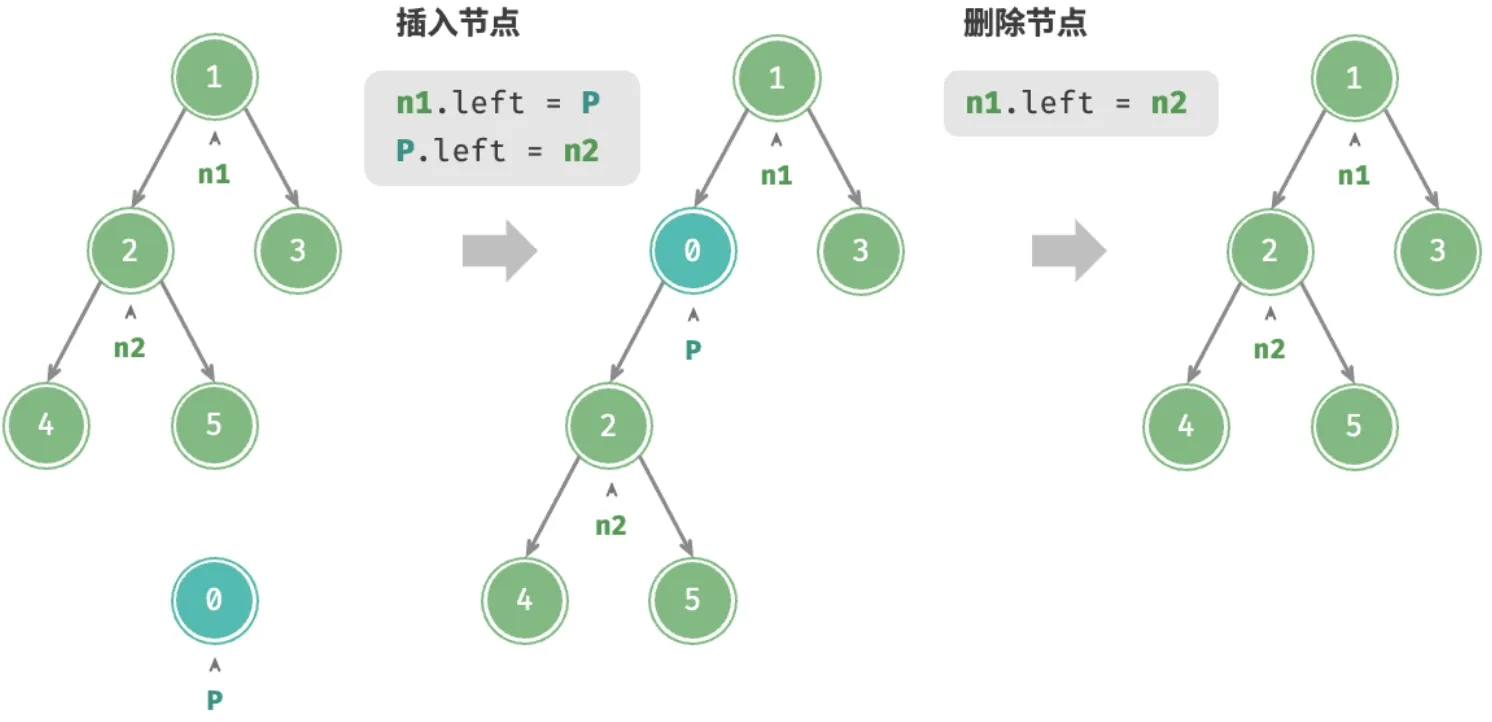
TreeNode P = new TreeNode(0);// 在 n1 -> n2 中间插入节点 Pn1.left = P;P.left = n2;// 删除节点 Pn1.left = n2;二叉树的种类#
-
满二叉树(完美二叉树)
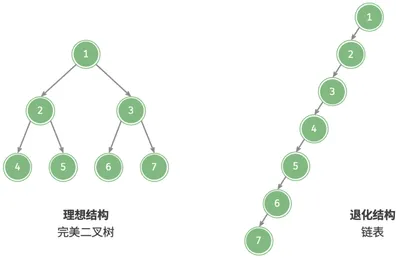
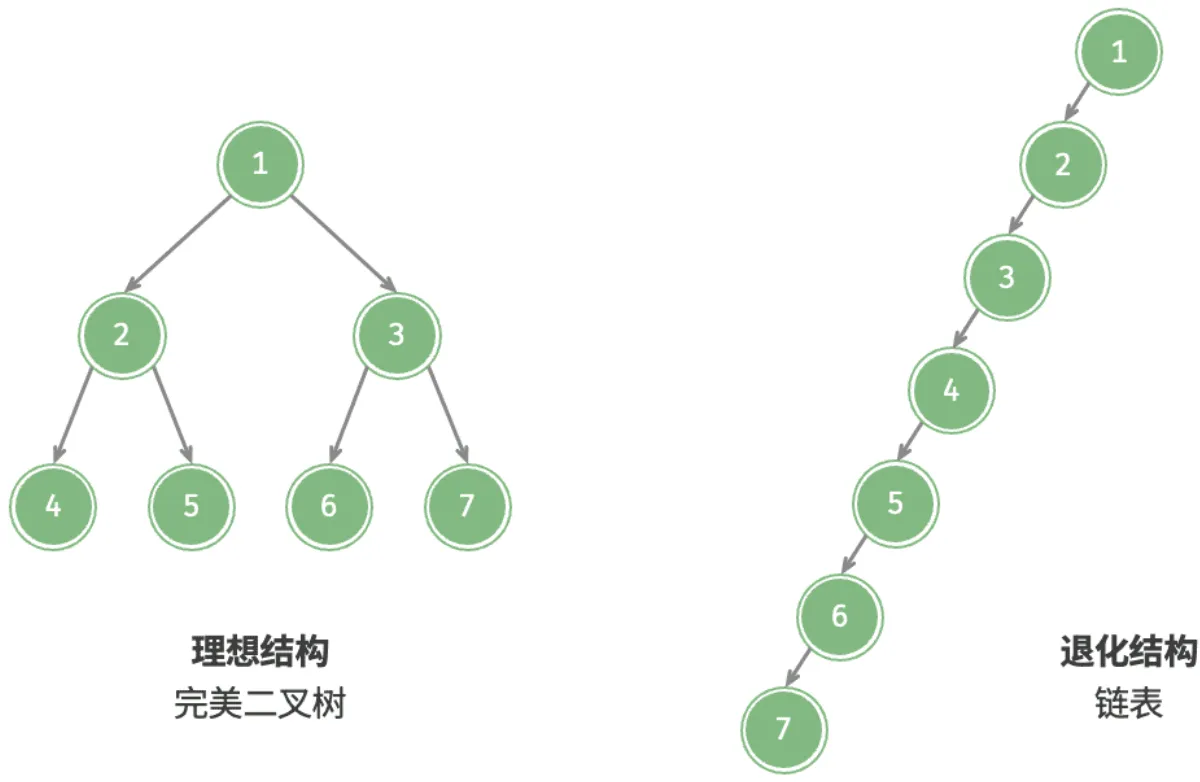
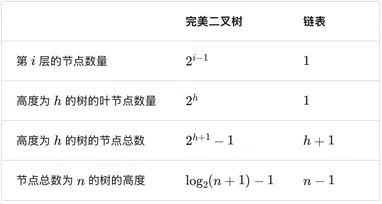
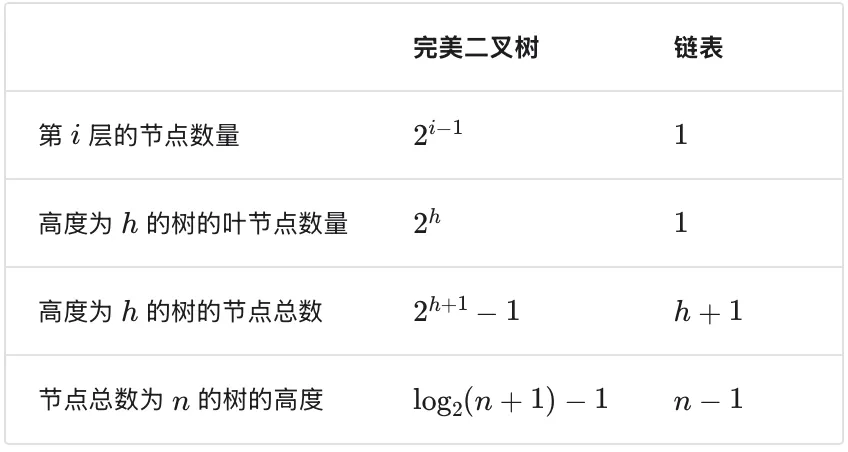
叶节点的度为 0,其余所有节点的度都为 2;若树的高度为 h,则节点总数为 2^h+1^-1,呈现标准的指数级关系
-
完全二叉树仅允许最底层的节点不完全填满,且最底层的节点必须从左至右依次连续填充
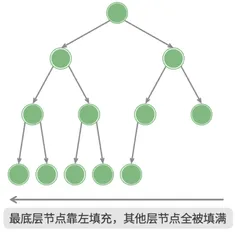
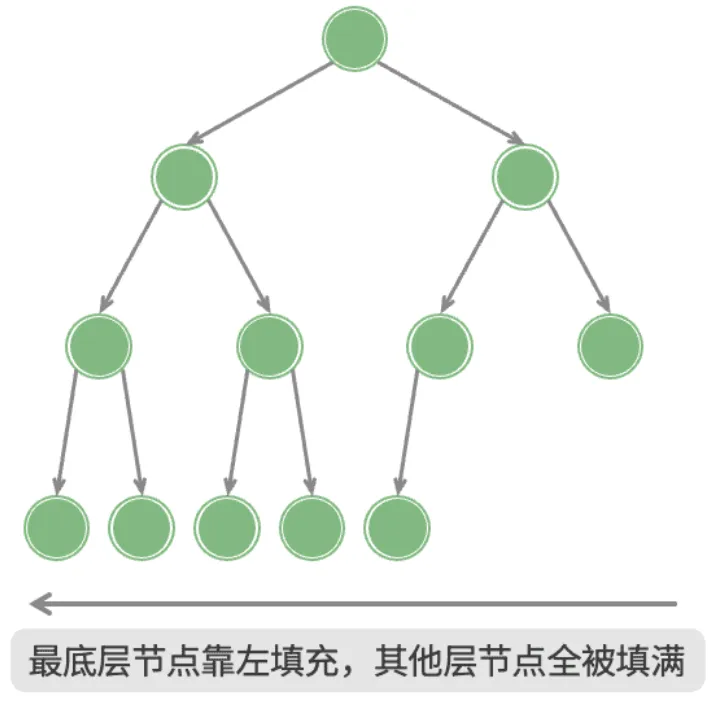
-
完满二叉树除了叶节点之外,其余所有节点都有两个子节点
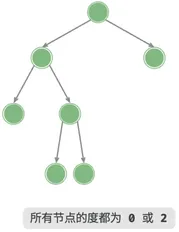
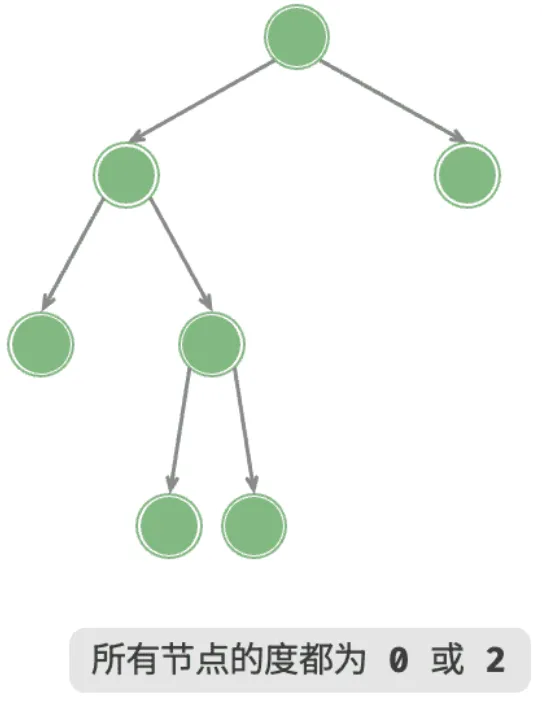
-
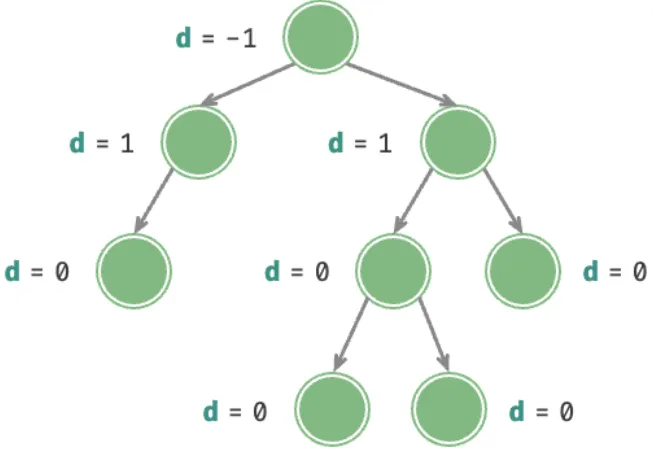
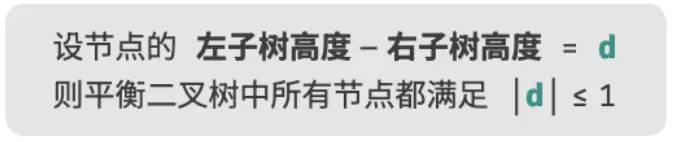
平衡二叉树中任意节点的左子树和右子树的高度之差的绝对值不超过1
二叉树的存储方式#
1、链式存储
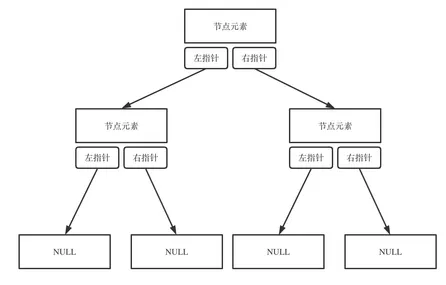
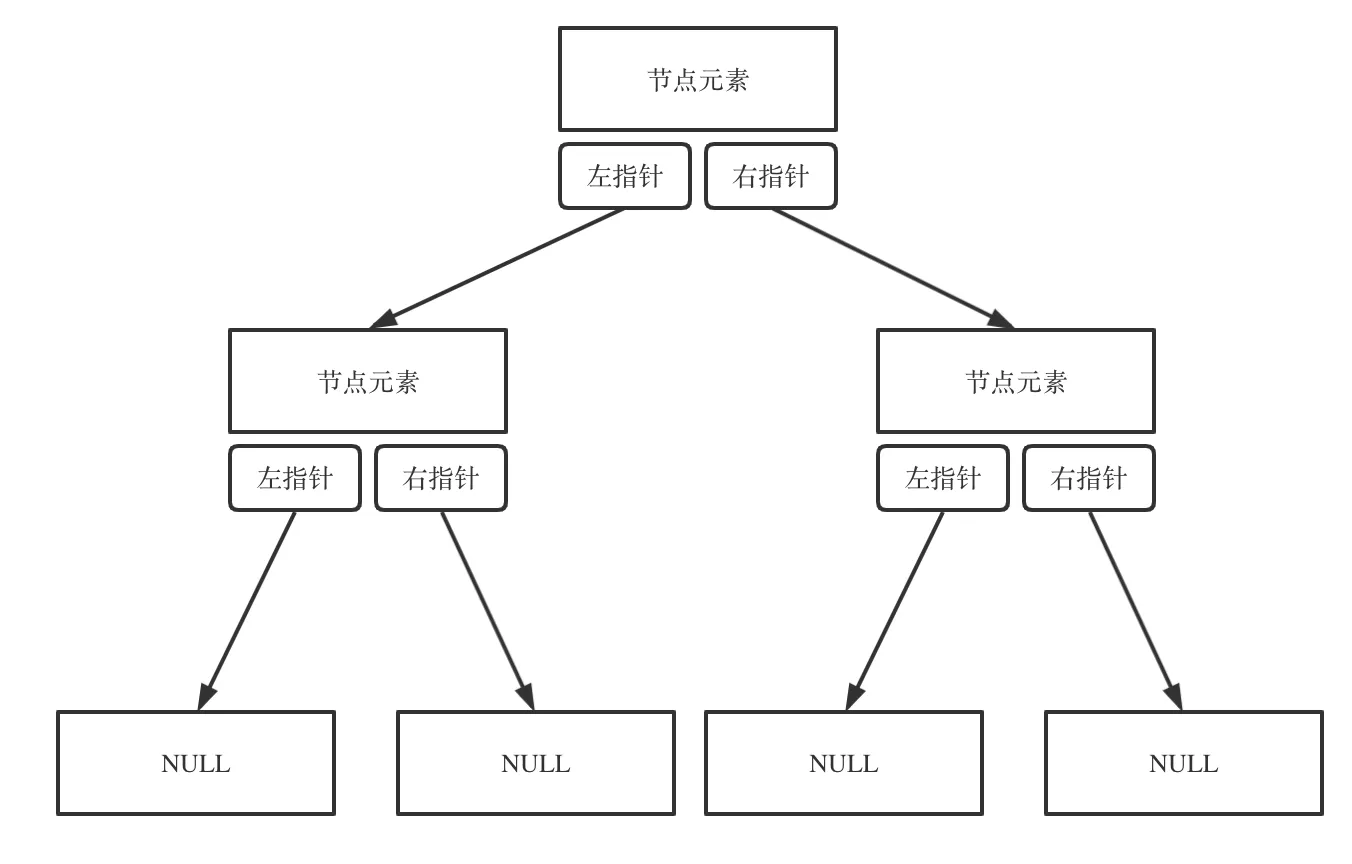
2、数组存储
(1)存储完美二叉树
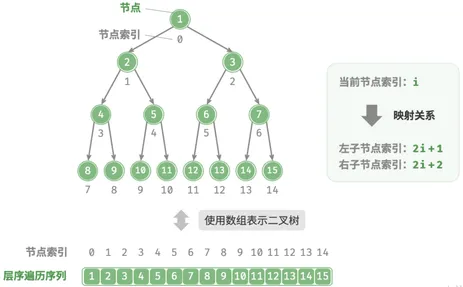
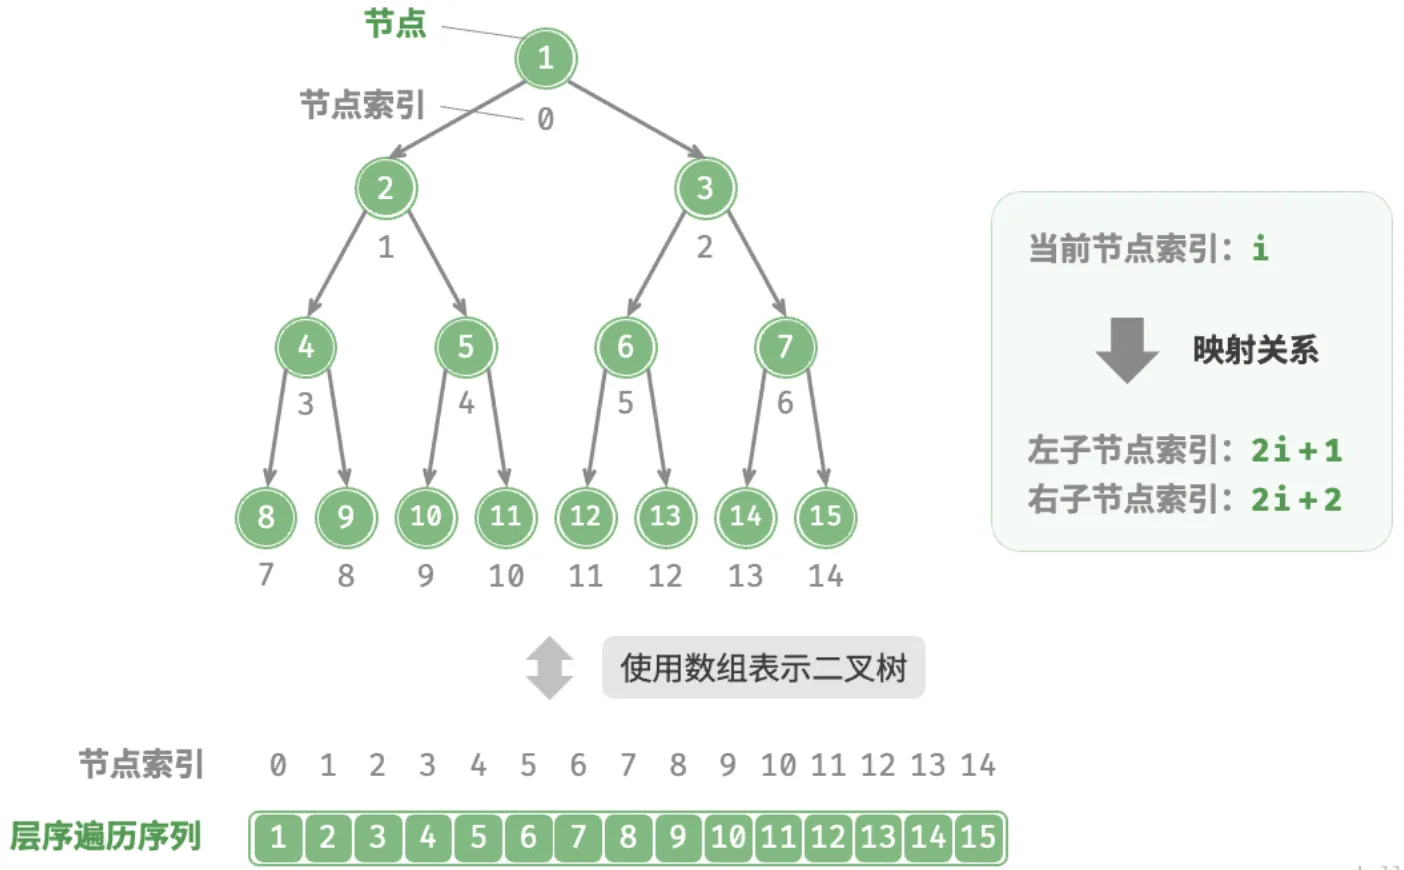
(2)存储任意二叉树:完美二叉树是一个特例,在二叉树的中间层通常存在许多 None 。由于层序遍历序列并不包含这些 None ,因此我们无法仅凭该序列来推测 None 的数量和分布位置。这意味着存在多种二叉树结构都符合该层序遍历序列
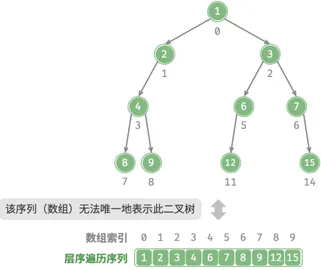
为了解决此问题,我们可以考虑在层序遍历序列中显式地写出所有 None
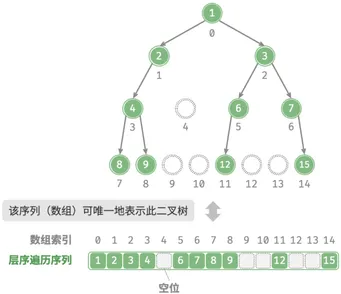
值得说明的是,完全二叉树非常适合使用数组来表示,所有 None 一定出现在层序遍历序列的末尾
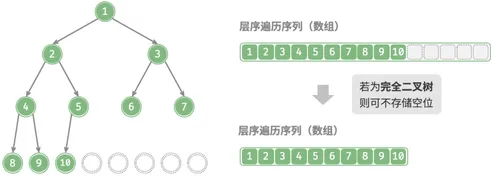
二叉树的遍历方式#
DFS深度优先搜素—简 144二叉树的前序遍历、【🔥简】94二叉树的中序遍历、简 145二叉树的后续遍历#
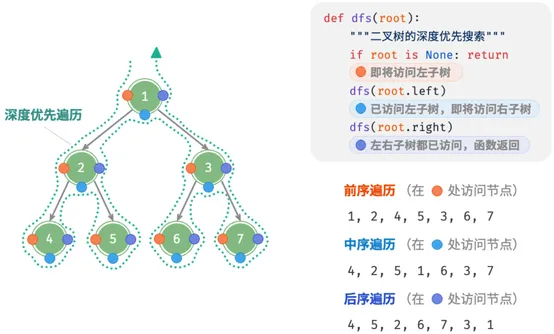
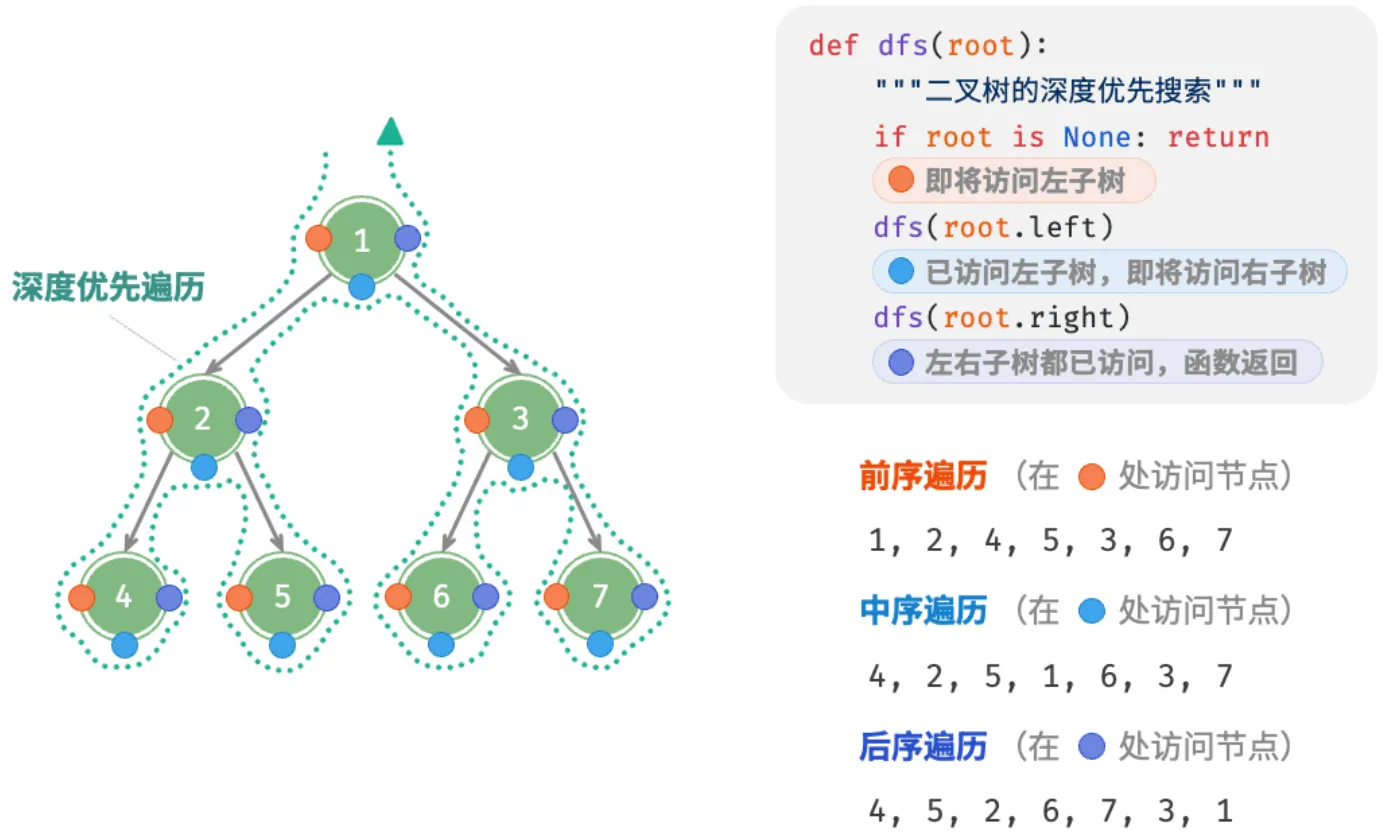
- 时间复杂度为:所有节点被访问一次,使用 O(n) 时间
- 空间复杂度为:在最差情况下,即树退化为链表时,递归深度达到 ,系统占用 O(n) 栈帧空间
前序:根节点-左节点-右节点
中序:左节点-根节点-右节点
后序:左节点-右节点-根节点
/* 前序遍历 */public List<Integer> preorderTraversal(TreeNode root) {    List<Integer> res = new ArrayList<>();    preorder(root,res);    return res;}// 使用一个辅助方法,传递同一个列表对象,避免每次递归 new ArrayList 和 addAll 的性能开销public void preorder(TreeNode root,List<Integer> res){    if(root == null) return;    res.add(root.val);    preorder(root.left, res);    preorder(root.right, res);}
/* 中序遍历 */public List<Integer> inorderTraversal(TreeNode root) {    List<Integer> res = new ArrayList<>();    inorder(root, res);    return res;}public void inorder(TreeNode root, List<Integer> res) {    if (root == null)        return;    inorder(root.left, res);    res.add(root.val);    inorder(root.right, res);}
/* 后序遍历 */public List<Integer> postorderTraversal(TreeNode root) { List<Integer> res = new ArrayList<>(); postorder(root, res); return res;}public void postorder(TreeNode root, List<Integer> res){ if(root == null) return; postorder(root.left, res); postorder(root.right, res); res.add(root.val);}BFS广度优先搜索—【🔥中】102迭代实现层序遍历#
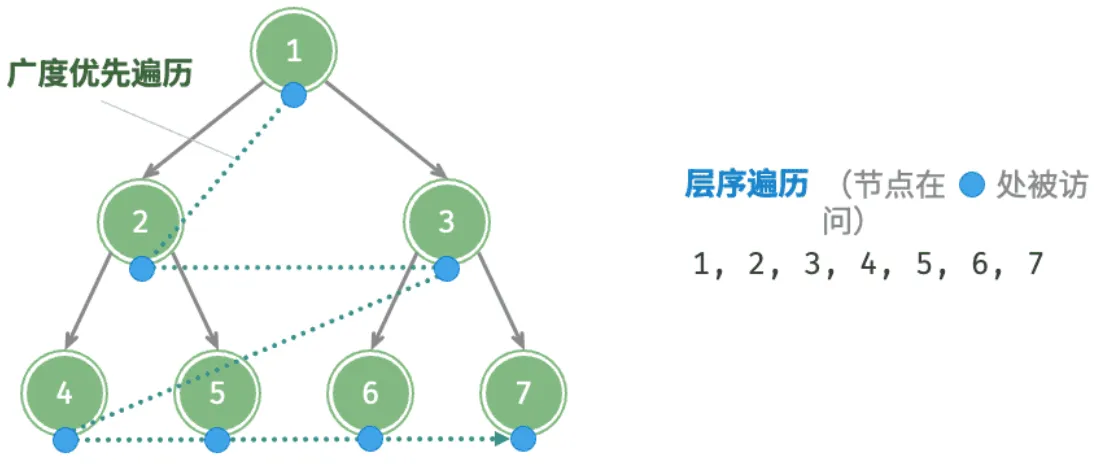
- 时间复杂度为:所有节点被访问一次,使用 O(n) 时间,其中 n 为节点数量
- 空间复杂度为:在最差情况下,即满二叉树时,遍历到最底层之前,队列中最多同时存在 (n+1)/2 个节点,占用 O(n) 空间
广度优先遍历通常借助“队列”来实现。队列遵循“先进先出”的规则,而广度优先遍历则遵循“逐层推进”的规则,两者背后的思想是一致的
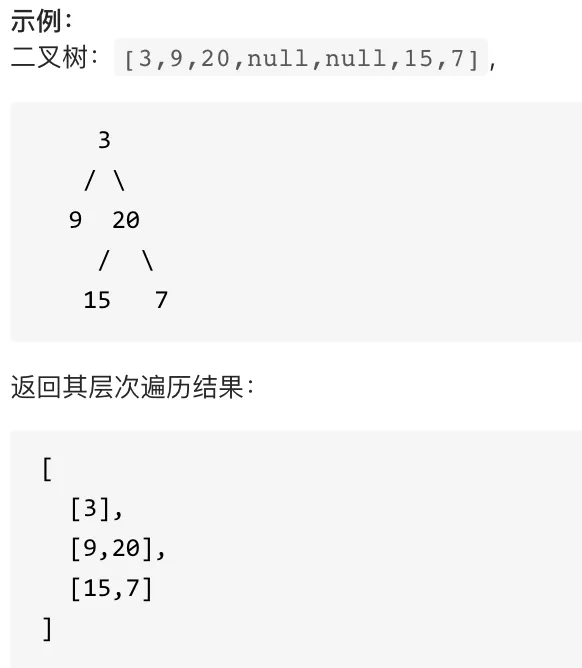
/* 层序遍历 */List<Integer> levelOrder(TreeNode root) { // 初始化队列,加入根节点 Queue<TreeNode> queue = new LinkedList<>(); queue.add(root); // 初始化一个列表,用于保存遍历序列 List<Integer> list = new ArrayList<>(); while (!queue.isEmpty()) { TreeNode node = queue.poll(); // 队列出队 list.add(node.val); // 保存节点值 if (node.left != null) queue.offer(node.left); // 左子节点入队 if (node.right != null) queue.offer(node.right); // 右子节点入队 } return list;}102题目要求每层节点返回值要合并为一个数组:
class Solution {    public List<List<Integer>> levelOrder(TreeNode root) {        List<List<Integer>> res = new ArrayList<>();        order(root, res);        return res;    }
    public void order(TreeNode root, List<List<Integer>> res) {        if (root == null) return;        Queue<TreeNode> que = new LinkedList<TreeNode>();        que.offer(root);
        while (!que.isEmpty()) {            // 【关键】获取当前层的节点数,实现分层            int size = que.size();            List<Integer> currentLevel = new ArrayList<>();
            for (int i = 0; i < size; i++) {                TreeNode node = que.poll();                // 将值添加到“当前层”的列表,而不是直接添加到 res                currentLevel.add(node.val);
if (node.left != null) que.offer(node.left); if (node.right != null) que.offer(node.right); } // 将“当前层”的列表添加到总结果 res 中 res.add(currentLevel); } }}迭代实现前中后序遍历#
递归的实现就是:每一次递归调用都会把函数的局部变量、参数值和返回地址等压入调用栈中,然后递归返回的时候,从栈顶弹出上一次递归的各项参数,这就是递归为什么可以返回上一层位置的原因。所以显然用栈也可以实现二叉树的前后中序遍历
1、前序遍历是中左右,每次先处理的是中间节点,那么先将根节点放入栈中,然后将右孩子加入栈,再加入左孩子(注意代码中空节点不入栈)
为什么要先加入右孩子,再加入左孩子呢? 因为这样出栈的时候才是中左右的顺序,动画如下:
循环迭代过程:每次将一个节点出栈,放入结果数组,如果其左右子节点不为空,则按先右后左入栈
// 前序遍历(迭代)顺序:中-左-右,入栈顺序:中-右-左class Solution { public List<Integer> preorderTraversal(TreeNode root) { List<Integer> result = new ArrayList<>(); if (root == null){ return result; } Stack<TreeNode> stack = new Stack<>(); stack.push(root); while (!stack.isEmpty()){ TreeNode node = stack.pop(); result.add(node.val); if (node.right != null){ stack.push(node.right); } if (node.left != null){ stack.push(node.left); } } return result; }}2、前序遍历的逻辑无法直接应用到中序遍历上
这是因为在迭代的过程中,其实有两个操作:
- 处理:将元素放进result数组中
- 访问:遍历节点
前序遍历中访问节点(遍历节点)和处理节点(将元素放进result数组中)可以同步处理,但是中序无法做到同步!
前序遍历的顺序是中左右,先访问的元素是中间节点,要处理的元素也是中间节点,所以要访问的元素和要处理的元素顺序是一致的,都是中间节点
中序遍历是左中右,先访问的是二叉树顶部的节点,然后一层一层向下访问,直到到达树左面的最底部,再开始处理节点(也就是在把节点的数值放进result数组中),这就造成了处理顺序和访问顺序是不一致的
用迭代实现中序遍历,需要借用指针的遍历来帮助访问节点,栈则用来处理节点上的元素,动画如下:
循环迭代过程:每次只要cur指向节点不为null,就将节点入栈;否则只要栈内不为空,将一个节点出栈并放入结果数组,再将该节点的右子节点入栈
// 中序遍历(迭代)顺序: 左-中-右,入栈顺序:左-右class Solution { public List<Integer> inorderTraversal(TreeNode root) { List<Integer> result = new ArrayList<>(); if (root == null){ return result; } Stack<TreeNode> stack = new Stack<>(); TreeNode cur = root; while (cur != null || !stack.isEmpty()){ if (cur != null){ stack.push(cur); cur = cur.left; }else{ cur = stack.pop(); result.add(cur.val); cur = cur.right; } } return result; }}3、后序遍历是左右中,只需要调整一下先序遍历的代码顺序,再反转result数组,输出的结果顺序就是左右中了,如下图:
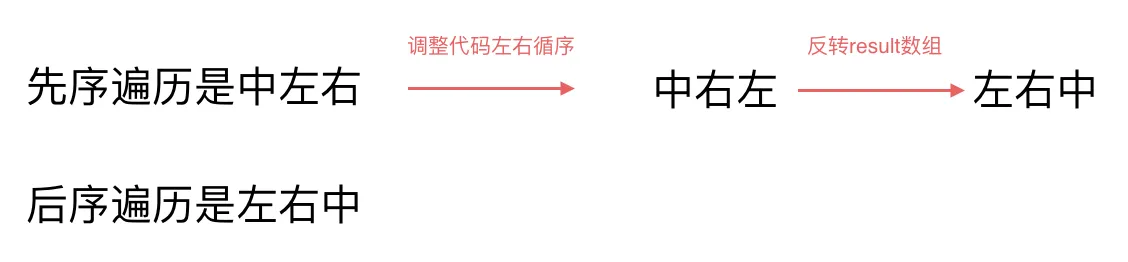
// 后序遍历(迭代)顺序:左-右-中,入栈顺序:中-左-右,出栈顺序:中-右-左,最后翻转结果class Solution { public List<Integer> postorderTraversal(TreeNode root) { List<Integer> result = new ArrayList<>(); if (root == null){ return result; } Stack<TreeNode> stack = new Stack<>(); stack.push(root); while (!stack.isEmpty()){ TreeNode node = stack.pop(); result.add(node.val); if (node.left != null){ stack.push(node.left); } if (node.right != null){ stack.push(node.right); } } Collections.reverse(result); return result; }}【🔥简】226翻转二叉树(递归实现前/后序遍历)#
给你一棵二叉树的根节点
root,翻转这棵二叉树,并返回其根节点。
只要把每一个节点的左右孩子翻转一下,就可以达到整体翻转的效果,从上往下或者从下往上都能实现,因此前后序遍历都可以
前序遍历的动画:
递归三部曲:
1、确定递归函数的参数和返回值
TreeNode* invertTree(TreeNode* root)2、确定终止条件
if (root == NULL) return root;3、确定单层递归的逻辑
因为是前序遍历,所以先交换左右孩子节点,然后反转左子树,反转右子树
// 递归实现前序遍历class Solution { public TreeNode invertTree(TreeNode root) { if (root == null) { return null; } swap(root); invertTree(root.left); invertTree(root.right); return root; } private void swap(TreeNode root) { TreeNode tmp = root.left; root.left = root.right; root.right = tmp; }}// 后序遍历也行invertTree(root.left);invertTree(root.right);swap(root);【🔥简】101对称二叉树 (递归实现后序遍历的变形)#
给你一个二叉树的根节点
root, 检查它是否轴对称。
比较的是两个子树的里侧和外侧的元素是否相等,如图所示:
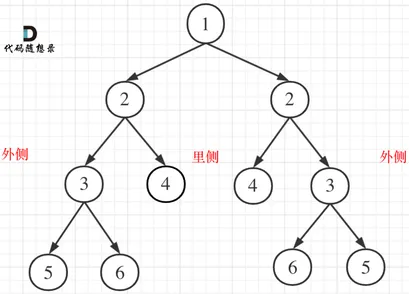
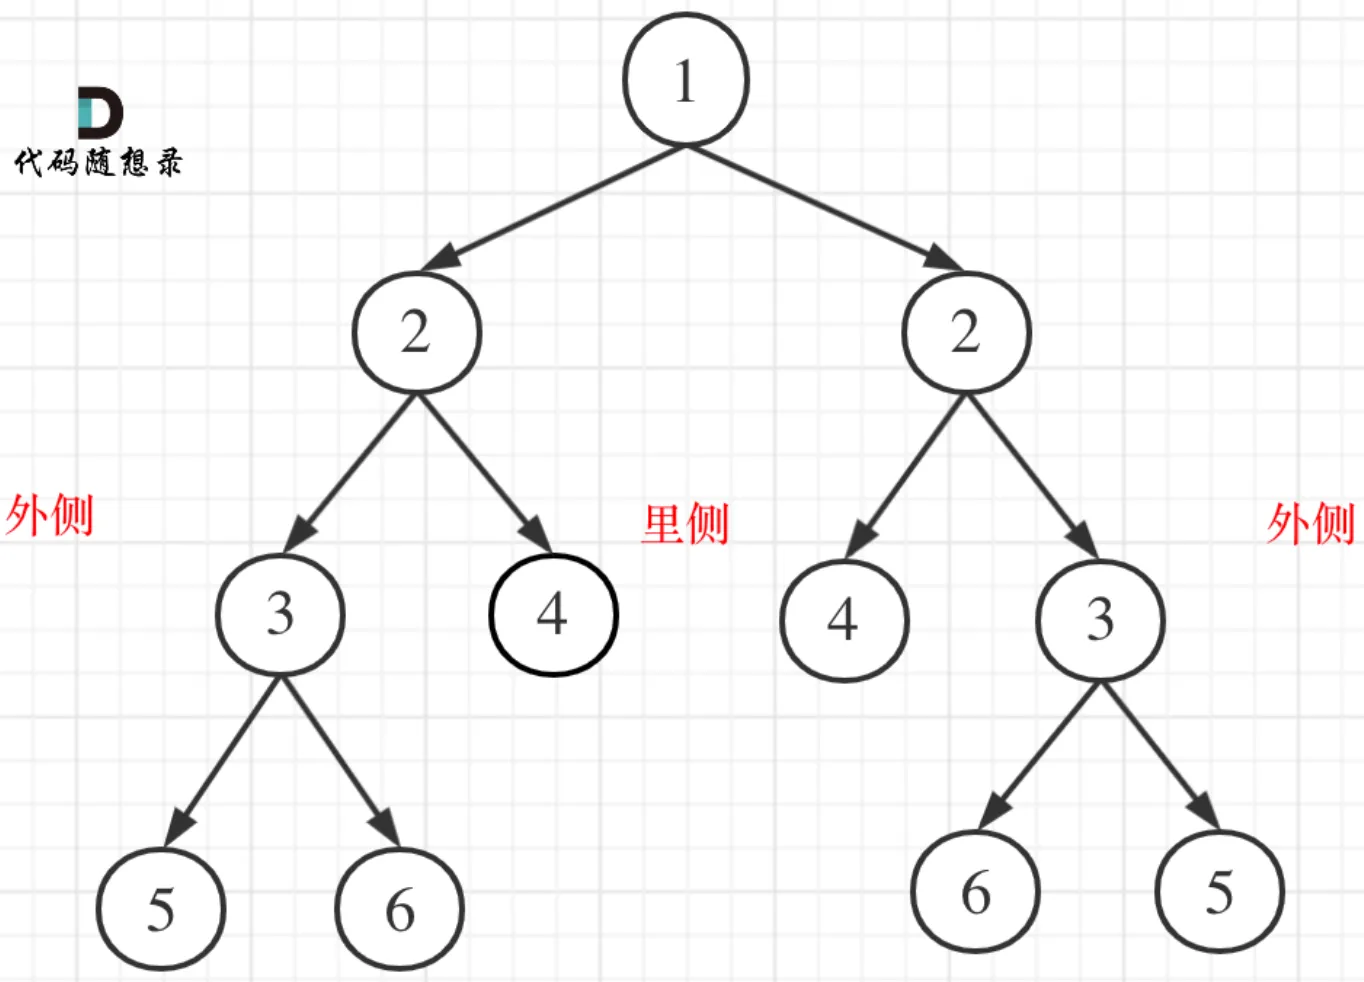
本题只能“后序遍历”,因为我们要通过递归函数的返回值来判断两个子树的内侧节点和外侧节点是否相等
因为要遍历两棵树并比较各自的内侧和外侧节点,所以准确的来说是一个树的遍历顺序是左右中,一个树的遍历顺序是右左中
递归三部曲:
1、确定递归函数的参数和返回值
因为要比较的是根节点的两个子树是否是相互翻转的,进而判断这个树是不是对称树,所以参数是左子树节点和右子树节点,返回值是bool类型
bool compare(TreeNode* left, TreeNode* right)2、确定终止条件
要比较两个节点数值相不相同,首先要把两个节点为空的情况弄清楚!否则后面比较数值的时候就会操作空指针了
节点为空的情况有:
- 左/右节点为空,右/左节点不为空,不对称,返回false
- 左右都为空,对称,返回true
此时已经排除掉了节点为空的情况,那么剩下的就是左右节点不为空:
- 左右都不为空,比较节点数值,不相同就返回false
if (left == NULL && right != NULL) return false;else if (left != NULL && right == NULL) return false;else if (left == NULL && right == NULL) return true;else if (left->val != right->val) return false; // 注意这里我没有使用else把以上情况都排除之后,剩下的就是左右节点都不为空,且数值相同的情况,需要继续递归才能得到返回的值
3、确定单层递归的逻辑
- 比较二叉树外侧是否对称:传入的是左节点的左孩子,右节点的右孩子
- 比较内侧是否对称,传入左节点的右孩子,右节点的左孩子
- 如果左右都对称就返回true ,有一侧不对称就返回false
// 后序遍历(递归)的变形public boolean isSymmetric(TreeNode root) {    return compare(root.left, root.right);}
private boolean compare(TreeNode left, TreeNode right) {    if (left == null && right != null) {        return false;    }    if (left != null && right == null) {        return false;    }    if (left == null && right == null) {        return true;    }    if (left.val != right.val) {        return false;    }
    // 可以看出使用的遍历方式,左子树左右中,右子树右左中    // 1、比较外侧    // 左子树:左、 右子树:右    boolean compareOutside = compare(left.left, right.right);
    // 2、比较内侧    // 左子树:右、 右子树:左    boolean compareInside = compare(left.right, right.left);
// 3、逻辑处理 // 左子树:中、 右子树:中 return compareOutside && compareInside;}【🔥简】104二叉树的最大深度 (递归实现前/后序遍历)#
给定一个二叉树
root,返回其最大深度。二叉树的 最大深度 是指从根节点到最远叶子节点的最长路径上的节点数。
- 求深度 = 自上而下的信息传递
- 父节点知道深度 -> 告诉子节点
- 用前序遍历(中->左->右):在访问子节点前,父节点已经把深度算好传下去了,正好用上
- 求高度 = 自下而上的信息汇总
- 子节点算出高度 -> 汇报给父节点
- 用后序遍历(左->右->中):必须等左右子树都汇报完毕,父节点才能汇总计算自己的高度
求深度用前序遍历(递归),但是这里求的是二叉树的最大深度,也就等于二叉树的高度所以也可以用后续遍历(递归)
// 求深度用前序遍历(递归)class Solution {    // 定义一个成员变量或全局变量来记录最大深度    private int maxD = 0;
    public int maxDepth(TreeNode root) {        // 重置最大深度,防止多次调用受影响        maxD = 0;        // 【中】:从根节点开始,当前深度为 1        // 调用辅助函数,传入当前节点和当前深度        preorder(root, 1);        return maxD;    }
    // 辅助函数:前序遍历 (中 -> 左 -> 右)    // node: 当前节点    // depth: 当前节点的深度 (从父节点传下来的)    private void preorder(TreeNode node, int depth) {        if (node == null) {            return;        }        // 【中】:处理当前节点        // 在进入子节点之前,先利用当前深度更新全局最大深度        maxD = depth > maxD ? depth : maxD;        // 【左】:遍历左子树,深度 + 1        preorder(node.left, depth + 1);        // 【右】:遍历右子树,深度 + 1        preorder(node.right, depth + 1);    }}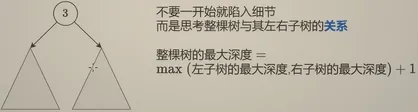
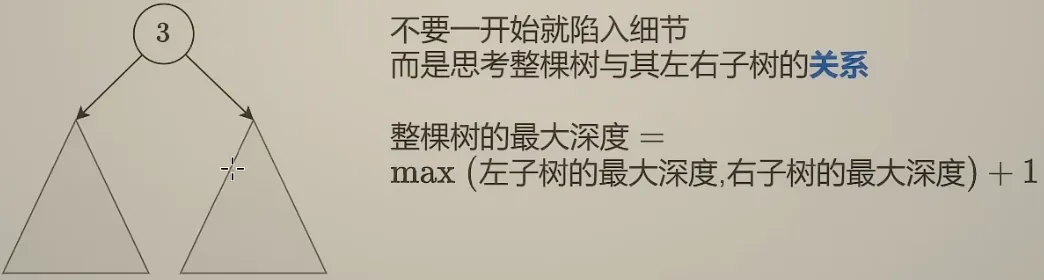
// 后序遍历(递归)class Solution { public int maxDepth(TreeNode root) { if(root == null) return 0; // 空节点 (null) 代表没有层数,所以返回 0 int left = maxDepth(root.left); int right = maxDepth(root.right); return left>right ? left+1 :right+1; }}简 111二叉树的最小深度(递归实现后序遍历)#
给定一个二叉树,找出其最小深度。
最小深度是从根节点到最近叶子节点的最短路径上的节点数量。
递归三部曲:
1、确定递归函数的参数和返回值:参数为要传入的二叉树根节点,返回的是int类型的深度
int getDepth(TreeNode* node)2、确定终止条件:遇到空节点返回0,表示当前节点的高度为0
if (node == NULL) return 0;3、确定单层递归的逻辑,遍历的顺序为后序(左右中)
求二叉树的最小深度和求二叉树的最大深度的差别主要在于处理左右分支子树为空的逻辑,从而避免下图中的误区:
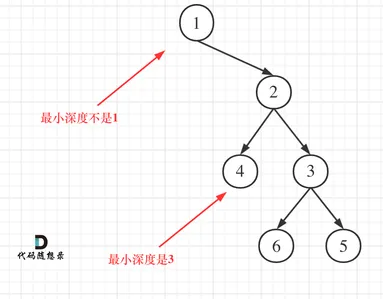
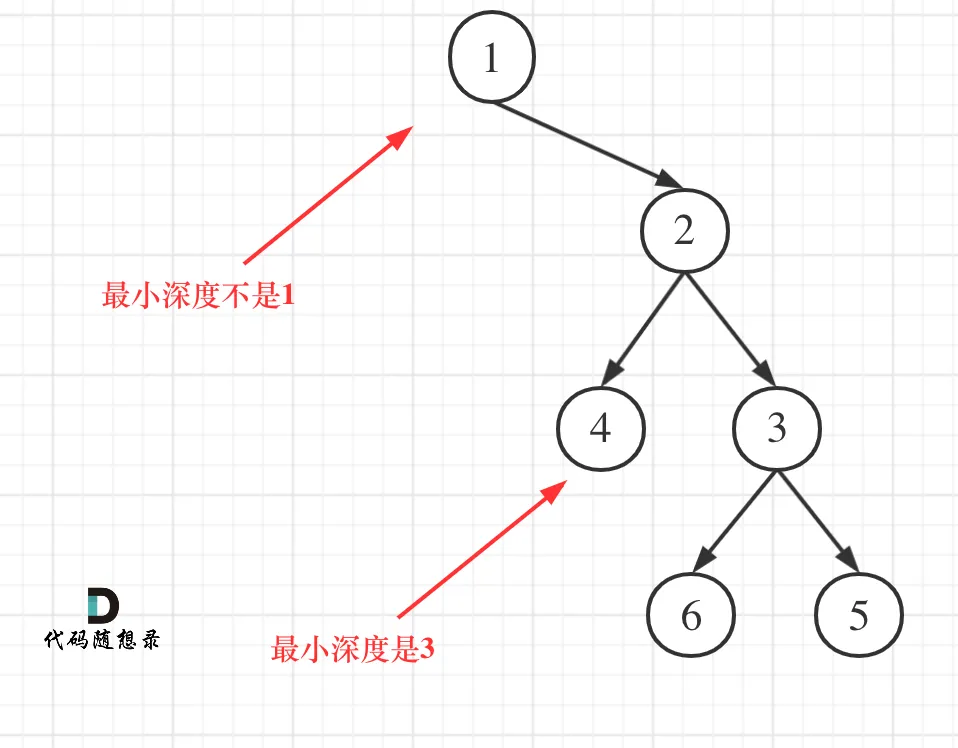
- 考虑没有左/右分支子树的情况,最小深度是 1 + 右/左子树的深度
- 如果左右子树都不为空,返回左右子树深度最小值 + 1
// 后序遍历(递归),比求最大深度复杂一些class Solution { public int minDepth(TreeNode root) { if (root == null) { return 0; } int leftDepth = minDepth(root.left); int rightDepth = minDepth(root.right); if (root.left == null) { return rightDepth + 1; } if (root.right == null) { return leftDepth + 1; } // 左右结点都不为null return Math.min(leftDepth, rightDepth) + 1; }}简 222完全二叉树的节点个数(递归实现后序遍历)#
给你一棵 完全二叉树 的根节点
root,求出该树的节点个数。
按照普通二叉树的逻辑来求
1、递归法和求二叉树的深度写法类似
单层递归的逻辑:先求它的左子树的节点数量,再求右子树的节点数量,最后取总和再加一 (加1是因为算上当前中间节点)就是目前节点为根节点的节点数量
// 通用后序递归遍历解法public int countNodes(TreeNode root) { if(root == null) { return 0; } int leftNum = countNodes(root.left); // 左 int rightNum = countNodes(root.right); // 右 return leftNum + rightNum + 1; // 中}2、迭代法,修改一下层序遍历模板,记录遍历的节点数量即可
// 层序遍历迭代法public int countNodes(TreeNode root) { if(root == null) return 0; // 初始化队列,加入根节点 Queue<TreeNode> queue = new LinkedList<>(); queue.add(root); int sum = 0; while (!queue.isEmpty()) { TreeNode node = queue.poll(); // 队列出队 sum++; if (node.left != null) queue.offer(node.left); // 左子节点入队 if (node.right != null) queue.offer(node.right); // 右子节点入队 } return sum;}简 110平衡二叉树(递归实现后序遍历)#
给定一个二叉树,判断它是否是 平衡二叉树。
既然要求比较高度,必然是要后序遍历
1、明确递归函数的参数和返回值
参数为当前传入节点, 返回值为以当前传入节点为根节点的树的高度。如果已经不是二叉平衡树了,可以返回-1 来标记不符合平衡树的规则
// -1 表示已经不是平衡二叉树了,否则返回值是以该节点为根节点树的高度int getHeight(TreeNode* node)2、明确终止条件
if (node == NULL) { return 0;}3、明确单层递归的逻辑
如何判断以当前传入节点为根节点的二叉树是否是平衡二叉树呢?
分别求出其左右子树的高度,比较其左子树高度和其右子树高度的差值,如果差值小于等于1,则返回当前二叉树的高度;否则返回-1,表示不是二叉平衡树
注意:必须在获取到子树返回值后,立刻检查是否为 -1。如果是,直接向上抛出 -1,不再参与后续的左右子树高度比较
// 后序遍历(递归)class Solution {    public boolean isBalanced(TreeNode root) {        return dfs(root) != -1;    }
    public int dfs(TreeNode root) {        if (root == null) {            return 0;        }        int leftHeight = dfs(root.left);        // 【⚠️容易遗漏】必须在获取到子树返回值后,立刻检查是否为 -1。如果是,直接向上抛出 -1,不再参与后续的左右子树高度比较        if (leftHeight == -1) {            return -1;        }        int rightHeight = dfs(root.right);        if (rightHeight == -1) {            return -1;        }        // 左右子树高度差大于1,return -1表示已经不是平衡树了        if (Math.abs(leftHeight - rightHeight) > 1) {            return -1;        }        return Math.max(leftHeight, rightHeight) + 1;    }}
简 404左叶子之和(递归实现前/后序遍历)#
给定二叉树的根节点
root,返回所有左叶子之和。
判断当前节点是不是左叶子必须要通过节点的父节点
如果某节点的左节点不为空,且该节点的左节点的左节点为空,该节点的左节点的右节点为空,则该节点的左节点就是一个左叶子,判断代码如下:
if (node.left != NULL && node.left.left == NULL && node.left.right == NULL) { // 左叶子节点处理逻辑}递归三部曲:
1、确定递归函数的参数和返回值
2、确定终止条件
if (root == NULL) return 0;if (root->left == NULL && root->right== NULL) return 0; //其实这个也可以不写,不影响结果,只会让递归多进行一层3、确定单层递归的逻辑
前序或者后序遍历都行,如果是前序,先判断根节点作为父节点有无左叶子节点,将对应的值递归加上左子树和右子树的左叶子之和
// 前序遍历(递归)public int sumOfLeftLeaves(TreeNode root) { if (root == null) return 0; int midValue = 0; if (root.left != null && root.left.left == null && root.left.right == null) { midValue = root.left.val; } int sum = midValue + sumOfLeftLeaves(root.left) + sumOfLeftLeaves(root.right); // 中左右 return sum;}中 513找树左下角的值(迭代实现bfs/递归实现dfs)#
给定一个二叉树的 根节点
root,请找出该二叉树的 最底层 最左边 节点的值。假设二叉树中至少有一个节点。
法一、最直观的就是用迭代,得到最后一层的第一个节点
// 层序遍历(迭代)public int findBottomLeftValue(TreeNode root) { Queue<TreeNode> queue = new LinkedList<>(); queue.offer(root); int res = 0; while (!queue.isEmpty()) { int size = queue.size(); for (int i = 0; i < size; i++) { TreeNode poll = queue.poll(); if (i == 0) { res = poll.val; } if (poll.left != null) { queue.offer(poll.left); } if (poll.right != null) { queue.offer(poll.right); } } } return res;}法二、求深度,递归(+回溯)实现前序遍历
class Solution {    private int Deep = -1;    private int value = 0;    public int findBottomLeftValue(TreeNode root) {        value = root.val;        findValue(root,0);        return value;    }
    private void findValue (TreeNode root,int deep) {        if (root == null) return;        if (root.left == null && root.right == null) {            if (deep > Deep) {                value = root.val;                Deep = deep;            }        }        if (root.left != null) findValue(root.left, deep + 1); // 这里的deep+1用到了回溯        if (root.right != null) findValue(root.right, deep + 1); // 同理    }}
简 112路径总和(递归实现前序遍历)#
给你二叉树的根节点
root和一个表示目标和的整数targetSum。判断该树中是否存在 根节点到叶子节点 的路径,这条路径上所有节点值相加等于目标和targetSum。如果存在,返回true;否则,返回false。
1、确定递归函数的参数和返回类型
参数:需要二叉树的根节点,还需要一个计数器,这个计数器用来计算二叉树的一条边之和是否正好是目标和
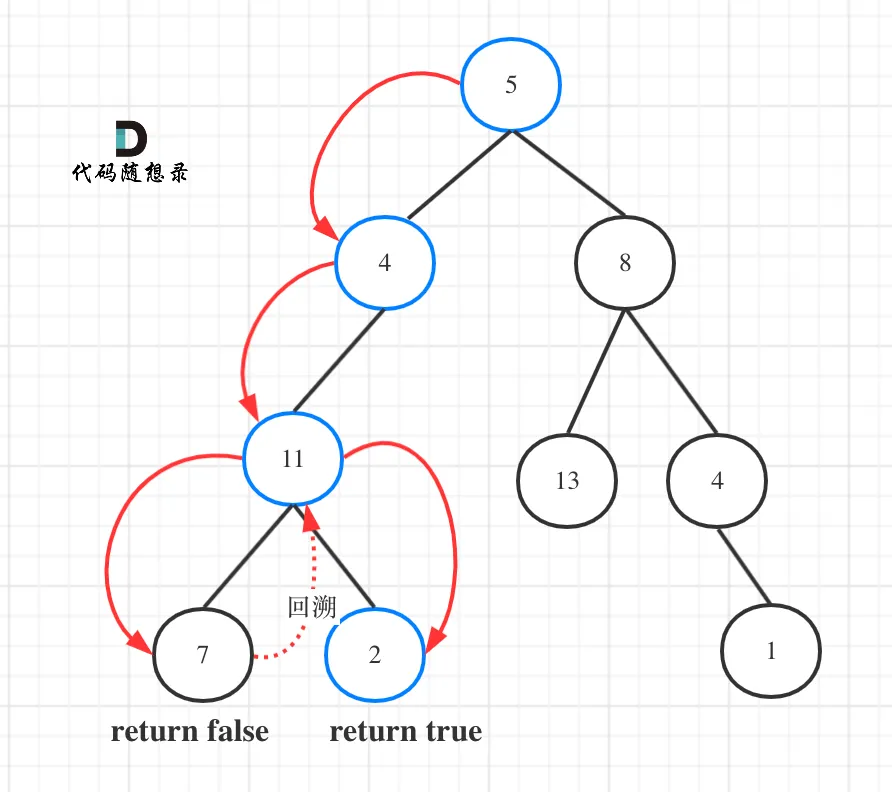
图中可以看出,遍历的路线,并不要遍历整棵树,当找到符合条件的路径时递归函数需要及时返回,可以用bool类型表示
public boolean hasPathSum(TreeNode root, int targetSum)2、确定终止条件
让计数器count初始为目标和,然后每次减去遍历路径节点上的数值,如果最后 count == 0,同时到了叶子节点的话,说明找到了目标和;如果遍历到了叶子节点,count不为0,就是没找到
if(cur == null) return false;if (!cur.left && !cur.right && count == 0) return true; // 遇到叶子节点,并且计数为0if (!cur.left && !cur.right) return false; // 遇到叶子节点而没有找到合适的边,直接返回3、确定单层递归的逻辑
递归函数是有返回值的,如果递归函数返回true,说明找到了合适的路径,应该立刻返回
// 左// 遇到叶子节点返回true,则直接返回trueif (traversal(cur.left, count - cur.left.val)) return true; // 回溯
// 右// 遇到叶子节点返回true,则直接返回trueif (traversal(cur.right, count - cur.right.val)) return true; // 回溯
return false;
以上代码中包含着回溯,没有回溯,就无法后撤重新找另一条路径
回溯隐藏在 traversal(cur->left, count - cur->left->val), 因为把 count - cur->left->val 直接作为参数传进去,函数结束,count的数值没有改变
为了把回溯的过程体现出来,可以改为如下代码:
// 左count -= cur.left.val; // 递归,处理节点;if (traversal(cur.left, count)) return true;count += cur.left.val; // 回溯,撤销处理结果
// 右count -= cur.right.val;if (traversal(cur.right, count)) return true;count += cur.right.val;
return false;
精简后的代码:
// 前序遍历(递归)public boolean hasPathSum(TreeNode root, int targetSum) { if (root == null) return false; // 为空退出 // 叶子节点判断是否符合 if (root.left == null && root.right == null) return root.val == targetSum; // 求两侧分支的路径和 return hasPathSum(root.left, targetSum - root.val) || hasPathSum(root.right, targetSum - root.val);}【🔥中】199二叉树的右视图(递归实现前序遍历/迭代实现bfs)#
给定一个二叉树的 根节点
root,想象自己站在它的右侧,按照从顶部到底部的顺序,返回从右侧所能看到的节点值。
// 前序遍历(递归)class Solution {    public List<Integer> rightSideView(TreeNode root) {        List<Integer> res = new ArrayList<>();        dfs(root, 0, res);        return res;    }
    private void dfs(TreeNode root, int depth, List<Integer> res) {        if (root == null) return;        if (depth == res.size()) // 这个深度首次遇到            res.add(root.val);        dfs(root.right, depth + 1, res); // 先递归右子树,保证首次遇到的一定是最右边的节点        dfs(root.left, depth + 1, res);    }}
// 迭代实现BFSclass Solution { public List<Integer> rightSideView(TreeNode root) { List<Integer> res = new ArrayList<>(); if (root == null) { return res; } // 1. 初始化队列,将根节点入队 Queue<TreeNode> queue = new LinkedList<>(); queue.offer(root); while (!queue.isEmpty()) { // 2. 获取当前层的节点数量 int size = queue.size(); // 3. 遍历当前层的所有节点 for (int i = 0; i < size; i++) { TreeNode node = queue.poll(); // 出队 // 4. 如果是当前层的最后一个节点,加入结果集 if (i == size - 1) { res.add(node.val); } // 5. 将下一层的子节点入队 (先左后右,保证顺序) if (node.left != null) { queue.offer(node.left); } if (node.right != null) { queue.offer(node.right); } } } return res; }}【🔥简】543二叉树的直径(递归实现后序遍历)#
给你一棵二叉树的根节点,返回该树的 直径 。
二叉树的 直径 是指树中任意两个节点之间最长路径的 长度 。这条路径可能经过也可能不经过根节点
root。两节点之间路径的 长度 由它们之间边数表示。
给定任意一个根节点,经过这个根节点的最长路径的长度是左子树的最大深度加右子树的最大深度,然后全局的最长路径不一定结果总树的root,但是总会经过某一个子树的跟姐,所以直接后序遍历所有根节点计算经过每个root的最长路径取max
// 后序遍历(递归)class Solution { int length = 0; // 路径长度 public int diameterOfBinaryTree(TreeNode root) { if(root==null) return -1; depth(root); return length; } public int depth(TreeNode node) { if (node == null) { return 0; // 访问到空节点了,返回0 } int L = depth(node.left); // 左儿子为根的子树的深度 int R = depth(node.right); // 右儿子为根的子树的深度 length = Math.max(length, L+R); // 计算该根节点的最大路径长度即L+R+1,更新length return Math.max(L, R) + 1; // 返回该节点为根的子树的深度 }}【🔥中】114二叉树展开为链表(递归实现前序遍历)#
给你二叉树的根结点
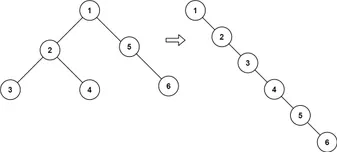
root,请你将它展开为一个单链表:
- 展开后的单链表应该同样使用
TreeNode,其中right子指针指向链表中下一个结点,而左子指针始终为null。- 展开后的单链表应该与二叉树 先序遍历 顺序相同。
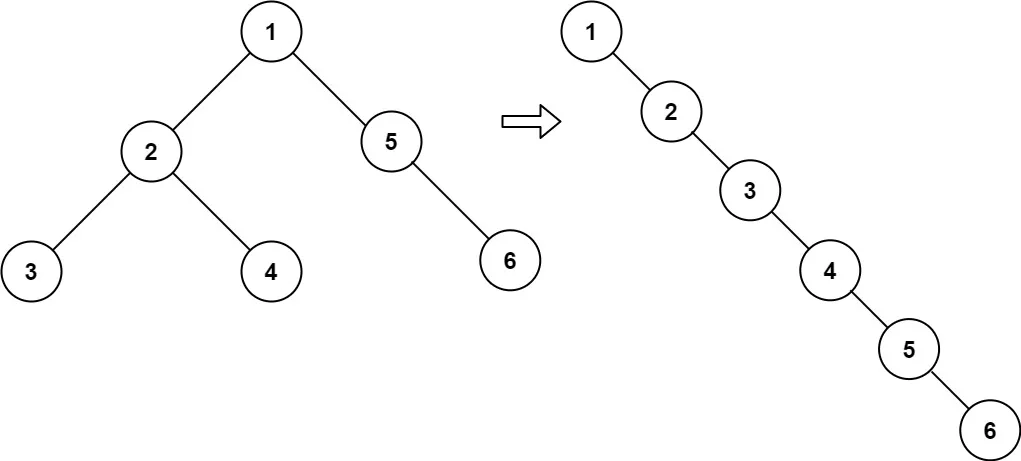
class Solution {    public void flatten(TreeNode root) {        List<TreeNode> list = new ArrayList<>();        preorderTraversal(root, list);        int size = list.size();        for (int i = 1; i < size; i++) {            TreeNode prev = list.get(i - 1), curr = list.get(i);            prev.left = null;            prev.right = curr;        }    }
    public void preorderTraversal(TreeNode root, List<TreeNode> list) {        if (root != null) {            list.add(root);            preorderTraversal(root.left, list);            preorderTraversal(root.right, list);        }    }}
中 106从中序与后序遍历序列构造二叉树、【🔥中】105从前序与中序遍历序列构造二叉树#
给定两个整数数组
inorder和postorder,其中inorder是二叉树的中序遍历,postorder是同一棵树的后序遍历,请你构造并返回这颗 二叉树 。
给定两个整数数组
preorder和inorder,其中preorder是二叉树的先序遍历,inorder是同一棵树的中序遍历,请构造二叉树并返回其根节点。
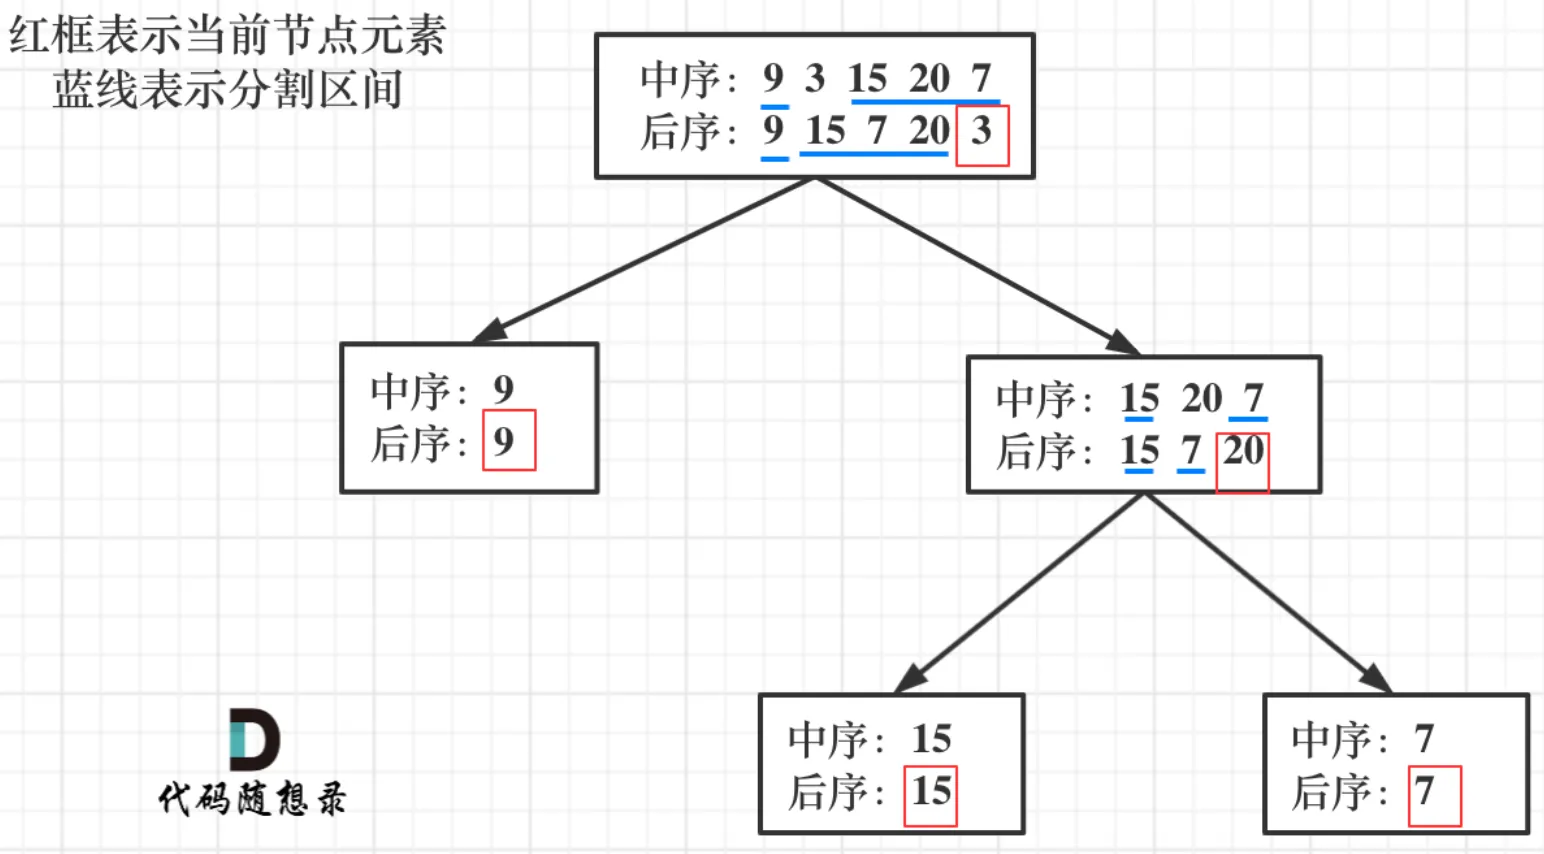
如何根据两个顺序构造一个唯一的二叉树:
- 如果数组大小为零的话,说明是空节点了
- 如果不为空,那么取后序数组最后一个元素作为节点元素
- 找到后序数组最后一个元素在中序数组的位置,作为切割点
- 切割中序数组,切成中序左数组和中序右数组 (顺序别搞反了,一定是先切中序数组)
- 切割后序数组,切成后序左数组和后序右数组
- 首先后序数组的最后一个元素不能要,这是切割点也是当前二叉树中间节点的元素
- 后序数组没有明确的切割元素来进行左右切割,而是按照左中序数组的大小来切割,切成左后序数组和右后序数组
- 递归处理左区间和右区间
难点:如何切割,以及注意边界值,这里统一用左闭右开的区间逻辑
import java.util.Arrays;class Solution {    public TreeNode buildTree(int[] inorder, int[] postorder) {        // 1. 如果数组为空或非法,返回 null        if (inorder.length == 0 || postorder.length ==0 || inorder.length != postorder.length) {            return null;        }
        // 2. 后序遍历数组最后一个元素,就是当前的中间节点(根节点)        int rootValue = postorder[postorder.length - 1];        TreeNode root = new TreeNode(rootValue);
        // 3. 叶子节点情况:如果只有一个元素,直接返回        if (postorder.length == 1) {            return root;        }
        // 4. 找到中序遍历的切割点        int delimiterIndex = 0;        for (; delimiterIndex < inorder.length; delimiterIndex++) {            if (inorder[delimiterIndex] == rootValue) {                break;            }        }
        // 5. 切割中序数组        // 左闭右开:[0, delimiterIndex)        int[] leftInorder = Arrays.copyOfRange(inorder, 0, delimiterIndex);        // [delimiterIndex + 1, end)        int[] rightInorder = Arrays.copyOfRange(inorder, delimiterIndex + 1, inorder.length);
        // 6. 切割后序数组        // 左子树的后序遍历:长度与左中序数组相同        // 范围:[0, leftInorder.length)        int[] leftPostorder = Arrays.copyOfRange(postorder, 0, leftInorder.length);
        // 右子树的后序遍历        // 范围:[leftInorder.length, postorder.length - 1)        // 注意:postorder.length - 1 是因为最后一个元素是根,已经被取出了        int[] rightPostorder = Arrays.copyOfRange(postorder, leftInorder.length, postorder.length - 1);
        // 7. 递归构建左右子树        root.left = buildTree(leftInorder, leftPostorder);        root.right = buildTree(rightInorder, rightPostorder);
return root; }}- 时间复杂度:O(N^2^),因为在每一层递归中,寻找根节点索引和复制数组都需要 O(N) 的时间,最坏情况下树退化为链表,深度为 N
- 空间复杂度:O(N^2^),主要用于存储递归过程中创建的大量子数组副本
如果需要优化到 O(N),通常使用哈希表记录中序遍历的索引,并通过传递数组下标范围而不是复制数组来实现
import java.util.HashMap;import java.util.Map;class Solution {    // 用于存储中序遍历中 "值 -> 索引" 的映射,以便 O(1) 时间找到根节点位置    private Map<Integer, Integer> inorderMap;    // 后序遍历数组,作为成员变量避免每次递归传递    private int[] postorderArr;
    public TreeNode buildTree(int[] inorder, int[] postorder) {        if (inorder.length == 0 || postorder.length == 0 || inorder.length != postorder.length) {            return null;        }
        // 1. 构建哈希表        inorderMap = new HashMap<>();        for (int i = 0; i < inorder.length; i++) {            inorderMap.put(inorder[i], i);        }
        this.postorderArr = postorder;
        // 2. 调用递归函数        // 初始范围:[0, length),即左闭右开        return buildHelper(0, inorder.length, 0, postorder.length);    }
    /**     * 递归构建树 (左闭右开区间)     * @param inLeft  中序遍历左边界 (包含)     * @param inRight 中序遍历右边界 (不包含) -> 有效范围 [inLeft, inRight)     * @param postLeft 后序遍历左边界 (包含)     * @param postRight 后序遍历右边界 (不包含) -> 有效范围 [postLeft, postRight)     */    private TreeNode buildHelper(int inLeft, int inRight, int postLeft, int postRight) {        // 终止条件:区间为空 (左边界 >= 右边界)        if (inLeft >= inRight || postLeft >= postRight) {            return null;        }
        // 1. 确定根节点的值        // 在左闭右开区间 [postLeft, postRight) 中,最后一个元素是 postRight - 1        int rootVal = postorderArr[postRight - 1];        TreeNode root = new TreeNode(rootVal);
        // 2. 找到根节点在中序遍历中的索引        int inRootIndex = inorderMap.get(rootVal);
        // 3. 计算左子树的节点数量        // 中序遍历中,左子树范围是 [inLeft, inRootIndex)        int leftSize = inRootIndex - inLeft;
        // 4. 递归构建左子树        // 中序:[inLeft, inRootIndex)        // 后序:[postLeft, postLeft + leftSize)        // 解释:后序的左子树从 postLeft 开始,长度为 leftSize        root.left = buildHelper(            inLeft,            inRootIndex,            postLeft,            postLeft + leftSize        );
        // 5. 递归构建右子树        // 中序:[inRootIndex + 1, inRight)        // 后序:[postLeft + leftSize, postRight - 1)        // 解释:        //   - 后序左边界:跳过左子树部分 (postLeft + leftSize)        //   - 后序右边界:当前区间的右边界 (postRight) 需要减去 1,因为最后一位是根节点        root.right = buildHelper(            inRootIndex + 1,            inRight,            postLeft + leftSize,            postRight - 1        );
        return root;    }}
105从前序与中序遍历序列构造二叉树
import java.util.Arrays;class Solution {    public TreeNode buildTree(int[] preorder, int[] inorder) {        // 1. 前序遍历数组第一个元素,就是当前的根节点        int rootValue = preorder[0];        TreeNode root = new TreeNode(rootValue);
        // 2. 叶子节点情况        if (preorder.length == 1) {            return root;        }
        // 3. 找到中序遍历的切割点 (根节点位置)        int delimiterIndex = 0;        for (; delimiterIndex < inorder.length; delimiterIndex++) {            if (inorder[delimiterIndex] == rootValue) {                break;            }        }
        // 4. 切割中序数组        // 左子树中序: [0, delimiterIndex)        int[] leftInorder = Arrays.copyOfRange(inorder, 0, delimiterIndex);        // 右子树中序: [delimiterIndex + 1, end)        int[] rightInorder = Arrays.copyOfRange(inorder, delimiterIndex + 1, inorder.length);
        // 5. 切割前序数组        // 左子树大小        int leftSize = leftInorder.length;
        // 左子树前序: [1, 1 + leftSize)        // 注意:前序的第0个是根,所以左子树从索引1开始        int[] leftPreorder = Arrays.copyOfRange(preorder, 1, 1 + leftSize);
        // 右子树前序: [1 + leftSize, end)        int[] rightPreorder = Arrays.copyOfRange(preorder, 1 + leftSize, preorder.length);
        // 6. 递归构建        root.left = buildTree(leftPreorder, leftInorder);        root.right = buildTree(rightPreorder, rightInorder);
        return root;    }}
import java.util.HashMap;import java.util.Map;class Solution { // 存储中序遍历的值到索引的映射 private Map<Integer, Integer> inorderMap; // 保存前序遍历数组引用 private int[] preorderArr;
public TreeNode buildTree(int[] preorder, int[] inorder) { if (preorder == null || inorder == null || preorder.length != inorder.length) { return null; }
// 1. 预处理:构建中序遍历哈希表 inorderMap = new HashMap<>(); for (int i = 0; i < inorder.length; i++) { inorderMap.put(inorder[i], i); }
this.preorderArr = preorder;
// 2. 调用递归函数 // 初始范围:前序 [0, n), 中序 [0, n) return buildHelper(0, preorder.length, 0, inorder.length); }
/** * 递归构建 (左闭右开区间) * @param preLeft 前序遍历左边界 (包含) * @param preRight 前序遍历右边界 (不包含) * @param inLeft 中序遍历左边界 (包含) * @param inRight 中序遍历右边界 (不包含) */ private TreeNode buildHelper(int preLeft, int preRight, int inLeft, int inRight) { // 终止条件:区间为空 if (preLeft >= preRight || inLeft >= inRight) { return null; }
// 1. 确定根节点 // 前序遍历的第一个元素即为根 (在左闭右开区间中是 preLeft) int rootVal = preorderArr[preLeft]; TreeNode root = new TreeNode(rootVal);
// 2. 找到根在中序遍历中的位置 Integer inRootIndex = inorderMap.get(rootVal);
// 3. 计算左子树的大小 // 中序左子树范围: [inLeft, inRootIndex) int leftSize = inRootIndex - inLeft;
// 4. 递归构建左子树 // 前序左子树: [preLeft + 1, preLeft + 1 + leftSize) // 解释:跳过根节点(preLeft),长度为 leftSize // 中序左子树: [inLeft, inRootIndex) root.left = buildHelper( preLeft + 1, preLeft + 1 + leftSize, inLeft, inRootIndex );
// 5. 递归构建右子树 // 前序右子树: [preLeft + 1 + leftSize, preRight) // 解释:从左子树结束的地方开始,直到当前区间结束 // 中序右子树: [inRootIndex + 1, inRight) root.right = buildHelper( preLeft + 1 + leftSize, preRight, inRootIndex + 1, inRight );
return root; }}| 特性 | 105 (前序+中序) | 106 (后序+中序) |
|---|---|---|
| 根节点位置 | 前序数组的 第一个 (preLeft) | 后序数组的 最后一个 (postRight - 1) |
| 左子树前序起点 | preLeft + 1 (跳过根) | postLeft (紧贴开头) |
| 左子树后序终点 | preLeft + 1 + leftSize | postLeft + leftSize |
| 右子树前序起点 | preLeft + 1 + leftSize | postLeft + leftSize |
| 右子树后序终点 | preRight (区间末尾) | postRight - 1 (排除根) |
【🔥中】236二叉树的最近公共祖先(递归实现后序遍历)#
给定一个二叉树, 找到该树中两个指定节点的最近公共祖先。
对于有根树 T 的两个结点 p、q,最近公共祖先表示为一个结点 x,满足 x 是 p、q 的祖先且 x 的深度尽可能大(一个节点也可以是它自己的祖先)。
如何判断一个节点是节点q和节点p的公共祖先:
情况一:如果找到一个节点,发现左子树出现结点p(q),右子树出现节点q(p),那么该节点就是节点p和q的最近公共祖先
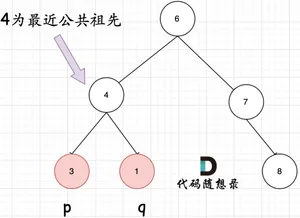
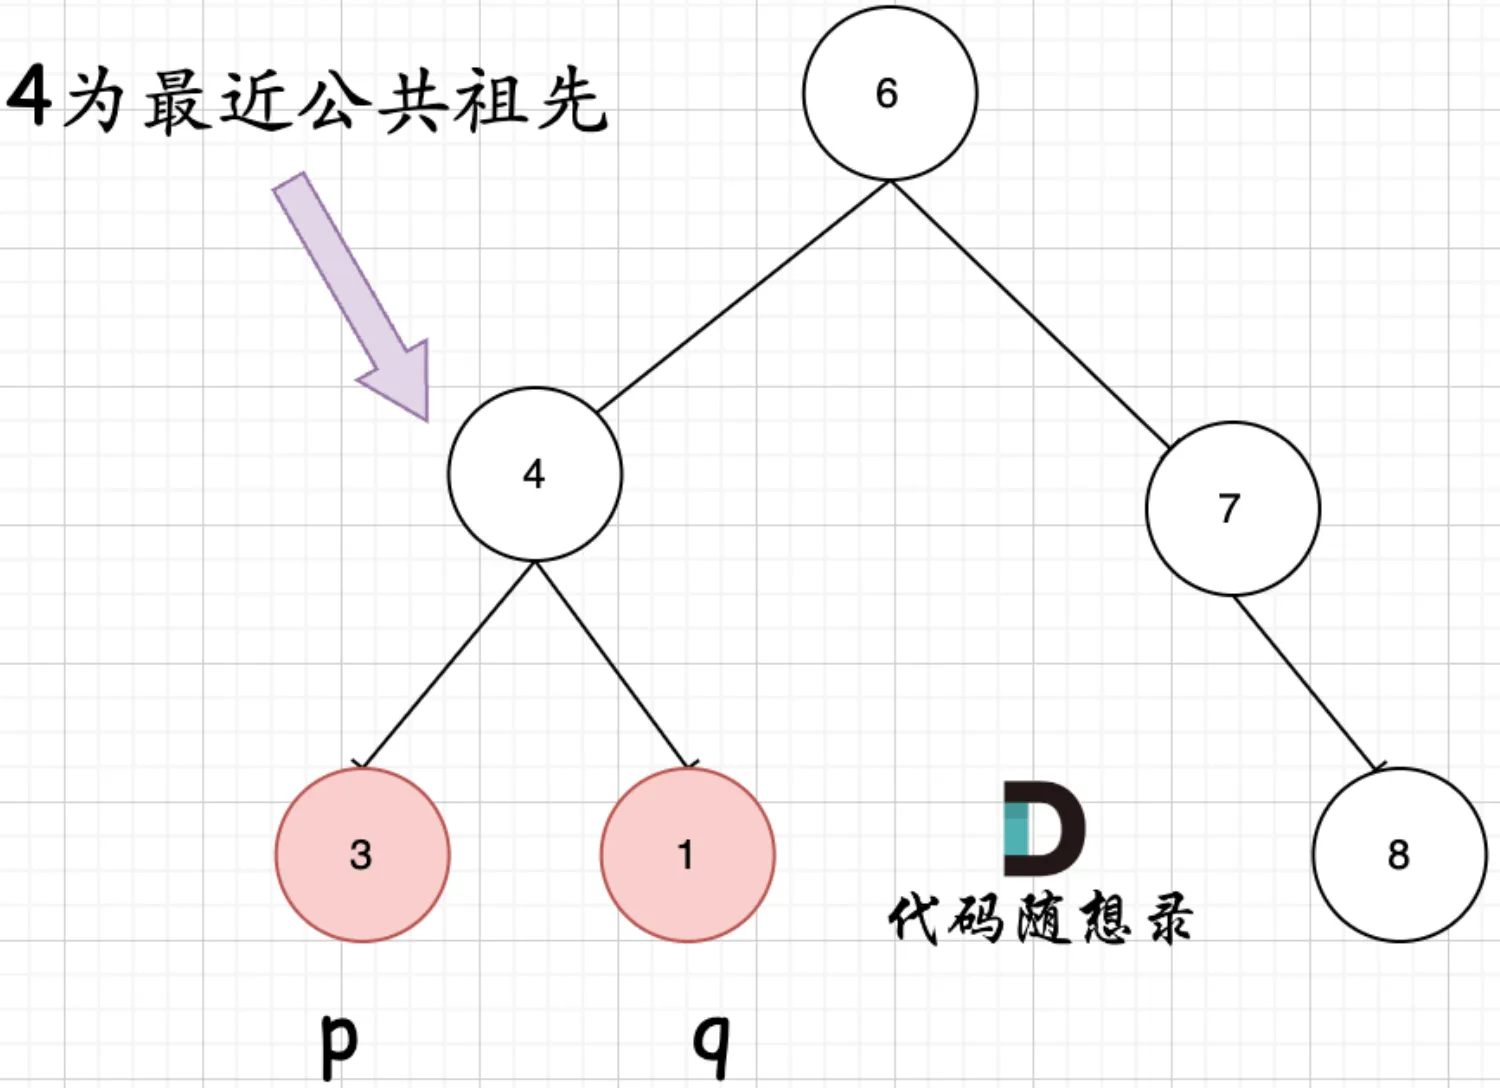
情况二:容易忽略的情况,就是节点本身p(q),它拥有一个子孙节点q(p)
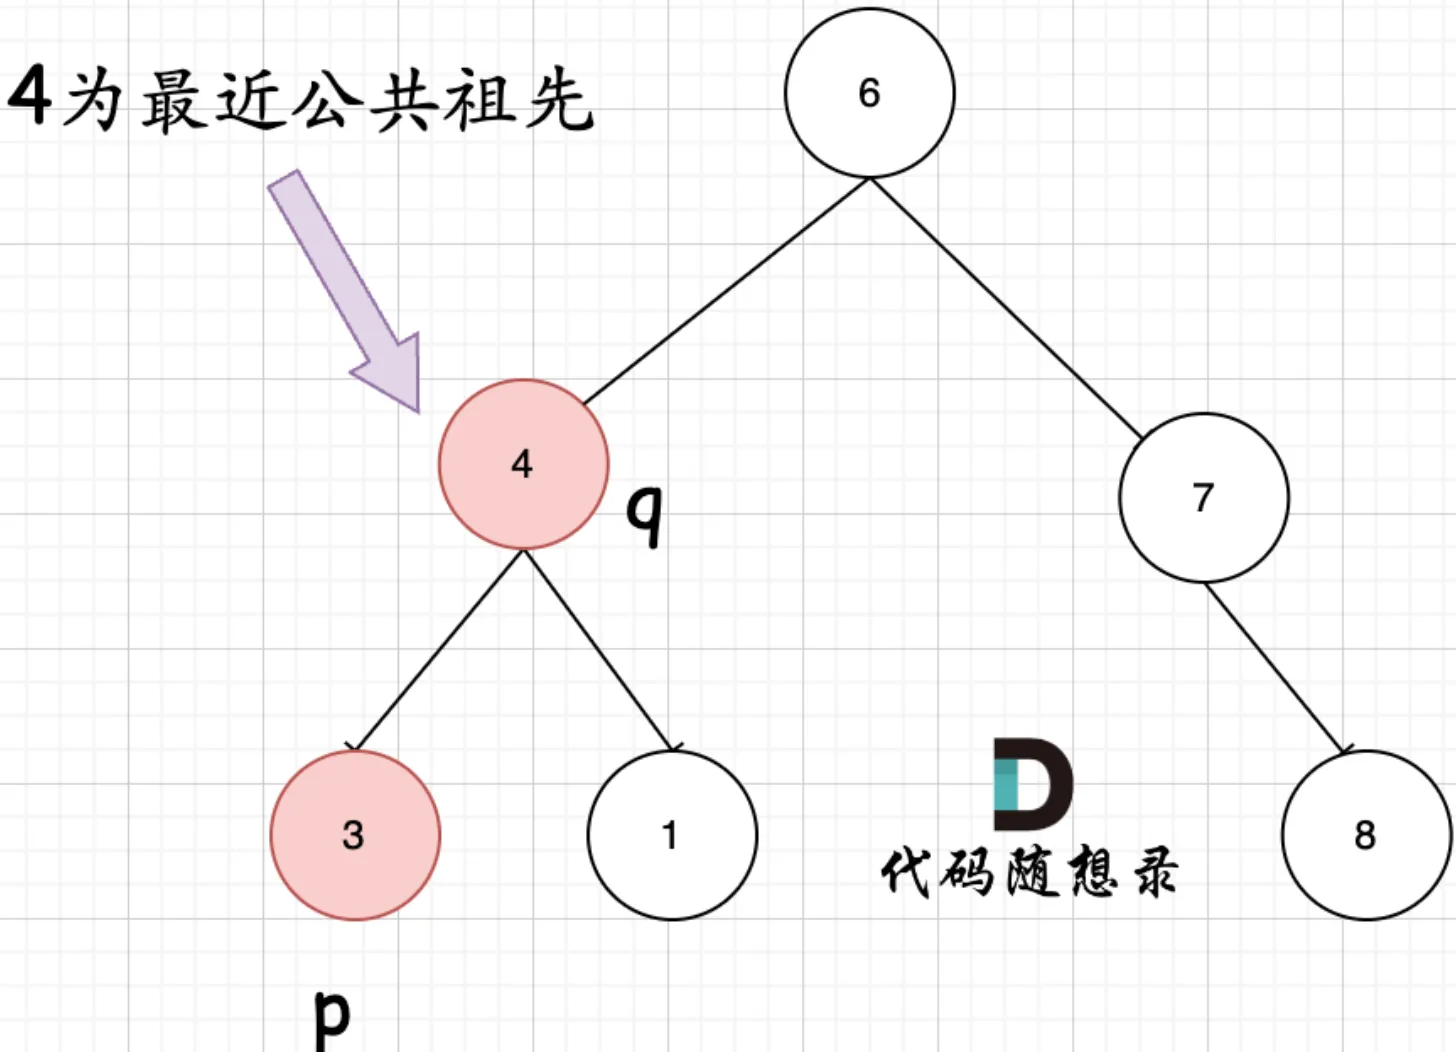
其实情况一 和 情况二 代码实现过程都是一样的,也可以说,实现情况一的逻辑,顺便包含了情况二。
因为遇到 q 或者 p 就返回,这样也包含了 q 或者 p 本身就是 公共祖先的情况。
递归三部曲:
1、确定递归函数返回值以及参数
如果遇到p或者q,就把q或者p返回
public TreeNode lowestCommonAncestor(TreeNode root, TreeNode p, TreeNode q)2、确定终止条件
if (root == q || root == p || root == NULL) return root;3、确定单层递归逻辑
搜索一条边的写法:递归函数返回值不为空的时候,立刻返回,如112路径总和
搜索整个树写法:用变量left、right接住返回值,这个left、right后序还有逻辑处理的需要,也就是后序遍历中处理中间节点的逻辑(也是回溯)
本题需要从底向上遍历,那么二叉树只能通过后序遍历(即:回溯)
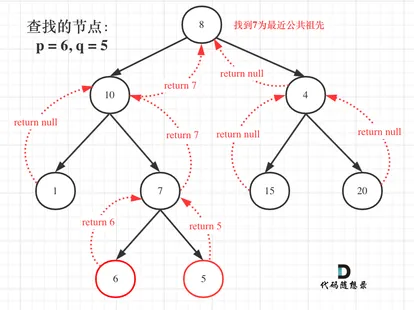
在回溯的过程中,必然要遍历整棵二叉树,即使已经找到结果了,依然要把其他节点遍历完,因为要使用递归函数的返回值(也就是代码中的left和right)做逻辑判断
- 如果 left 和 right 都不为空,说明此时 root 就是最近公共节点
- 如果 left 为空,right 不为空,就返回 right,反之返回 left
完整流程图如下:
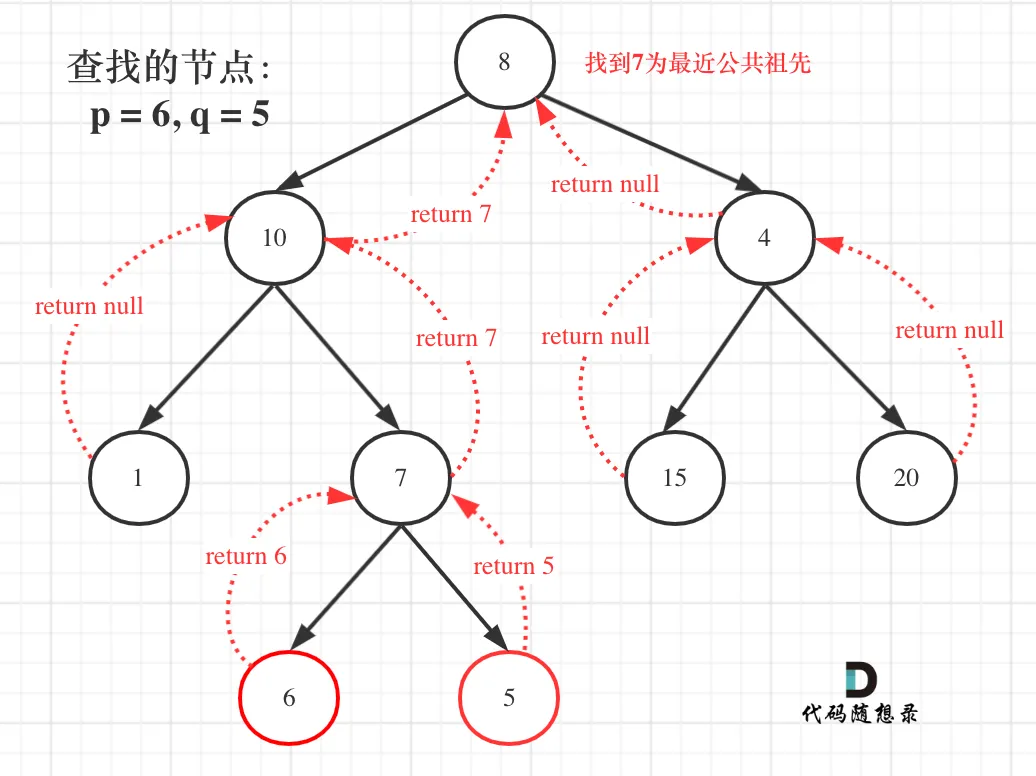
public TreeNode lowestCommonAncestor(TreeNode root, TreeNode p, TreeNode q) { // 递归结束条件 if (root == null || root == p || root == q) return root; // 后序遍历 TreeNode left = lowestCommonAncestor(root.left, p, q); TreeNode right = lowestCommonAncestor(root.right, p, q); // 若未找到节点 p 或 q if(left == null && right == null) return null; // 若找到一个节点 else if(left == null && right != null) return right; // 若找到一个节点 else if(left != null && right == null) return left; // 若找到两个节点 else return root;}【🔥难】124二叉树中的最大路径和(递归实现后续遍历)#
二叉树中的 路径 被定义为一条节点序列,序列中每对相邻节点之间都存在一条边。同一个节点在一条路径序列中 至多出现一次 。该路径 至少包含一个 节点,且不一定经过根节点。
路径和 是路径中各节点值的总和。
给你一个二叉树的根节点
root,返回其 最大路径和 。
int max = Integer.MIN_VALUE;public int maxPathSum(TreeNode root) { dfs(root); return max;}// 返回经过root的单边分支最大和, 即Math.max(root, root+left, root+right)public int dfs(TreeNode root) { // 递归结束条件 if (root == null) return 0; // 后序遍历 // 计算左边分支最大值,左边分支如果为负数还不如不选择 int leftMax = Math.max(0, dfs(root.left)); // 计算右边分支最大值,右边分支如果为负数还不如不选择 int rightMax = Math.max(0, dfs(root.right)); // left->root->right 作为路径与已经计算过历史最大值做比较 max = Math.max(max, root.val + leftMax + rightMax); // 返回经过root的单边最大分支给当前root的父节点计算使用 return root.val + Math.max(leftMax, rightMax);}二叉搜索树#
二叉搜索树节点有数值,是一个有序树
-
对于根节点,左子树中所有节点的值<根节点的值<右子树中所有节点的值
-
任意节点的左、右子树也是二叉搜索树,即同样满足条件1
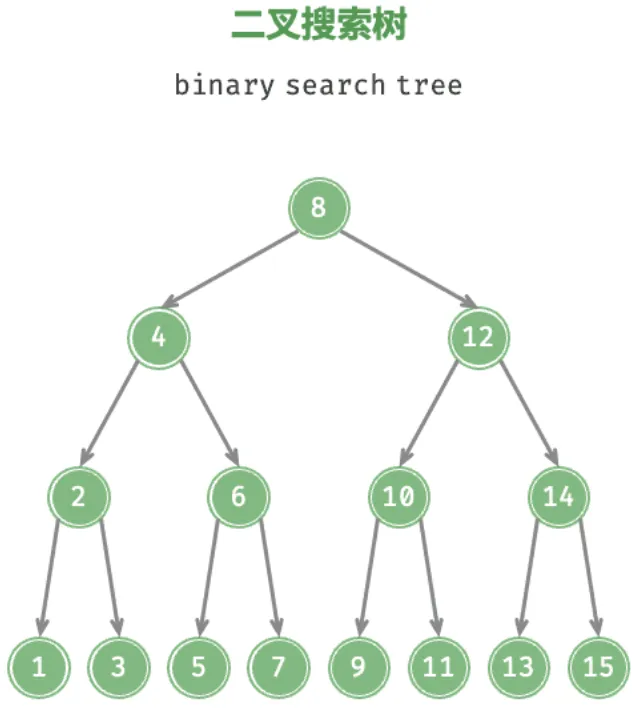
二叉搜索树的操作 O(logn)#
将二叉搜索树封装为一个类 BinarySearchTree ,并声明一个成员变量 root ,指向树的根节点
1、查找节点
给定目标节点值 num ,可以根据二叉搜索树的性质来查找,声明一个节点 cur ,从二叉树的根节点 root出发,循环比较节点值 cur.val 和 num 之间的大小关系
- 若
cur.val < num,说明目标节点在cur的右子树中,因此执行cur = cur.right - 若
cur.val > num,说明目标节点在cur的左子树中,因此执行cur = cur.left - 若
cur.val = num,说明找到目标节点,跳出循环并返回该节点
/* 查找节点 */TreeNode search(int num) { TreeNode cur = root; // 循环查找,越过叶节点后跳出 while (cur != null) { // 目标节点在 cur 的右子树中 if (cur.val < num) cur = cur.right; // 目标节点在 cur 的左子树中 else if (cur.val > num) cur = cur.left; // 找到目标节点,跳出循环 else break; } // 返回目标节点 return cur;}二叉搜索树的查找操作与二分查找算法的工作原理一致,都是每轮排除一半情况。循环次数最多为二叉树的高度,当二叉树平衡时,使用 O(logn) 时间
2、插入节点
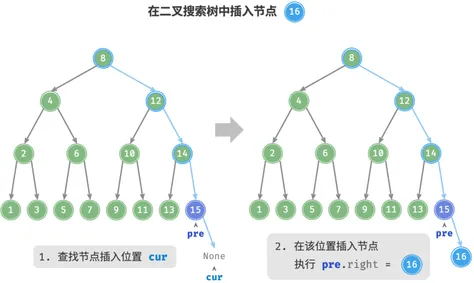
给定一个待插入元素 num ,为了保持二叉搜索树“左子树 < 根节点 < 右子树”的性质,插入操作流程:
- 查找插入位置:与查找操作相似,从根节点出发,根据当前节点值和
num的大小关系循环向下搜索,直到越过叶节点(遍历至None)时跳出循环 - 在该位置插入节点:初始化节点
num,将该节点置于None的位置
注意:
- 二叉搜索树不允许存在重复节点,否则将违反其定义。因此,若待插入节点在树中已存在,则不执行插入,直接返回
- 为了实现插入节点,我们需要借助节点
pre保存上一轮循环的节点。这样在遍历至None时,我们可以获取到其父节点,从而完成节点插入操作
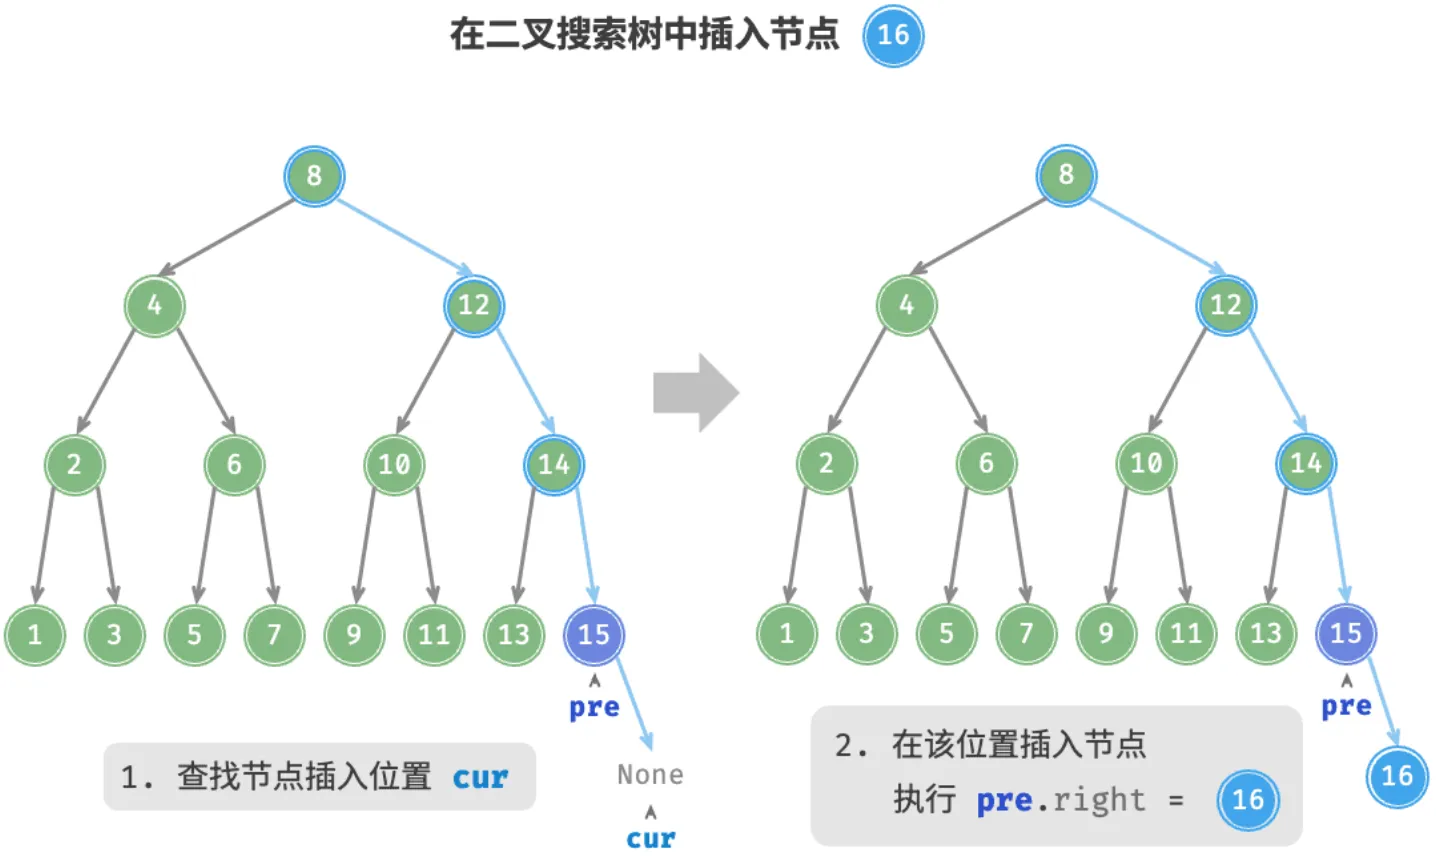
/* 插入节点 */void insert(int num) { // 若树为空,则初始化根节点 if (root == null) { root = new TreeNode(num); return; } TreeNode cur = root, pre = null; // 循环查找,越过叶节点后跳出 while (cur != null) { // 找到重复节点,直接返回 if (cur.val == num) return; pre = cur; // 插入位置在 cur 的右子树中 if (cur.val < num) cur = cur.right; // 插入位置在 cur 的左子树中 else cur = cur.left; } // 插入节点 TreeNode node = new TreeNode(num); if (pre.val < num) pre.right = node; else pre.left = node;}与查找节点相同,插入节点使用 O(logn) 时间
3、删除节点
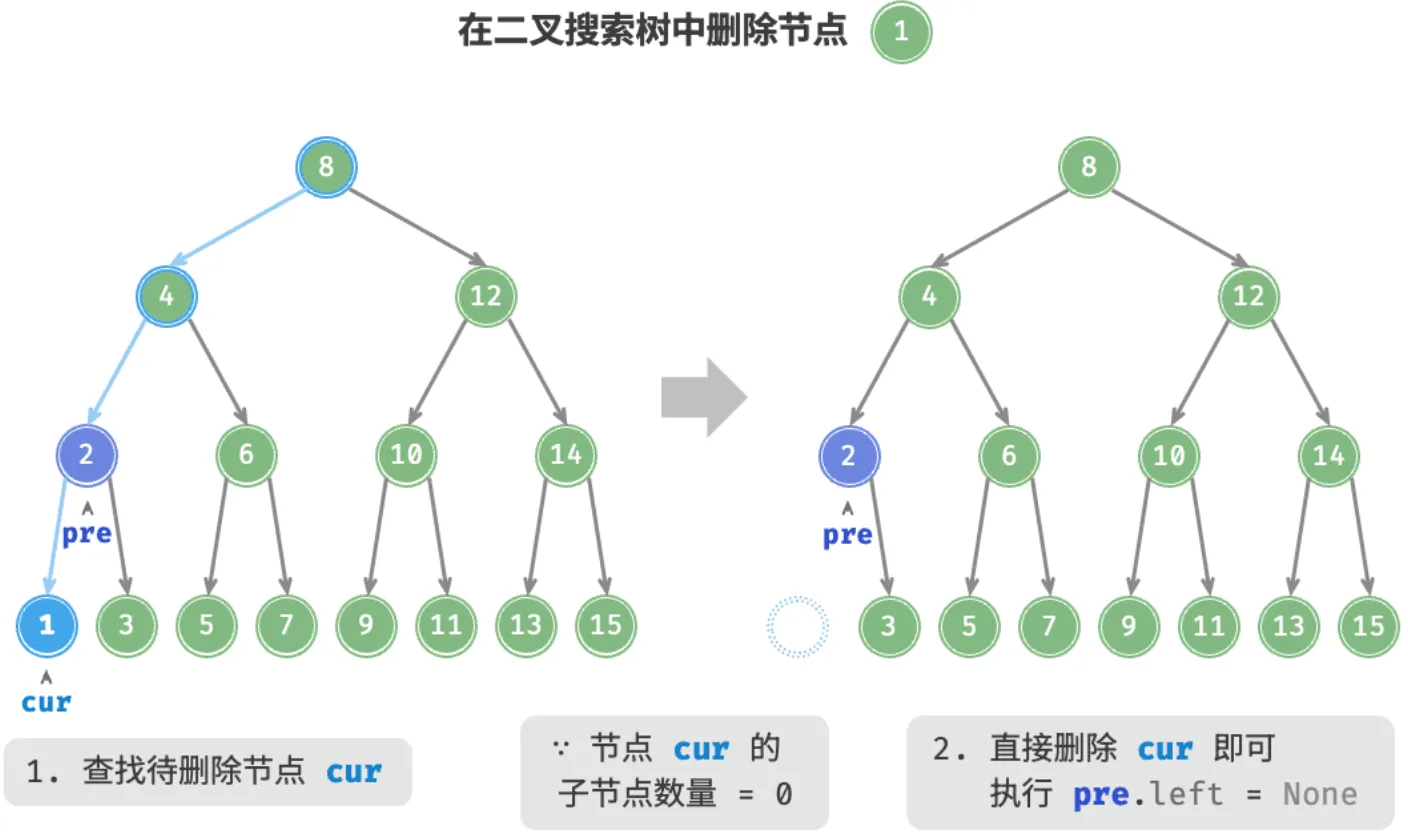
先在二叉树中查找到目标节点,再将其删除。与插入节点类似,需要保证在删除操作完成后,二叉搜索树的“左子树 < 根节点 < 右子树”的性质仍然满足。因此,我们根据目标节点的子节点数量,分 0、1 和 2 三种情况,执行对应的删除节点操作
-
当待删除节点的度为0时,表示该节点是叶节点,可以直接删除
-
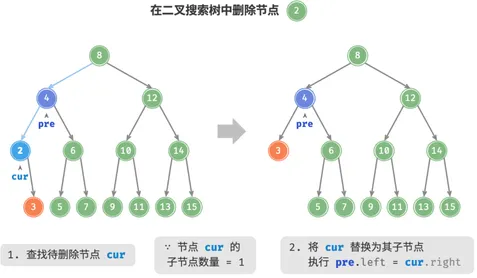
当待删除节点的度为1时,将待删除节点替换为其子节点即可
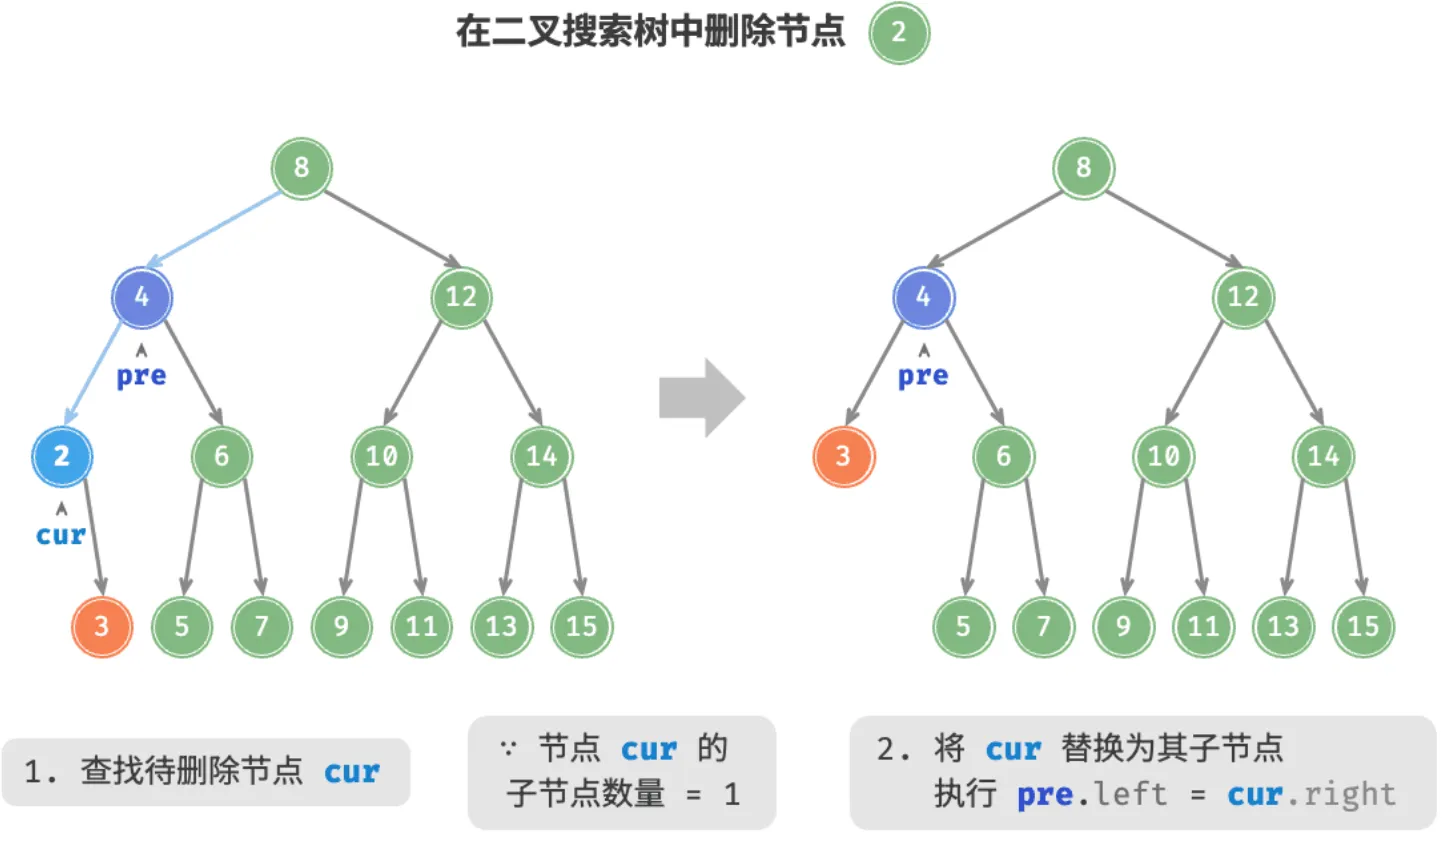
-
当待删除节点的度为2时,无法直接删除它,而需要使用一个节点替换该节点,这个节点可以是右子树的最小节点或左子树的最大节点
假设选择右子树的最小节点,则删除操作流程:
- 找到待删除节点在“中序遍历序列”中的下一个节点(关键),记为
tmp - 用
tmp的值覆盖待删除节点的值,并在树中递归删除节点tmp
- 找到待删除节点在“中序遍历序列”中的下一个节点(关键),记为
/* 删除节点 */void remove(int num) { // 若树为空,直接提前返回 if (root == null) return; TreeNode cur = root, pre = null; // 循环查找,越过叶节点后跳出 while (cur != null) { // 找到待删除节点,跳出循环 if (cur.val == num) break; pre = cur; // 待删除节点在 cur 的右子树中 if (cur.val < num) cur = cur.right; // 待删除节点在 cur 的左子树中 else cur = cur.left; } // 若无待删除节点,则直接返回 if (cur == null) return; // 子节点数量 = 0 or 1 if (cur.left == null || cur.right == null) { // 当子节点数量 = 0 / 1 时, child = null / 该子节点 TreeNode child = cur.left != null ? cur.left : cur.right; // 删除节点 cur if (cur != root) { if (pre.left == cur) pre.left = child; else pre.right = child; } else { // 若删除节点为根节点,则重新指定根节点 root = child; } } // 子节点数量 = 2 else { // 获取中序遍历中 cur 的下一个节点 TreeNode tmp = cur.right; while (tmp.left != null) { tmp = tmp.left; } // 递归删除节点 tmp remove(tmp.val); // 用 tmp 覆盖 cur cur.val = tmp.val; }}删除节点操作同样使用 O(logn) 时间,其中查找待删除节点需要 O(logn) 时间,获取中序遍历后继节点需要 O(logn) 时间
4、中序遍历有序
二叉树的中序遍历遵循“左 根 右”的遍历顺序,而二叉搜索树满足“左子节点 根节点 右子节点”的大小关系。
这意味着在二叉搜索树中进行中序遍历时,总是会优先遍历下一个最小节点,从而得出一个重要性质:二叉搜索树的中序遍历序列是升序的
利用中序遍历升序的性质,我们在二叉搜索树中获取有序数据仅需 O(logn) 时间,无须进行额外的排序操作
二叉搜索树常见应用#
- 用作系统中的多级索引,实现高效的查找、插入、删除操作
- 作为某些搜索算法的底层数据结构
- 用于存储数据流,以保持其有序状态
简 700二叉搜索树中的搜索(二分查找思想)#
给定二叉搜索树(BST)的根节点
root和一个整数值val。你需要在 BST 中找到节点值等于
val的节点。 返回以该节点为根的子树。 如果节点不存在,则返回null。
// 递归法class Solution { public TreeNode searchBST(TreeNode root, int val) { if(root == null) return null; // 注意是root与null而不是root.val if(val == root.val) return root; return searchBST(val>root.val ? root.right : root.left, val); }}// 迭代法class Solution { public TreeNode searchBST(TreeNode root, int val) { while (root != null && root.val != val) { root = root.val < val ? root.right : root.left; } return root; }}【🔥简】108将有序数组转换为二叉搜索树(递归实现中序遍历构建)#
给你一个整数数组
nums,其中元素已经按 升序 排列,请你将其转换为一棵 平衡 二叉搜索树。
二叉搜索树的中序遍历是升序序列,题目给定的数组是按照升序排序的有序数组,因此可以确保数组是二叉搜索树的中序遍历序列,此时不能确定某一个BST;
增加高度平衡的限制条件后,取数组中间元素为根节点,中序递归遍历构建左右子树,保证平衡,此时还是无法确定某一个BST,因为如果数组长度是偶数,则可以选择中间位置左边或者右边的数字作为根节点,只有在代码中确定根节点的选择方式时才能对应一个确定的BST
要将一个有序数组转换为高度平衡的二叉搜索树(BST),核心规则是:
数组中间的元素必须是当前子树的根节点
只有确定了根节点,我们才能明确地划分出:
- 左边部分
[lo, mid-1]-> 属于左子树 - 右边部分
[mid+1, hi]-> 属于右子树
得出算法步骤:算出中间值 -> 创建根节点 -> 递归创建左子树挂上去 -> 递归创建右子树挂上去
注意:二叉搜索树的中序遍历序列不能唯一确定一个BST,因为根节点没有确定,增加高度平衡的限制条件后,如果再在代码中确定根节点的选择方式(偶数时选中间的左边还是右边),此时可以唯一确定一个BST
class Solution {    public TreeNode sortedArrayToBST(int[] nums) {        return dfsToBST(nums, 0, nums.length - 1);    }
    private TreeNode dfsToBST(int[] nums, int lo, int hi) {        // 防止数组为空,此时0>-1返回null        if (lo > hi) {            return null;        }        // 中序遍历(递归)构建        // 以升序数组的中间元素(偶数时选中间的左边)作为根节点 root        int mid = lo + (hi - lo) / 2;        TreeNode root = new TreeNode(nums[mid]);        // 递归构建 root 的左子树与右子树        root.left = dfsToBST(nums, lo, mid - 1);        root.right = dfsToBST(nums, mid + 1, hi);        return root;    }}
中 109有序链表转换二叉搜索树(快慢指针法+中序递归遍历构建)#
给定一个单链表的头节点
head,其中的元素 按升序排序 ,将其转换为 平衡 二叉搜索树。
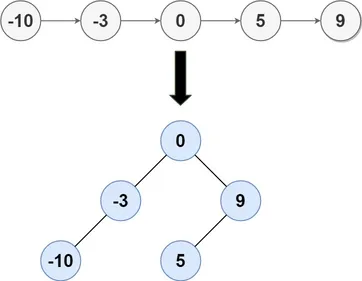
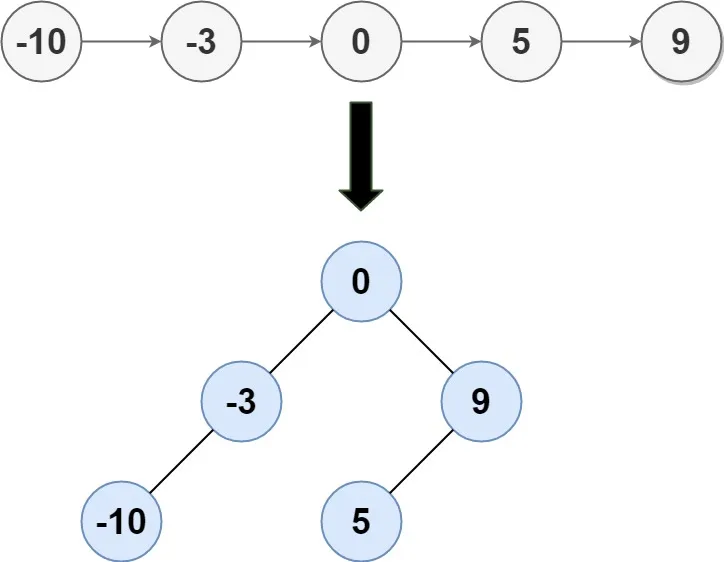
109题将108题的数组换成了链表,做法完全一样,不过链表无法像数组一样直接索引到中间元素,可以用快慢指针法得到链表的中间节点,对应 简 876链表的中间节点 这道题
class Solution {    public TreeNode sortedListToBST(ListNode head) {        return dfsToBST(head, null);    }
    public TreeNode dfsToBST(ListNode left, ListNode right) {        if (left == right) {            return null;        }        ListNode mid = getMedian(left, right);        TreeNode root = new TreeNode(mid.val);        root.left = dfsToBST(left, mid);        root.right = dfsToBST(mid.next, right);        return root;    }
    // 链表长度为偶数时返回中间的右边节点    public ListNode getMedian(ListNode left, ListNode right) {        ListNode fast = left;        ListNode slow = left;        while (fast != right && fast.next != right) {            fast = fast.next.next;            slow = slow.next;        }        return slow;    }}
如果要让链表长队为偶数时返回中间的左边节点
class Solution {    public ListNode middleNode(ListNode head) {        if (head == null) return null;
        ListNode slow = head;        // 【关键修改】让 fast 从 head.next 开始        ListNode fast = head.next;
        // 循环条件保持不变        while (fast != null && fast.next != null) {            fast = fast.next.next;            slow = slow.next;        }
return slow; }}【🔥中】98验证二叉搜索树(递归实现中序遍历)#
给你一个二叉树的根节点
root,判断其是否是一个有效的二叉搜索树。有效 二叉搜索树定义如下:
- 节点的左子树只包含 严格小于 当前节点的数。
- 节点的右子树只包含 严格大于 当前节点的数。
- 所有左子树和右子树自身必须也是二叉搜索树。
验证二叉搜索树,相当于判断一个中序遍历序列是否递增
可以递归中序遍历将二叉搜索树转变成一个数组,然后判断这个数组是否是有序的,注意二叉搜索树中不能有重复元素。代码如下:
class Solution {    private List<Integer> list;
    private void traversal(TreeNode root) {        if (root == null) return;        traversal(root.left);        list.add(root.val); // 将二叉搜索树转换为有序列表        traversal(root.right);    }
    public boolean isValidBST(TreeNode root) {        list = new ArrayList<>();        traversal(root);        for (int i = 1; i < list.size(); i++) {            // 注意要小于等于,搜索树里不能有相同元素            // Java 中 Integer 比较值建议直接拆箱比较或使用 compareTo,            // 这里自动拆箱比较数值大小:list.get(i) <= list.get(i-1)            if (list.get(i) <= list.get(i - 1)) {                return false;            }        }        return true;    }}
以上代码中直观的把二叉树转变为数组来判断,但其实不用转变成数组,可以在递归遍历的过程中直接判断是否有序
class Solution {    TreeNode max;    public boolean isValidBST(TreeNode root) {        if (root == null) {            return true;        }        // 左        boolean left = isValidBST(root.left);
// 中 if (max != null && root.val <= max.val) { return false; } max = root; // 右 boolean right = isValidBST(root.right); return left && right; }}【🔥中】230二叉搜索树中第 K 小的元素(递归实现中序遍历)#
给定一个二叉搜索树的根节点
root,和一个整数k,请你设计一个算法查找其中第k小的元素(k从 1 开始计数)。
利用BST 中序遍历即升序序列的特性,在递归中找到第 k 个节点
public class Solution {  int res, i =0;
  public int kthSmallest(TreeNode root, int k) {      inorder(root, k);      return res;  }
public void inorder(TreeNode root, int k){ if (root == null) return; inorder(root.left, k); if (++i == k){ res = root.val; } inorder(root.right, k); }}【🔥中】538把二叉搜索树转换为累加树(递归实现反向中序遍历)#
给出二叉 搜索 树的根节点,该树的节点值各不相同,请你将其转换为累加树(Greater Sum Tree),使每个节点
node的新值等于原树中大于或等于node.val的值之和。提醒一下,二叉搜索树满足下列约束条件:
- 节点的左子树仅包含键 小于 节点键的节点。
- 节点的右子树仅包含键 大于 节点键的节点。
- 左右子树也必须是二叉搜索树。
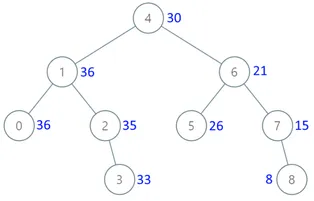
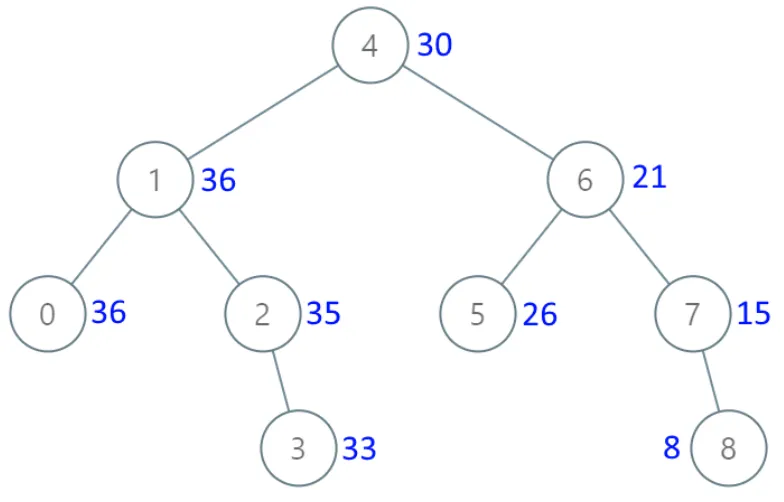
换一个角度来看,这就是一个有序数组 [2, 5, 13],求从后到前的累加数组,也就是 [20, 18, 13]
对应树中就是按 右 -> 根 -> 左 顺序遍历,维护一个累加和 sum
- 初始化 s=0
- 从根节点开始递归,先递归右子树
- 右子树递归结束后,把当前节点的值加到 s 中,然后用 s 替换当前节点的值
- 然后递归左子树
- 递归边界:递归到空节点时返回
class Solution {    private int s = 0;
    public TreeNode convertBST(TreeNode root) {        redfs(root);        return root;    }
    private void redfs(TreeNode node) {        if (node == null) {            return;        }        redfs(node.right); // 递归右子树        s += node.val;        node.val = s; // 此时 s 就是 >= node.val 的所有数之和        redfs(node.left); // 递归左子树    }}
平衡二叉搜索树 AVL 和红黑树#
前面的章节提到,在多次插入和删除操作后,二叉搜索树可能退化为链表。在这种情况下,所有操作的时间复杂度将从 O(logn) 劣化为 O(n),为了避免这种情况,AVL树和红黑树出现了
AVL树最初由两位苏联的计算机科学家,Adelson-Velskii和Landis,于1962年提出。因此,AVL树就以他们两人名字的首字母缩写命名了
红黑树 vs AVL 树的区别:
- 平衡标准: AVL 是严格平衡(左右子树高度差绝对值不超过 1),红黑树是弱平衡(最长路径不超过最短路径的 2 倍)
- 性能差异: AVL 查询更快(树更矮),但插入/删除维护平衡的旋转次数更多;红黑树插入/删除效率更高(旋转少),查询稍慢但也是 O(logN)
- 应用场景: 读多写少选 AVL(如数据库索引),读写频繁选红黑树(如语言标准库)
红黑树的 5 条性质: (头尾黑、叶黑、红不连红、黑高相同)
-
每个节点要么是红色,要么是黑色
-
根节点必须是黑色
注意: 虽然在插入过程中根节点可能会暂时变红,但在任何操作完成后的最终状态下,根节点必须强制为黑色。如果插入后根是红的,直接涂黑即可
-
每个叶子节点(NIL 节点,即空节点)都是黑色的
关键: 这里的“叶子节点”指的是树末端的空指针(在代码中通常表示为
null或一个特殊的NIL对象),而不是我们通常认为的“没有子节点的实节点” 意义: 这条性质保证了从任何路径走到尽头都能遇到黑色节点,为第 5 条性质做铺垫 -
红不连红:如果一个节点是红色的,则它的两个子节点都必须是黑色的
意义: 这条性质限制了路径上红色节点的密度,防止某条路径因为全是红色节点而变得过长
-
黑高相同:从任一节点到其每个叶子的所有简单路径上,包含相同数量的黑色节点
意义: 这是红黑树保持平衡的核心。结合第 4 条性质(不能红红相连),可以推导出:最长路径(红黑交替)的长度不会超过最短路径(全黑)长度的 2 倍。从而保证了树的高度维持在 O(logN) 级别
结合 Java 集合框架:
-
TreeMap/TreeSet:底层是红黑树。你要知道它们的方法是 O(logN) 的,且元素是有序的 -
HashMap:当链表长度超过 8 且数组长度超过 64 时,链表转为红黑树。你要能解释这个阈值设定的原因以及退化为链表的条件为什么 Java HashMap (JDK 8+) 链表转树用的是红黑树而不是 AVL?
因为 HashMap 经常涉及插入和删除,红黑树在维持平衡时的旋转开销更小,综合性能更好
-
并发 Map
ConcurrentHashMap:无序—红黑树ConcurrentSkipListMap:有序—跳表
并发有序 Map 用跳表(SkipList)而不是红黑树,因为红黑树在并发下加锁开销太大,在插入/删除时需要旋转节点,这在多线程环境下很难处理,而跳表只需要修改相邻节点的指针
七、图论#
图论理论基础#
图由顶点(vertex)和边(edge)组成,我们可以将图 G 抽象表示为一组顶点 V 和一组边 E 的集合
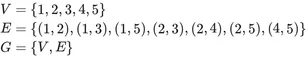
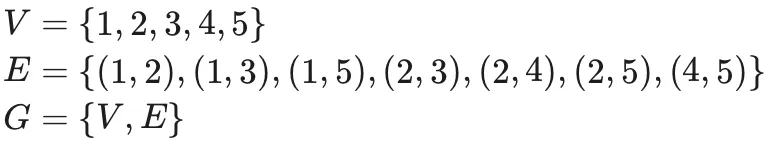
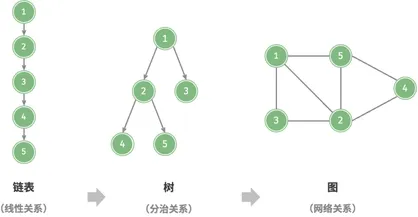
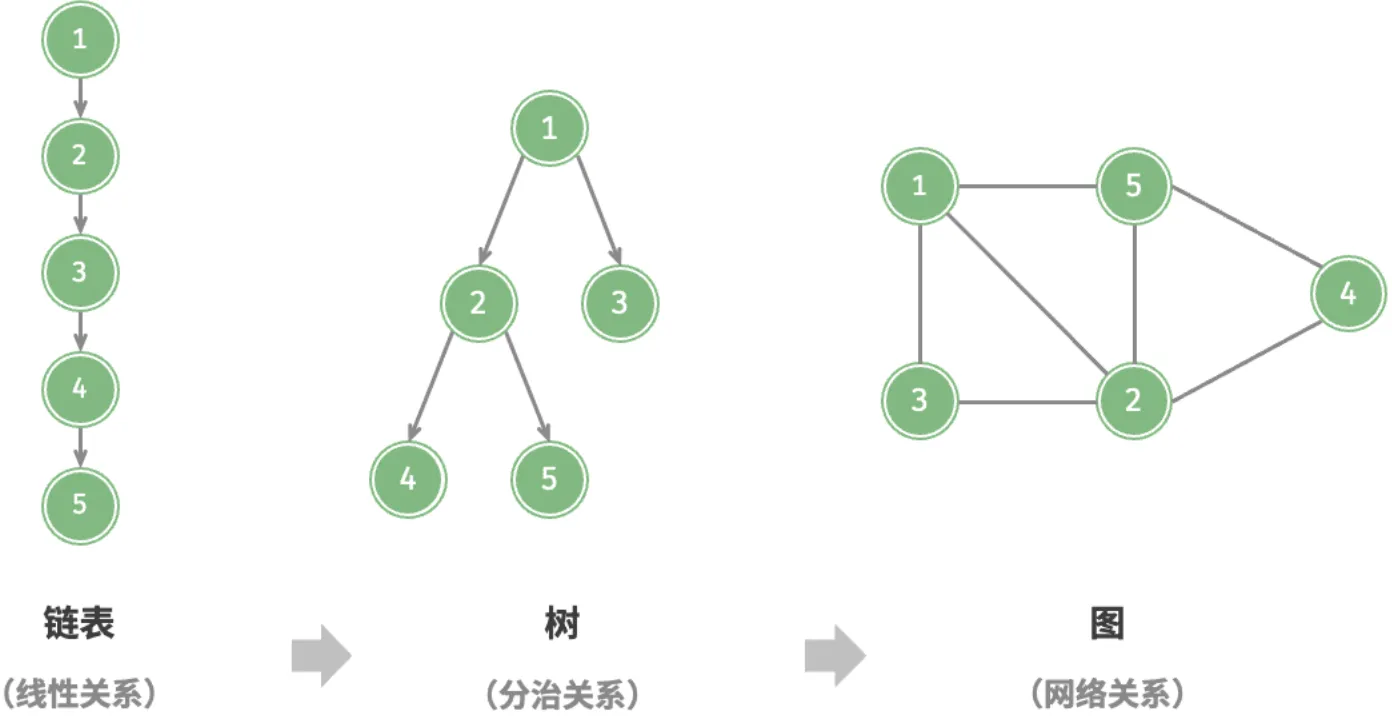
概念:
- 子图:从原图中删除一些节点和边后得到的图
- 邻接:当两顶点之间存在边相连时,称这两顶点“邻接”
- 路径(path):从顶点 A 到顶点 B 经过的边构成的序列被称为从 A 到 B 的“路径”
- 度(degree):一个顶点拥有的边数。对于有向图,入度表示有多少条边指向该顶点,出度表示有多少条边从该顶点指出
一般讨论的都是简单图,即没有自环边和多重边的图
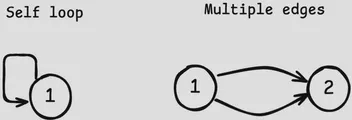
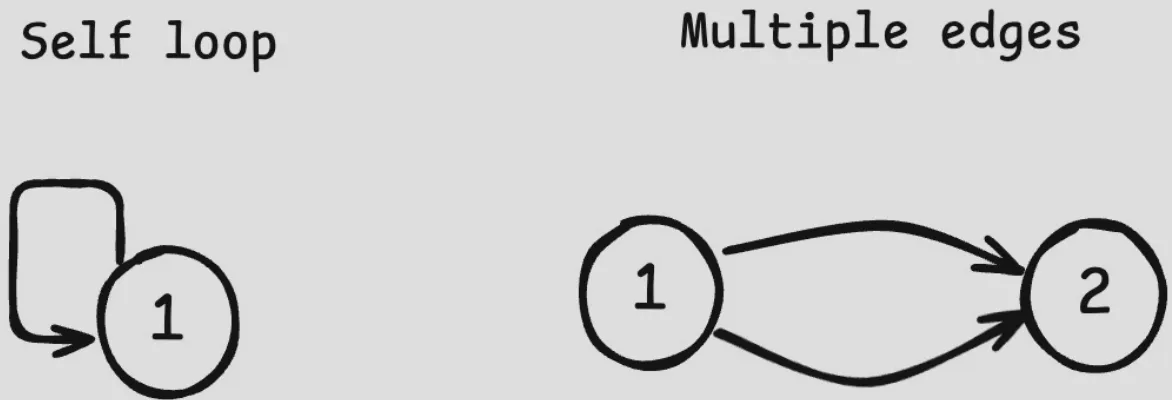
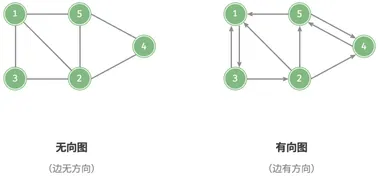
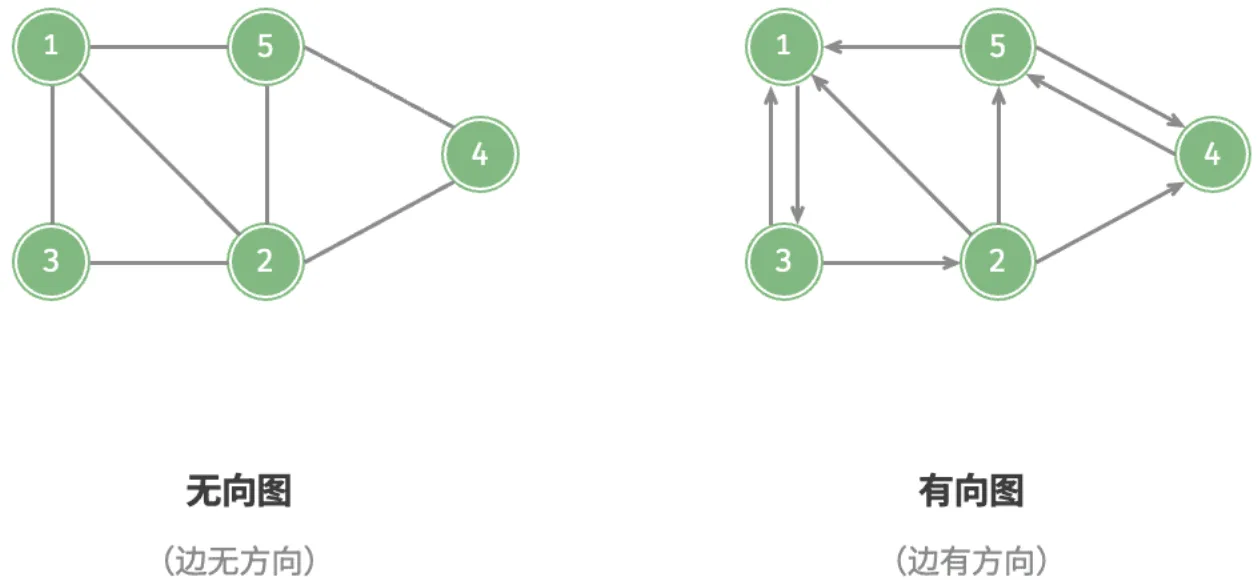
- 在无向图中,边表示两顶点之间的“双向”连接关系,例如微信或 QQ 中的“好友关系”
- 在有向图中,边具有方向性,即两个方向的边是相互独立的,例如微博或抖音上的“关注”与“被关注”关系
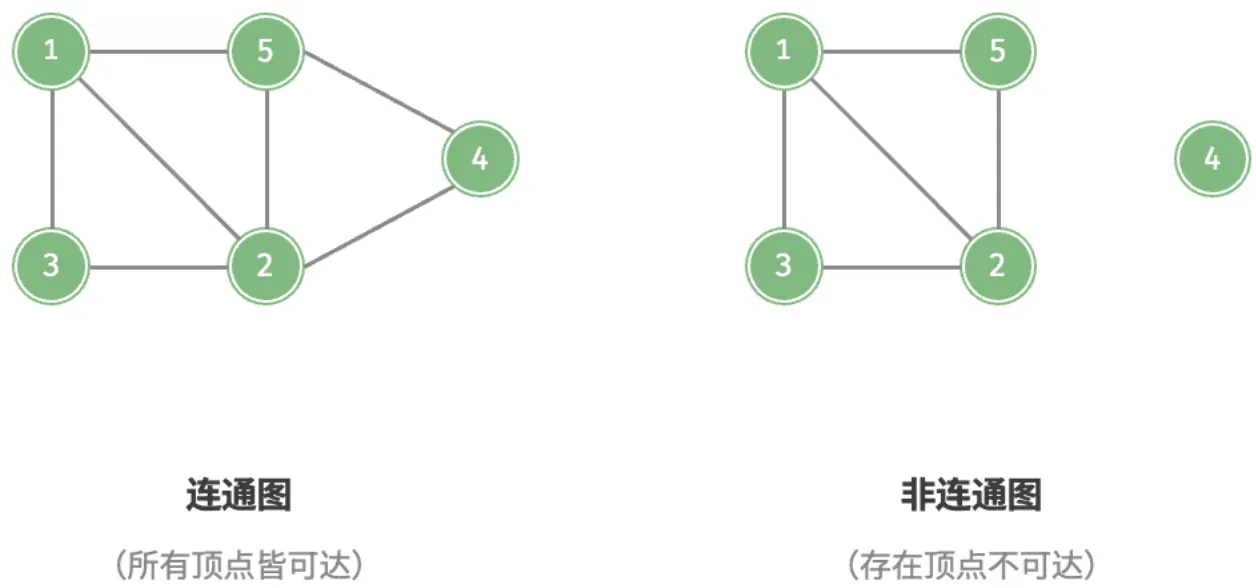
- 对于连通图,从某个顶点出发,可以到达其余任意顶点
- 对于非连通图,从某个顶点出发,至少有一个顶点无法到达
-
在有向图中,任何两个节点是可以相互到达的,称之为强连通图
-
如果将有向图中的所有有向边都变成无向边后,该图变成连通的,那么原来的有向图就是弱连通图
-
在无向图中的极大连通子图称之为该图的连通分量
-
在有向图中的极大强连通子图称之为该图的强连通分量
-
有向图中的极大弱连通子图称之为该图的弱连通分量
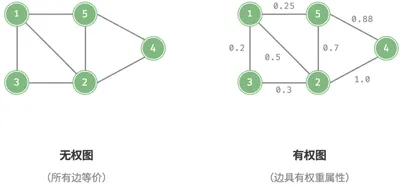
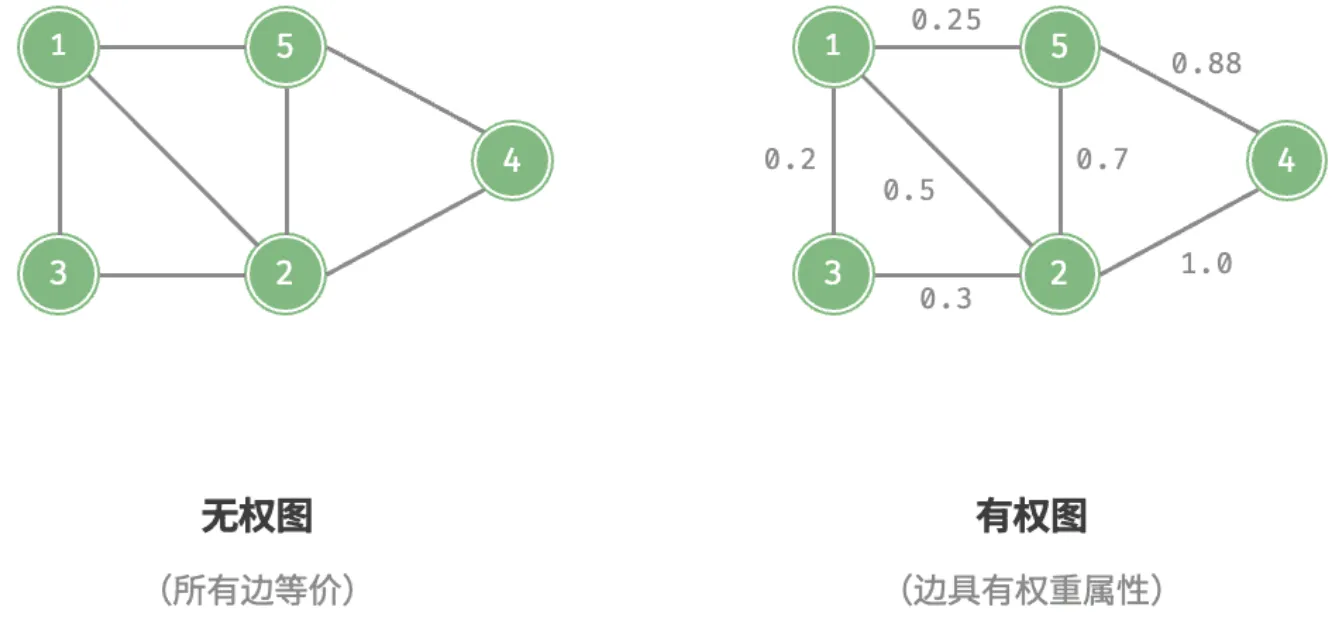
还可以为边添加“权重”变量,从而得到有权图,例如在《王者荣耀》等手游中,系统会根据共同游戏时间来计算玩家之间的“亲密度”
图的表示#
邻接矩阵#
设图的顶点数量为n ,邻接矩阵(adjacency matrix)使用一个 大小的矩阵来表示图,每一行(列)代表一个顶点,矩阵元素代表边,用1或0表示两个顶点之间是否存在边
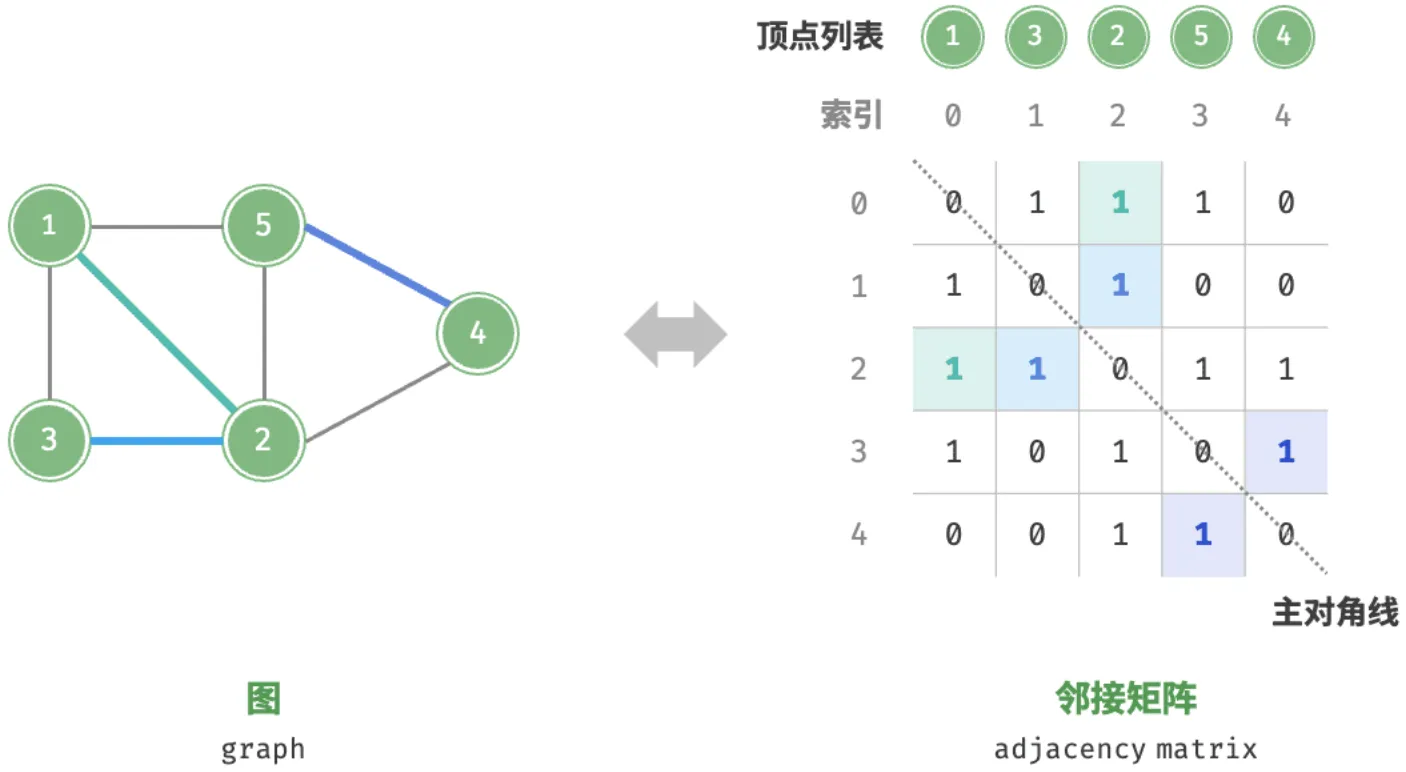
邻接矩阵具有以下特性:
- 在简单图中,顶点不能与自身相连,此时邻接矩阵主对角线元素没有意义
- 对于无向图,两个方向的边等价,此时邻接矩阵关于主对角线对称
- 将邻接矩阵的元素从 1 和 0 替换为权重,则可表示有权图
使用邻接矩阵表示图时,我们可以直接访问矩阵元素以获取边,因此增删查改操作的效率很高,时间复杂度均为 O(1);但是矩阵的空间复杂度为 O(n^2^),内存占用较多
邻接表#
使用n个链表来表示图,链表节点表示顶点。第i个链表对应顶点i,其中存储了该顶点的所有邻接顶点
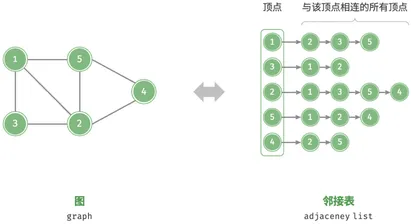
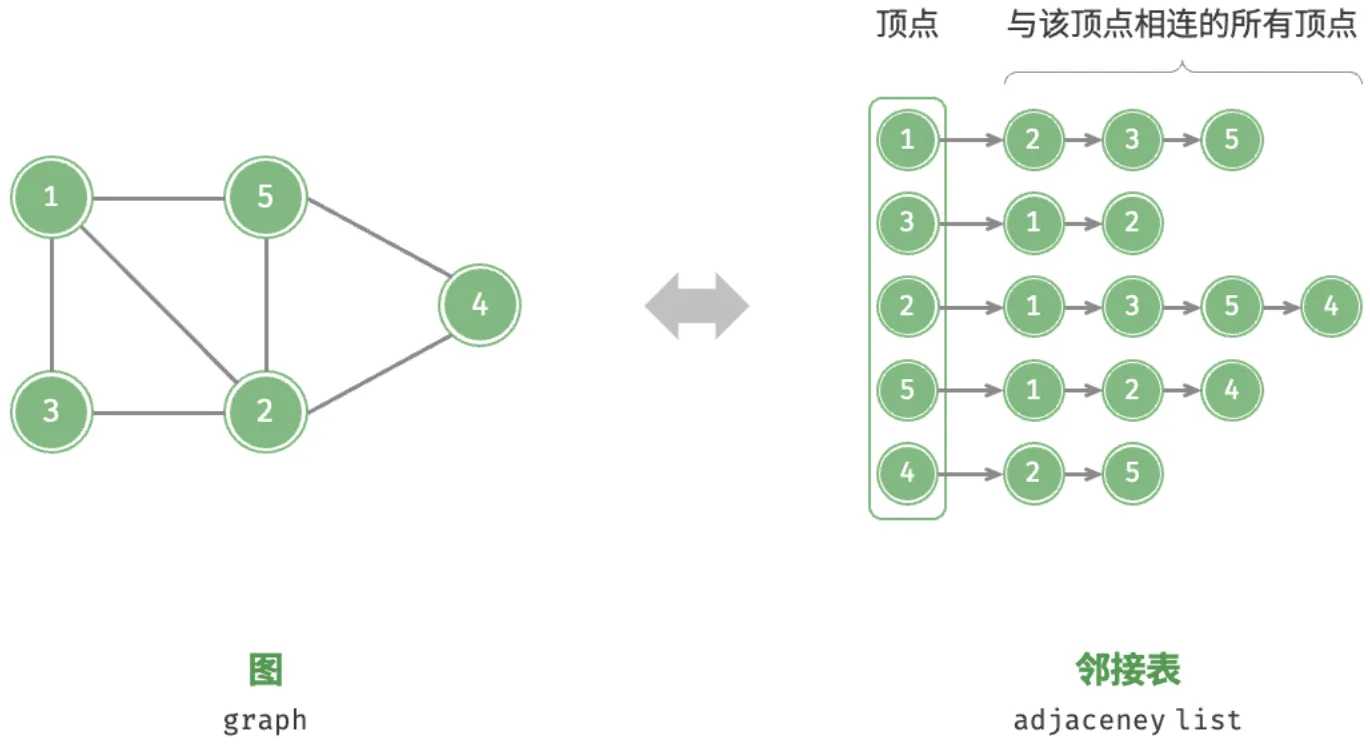
邻接表仅存储实际存在的边,而边的总数通常远小于 n^2^,因此它更加节省空间;但是在邻接表中需要通过遍历链表来查找边,因此其时间效率不如邻接矩阵
邻接表结构与哈希表中的“链式地址”非常相似,因此我们也可以采用类似的方法来优化效率。比如当链表较长时,可以将链表转化为 AVL 树或红黑树,从而将时间效率从 O(n) 优化至 O(logn) ;还可以把链表转换为哈希表,从而将时间复杂度降至 O(1)
图的遍历#
深度优先搜索 DFS#
- 图中连通块数量
- 判断图中是否有环
- 遍历所有路径
下图是一个无向图,我们要搜索从节点1到节点6的所有路径
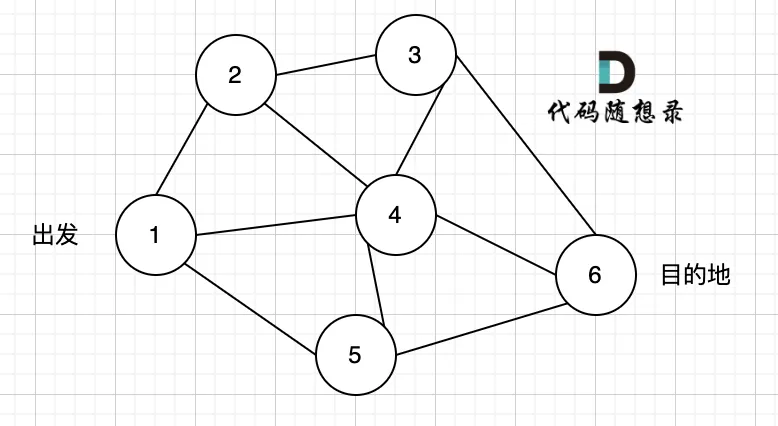
那么dfs搜索的第一条路径是这样的:(假设第一次延默认方向,就找到了节点6)
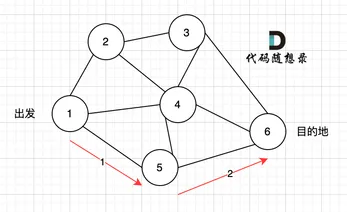
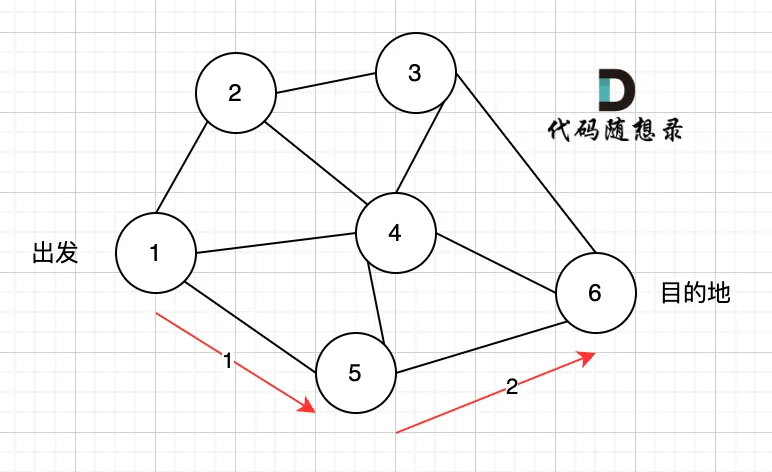
此时我们找到了节点6,那么应该再去搜索其他方向了:
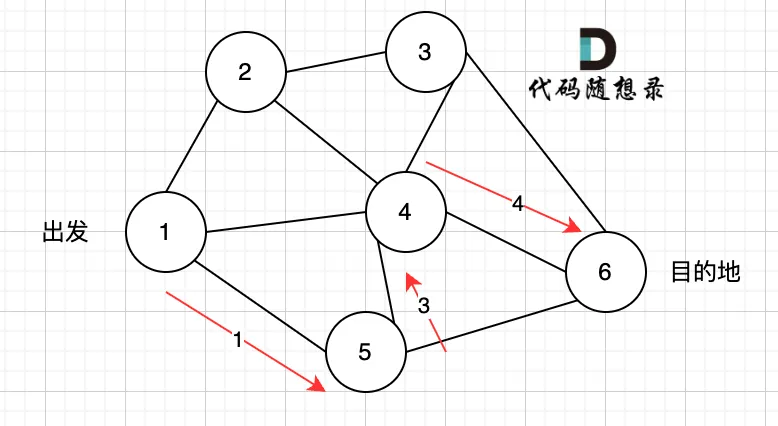
路径2撤销了,改变了方向,走路径3(红色线),接着也找到终点6(这里撤销路径2,改为路径3,在dfs中其实就是回溯的过程),此时再回头,路径4撤销(回溯),改为路径5:
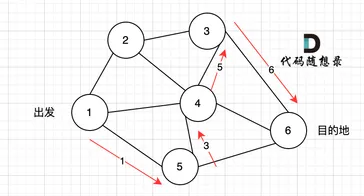
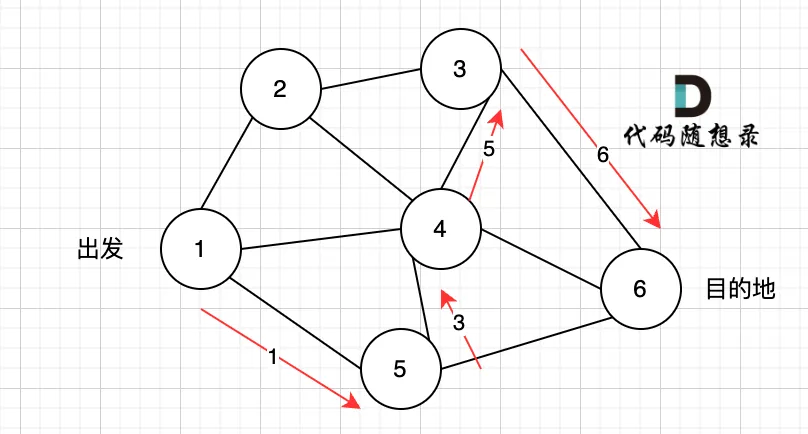
又找到了一条从节点1到节点6的路径,此时再回头,路径6撤销(回溯),改为路径7,结果发现不管路径8还是9都是死路,都走到了之前走过的节点:
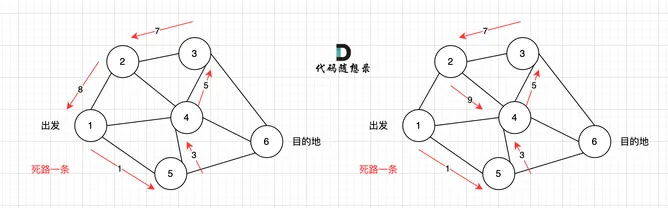
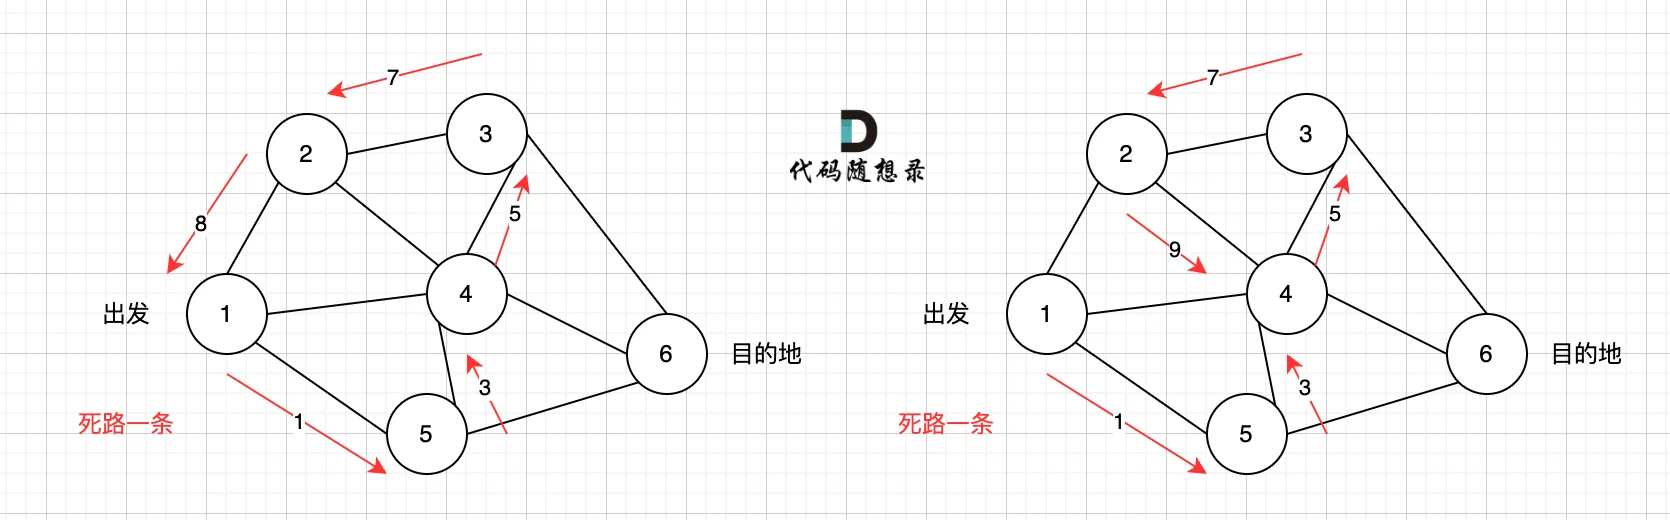
那么节点2所连接路径和节点3所连接的路径都走过了,撤销路径只能继续向上回退,去选择撤销当初节点4的选择,也就是撤销路径5,改为路径10:
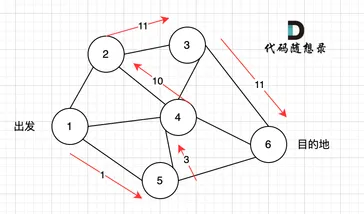
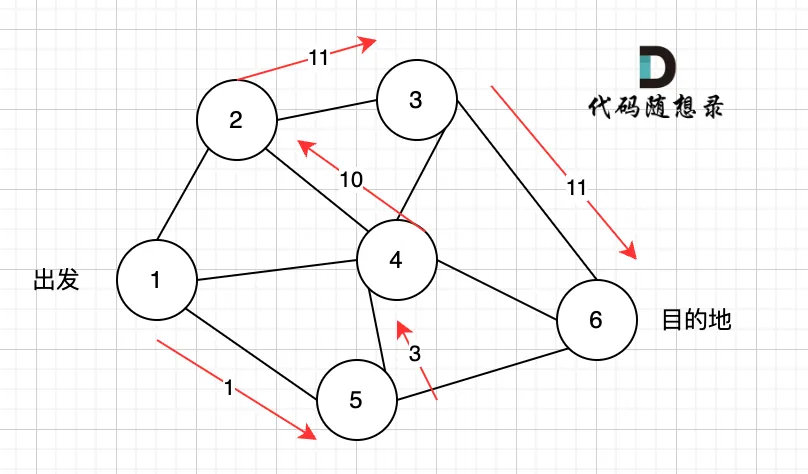
上图演示中并没有把所有的dfs过程都画出来,但已经涉及了 dfs 的关键:
- 搜索方向,是认准一个方向搜,直到碰壁之后再换方向
- 换方向是撤销原路径,改为节点链接的下一个路径,回溯的过程
深度优先遍历能得到所有从起点到终点的路径
给定某顶点,先往哪个方向探索都可以,即邻接顶点的顺序可以任意打乱,都是深度优先遍历
以树的遍历为例,“根 左 右”“左 根 右”“左 右 根”分别对应前序、中序、后序遍历,它们展示了三种遍历优先级,然而这三者都属于深度优先遍历
代码框架:
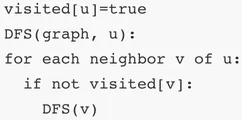
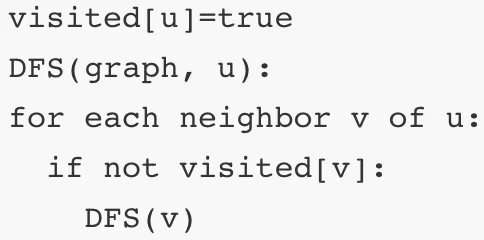
一般情况,深搜需要全局变量二维数组 result保存所有路径,哈希表 visited 保存已访问的节点(如果是无环图,不用 visited 也行,只是会降低效率),一维数组 path保存单一路径
// 全局变量:用于收集结果和记录当前路径static List<List<节点类型>> result = new ArrayList<>();static List<节点类型> path = new ArrayList<>();static Set<节点类型> visited = new HashSet<>(); // 记录当前路径已访问的节点
// 1、确认递归函数签名// (1) 邻接矩阵:int[][] graph// (2) 邻接表:List<LinkedList<Integer>> graphstatic void dfs(参数:图, 目前节点 cur, 终点 target) {    // 2、确认终止条件 (通常在递归入口处判断)    if (cur == target) {        // 找到一条完整路径,拷贝当前路径存入结果集        result.add(new ArrayList<>(path));        return; // 结束当前递归分支    }
    // 3、扩展节点:遍历目前搜索节点所能到的所有邻居,兼容邻接表/矩阵    // (1) 邻接表:for (节点类型 neighbor : cur 的所有邻居)    for (Vertex adjVet : graph.get(vet)){        // --- 剪枝 / 隐式终止条件 ---        // 如果该邻居已经在当前路径中 (visited),说明成环或重复,直接跳过,不向下递归        if (visited.contains(neighbor)) {            continue;        }        // --- 处理节点 (做选择) ---        // 标记为已访问 (防止当前路径走回头路)        visited.add(neighbor);        // 加入当前路径        path.add(neighbor);    // (2) 邻接矩阵    // for (int i = 1; i <= n; i++) {    //     if (graph[x][i] == 1 && !visited[i]) {    //         visited.add(neighbor);    //         path.add(neighbor);    //     }

        // --- 递归进入下一层 ---        dfs(图,neighbor, target);
        // --- 回溯,撤销处理结果 (关键步骤) ---        // BFS 不需要这一步,但 DFS 求所有路径必须撤销!        // 原因:当前分支探索完毕,需要释放该节点,允许其他路径再次经过它        path.remove(path.size() - 1);      // 撤销路径选择        visited.remove(neighbor);          // 撤销访问标记    }}
// 【⚠️注意】主方法调用 dfs,需要提前初始化全局变量;而bfs不需要path.add(起点); // 初始化起点visited[起点] = true; // 起点也要标记dfs(graph, 起点, 终点);注意:部分dfs写法将终止条件隐藏在了是否进行dfs递归的判断里,也就是不符合条件,直接不会向下递归
中 797所有可能的路径#
给你一个有
n个节点的 有向无环图(DAG),请你找出从节点0到节点n-1的所有路径并输出(不要求按特定顺序)。
深搜三部曲(以邻接矩阵为例):
1、确认递归函数,参数
List<List<Integer>> result = new ArrayList<>(); // 收集符合条件的路径List<Integer> path = new ArrayList<>(); // 1节点到终点的路径// graph:存当前的图// x:目前遍历的节点// n:终点public static void dfs(int[][] graph, int x, int n) {2、确认终止条件:当目前遍历的节点为最后一个节点 n 的时候 就找到了一条从出发点到终止点的路径
// 当前遍历的节点x到达节点nif (x == n) { result.add(path); return;}3、处理目前搜索节点出发的路径
-
首先是要找到x节点指向了哪些节点,遍历方式:
for (int i = 1; i <= n; i++) { // 遍历节点x连接的所有节点if (graph[x][i] == 1) { // 找到x指向的节点,就是节点i}} -
接下来将x所指向的节点,加入到 path:
path.add(i); // 遍历到的节点加入到路径中来 -
进入下一层递归:
dfs(graph, i, n); // 进入下一层递归 -
最后就是回溯的过程,撤销本次添加节点的操作:
path.remove(); // 回溯,撤销本节点
4、打印结果
ACM格式在输出结果的时候,要关注格式问题,特别是字符串,有的题目说的是每个元素后面都有空格,有的题目说的是每个元素间有空格,最后一个元素没有空格
输入描述:
第一行包含两个整数 N,M,表示图中拥有 N 个节点,M 条边
后续 M 行,每行包含两个整数 s 和 t,表示图中的 s 节点与 t 节点中有一条路径
输出描述:
输出所有的可达路径,路径中所有节点之间空格隔开,每条路径独占一行,存在多条路径,路径输出的顺序可任意。如果不存在任何一条路径,则输出 -1
注意输出的序列中,最后一个节点后面没有空格!
import java.util.ArrayList;import java.util.List;import java.util.Scanner;public class Main {    static List<List<Integer>> result = new ArrayList<>(); // 收集符合条件的路径    static List<Integer> path = new ArrayList<>(); // 记录当前路径    static boolean[] visited; // 记录节点是否在当前路径中被访问过
    public static void dfs(int[][] graph, int x, int n) {        // 终止条件:到达终点        if (x == n) {            result.add(new ArrayList<>(path));            return;        }
        // 遍历所有可能的下一个节点 (1 到 n)        for (int i = 1; i <= n; i++) {            // 1. 判断是否有边相连 (graph[x][i] == 1)            // 2. 【剪枝】判断节点 i 是否已经在当前路径中 (避免成环)            if (graph[x][i] == 1 && !visited[i]) {
                // 做选择                visited[i] = true; // 标记为已访问                path.add(i); // 加入路径
                // 递归                dfs(graph, i, n);
                // 回溯                path.remove(path.size() - 1); // 移除路径末尾                visited[i] = false; // 取消标记,允许其他路径经过该节点            }        }    }
    public static void main(String[] args) {        Scanner scanner = new Scanner(System.in);        if (!scanner.hasNextInt()) return;
        int n = scanner.nextInt(); // 节点数        int m = scanner.nextInt(); // 边数
        // 初始化邻接矩阵        int[][] graph = new int[n + 1][n + 1];
        for (int i = 0; i < m; i++) {            int s = scanner.nextInt();            int t = scanner.nextInt();            // 题目通常为有向图:s -> t            // 如果题目明确说是无向图,则需要加上: graph[t][s] = 1;            graph[s][t] = 1;        }
        // 初始化 visited 数组        visited = new boolean[n + 1];
        // 初始化起点        path.add(1);        visited[1] = true;
        // 开始 DFS        dfs(graph, 1, n);
        // 输出结果        if (result.isEmpty()) {            System.out.println(-1);        } else {            for (List<Integer> pa : result) {                for (int i = 0; i < pa.size() - 1; i++) {                    System.out.print(pa.get(i) + " ");                }                System.out.println(pa.get(pa.size() - 1));            }        }
        scanner.close();    }}
import java.util.ArrayList;import java.util.LinkedList;import java.util.List;import java.util.Scanner;
public class Main { static List<List<Integer>> result = new ArrayList<>(); static List<Integer> path = new ArrayList<>(); // 记录当前路径上已经访问过的节点,防止成环 static boolean[] visited;
public static void dfs(List<LinkedList<Integer>> graph, int x, int n) { if (x == n) { result.add(new ArrayList<>(path)); return; }
for (int i : graph.get(x)) { // 剪枝:如果节点 i 已经在当前路径中出现过,说明有环,跳过 if (visited[i]) { continue; }
// 标记为已访问 visited[i] = true; path.add(i);
dfs(graph, i, n);
// 回溯:撤销选择,同时撤销访问标记 path.remove(path.size() - 1); visited[i] = false; } }
public static void main(String[] args) { Scanner scanner = new Scanner(System.in); if (!scanner.hasNextInt()) return;
int n = scanner.nextInt(); int m = scanner.nextInt();
// 初始化 visited 数组 visited = new boolean[n + 1];
List<LinkedList<Integer>> graph = new ArrayList<>(n + 1); for (int i = 0; i <= n; i++) { graph.add(new LinkedList<>()); }
while (m-- > 0) { int s = scanner.nextInt(); int t = scanner.nextInt(); graph.get(s).add(t); }
// 初始化起点 path.add(1); visited[1] = true; // 起点也要标记
dfs(graph, 1, n);
if (result.isEmpty()) { System.out.println(-1); } else { for (List<Integer> pa : result) { for (int i = 0; i < pa.size() - 1; i++) { System.out.print(pa.get(i) + " "); } System.out.println(pa.get(pa.size() - 1)); } } }}广度优先搜索 BFS#
-
无权图最短路径
-
多源扩散类问题
广度优先遍历是一种由近及远的遍历方式,从某个节点出发,始终优先访问距离最近的顶点,并一层层向外扩张
当然,也有一些问题广搜和深搜都可以解决,例如岛屿问题,这类问题的特征就是不涉及具体的遍历方式,只要能把相邻且相同属性的节点标记上就行
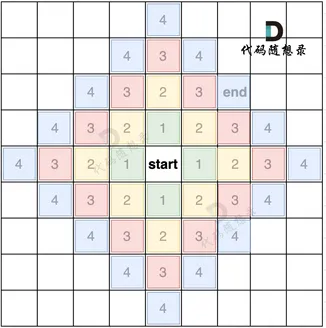
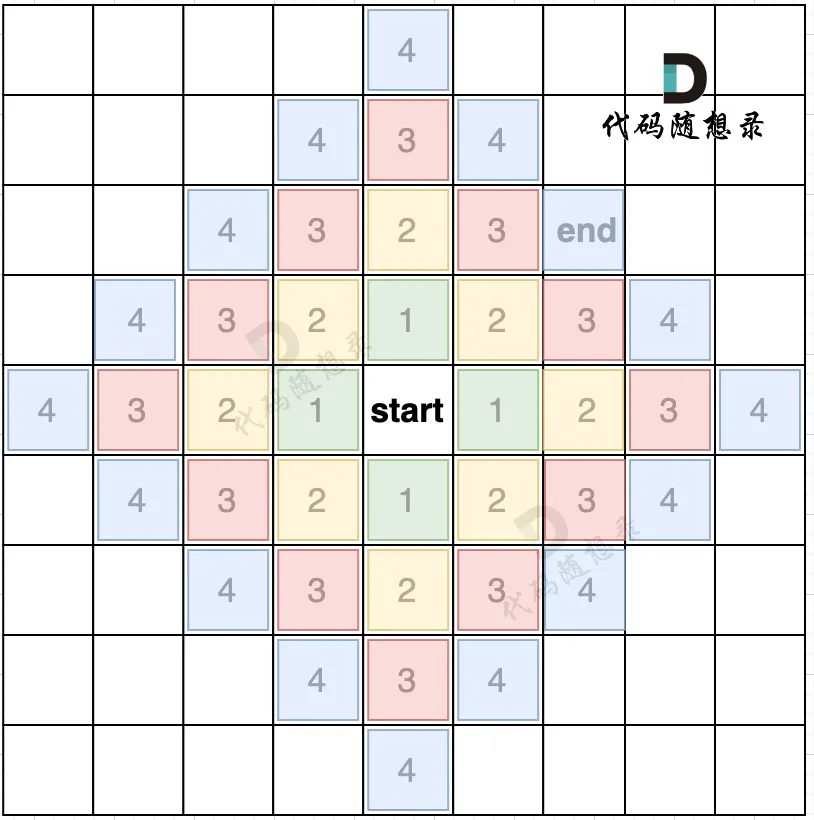
从 start 起点开始,一圈一圈向外搜索,方格编号1为第一步遍历的节点,方格编号2为第二步遍历的节点,第四步的时候我们找到终止点 end
地图还可以有障碍,如图所示:
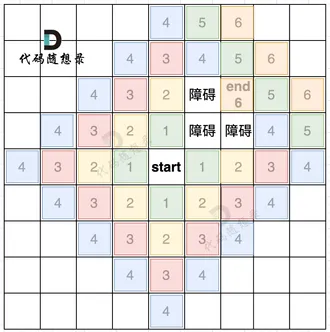
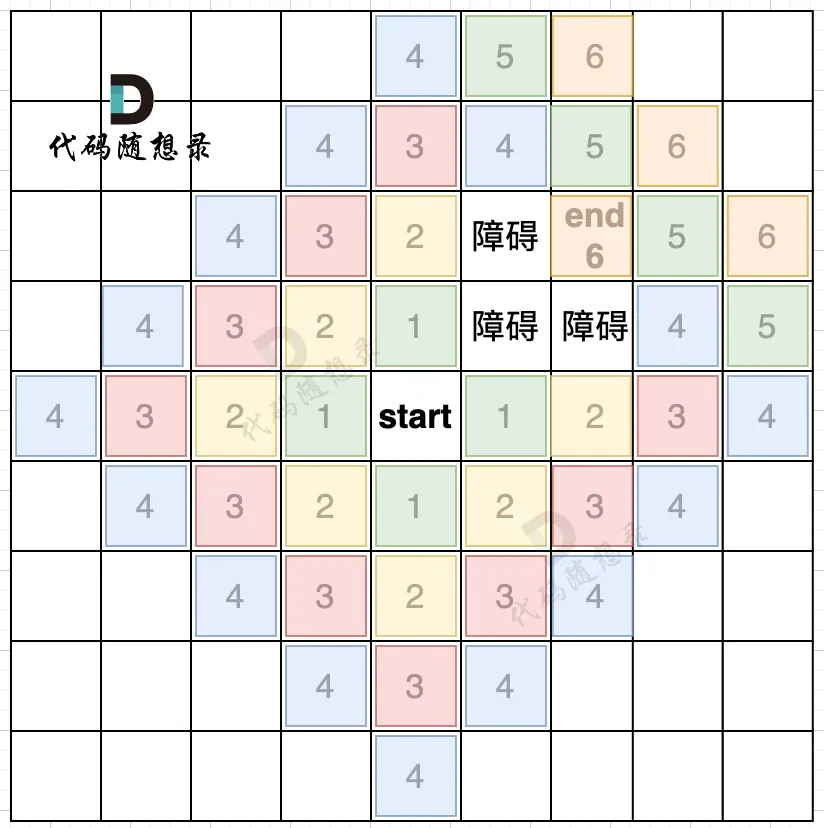
BFS只能让你根据找邻接节点的顺序得到其中一条最短路径,而无法一次性得到所有最短路径
之所以是其中一条,是因为BFS只要求按“由近及远”的顺序遍历,而多个相同距离的顶点的遍历顺序允许被打乱
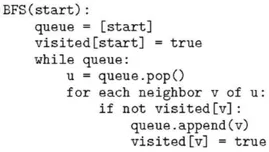
代码框架:
- BFS 通常借助队列来实现,用于存储待访问的节点
- 为了防止重复遍历顶点,还需要一个哈希集合
visited来记录哪些节点已被访问
- 将遍历起始顶点加入队列并标记为已访问,开启循环
- 在循环的每轮迭代中,弹出队首顶点并记录访问,然后将该顶点的所有未访问过的邻接顶点加入到队列尾部
- 循环步骤
2.,直到所有顶点被访问完毕后结束
注意:
- 如果要进行搜索而非全部遍历,可以在出队后或入队时进行终止条件判断;
- 分层处理,加一层 for 循环,用 sz 存储当前层的节点数量控制每层的遍历
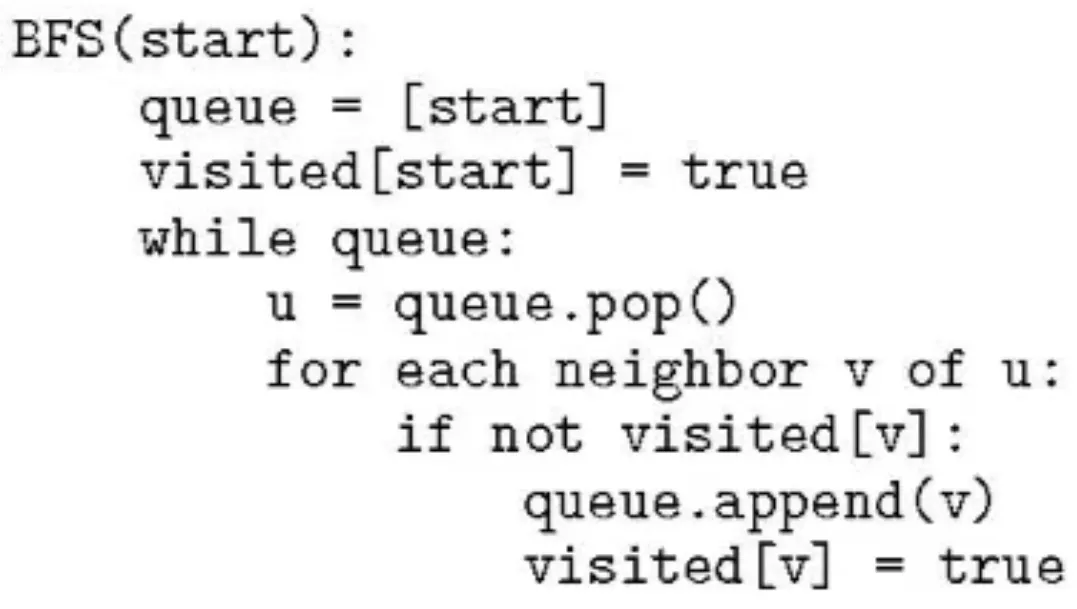
// 1、确认初始化:队列、访问记录static void bfs(参数:图, 起点, 终点) {    // 创建队列,用于存储待访问的节点    Queue<节点类型> queue = new LinkedList<>();    // 创建集合,用于记录已访问过的节点 (防止重复访问和死循环)    Set<节点类型> visited = new HashSet<>();    // 初始化:将起点入队,并标记为已访问    queue.offer(起点);    visited.add(起点);
    // (可选) 如果需要记录层数/步数    int step = 0;
    // 2、确认循环终止条件:队列不为空    while (!queue.isEmpty()) {        // 【关键点】获取当前层的节点数量        // 如果不需要分层处理(比如只需要遍历所有),这行可以省略        // 如果需要计算最短路径步数,必须用这个 sz 来控制层数        int sz = queue.size();
        // 遍历当前层的所有节点        for (int i = 0; i < sz; i++) {            // 3、处理目前搜索节点:出队            节点类型 cur = queue.poll();
            // --- 终止条件判断 ---            // 注意:DFS 通常在递归入口处判断终止,BFS 可以在出队时判断,也可以在入队时判断            if (cur == 终点) {                存放结果;                return; // 找到目标,直接返回            }
// 4、扩展节点:遍历当前节点所能到的所有邻居 for (节点类型 neighbor : cur 的所有邻居) { // 剪枝:如果未访问过,才加入队列 if (!visited.contains(neighbor)) { // 处理节点:标记为已访问 //【⚠️注意】必须在入队时标记,防止重复入队 visited.add(neighbor); // 入队:将邻居加入队列,等待下一轮处理 queue.offer(neighbor); } } } // (可选) 如果遍历完了一层,步数 +1 step++; } // 如果队列空了还没找到,说明无解 return;}// 不需要初始化visited,bfs里会初始化bfs(graph, 起点, 终点);【🔥】200岛屿数量(DFS/BFS)#
给你一个由
'1'(陆地)和'0'(水)组成的的二维网格,请你计算网格中岛屿的数量。岛屿总是被水包围,并且每座岛屿只能由水平方向和/或竖直方向上相邻的陆地连接形成。
此外,你可以假设该网格的四条边均被水包围。
本题思路是每遇到一个没有遍历过的节点陆地,计数器就加一,然后把该节点陆地及其所能遍历到的陆地都标记上,在遇到标记过的陆地节点和海洋节点的时候直接跳过。 这样计数器就是最终岛屿的数量
如何把节点陆地所能遍历到的陆地都标记上呢,可以使用 DFS,BFS或者并查集
- 岛屿数量 = 涂色游戏。涂过的地方就是那个颜色,不用擦掉重涂 -> 不用回溯
- 回溯算法 = 走迷宫试错。此路不通,退回来擦掉脚印,换条路走 -> 必须回溯
在 LeetCode 上做“岛屿数量”、“腐烂的橘子”、“单词接龙(部分)”等题目时,因为地图天然是矩形网格(二维数组),不需要额外构建邻接矩阵/表,而是通过坐标计算邻居;并且可以直接用二维数组作为visited保存已访问的节点
// 隐式地获取邻居int[][] dir ={{0,1},{1,0},{-1,0},{0,-1}};boolean[][] visited;for (int i = 0; i < 4; i++) { int nextX=x+dir[i][0]; int nextY=y+dir[i][1]; ...}// DFSimport java.util.Scanner;class Solution { static int[][] dir = {{0,1},{1,0},{-1,0},{0,-1}}; static boolean[][] visited; static void dfs(int [][]grid,int x,int y) { for (int i = 0; i < 4; i++) { int nextX = x+dir[i][0]; int nextY = y+dir[i][1]; // 边界检查 if(nextY<0||nextX<0||nextX>= grid.length||nextY>=grid[0].length) continue; // 跳过水或已访问的节点 if(!visited[nextX][nextY] && grid[nextX][nextY]==1){ visited[nextX][nextY] = true; dfs(grid,nextX,nextY); } } } public static void main(String[] args) { Scanner sc = new Scanner(System.in); int m = sc.nextInt(); int n = sc.nextInt(); int[][] grid = new int[n][m]; for (int i = 0; i < n; i++) { for (int j = 0; j < m; j++) { grid[i][j] = sc.nextInt(); } } visited = new boolean[n][m]; int res = 0; for (int i = 0; i < n; i++) { for (int j = 0; j < m; j++) { if(!visited[i][j] && grid[i][j]==1){ res++; visited[i][j] = true; dfs(grid,i,j); } } } System.out.println(res); }}// BFSimport java.util.LinkedList;import java.util.Queue;import java.util.Scanner;public class Main { static int[][] dir = {{0, 1}, {1, 0}, {0, -1}, {-1, 0}}; static boolean[][] visited; static class Node { int x,y; public Node(int x, int y) { this.x = x; this.y = y; } } static void bfs(int[][] grid, int x, int y) { Queue<Node> queue = new LinkedList<>();// 定义坐标队列,没有现成的Node类,需要自定义 visited[x][y] = true;// 入队时直接标记为优先 queue.offer(new Node(x, y)); while (!queue.isEmpty()) { Node node = queue.poll(); // 当前横纵坐标 for (int i = 0; i < 4; i++) { // 遍历新节点next,下面记录坐标 int nextX = node.x + dir[i][0]; int nextY = node.y + dir[i][1]; // 边界检查 if (nextX < 0 || nextX >= grid.length || nextY < 0 || nextY >= grid[0].length) { continue; } // 跳过水或已访问的节点 if (!visited[nextX][nextY] && grid[nextX][nextY] == 1) { visited[nextX][nextY] = true; queue.offer(new Node(nextX, nextY)); } } } }
public static void main(String[] args) { Scanner sc = new Scanner(System.in); int n = sc.nextInt(); int m = sc.nextInt(); int[][] grid = new int[n][m]; visited = new boolean[n][m]; int res = 0; for (int i = 0; i < n; i++) { for (int j = 0; j < m; j++) { grid[i][j] = sc.nextInt(); } } for (int i = 0; i < n; i++) { for (int j = 0; j < m; j++) { if (!visited[i][j] && grid[i][j] == 1) { res++; bfs(grid, i, j); } } } System.out.println(res); }}695岛屿的最大面积(DFS/BFS)#
给你一个大小为
m x n的二进制矩阵grid。岛屿 是由一些相邻的
1(代表土地) 构成的组合,这里的「相邻」要求两个1必须在 水平或者竖直的四个方向上 相邻。你可以假设grid的四个边缘都被0(代表水)包围着。岛屿的面积是岛上值为
1的单元格的数目。计算并返回
grid中最大的岛屿面积。如果没有岛屿,则返回面积为0。
// DFSimport java.util.*;import java.math.*;public class Main{ static int[][] dir={{0,1},{1,0},{0,-1},{-1,0}}; static int result=0; static int count=0; static boolean[][] visited; static void dfs(int[][] grid,int x,int y){ for (int i = 0; i < 4; i++) { int nextX=x+dir[i][0]; int nextY=y+dir[i][1]; // 边界检查 if (nextX < 0 || nextY < 0 || nextX >= grid.length || nextY >= grid[0].length) continue; // 跳过水或已访问的节点 if (!visited[nextX][nextY] && grid[nextX][nextY] == 1) { visited[nextX][nextY] = true; count++; dfs(grid,nextX,nextY); } } } public static void main(String[] args){ Scanner scanner = new Scanner(System.in); int n = scanner.nextInt(); int m = scanner.nextInt(); int[][] grid = new int[n][m]; for (int i = 0; i < n; i++) { for (int j = 0; j < m; j++) { grid[i][j]=scanner.nextInt(); } } visited = new boolean[n][m]; for (int i = 0; i < n; i++) { for (int j = 0; j < m; j++) { if(!visited[i][j]&&grid[i][j]==1){ count=1; visited[i][j]=true; dfs(grid,i,j); result= Math.max(count, result); } } } System.out.println(result); }}// BFSimport java.util.*;import java.math.*;public class Main { static class Node { int x; int y;
public Node(int x, int y) { this.x = x; this.y = y; } }
static final int[][] dir = {{0, 1}, {1, 0}, {0, -1}, {-1, 0}}; static boolean[][] visited; static int result = 0; static int count = 0;
static void bfs(int[][] grid, int x, int y) { Queue<Node> q = new LinkedList<>(); q.add(new Node(x, y)); visited[x][y] = true; count++; while (!q.isEmpty()) { Node node = q.remove(); for (int i = 0; i < 4; i++) { int nextX = node.x + dir[i][0]; int nextY = node.y + dir[i][1]; // 边界检查 if (nextX < 0 || nextY < 0 || nextX >= grid.length || nextY >= grid[0].length) continue; // 跳过水或已访问的节点 if (!visited[nextX][nextY] && grid[nextX][nextY] == 1) { q.add(new Node(nextX, nextY)); visited[nextX][nextY] = true; count++; } } } }
public static void main(String[] args) { Scanner scanner = new Scanner(System.in); int n = scanner.nextInt(); int m = scanner.nextInt(); int[][] grid = new int[n][m]; for (int i = 0; i < n; i++) { for (int j = 0; j < m; j++) { grid[i][j] = scanner.nextInt(); } } visited = new boolean[n][m]; for (int i = 0; i < n; i++) { for (int j = 0; j < m; j++) { if (!visited[i][j] && grid[i][j] == 1) { count = 0; bfs(grid, i, j); result = Math.max(count, result);
} } } System.out.println(result); }}【🔥中】994腐烂的橘子(多源搜索BFS)#
在给定的
m x n网格grid中,每个单元格可以有以下三个值之一:
- 值
0代表空单元格;- 值
1代表新鲜橘子;- 值
2代表腐烂的橘子。每分钟,腐烂的橘子 周围 4 个方向上相邻 的新鲜橘子都会腐烂。
返回 直到单元格中没有新鲜橘子为止所必须经过的最小分钟数。如果不可能,返回
-1。
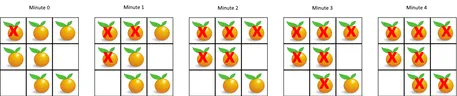
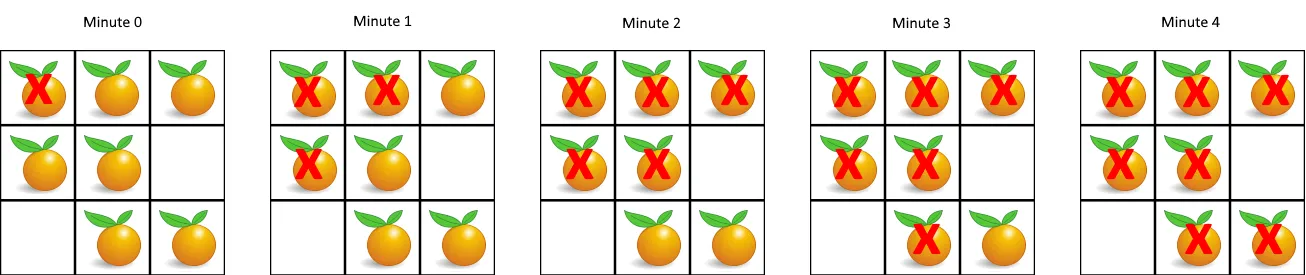
实际上就是求腐烂橘子到所有新鲜橘子的最短路径,因此用BFS
一开始,我们找出所有腐烂的橘子,将它们放入队列,作为第 0 层的结点
然后进行 BFS 遍历,每个结点的相邻结点可能是上、下、左、右四个方向的结点,注意判断结点位于网格边界的特殊情况
由于可能存在无法被污染的橘子,我们需要记录新鲜橘子的数量。在 BFS 中,每遍历到一个橘子(污染了一个橘子),就将新鲜橘子的数量减一。如果 BFS 结束后这个数量仍未减为零,说明存在无法被污染的橘子
public int orangesRotting(int[][] grid) {    int[][] dir = {{0, 1}, {1, 0}, {0, -1}, {-1, 0}};    int m = grid.length;    int n = grid[0].length;    Queue<int[]> queue = new LinkedList<>();    int count = 0; // 新鲜橘子数量
    // 遍历网格,将所有初始腐烂橘子加入队列,并统计新鲜橘子数量    for (int i = 0; i < m; i++) {        for (int j = 0; j < n; j++) {            if (grid[i][j] == 2) {                queue.offer(new int[]{i, j});            } else if (grid[i][j] == 1) {                count++;            }        }    }
    // 如果没有新鲜橘子,直接返回 0    if (count == 0) {        return 0;    }
    int minute = 0; // 分钟数    while (count>0 && !queue.isEmpty()) {        minute++;        int size = queue.size();        // 处理当前队列中的所有腐烂橘子        for (int i = 0; i < size; i++) {            int[] arr = queue.poll();            int x = arr[0];            int y = arr[1];
            // 遍历四个方向            for (int j = 0; j < 4; j++) {                int xNext = x + dir[j][0];                int yNext = y + dir[j][1];
// 检查边界条件和是否为新鲜橘子 if (xNext >= 0 && yNext >= 0 && xNext < m && yNext < n && grid[xNext][yNext] == 1) { // 将新鲜橘子变为腐烂橘子 grid[xNext][yNext] = 2; queue.offer(new int[]{xNext, yNext}); count--; } } } } // 如果还有新鲜橘子,返回-1,否则返回腐烂时间 return count>0 ? -1 : minute;}拓扑排序#
DAG(有向无环图)上的线性排序
适用场景:
- 课程/任务调度:例如先上A课才能上B课,上了B课才能上C课,上了A课才能上D课等,规划出一条完整的上课顺序
- 依赖关系解析:在做项目安装文件包的时候有复杂的文件依赖关系, A依赖B,B依赖C,C依赖E等,规划出一条依赖的下载顺序
两种实现方式:
-
DFS逆后序遍历:回溯时加入排序结果中,最后反转
-
Kahn‘s算法(BFS+入度):从入度为0的节点开始逐步剥离图
-
统计依赖关系、每个节点的入度
-
将入度为0的节点(第一个就是出发节点)加入队列
-
每次从队列取出节点并放入结果集,更新依赖它的所有节点的入度
-
循环2、3步,若所有节点都被访问,则排序成功(结果不唯一);否则存在环
-
有环的情况: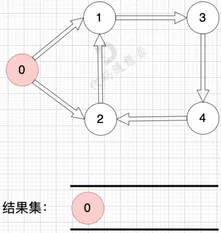
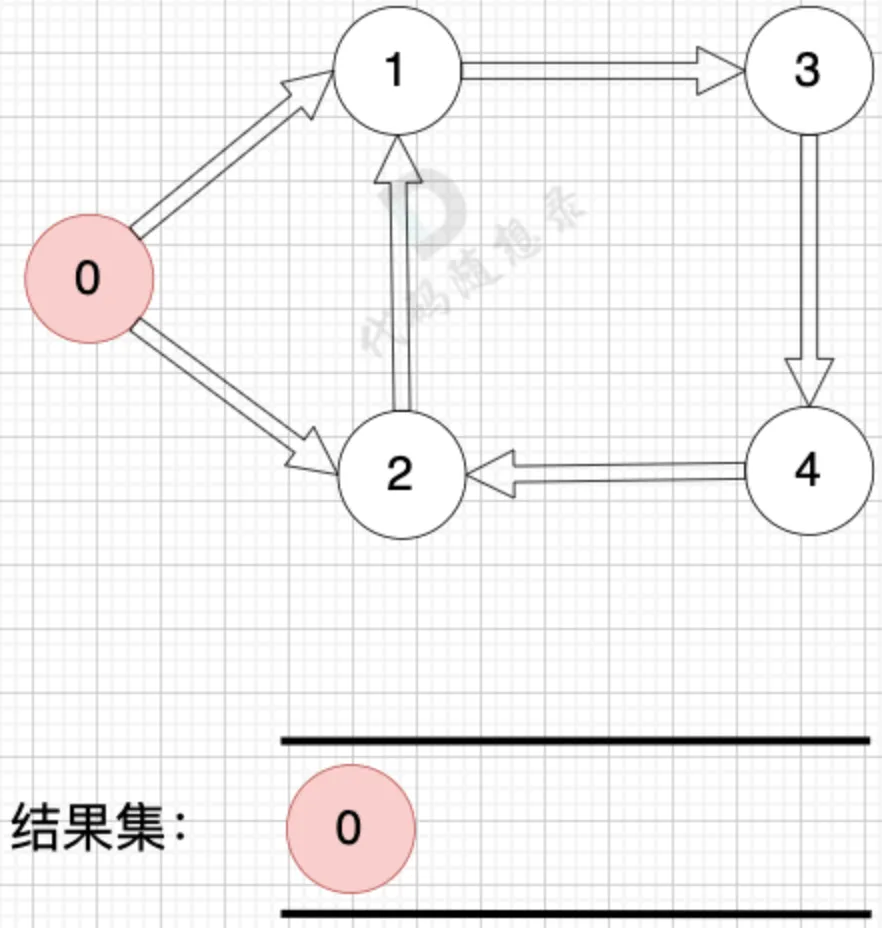
将入度为0的节点0放入结果之后,节点1、2、3、4 形成了环,找不到入度为0 的节点
代码框架:
List<List<Integer>> rely = new ArrayList<>(); // 记录依赖关系[被依赖节点:[依赖节点,依赖节点,...],...]int[] indeg; // 记录每个节点的入度for(int i=0;i<节点个数;i++)    rely.add(new ArrayList<>());
// 1. 统计依赖关系、每个节点的入度for(每个依赖关系,即被依赖节点->依赖节点){    rely.get(被依赖节点).add(依赖节点);    indeg[依赖节点]++;}
// 2. 将入度为0的出发节点加入队列Queue<Integer> queue = new LinkedList<>();for(int i=0;i<节点个数;i++)    if(indeg[i]==0) queue.offer(i);
List<Integer> result = new ArrayList<>();while(!queue.isEmpty()){ // 3. 每次从队列取出节点并放入结果 int cur = queue.poll(); result.add(cur); // ;更新依赖它的所有节点的入度 for (依赖节点 : rely.get(被依赖节点)) { inDegree[依赖节点]--; // ;将入度为0的出发节点加入队列 if (inDegree[依赖节点] == 0) { queue.offer(依赖节点); } }}// 4. 若所有节点都被访问,则排序成功if (result.size() == 节点个数) { return result;} else { // ;否则存在环 return null;}【🔥中】207课程表#
你这个学期必须选修
numCourses门课程,记为0到numCourses - 1。在选修某些课程之前需要一些先修课程。 先修课程按数组
prerequisites给出,其中prerequisites[i] = [ai, bi],表示如果要学习课程ai则 必须 先学习课程bi。
- 例如,先修课程对
[0, 1]表示:想要学习课程0,你需要先完成课程1。请你判断是否可能完成所有课程的学习?如果可以,返回
true;否则,返回false。
class Solution {    List<List<Integer>> edges;    int[] indeg;
    public boolean canFinish(int numCourses, int[][] prerequisites) {        edges = new ArrayList<List<Integer>>();        for (int i = 0; i < numCourses; ++i) {            edges.add(new ArrayList<Integer>());        }        indeg = new int[numCourses];        for (int[] info : prerequisites) {            edges.get(info[1]).add(info[0]);            ++indeg[info[0]];        }
        Queue<Integer> queue = new LinkedList<Integer>();        for (int i = 0; i < numCourses; ++i) {            if (indeg[i] == 0) {                queue.offer(i);            }        }
        int visited = 0;        while (!queue.isEmpty()) {            ++visited;            int u = queue.poll();            for (int v: edges.get(u)) {                --indeg[v];                if (indeg[v] == 0) {                    queue.offer(v);                }            }        }        return visited == numCourses;    }}
210课程表 II#
返回你为了学完所有课程所安排的学习顺序。可能会有多个正确的顺序,你只要返回 任意一种 就可以了。如果不可能完成所有课程,返回 一个空数组 。
class Solution {    // 存储有向图    List<List<Integer>> edges;    // 存储每个节点的入度    int[] indeg;    // 存储答案    int[] result;    // 答案下标    int index;
    public int[] findOrder(int numCourses, int[][] prerequisites) {        edges = new ArrayList<List<Integer>>();        for (int i = 0; i < numCourses; ++i) {            edges.add(new ArrayList<Integer>());        }        indeg = new int[numCourses];        result = new int[numCourses];        index = 0;        for (int[] info : prerequisites) {            edges.get(info[1]).add(info[0]);            ++indeg[info[0]];        }
        Queue<Integer> queue = new LinkedList<Integer>();        // 将所有入度为 0 的节点放入队列中        for (int i = 0; i < numCourses; ++i) {            if (indeg[i] == 0) {                queue.offer(i);            }        }
        while (!queue.isEmpty()) {            // 从队首取出一个节点            int u = queue.poll();            // 放入答案中            result[index++] = u;            for (int v: edges.get(u)) {                --indeg[v];                // 如果相邻节点 v 的入度为 0,就可以选 v 对应的课程了                if (indeg[v] == 0) {                    queue.offer(v);                }            }        }
if (index != numCourses) { return new int[0]; } return result; }}Dijkstra算法#
【🔥中】208实现Trie(前缀树)#
Trie(发音类似 “try”)或者说 前缀树 是一种树形数据结构,用于高效地存储和检索字符串数据集中的键。这一数据结构有相当多的应用情景,例如自动补全和拼写检查。
请你实现 Trie 类:
Trie()初始化前缀树对象。void insert(String word)向前缀树中插入字符串word。boolean search(String word)如果字符串word在前缀树中,返回true(即,在检索之前已经插入);否则,返回false。boolean startsWith(String prefix)如果之前已经插入的字符串word的前缀之一为prefix,返回true;否则,返回false。
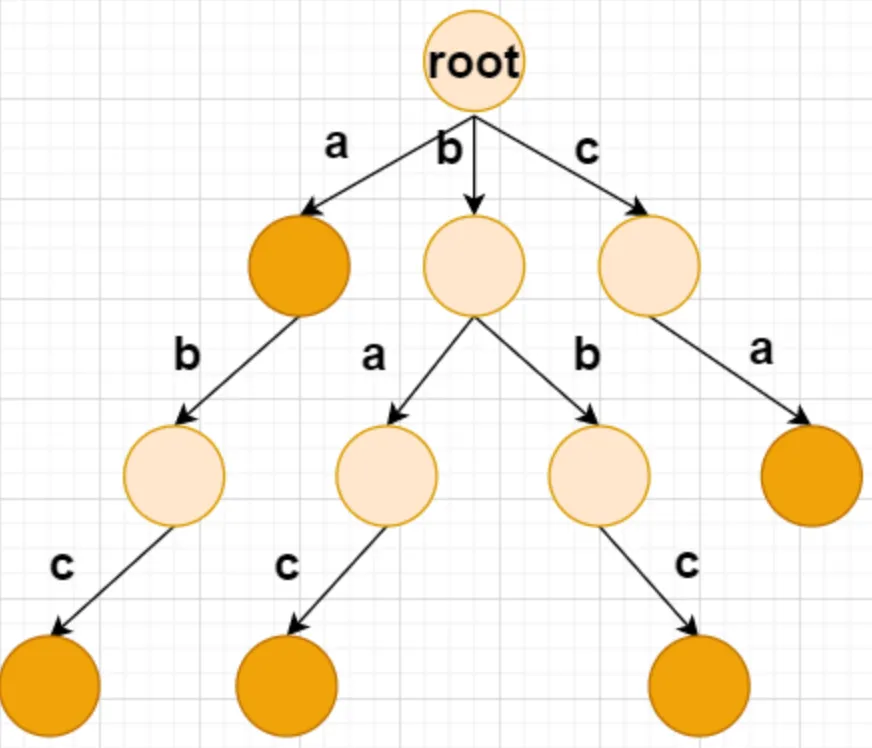
字典树,顾名思义,是关于“字典”的一棵树。即:它是对于字典的一种存储方式。这个词典中的每个“单词”就是从根节点出发一直到某一个目标节点的路径,路径中每条边的字母连起来就是一个单词
标橙色的节点是“目标节点“,即根节点到这个目标节点的路径上的所有字母构成了一个单词
具体操作:
1、定义字典树节点,每个节点都预设26个子节点 “Trie[] children对应26个字符,并设置目标节点标志boolean isEnd`
初始化时只需
- children = new Trie[26];
- isEnd = false;
2、向字典树中插入一个单词
从根结点出发,沿着字符串的字符一直往下走,若某一字符不存在,则直接把它创建出来,继续走下去,走完了整个单词,标记最后的位置 is_end = true
3、查找字典树中是否存在单词
从根结点出发,沿着字符串的字符一直往下走,若某一字符不存在,则直接 return false,当很顺利走到最后的位置的时候,判断最后一个位置的 is_end 即可
4、查找字典树中是否有以 prefix 为前缀的单词
从根结点出发,沿着字符串的字符一直往下走,若某一字符不存在,则直接 return false,如果顺利走到最后一个位置 return true
class Trie {    private Trie[] children;    private boolean isEnd;
    public Trie() {        children = new Trie[26];        isEnd = false;    }
    public void insert(String word) {        Trie node = this;        for (int i = 0; i < word.length(); i++) {            char ch = word.charAt(i);            int index = ch - 'a';            if (node.children[index] == null) {                node.children[index] = new Trie();            }            node = node.children[index];        }        node.isEnd = true;    }
    public boolean search(String word) {        Trie node = this;        for (int i = 0; i < word.length(); i++) {            char ch = word.charAt(i);            int index = ch - 'a';            if (node.children[index] == null) {                return false;            }            node = node.children[index];        }        return node.isEnd;    }
public boolean startsWith(String prefix) { Trie node = this; for (int i = 0; i < prefix.length(); i++) { char ch = prefix.charAt(i); int index = ch - 'a'; if (node.children[index] == null) { return false; } node = node.children[index]; } return true; }}/** * Your Trie object will be instantiated and called as such: * Trie obj = new Trie(); * obj.insert(word); * boolean param_2 = obj.search(word); * boolean param_3 = obj.startsWith(prefix); */八、回溯算法#
理论基础#
回溯算法是一种通过穷举来解决问题的方法,它的核心思想是从一个初始状态出发,暴力搜索所有可能的解决方案,当遇到正确的解则将其记录,直到找到解或者尝试了所有可能的选择都无法找到解为止
回溯算法通常采用“深度优先搜索”来遍历解空间
之所以称之为回溯算法,是因为该算法在搜索解空间时会采用“尝试”与“回退”的策略。当算法在搜索过程中遇到某个状态无法继续前进或无法得到满足条件的解时,它会撤销上一步的选择,退回到之前的状态,并尝试其他可能的选择
例题:在二叉树中搜索所有值为 7 的节点,请返回根节点到这些节点的路径,并要求路径中不包含值为 3 的节点。
// 前序遍历void preOrder(TreeNode root) { // 剪枝 if (root == null || root.val == 3) { return; } // 尝试 path.add(root); if (root.val == 7) { // 记录解 res.add(new ArrayList<>(path)); } preOrder(root.left); preOrder(root.right); // 回退 path.remove(path.size() - 1);}// main 函数可传入空列表[] 作为 state,root 作为 choices,空列表[] 作为 resvoid backtrack(List<TreeNode> state, List<TreeNode> choices, List<List<TreeNode>> res) { // 判断是否为解 // 如果状态不为空,且最后一个节点的值为 7,则找到解 if (!state.isEmpty() && state.get(state.size() - 1).val == 7) { // 记录解 // 注意:需要 new 一个新的 ArrayList,否则后续回退会影响结果 res.add(new ArrayList<>(state)); // 找到解后通常可以选择 return,或者继续寻找其他解(视题目要求而定) // return; }
// 遍历所有选择 for (TreeNode choice : choices) { // 剪枝:判断选择是否合法 // 节点不为空 且 节点值不为 3 if (choice != null && choice.val != 3) { // 尝试:做出选择,更新状态 state.add(choice);
// 进行下一轮选择 // 下一层的选择列表是当前节点的左右子节点 backtrack(state, Arrays.asList(choice.left, choice.right), res);
// 回退:撤销选择,恢复到之前的状态 state.remove(state.size() - 1); } }}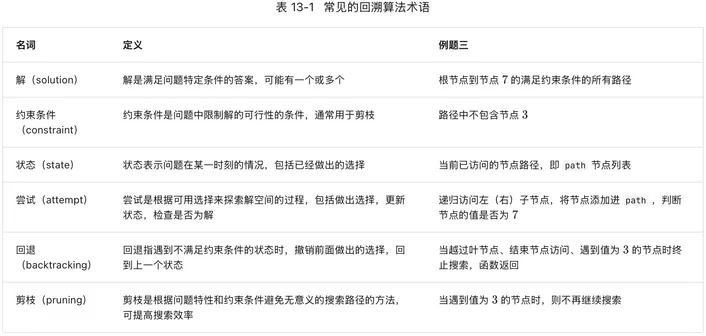
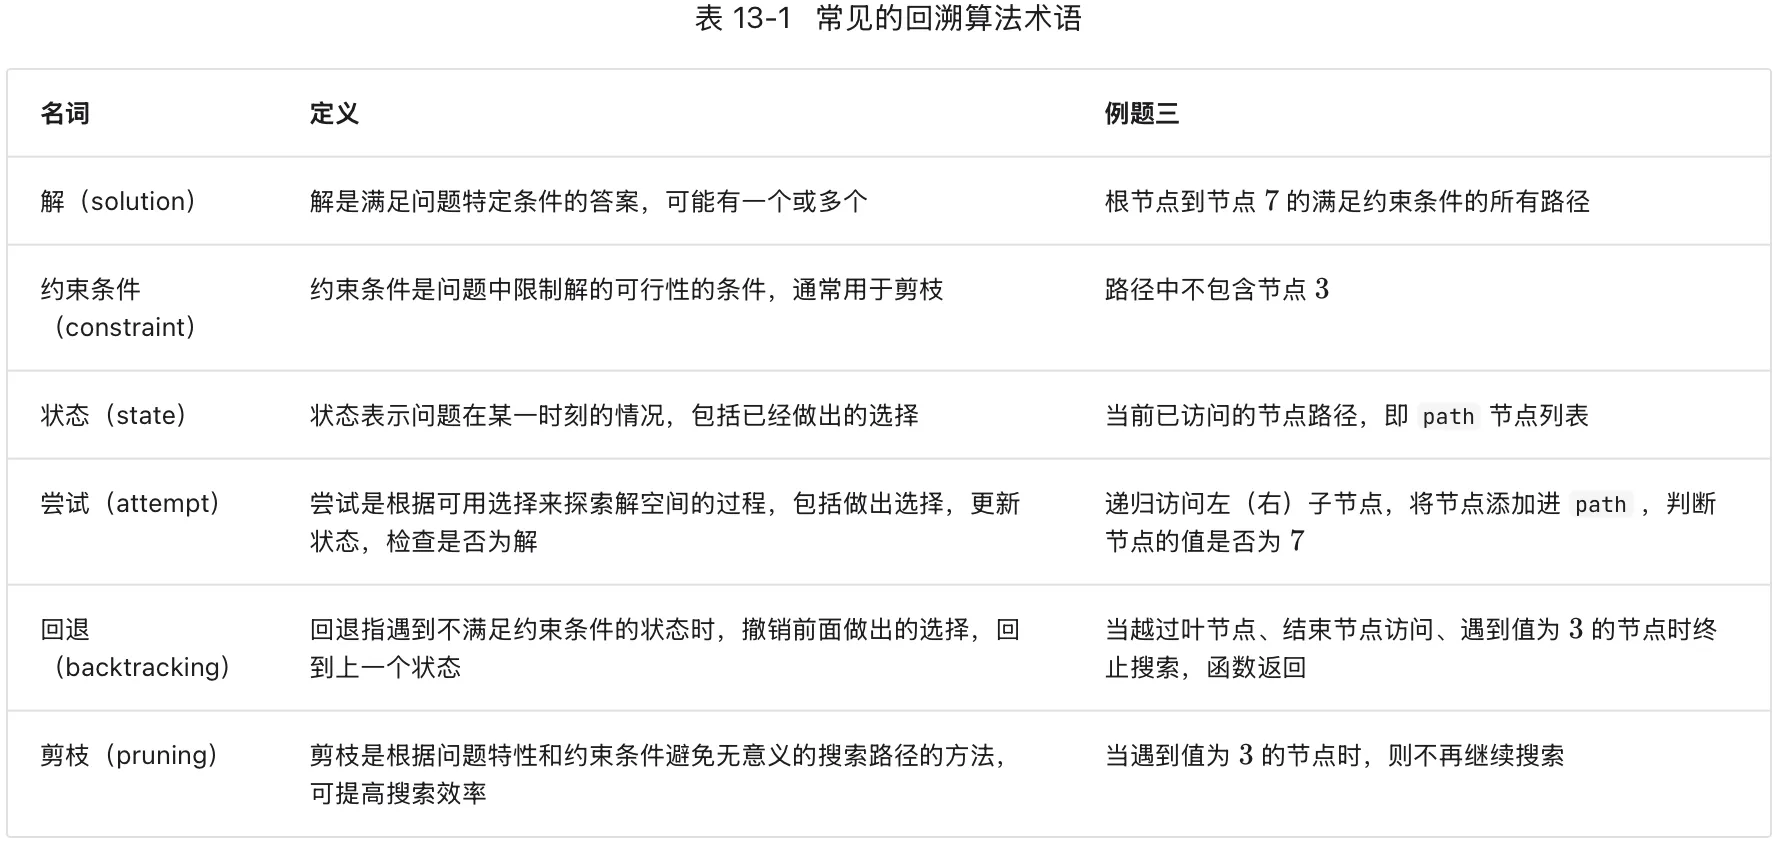
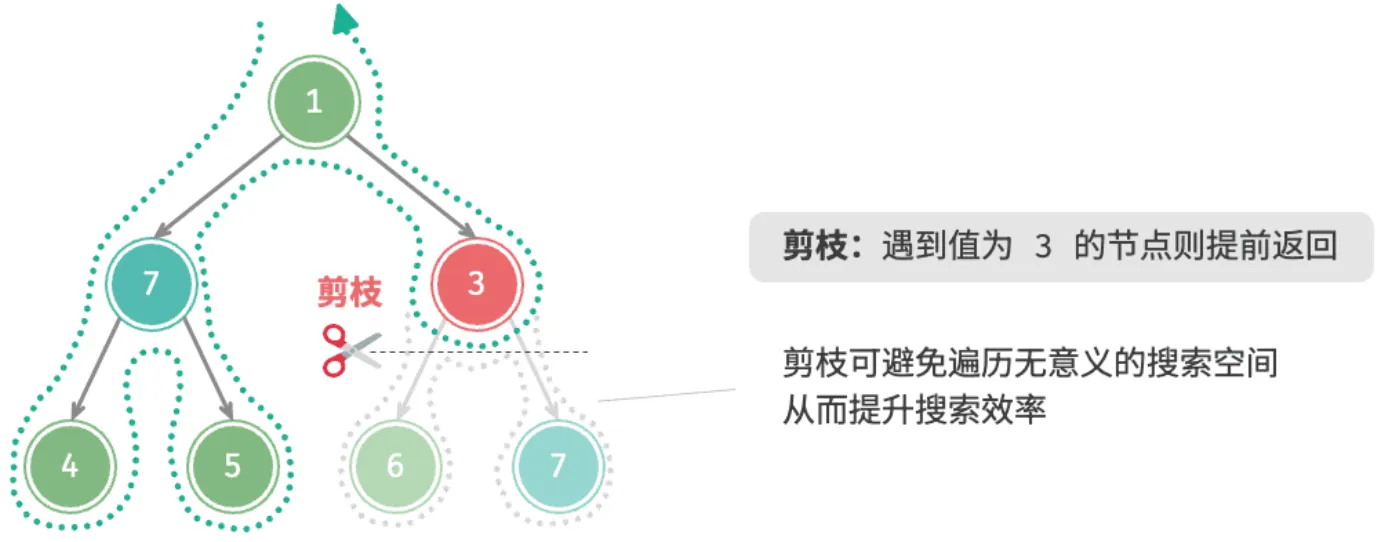
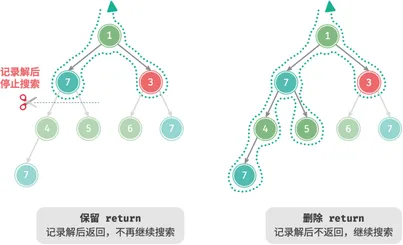
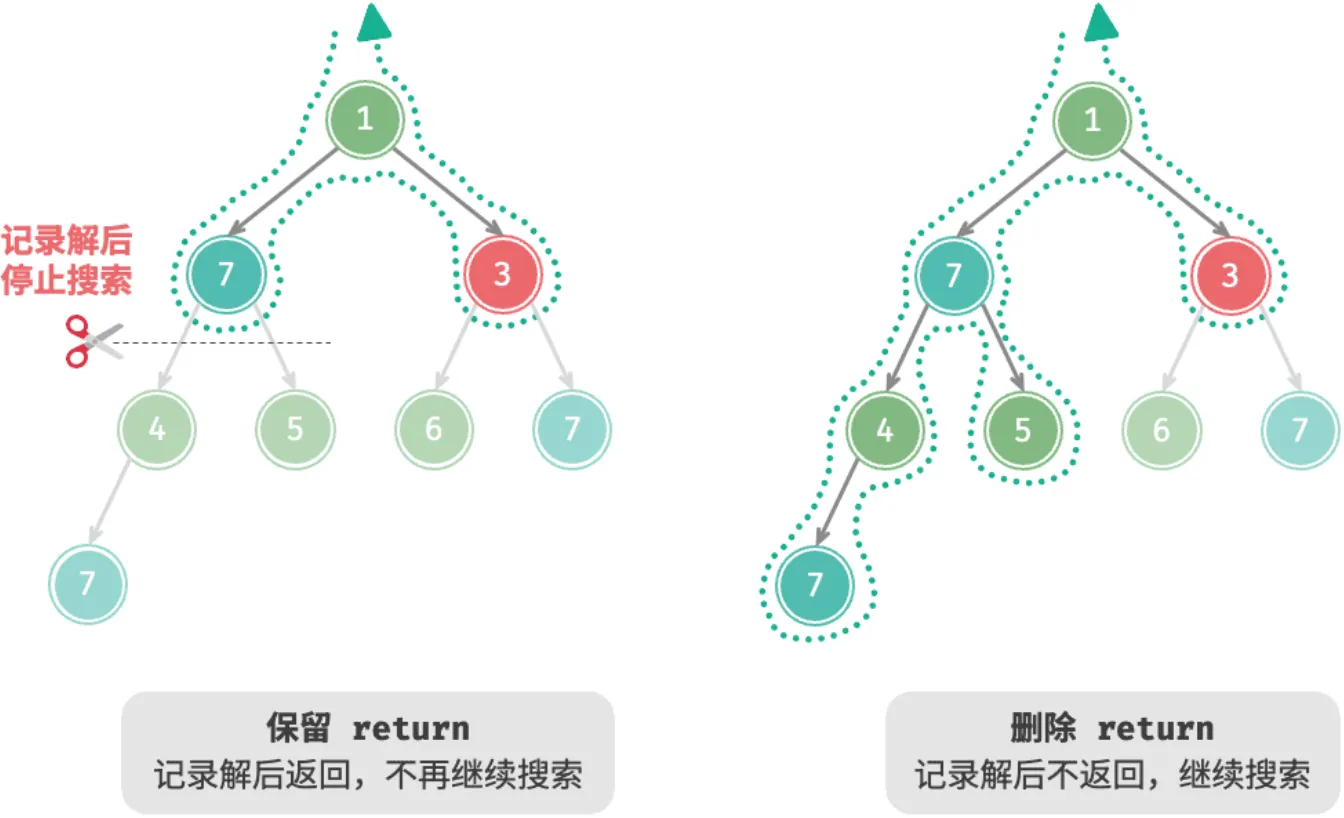
回溯算法是在用递归构建和搜索一棵“决策树”,而前序遍历是在用递归访问一棵已经存在的“数据树”
- 回溯算法的递归顺序是“决策驱动”的。它在每一层都通过一个循环来探索所有可能性,体现了搜索的本质。
- 前序遍历的递归顺序是“结构驱动”的。它只是简单地遵循树这种数据结构的固有访问顺序
回溯算法框架#
void backtrack(State state, List<Choice> choices, List<State> res) { // 【Base Case】判断是否为解 // 【⚠️注意】不能把 判断是否为解 放到 尝试 后,因为 state 无法通过后续的 undoChoice 还原 if (isSolution(state)) { // 记录解 recordSolution(state, res); // 不再继续搜索 return; } // 【遍历所有选择】 for (Choice choice : choices) { // 【剪枝】判断选择是否合法 if (isValid(state, choice)) { // 【尝试】做出选择,更新状态 makeChoice(state, choice); // 【进行下一轮选择】 backtrack(state, choices, res); // 【回退】撤销选择,恢复到之前的状态 undoChoice(state, choice); } }}一、排列问题(排列区分顺序)#
choices是输入数组中的所有元素,并且不会随着递归而更新(而之前的搜索树例题则是每次递归都会更新不同的 choices)- 状态
state是直至目前已被选择的元素
1、Base Case
全排列:当状态长度等于元素数量时,记录解
if (state.size() == choices.length) { res.add(new ArrayList<Integer>(state)); return;}2、基础题型:元素无重可以复选,不需要剪枝
// 方法定义:state、choices、resvoid backtrack(List<Integer> state, int[] choices, List<List<Integer>> res){3、变型1:元素无重不可复选
不可复选的剪枝:整个搜索过程中只有一个布尔型数组 selected。它记录的是当前状态中包含哪些元素,其作用是避免某个元素在 state 中重复出现
// 方法定义:state、choices、res + 不可复选 selectedvoid backtrack(List<Integer> state, int[] choices, boolean[] selected, List<List<Integer>> res){// 调用方法(初始化selected数组要定义长度)backtrack(new ArrayList<Integer>(), nums, new boolean[nums.length], res);if (selected[i]) continue;selected[i] = true;state.add(choices[i]);backtrack(state, choices, selected, res);selected[i] = false;state.remove(state.size() - 1);4、变型2:元素有重不可复选
元素有重的剪枝:将数组排序,当代码执行到 nums[i] 时,如果 nums[i] == nums[i-1],
- 情况 A:
used[i-1] == true- 说明
nums[i-1]在当前路径(树枝)上已经被使用了 - 例如:路径是
[1(下标0), ...],现在正在尝试填第二个位置,选1(下标1) - 这是允许的。我们要构造
[1, 1, 2]这种结果,必须允许同一个分支里出现重复元素
- 说明
- 情况 B:
used[i-1] == false- 说明
nums[i-1]刚刚被撤销,或者根本没选 - 这意味着:在当前的
for循环(同一层)中,我们已经尝试过选nums[i-1]了,并且已经把它回溯完了(把它拿出来了) - 现在循环到了
nums[i],发现它和nums[i-1]一样。既然刚才选nums[i-1]已经把该探索的情况都探索完了,现在选nums[i]就会产生完全重复的分支
- 说明
Arrays.sort(nums);if (selected[i]) continue;if (i > 0 && choices[i] == choices[i - 1] && !selected[i - 1]) continue;⚠️注意区分不可复选和元素有重的剪枝,下图展示了两个剪枝条件的生效范围
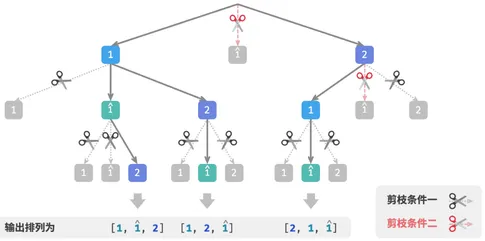
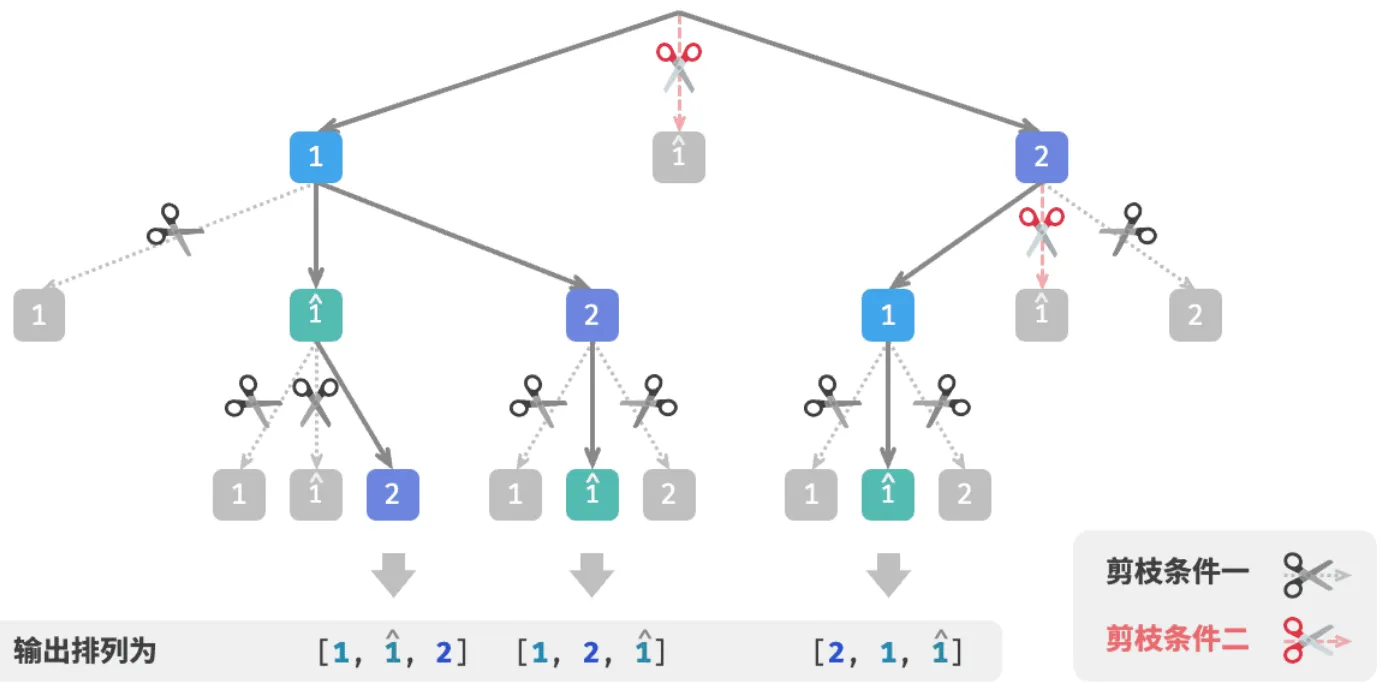
5、考虑要求的是 k 个数的排列
// 方法定义:state、choices、res + 不可复选 selected + 排列个数 kvoid backtrack(int k, List<Integer> state, int[] choices, boolean[] selected, List<List<Integer>> res){(1)Base Case 仅收集第 k 层的节点值即可
if (state.size() == k) { // 第 k 层节点的值就是⼤⼩为 k 的排列 res.add(new LinkedList(state)); return;}(2)元素个数的剪枝:通过 for 循环判断
for (int i = start; i <= choices.length - (k - state.size()) + 1; i++) {全排列问题#
在给定一个集合(如一个数组或字符串)的情况下,找出其中元素的所有可能的排列。
元素无重不可复选—【🔥中】46全排列#
输入一个整数数组,其中不包含重复元素,返回所有可能的排列。
从回溯算法的角度看,我们可以把生成排列的过程想象成一系列选择的结果。假设输入数组为 [1,2,3],如果我们先选择 1,再选择 3,最后选择 2,则获得排列 [1,3,2]。回退表示撤销一个选择,之后继续尝试其他选择
从回溯代码的角度看,候选集合 choices 是输入数组中的所有元素,并且不会随着递归而更新(而之前的搜索树例题则是每次递归都会更新不同的 choices),状态 state 是直至目前已被选择的元素。注意,每个元素只允许被选择一次,因此 state 中的所有元素都应该是唯一的
如下图所示,我们可以将搜索过程展开成一棵递归树,树中的每个节点代表当前状态 state 。从根节点开始,经过三轮选择后到达叶节点,每个叶节点都对应一个排列
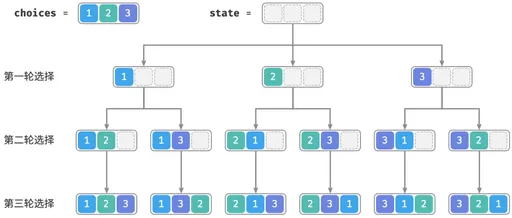
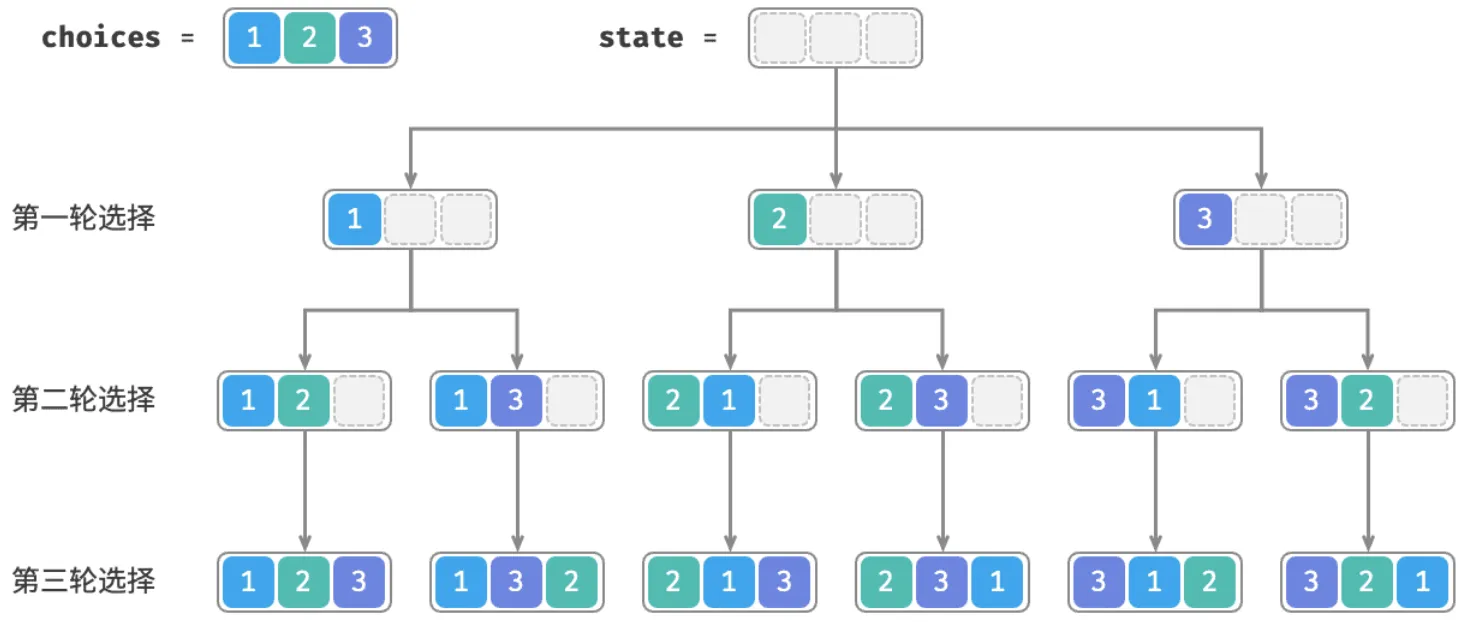
1、重复选择剪枝
为了实现每个元素只被选择一次,需要引入一个布尔型数组 selected(初始化时要定义长度为 nums.length),其中 selected[i] 表示 choices[i] 是否已被选择,并基于它实现以下剪枝操作
- 在做出选择
choice[i]后,就将selected[i]赋值为 True,代表它已被选择 - 遍历选择列表
choices时,跳过所有已被选择的节点,即剪枝
如下图所示,假设第一轮选择 1 ,第二轮选择 3 ,第三轮选择 2 ,则需要在第二轮剪掉元素 1 的分支,在第三轮剪掉元素 1 和元素 3 的分支
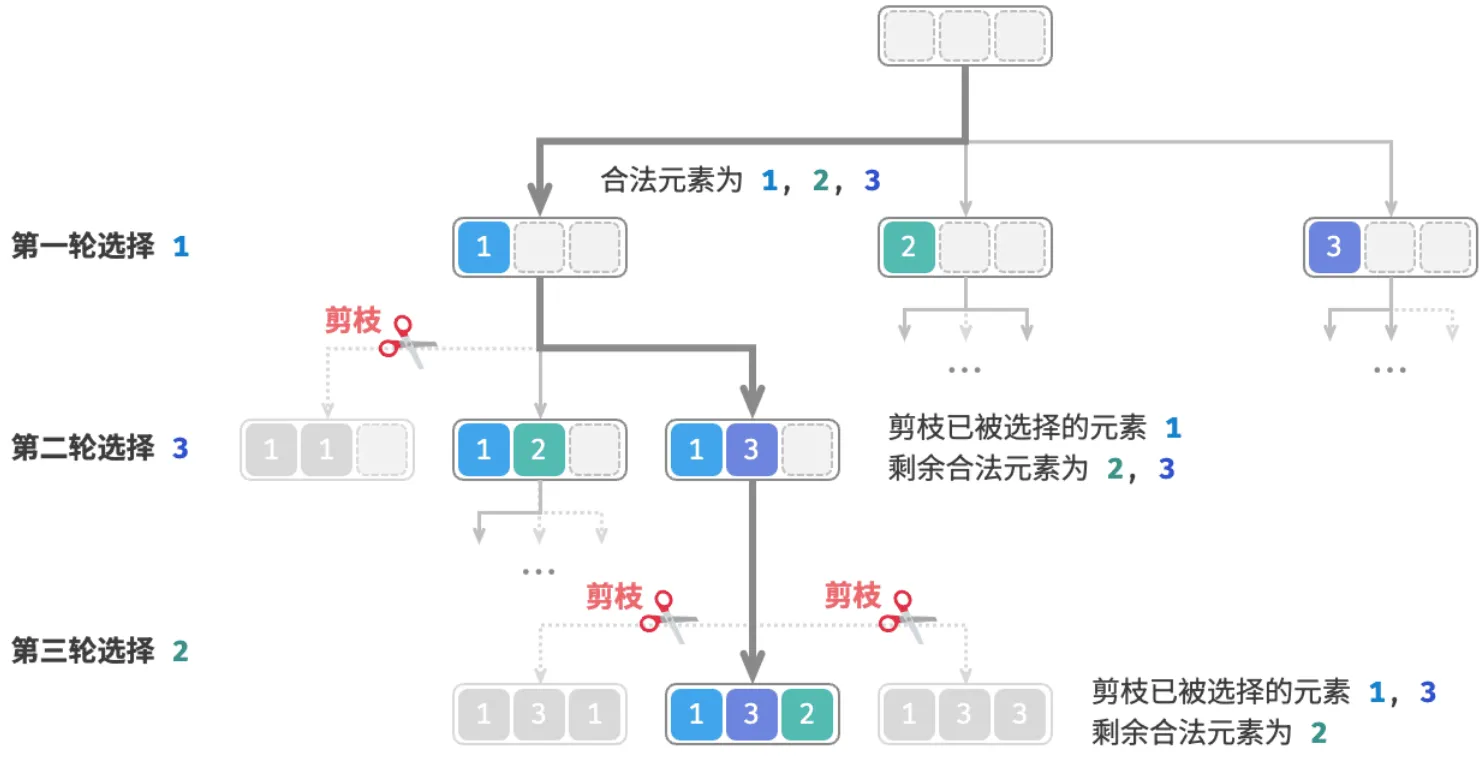
该剪枝操作将搜索空间大小从 O(n^n^) 减小至 O(n!)
2、代码实现
void backtrack(List<Integer> state, int[] choices, boolean[] selected, List<List<Integer>> res) { // 当状态长度等于元素数量时,记录解 if (state.size() == choices.length) { res.add(new ArrayList<Integer>(state)); return; } // 【遍历所有选择】 for (int i = 0; i < choices.length; i++) { // 【剪枝】不允许重复选择元素 if (selected[i]) continue; // 【尝试】做出选择,更新状态 selected[i] = true; state.add(choices[i]); // 【进行下一轮选择】 backtrack(state, choices, selected, res); // 【回退】撤销选择,恢复到之前的状态 selected[i] = false; state.remove(state.size() - 1); }}List<List<Integer>> permute(int[] nums) { List<List<Integer>> res = new ArrayList<List<Integer>>(); backtrack(new ArrayList<Integer>(), nums, new boolean[nums.length], res); return res;}元素有重不可复选—中 47全排列 II#
输入一个整数数组,数组中可能包含重复元素,返回所有不重复的排列。
假设输入数组为 [1,1,2],为了方便区分两个重复元素 1,将第二个 1 记为 1^
如下图所示,上述方法生成的排列有一半是重复的
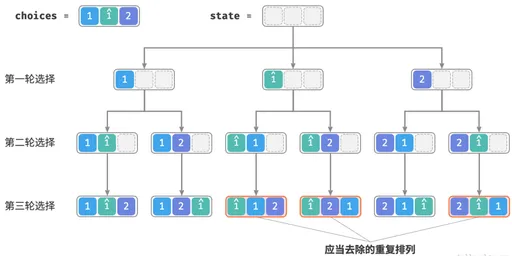
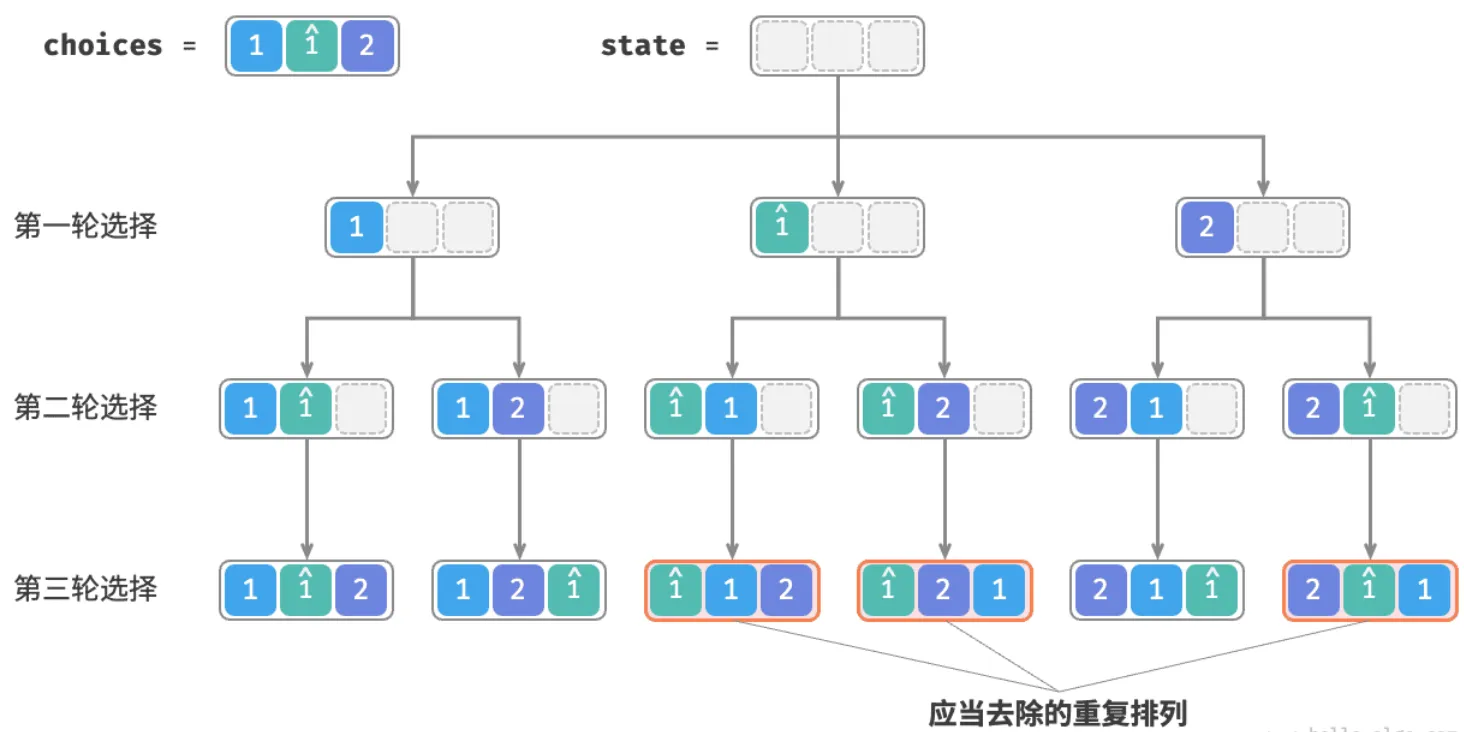
如何去除重复的排列呢?最直接地,可以借助一个哈希集合,直接对排列结果进行去重。然而这样做不够优雅,因为生成重复排列的搜索分支没有必要,应当提前识别并剪枝,进一步提升算法效率
1、相等元素剪枝
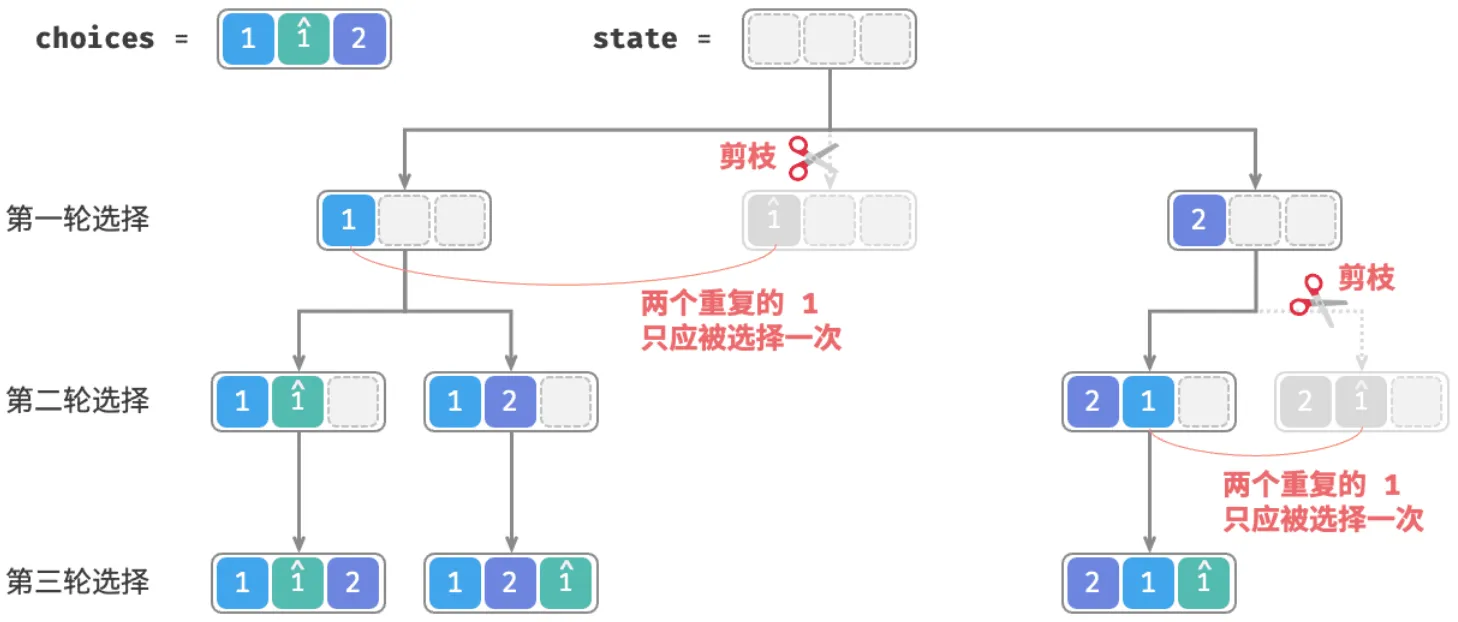
下图第一轮中,选择 1 或选择 1^ 是等价的,在这两个选择之下生成的所有排列都是重复的。因此应该把 1^ 剪枝
同理,在第一轮选择 2 之后,第二轮选择中的 1 和 1^ 也会产生重复分支,因此也应将第二轮的 1^ 剪枝
从本质上看,目标是在某一轮选择中,保证多个相等的元素仅被选择一次
2、代码实现
void backtrack(List<Integer> state, int[] choices, boolean[] selected, List<List<Integer>> res) { // 当状态长度等于元素数量时,记录解 if (state.size() == choices.length) { res.add(new ArrayList<Integer>(state)); return; } // 【遍历所有选择】 for (int i = 0; i < choices.length; i++) { // 【剪枝一 不可复选】 if (!selected[i]) continue; // 【剪枝二 元素有重】 if (i > 0 && choices[i] == choices[i - 1] && !selected[i - 1]) continue; // 【尝试】做出选择,更新状态 selected[i] = true; state.add(choices[i]); // 【进行下一轮选择】 backtrack(state, choices, selected, res); // 【回退】撤销选择,恢复到之前的状态 selected[i] = false; state.remove(state.size() - 1); }}List<List<Integer>> permutate(int[] nums) { Arrays.sort(nums); // 将数组排序 List<List<Integer>> res = new ArrayList<List<Integer>>(); backtrack(new ArrayList<Integer>(), nums, new boolean[nums.length], res); return res;}二、子集/组合问题(子集不区分顺序)#
choices 和 state 定义不变,但是递归过程中会借助 start 变量控制 choices 的可选项
1、Base Case:子集不需要判断,全部放入 res
res.add(new ArrayList<>(state));2、子集不区分元素顺序,比如 {4,5} 和 {5,4} 是同一个子集
重复子集的剪枝:使⽤ start 变量保证元素 nums[start] 之后只会出现 nums[start+1..] 中的元素,通过固定元素的相对位置保证不出现重复的⼦集
// 方法定义:state、choices、res + 不区分顺序 startvoid backtrack(List<Integer> state, int[] choices, int start, List<List<Integer>> res) {for (int i = start; i < choices.length; i++) {3、基础题型:元素无重可以复选
// 调用方法backtrack(state, choices, i, res); // 递归传入参数 `i`4、变型1:元素无重不可复选
不可复选的剪枝:递归传入参数 i+1
// 调用方法backtrack(state, choices, i+1, res);5、变型2:元素有重不可复选
元素有重的剪枝:将数组排序,因此相等元素都是相邻的。这意味着在某轮选择中,若当前元素与其左边元素相等,则说明它已经被选择过,直接跳过当前元素
Arrays.sort(nums);if (i > start && choices[i] == choices[i - 1]) continue;6、考虑要求的是 k 个数的组合
// 方法定义:state、choices、res + 不区分顺序 start + 组合个数 kvoid backtrack(int k, ArrayList<Integer> state, int[] choices, int start, List<List<Integer>> res){(1)base case
if (k == state.size()) { // 遍历到了第 k 层,收集当前节点的值 res.add(new LinkedList<>(state)); return;}(2)元素个数的剪枝:通过 for 循环判断
for (int i = start; i <= choices.length - (k - state.size()) + 1; i++) {元素无重不可复选—【🔥中】78子集#
给你一个整数数组
nums,数组中的元素 互不相同 。返回该数组所有可能的子集(幂集)。解集 不能 包含重复的子集。你可以按 任意顺序 返回解集。
void backtrack(List<Integer> state, int[] choices, int start, List<List<Integer>> res) { res.add(new ArrayList<>(state)); // 【剪枝】从 start 开始遍历,避免生成重复子集 for (int i = start; i < choices.length; i++) { state.add(choices[i]); // 进行下一轮选择,注意本题每个元素只能选择一次,因此是i+1 backtrack(state, choices, i+1, res); state.remove(state.size() - 1); }}List<List<Integer>> subsets(int[] nums) { List<List<Integer>> res = new ArrayList<>(); backtrack(new ArrayList<>(), nums, 0, res); return res;}元素有重不可复选—中 90子集 II#
给你一个整数数组
nums,其中可能包含重复元素,请你返回该数组所有可能的 子集(幂集)。解集 不能 包含重复的子集。返回的解集中,子集可以按 任意顺序 排列。
void backtrack(List<Integer> state, int[] choices, int start, List<List<Integer>> res) { res.add(new ArrayList<>(state)); // 【剪枝一 子集】从 start 开始遍历,避免生成重复子集 for (int i = start; i < choices.length; i++) { // 【剪枝二 元素有重】 if(i>start && choices[i]==choices[i-1]) continue; state.add(choices[i]); // 【剪枝三 不可复选】 backtrack(state, choices, i+1, res); state.remove(state.size() - 1); }}List<List<Integer>> subsets(int[] nums) { Arrays.sort(nums); // 将数组排序 List<List<Integer>> res = new ArrayList<>(); backtrack(new ArrayList<>(), nums, 0, res); return res;}元素无重不可复选+k个数的组合—中 77组合#
给定两个整数
n和k,返回范围[1, n]中所有可能的k个数的组合。你可以按 任何顺序 返回答案。
// 本题中 choices 就是 nvoid backtrack(int k, ArrayList<Integer> state, int n, int start, List<List<Integer>> res) { if(state.size() == k) { res.add(new ArrayList<>(state)); return; } // 【剪枝】for循环判断提前止损,发现剩下的数字不够凑齐 k 个了,立刻停止循环 for (int i = start; i <= n - (k - state.size()) + 1; i++) { state.add(i); backtrack(k, state, n, i+1, res); state.remove(state.size() - 1); }}public List<List<Integer>> combine(int n, int k) { List<List<Integer>> res = new ArrayList<>(); // start 从 1 开始 backtrack(k, new ArrayList<Integer>(), n, 1, res); return res;}多个集合取组合—【🔥中】17电话号码的字母组合#
给定一个仅包含数字
2-9的字符串,返回所有它能表示的字母组合。答案可以按 任意顺序 返回。给出数字到字母的映射如下(与电话按键相同)。注意 1 不对应任何字母。
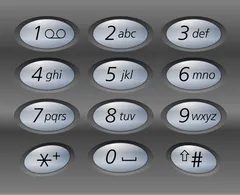
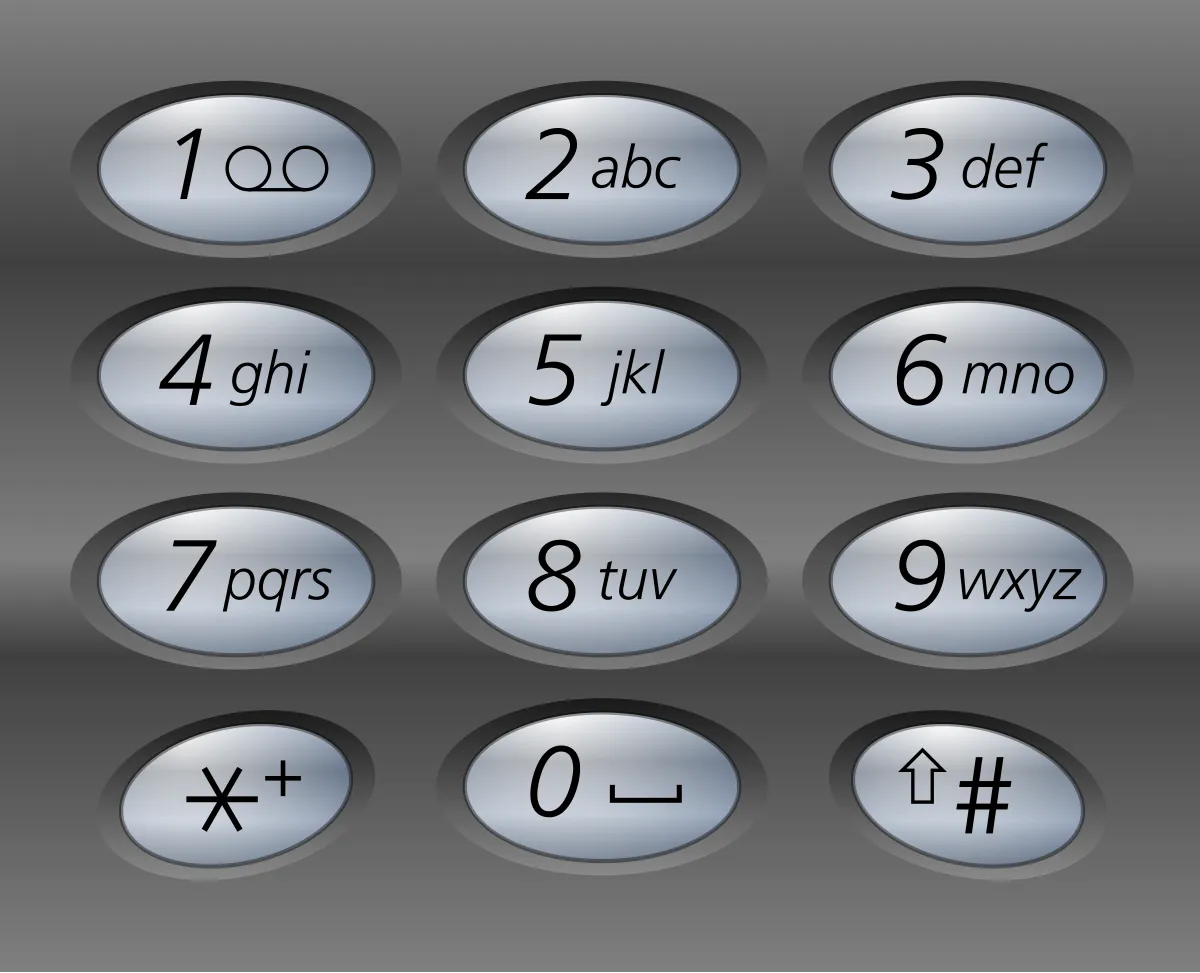
- 如果是一个集合来求组合的话,就需要 start,例如之前的题目;
- 而多个集合取组合,由于各个集合之间相互不影响,不需要 start
// 全局映射表:索引2对应abc,所以前面索引0和索引1留空String[] MAPPING = new String[]{"", "", "abc", "def", "ghi", "jkl", "mno", "pqrs", "tuv", "wxyz"};
/** * 回溯核心函数 * @param i 当前处理的层级(对应 digits 的第 i 位,也是 path 的第 i 个位置) * @param res 结果集 * @param str 当前字母组合 * @param digits 输入的数字字符数组 */void backtrack(int i, List<String> res, char[] str, char[] digits) {    // 【Base Case】如果 i 等于数字长度,说明所有数字位都已经处理完毕,path 中已填满一个完整的组合    if (i == digits.length) {        // 将字符数组转换为字符串并加入结果集        res.add(new String(str));        return;    }    // 【获取当前数字对应的字母串】    // digits[i] 获取当前字符(如 '2'),减去 '0' 得到整数(2),查表得到 "abc"    String letters = MAPPING[digits[i] - '0'];    // 【遍历当前数字对应的所有可能字母】    for (char c : letters.toCharArray()) {        // 【做选择】直接覆盖 str 数组第 i 位的字符        str[i] = c;        // 【进入下一层决策树】处理下一个数字(i + 1)        backtrack(i + 1, res, str, digits);        // 【撤销选择(隐式)】这里不需要显式的 str.deleteCharAt(i),因为下次循环执行 str[i] = c 时会直接覆盖旧值;或者回溯到上一层时,上一层也会覆盖它自己的位置。    }}
List<String> letterCombinations(String digits) { int n = digits.length(); // 边界情况处理:输入为空时返回空列表 if (n == 0) { return List.of(); } List<String> res = new ArrayList<>(); // 初始化 str 容器 // 注意:这里直接申请了长度为 n 的数组,而不是空数组 // 这意味着我们在递归过程中是在“填空”,而不是在“增长”数组 char[] str = new char[n]; // 从第 0 位开始回溯 backtrack(0, res, str, digits.toCharArray()); return res;}【🔥中】131分割回文串#
给你一个字符串
s,请你将s分割成一些 子串,使每个子串都是 回文串 。返回s所有可能的分割方案。
其实切割问题类似组合问题,例如对于字符串abcdef:
- 组合问题:选取一个a之后,在bcdef中再去选取第二个,选取b之后在cdef中再选取第三个…
- 切割问题:切割一个a之后,在bcdef中再去切割第二段,切割b之后在cdef中再切割第三段…
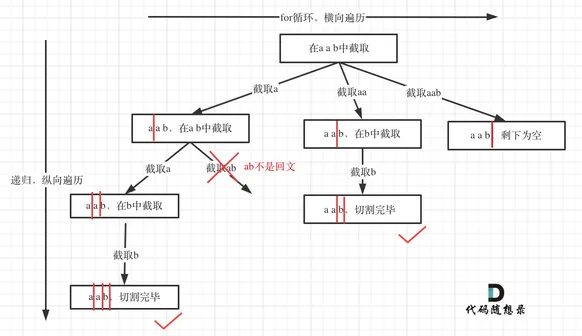
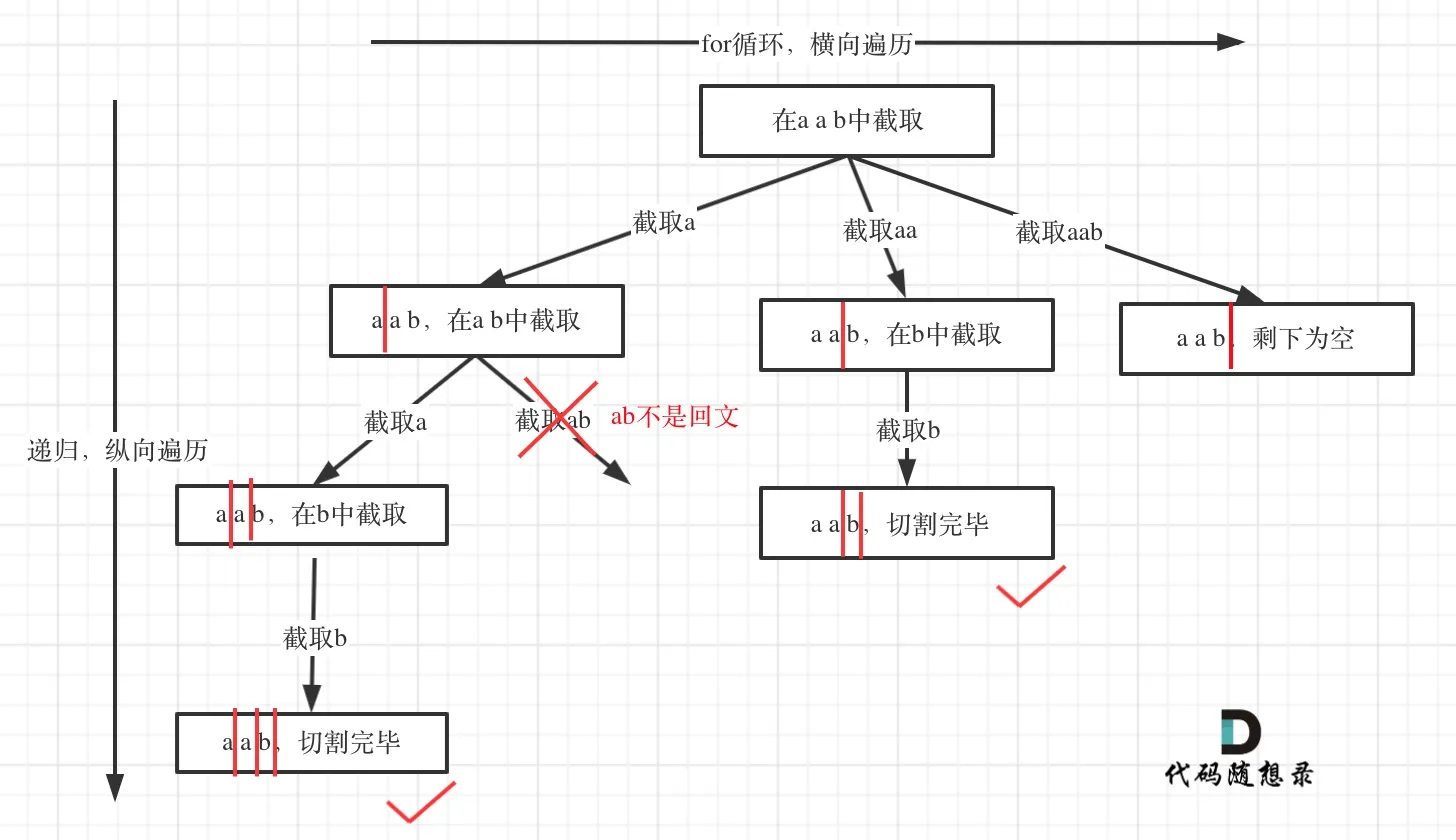
回溯三部曲:
1、递归函数参数:需要 start,因为是一个集合来求组合,组合不区分顺序
// 方法定义:state、choices、res + 不区分顺序 startvoid backtrack(List<String> state, String choices, int start, List<List<String>> res){2、终止条件 Base Case:切割线(就是图中的红线)切割到字符串的结尾位置,说明找到了一个切割方法
// 如果起始位置已经大于s的大小,说明找到一组分割方案if (start == s.length()){ // 【⚠️注意】创建一个新的 copy,不能直接用原来的引用 res.add(new ArrayList<>(state)); return;}3、遍历递归的逻辑
在 for (int i = start; i < s.size(); i++) 循环中,定义了起始位置 start,那么 [start, i] 就是要截取的子串
(1)子串不是回文串的剪枝
if (!check(str)) continue;判断回文 check 方法:
boolean check(String str){ for (int i = 0; i < str.length()/ 2; i++){ if (str.charAt(i) != str.charAt(str.length() - 1 - i)) return false; } return true;}(2)不可重复切割的剪枝:切割过的地方,不能重复切割,对应子集/组合问题中的不可复选,因此传递 i+1 起始位置
String str = s.substring(start, i + 1); // 截取从 start 到 i+1 的子串if (!check(str)) continue;state.add(str.toString());backtrack(state, s, i + 1, res); // 递归寻找 i+1 为起始位置的子串state.remove(state.size() - 1); // 回溯,弹出本次已经添加的子串class Solution { List<List<String>> partition(String s) { List<List<String>> res = new ArrayList<>(); List<String> state = new ArrayList<>(); backtrack(state, s, 0, res); return res; } void backtrack(List<String> state, String choices, int start, List<List<String>> res){ if (start == choices.length()){ // 【⚠️注意】创建一个新的 copy,不能直接用原来的引用 res.add(new ArrayList<>(state)); return; } for (int i = start; i < choices.length(); i++){ String str = choices.substring(start, i + 1); if (!check(str)) continue; state.add(str.toString()); backtrack(state, choices, i + 1, res); state.remove(state.size() - 1); } } // 判断是否是回文 boolean check(String str){ for (int i = 0; i < str.length()/ 2; i++){ if (str.charAt(i) != str.charAt(str.length() - 1 - i)) return false; } return true; }}三、子集/组合和问题#
给定一个集合和一个目标和,找到集合中所有和为目标和的子集。
// 方法定义:state、choices、res + 不区分顺序 start + 子集和 targetvoid backtrack(List<Integer> state, int target, int[] choices, int start, List<List<Integer>> res){省去元素和变量 total ,通过在 target 上执行减法来统计元素和,当 target 等于 0 时记录解
// 调用方法backtrack(state, target - choices[i], choices, i, res);1、Base Case
// 子集和等于 target 时,记录解if (target == 0) { res.add(new ArrayList<>(state)); return;}2、剪枝的优化:将数组排序,若是正整数数组则不用排序
// 若超过 target,则直接结束循环// 这是因为数组已排序,后边元素更大,子集和一定超过 targetif (target - choices[i] < 0) break;3、考虑要求的是 k 个数的组合
// 方法定义:state、choices、res + 不区分顺序 start + 子集和 target + 组合个数 kvoid backtrack(int k, List<Integer> state, int target, int choices, int start, List<List<Integer>> res) {Base Case
if (target == 0 && state.size() == k) { res.add(new ArrayList<>(state)); return;}元素无重可以复选—【🔥中】39组合总和#
给定一个整数数组 nums 和一个目标整数 target,请找出所有可能的组合,使得组合中的元素和等于 target。给定数组无重复元素,每个元素可以被选取多次。请以列表形式返回这些组合,列表中不应包含重复组合。
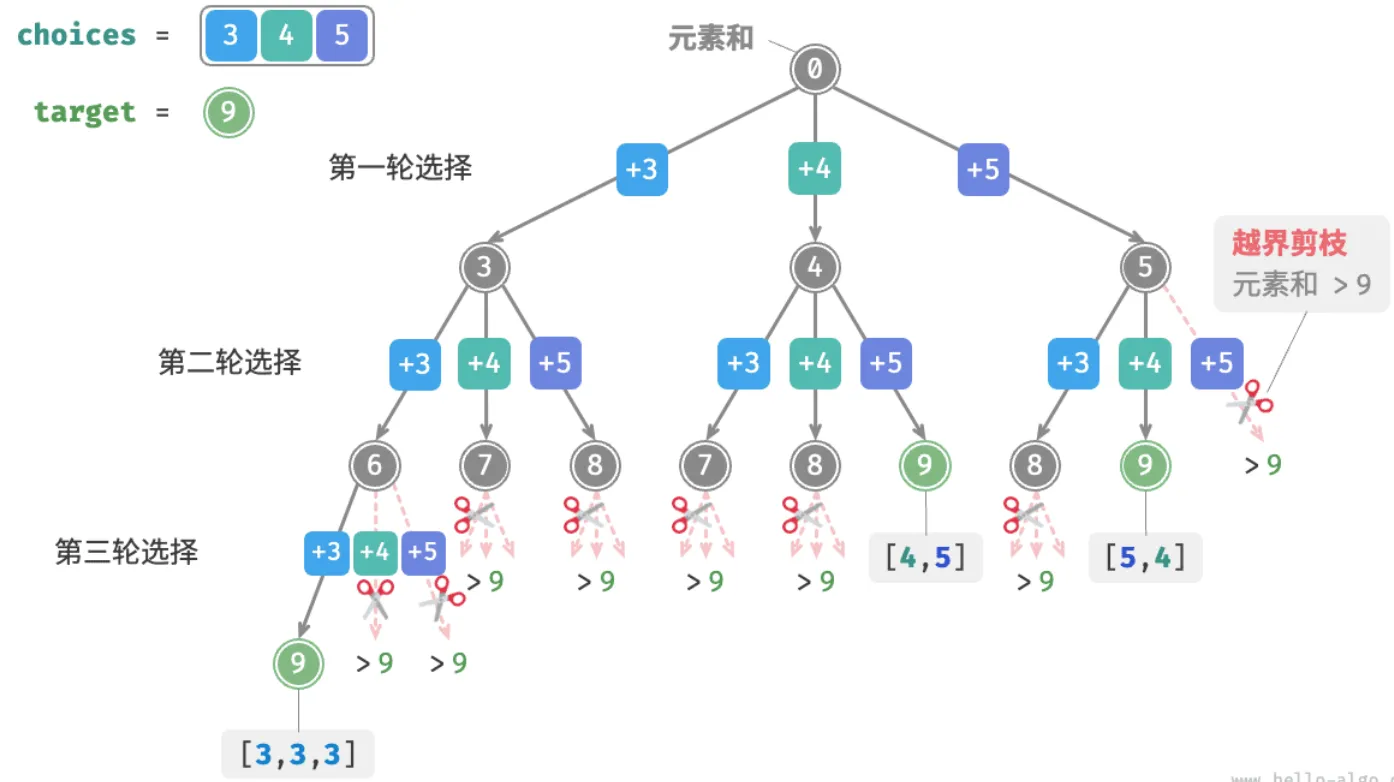
例如,输入集合 {3,4,5} 和目标整数 9,解为 {3,3,3},{4,5}。需要注意以下两点:
- 输入集合中的元素可以被无限次重复选取
- 子集不区分元素顺序,比如 {4,5} 和 {5,4} 是同一个子集
1、参考全排列解法
类似于全排列问题,我们可以把子集的生成过程想象成一系列选择的结果,并在选择过程中实时更新“元素和 total”,当元素和等于 target 时,就将子集记录至结果列表
而与全排列问题不同的是,本题集合中的元素可以被无限次选取,因此无须借助 selected 布尔列表来记录元素是否已被选择。我们可以对全排列代码进行小幅修改,初步得到解题代码:
void backtrack(List<Integer> state, int target, int total, int[] choices, List<List<Integer>> res) { // 子集和等于 target 时,记录解 if (total == target) { res.add(new ArrayList<>(state)); return; } // 【遍历所有选择】 for (int i = 0; i < choices.length; i++) { // 【剪枝】若子集和超过 target ,则跳过该选择 if (total + choices[i] > target) { continue; } // 【尝试】做出选择,更新元素和 total state.add(choices[i]); // 【进行下一轮选择】 backtrack(state, target, total + choices[i], choices, res); // 【回退】撤销选择,恢复到之前的状态 state.remove(state.size() - 1); }}List<List<Integer>> subsetSum(int[] nums, int target) { List<Integer> state = new ArrayList<>(); // 状态(子集) int total = 0; // 子集和 List<List<Integer>> res = new ArrayList<>(); // 结果列表(子集列表) backtrack(state, target, total, nums, res); return res;}向以上代码输入数组 [3,4,5] 和目标元素 9,输出结果为 [3,3,3],[4,5],[5,4],存在重复的子集
这是因为搜索过程是区分选择顺序的,然而子集不区分选择顺序。如下图所示,先选 4 后选 5 与先选 5 后选 4 是不同的分支,但对应同一个子集
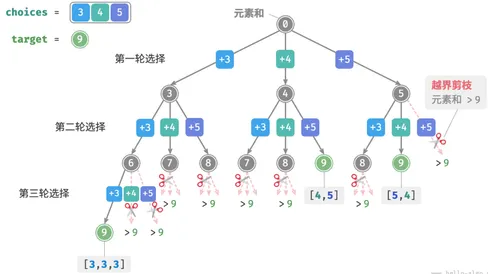
为了去除重复子集,一种直接的思路是对结果列表进行去重。但这个方法效率很低,有两方面原因:
- 当数组元素较多,尤其是当
target较大时,搜索过程会产生大量的重复子集 - 比较子集(数组)的异同非常耗时,需要先排序数组,再比较数组中每个元素的异同
2、重复子集剪枝
在搜索过程中通过剪枝进行去重。观察下图,重复子集是在以不同顺序选择数组元素时产生的,例如以下情况:
- 当第一轮和第二轮分别选择 3 和 4 时,会生成包含这两个元素的所有子集,记为 [3,4, …]
- 之后,当第一轮选择 4 时,则第二轮应该跳过 3,因为该选择产生的子集 [4,3] 和第
1.步中生成的子集完全重复
在搜索过程中,每一层的选择都是从左到右被逐个尝试的,因此越靠右的分支需要被剪掉的越多:
- 前两轮选择 3 和 5,生成子集 [3,5, …]
- 前两轮选择 4 和 5,生成子集 [4,5, …]
- 若第一轮选择 5,则第二轮应该跳过 3 和 4 ,因为子集 [5,3, …] 和 [5,4, …] 与第
1.步和第2.步中描述的子集完全重复
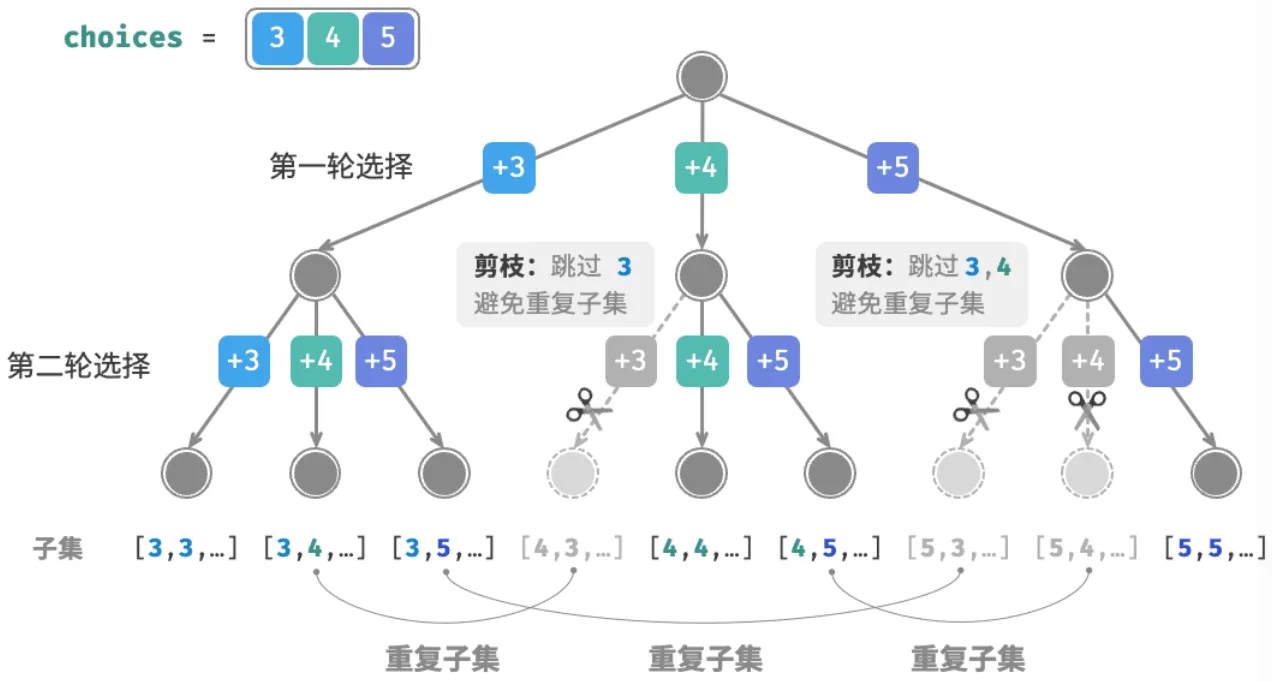
第三轮选择(注意:第二轮如果 >=target 则直接返回,不会递归到第三轮):[3,3,3/4/5] [3,4,4/5] [3,5,5] | [4,4,4/5]
最后的效果是:输入数组 [x1,x2, … ,xn],得到的选择序列 [xi1,xi2, … ,xim] 满足 xi1<=xi2<= … <=xim,不满足该条件的选择序列都会造成重复,应当剪枝
3、代码实现
为实现该剪枝,可以初始化变量 start ,用于指示遍历起始点。当做出选择 xi 后,设定下一轮从索引 i 开始遍历。这样做就可以让选择序列满足 i1<i2< … <im,从而保证子集唯一
除此之外,还对代码进行了以下两项优化:
- 在开启搜索前,先将数组
nums排序。在遍历所有选择时,当子集和超过target时直接结束循环,因为后边的元素更大,其子集和一定超过target - 省去元素和变量
total,通过在target上执行减法来统计元素和,当target等于 时记录解
void backtrack(List<Integer> state, int target, int[] choices, int start, List<List<Integer>> res) { // 子集和等于 target 时,记录解 if (target == 0) { res.add(new ArrayList<>(state)); return; } // 【遍历所有选择】 // 【剪枝一 子集】从 start 开始遍历,避免生成重复子集 for (int i = start; i < choices.length; i++) { // 【剪枝二 子集和】若超过 target,则直接结束循环 // 这是因为数组已排序,后边元素更大,子集和一定超过 target if (target - choices[i] < 0) break; // 【尝试】做出选择,更新 target, start state.add(choices[i]); // 【进行下一轮选择】 backtrack(state, target - choices[i], choices, i, res); // 【回退】撤销选择,恢复到之前的状态 state.remove(state.size() - 1); }}List<List<Integer>> subsetsSum(int[] nums, int target) { List<Integer> state = new ArrayList<>(); // 状态(子集) Arrays.sort(nums); // 对 nums 进行排序 int start = 0; // 遍历起始点 List<List<Integer>> res = new ArrayList<>(); // 结果列表(子集列表) backtrack(state, target, nums, start, res); return res;}元素有重不可复选—中 40组合总和 II#
给定一个整数数组
nums和一个目标整数target,请找出所有可能的组合,使得组合中的元素和等于target。给定数组可能包含重复元素,每个元素只可被选择一次。请以列表形式返回这些组合,列表中不应包含重复组合。
相比于上题,本题的输入数组可能包含重复元素,这引入了新的问题。例如,给定数组 [4,4^,5] 和目标元素 9,则现有代码的输出结果为 [4,5],[4^,5],出现了重复子集
造成这种重复的原因是相等的元素在某轮都被选择。在下图中,第一轮共有三个选择,其中两个都为 4,会产生两个重复的搜索分支,从而输出重复子集;同理,第二轮的两个 4 也会产生重复子集
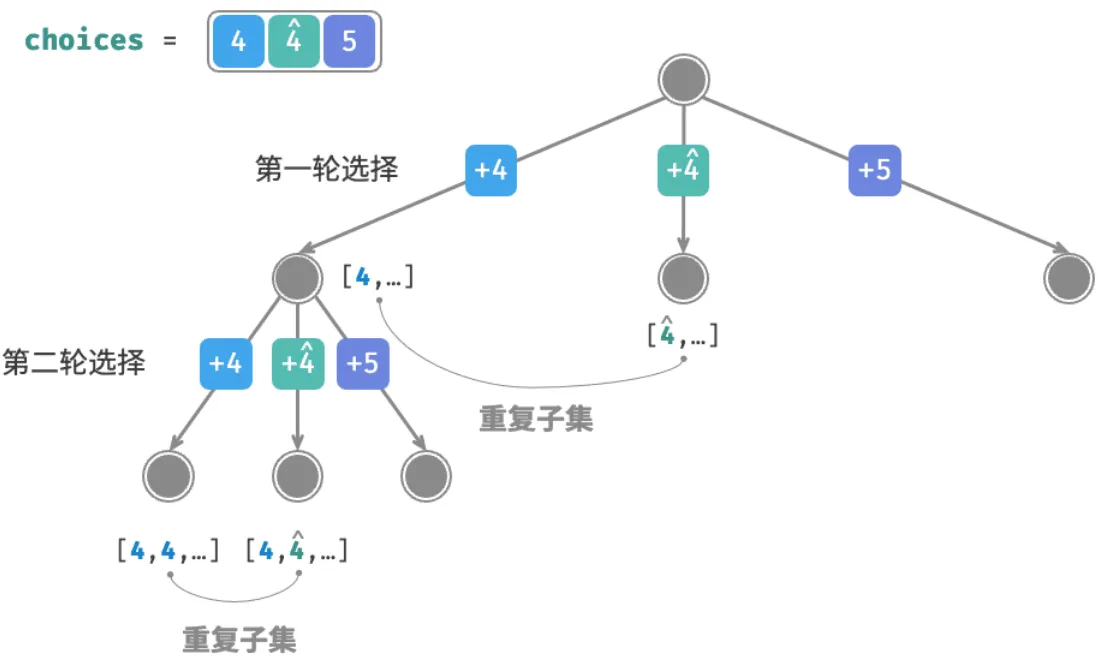
1、相等元素剪枝
为解决此问题,我们需要限制相等元素在每一轮中只能被选择一次。实现方式比较巧妙:由于数组是已排序的,因此相等元素都是相邻的。这意味着在某轮选择中,若当前元素与其左边元素相等,则说明它已经被选择过,因此直接跳过当前元素
与此同时,本题规定每个数组元素只能被选择一次。幸运的是,我们也可以利用变量 start 来满足该约束:当做出选择 xi 后,设定下一轮从索引 i+1 开始向后遍历。这样既能去除重复子集,也能避免重复选择元素
2、代码实现
void backtrack(List<Integer> state, int target, int[] choices, int start, List<List<Integer>> res) { // 子集和等于 target 时,记录解 if (target == 0) { res.add(new ArrayList<>(state)); return; } // 【遍历所有选择】 // 【剪枝一 子集】从 start 开始遍历,避免生成重复子集 for (int i = start; i < choices.length; i++) { // 【剪枝二 子集和】若超过 target,则直接结束循环 // 这是因为数组已排序,后边元素更大,子集和一定超过 target if (target - choices[i] < 0) break; // 【剪枝四 元素有重】如果该元素与左边元素相等,说明该搜索分支重复,直接跳过 if (i > start && choices[i] == choices[i - 1]) continue; // 尝试:做出选择,更新 target, start state.add(choices[i]); // 进行下一轮选择 // 【剪枝三 不可复选】从 i+1 开始遍历 backtrack(state, target - choices[i], choices, i + 1, res); // 回退:撤销选择,恢复到之前的状态 state.remove(state.size() - 1); }}List<List<Integer>> subsetSum(int[] nums, int target) { List<Integer> state = new ArrayList<>(); // 状态(子集) Arrays.sort(nums); // 对 nums 进行排序 int start = 0; // 遍历起始点 List<List<Integer>> res = new ArrayList<>(); // 结果列表(子集列表) backtrack(state, target, nums, start, res); return res;}展示了数组 [4,4,5] 和目标元素 9 的回溯过程,共包含四种剪枝操作
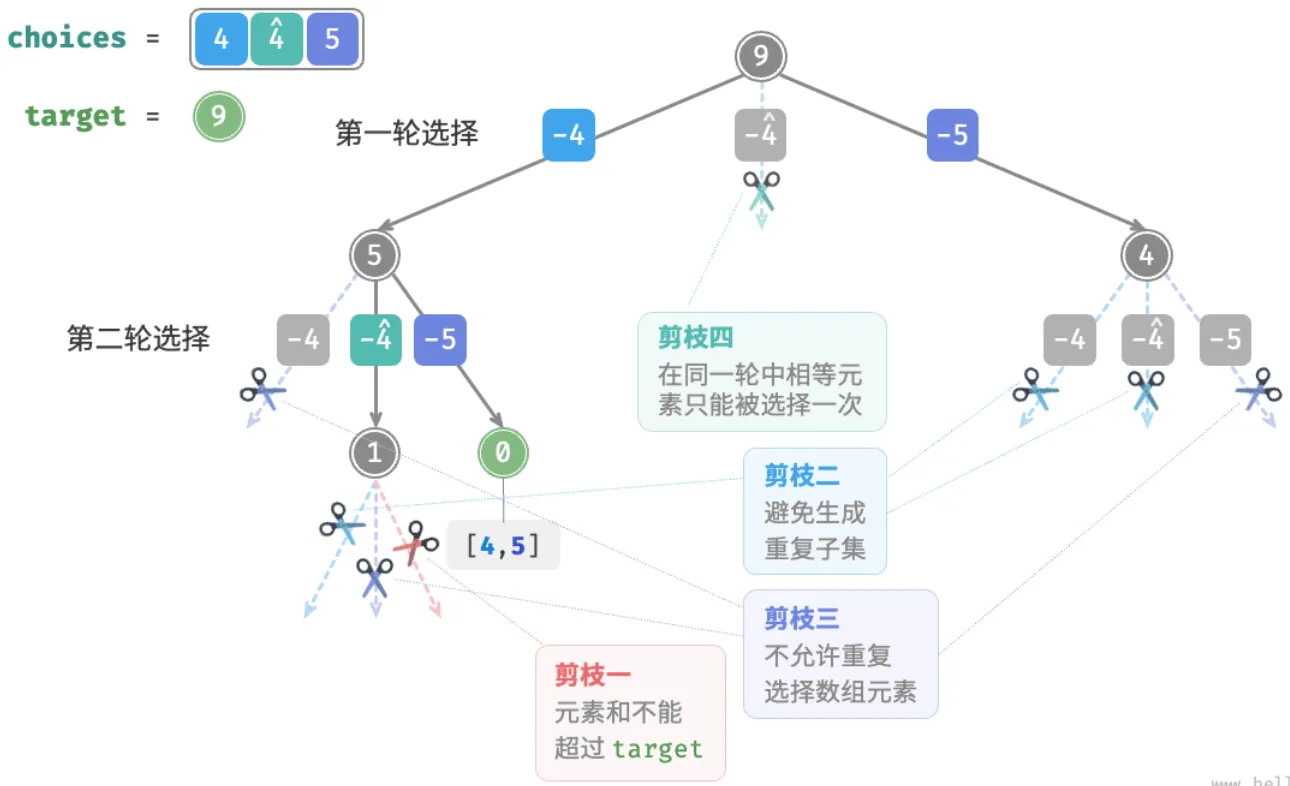
元素无重不可复选+k个数的组合—中 216组合总和 III#
找出所有相加之和为
n的k个数的组合,且满足下列条件:
- 只使用数字1到9
- 每个数字 最多使用一次
返回 所有可能的有效组合的列表 。该列表不能包含相同的组合两次,组合可以以任何顺序返回。
以上两题本质上都是子集和问题,本题需要找到 k 个数的组合
void backtrack(int k, List<Integer> state, int target, int start, List<List<Integer>> res) {    if (target == 0 && state.size() == k) {        res.add(new ArrayList<>(state));        return;    }    // 【剪枝 子集】    // 【剪枝 元素个数】for循环判断提前止损    for (int i = start; i <= 9-(k-state.size())+1 ; i++) {        // 【剪枝 子集和】        if (target - i < 0) break;        state.add(i);        // 【剪枝 不可复选】        backtrack(k, state, target - i, i + 1, res);        state.remove(state.size() - 1);    }}
List<List<Integer>> combinationSum(int k, int n) {    List<Integer> state = new ArrayList<>(); // 状态(子集)    List<List<Integer>> res = new ArrayList<>(); // 结果列表(子集列表)    backtrack(k, state, n, 1, res);    return res;}
N 皇后问题—【🔥难】51N 皇后#
根据国际象棋的规则,皇后可以攻击与同处一行、一列或一条斜线上的棋子。给定 n 个皇后和一个 n*n 大小的棋盘,寻找使得所有皇后之间无法相互攻击的摆放方案,方案中
'Q'和'.'分别代表皇后和空位。
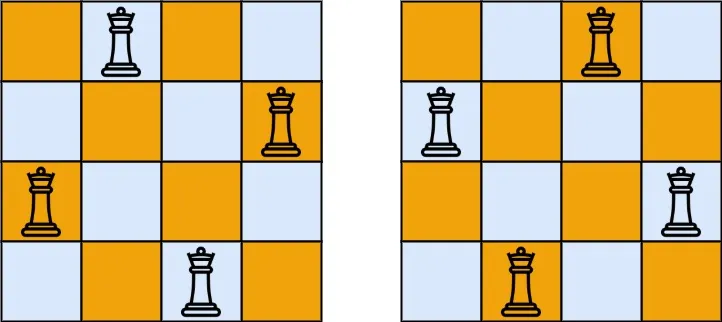
从回溯算法的角度看,n*n 大小的棋盘共有 n^2^ 个格子,给出了所有的选择 choices 。在逐个放置皇后的过程中,棋盘状态在不断地变化,每个时刻的棋盘就是状态 state
下图展示了本题的三个约束条件:多个皇后不能在同一行、同一列、同一条对角线上。值得注意的是,对角线分为主对角线 \ 和次对角线 / 两种
1、逐行放置策略
皇后的数量和棋盘的行数都为 n,因此容易得到一个推论:棋盘每行都允许且只允许放置一个皇后
因此可以采取逐行放置策略:从第一行开始,在每行放置一个皇后,直至最后一行结束
下图所示为 4 皇后问题的逐行放置过程。受画幅限制仅展开了第一行的其中一个搜索分支,并且将不满足列约束和对角线约束的方案都进行了剪枝
从本质上看,逐行放置策略起到了剪枝的作用,它避免了同一行出现多个皇后的所有搜索分支
2、列与对角线剪枝
为了满足列约束,我们可以利用一个长度为 n 的布尔型数组 cols 记录每一列是否有皇后。在每次决定放置前,我们通过 cols 将已有皇后的列进行剪枝,并在回溯中动态更新 cols 的状态
那么,如何处理对角线约束呢?设棋盘中某个格子的行列索引为 (row, col),选定矩阵中的某条主对角线,可以发现该对角线上所有格子的行索引减列索引都相等,即主对角线上所有格子的 row - col 为恒定值。推广一下,如果两个格子满足 row1-col1 = row2-col2,则它们一定处在同一条主对角线上。利用该规律,可以借助下图所示的数组 diags1 记录每条主对角线上是否有皇后;同理,次对角线上的所有格子的 row + col 是恒定值,同样也可以借助数组 diags2 来处理次对角线约束
3、代码实现
-
n 维方阵中
row - col的范围是 [-n+1, n-1](可能为负数,因此需要加上 n-1 映射到 [0, 2n-2] 区间),row + col的范围是 [0, 2n-2],所以主对角线和次对角线的数量都为 2n-1,即数组diags1和diags2的长度都为 2n-1 -
对每个时刻的棋盘 state 进行优化:只用一个一维数组
int[] queens,其中queens[r] = c表示第r行的皇后在第c列。只有当找到解(r == n)时,才根据queens数组即时构建出最终的List<String>棋盘。这避免了递归过程中的字符串操作开销
/* 回溯算法:n 皇后 */void backtrack(int row, int[] queens, boolean[] cols, boolean[] diags1, boolean[] diags2, List<List<String>> res) {    int n = cols.length;    // 当处理完所有行 (row == n),说明找到了一个合法的解    if (row == n) {        // 【构建解】根据 queens 数组即时生成棋盘字符串        List<String> state = new ArrayList<>(n);        for (int col : queens) {            char[] rowChars = new char[n];            // 初始化行为全 '.'            Arrays.fill(rowChars, '.');            // 将皇后位置设为 'Q'            rowChars[col] = 'Q';            state.add(new String(rowChars));        }        res.add(state);        return;    }
    // 遍历当前行的所有列,尝试放置皇后    for (int col = 0; col < n; col++) {        // 【⚠️注意】计算主对角线索引:r-c 可能为负数,加上 n-1 映射到 [0, 2n-2] 区间        int diag1 = row - col + n - 1;        int diag2 = row + col;        // 剪枝:判断当前位置 (row, col) 是否安全        // 必须同时满足:该列无皇后、主对角线无皇后、次对角线无皇后        if (!cols[col] && !diags1[diag1] && !diags2[diag2]) {            // 尝试:放置皇后            queens[row] = col; // 记录位置(直接覆盖,回溯时无需显式恢复该数组)            // 标记占用            cols[col] = diags1[diag1] = diags2[diag2] = true;            // 递归:处理下一行            backtrack(row + 1, queens, cols, diags1, diags2, res);            // 回退:恢复现场(撤销占用标记)            cols[col] = diags1[diag1] = diags2[diag2] = false;            // 【⚠️注意】queens[row] 不需要恢复,因为下一次循环会直接覆盖它,或者递归返回后该位置不再被访问        }    }}/* 求解 n 皇后 */List<List<String>> solveNQueens(int n) {    List<List<String>> res = new ArrayList<>();    // 【⚠️关键】使用一维数组记录状态,queens[r] = c 表示第 r 行的皇后位于第 c 列(避免了维护整个二维棋盘,节省空间)    int[] queens = new int[n];    // 记录列占用情况    boolean[] cols = new boolean[n];    // 记录主对角线占用情况 (行-列 为定值)    boolean[] diags1 = new boolean[2 * n - 1];    // 记录次对角线占用情况 (行+列 为定值)    boolean[] diags2 = new boolean[2 * n - 1];
backtrack(0, queens, cols, diags1, diags2, res); return res;}【🔥中】79单词搜索#
给定一个
m x n二维字符网格board和一个字符串单词word。如果word存在于网格中,返回true;否则,返回false。单词必须按照字母顺序,通过相邻的单元格内的字母构成,其中“相邻”单元格是那些水平相邻或垂直相邻的单元格。同一个单元格内的字母不允许被重复使用。
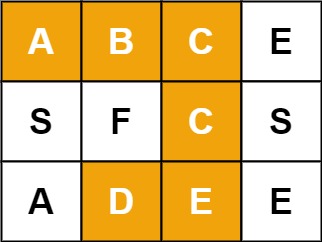
class Solution {    int[][] dir = {{1,0},{0,1},{-1,0},{0,-1}};    /**     * 回溯函数     * @param choices 二维网格     * @param target  目标单词的字符数组     * @param i     当前行坐标     * @param j     当前列坐标     * @param k     当前需要匹配的字符在 target 中的索引     * @param res     */    boolean backtrack(char[][] choices, char[] target, int i, int j, int k, boolean res) {        // 【Base Case】        // 1、越界检查:如果走出了网格边界,直接失败        if (i >= choices.length || i < 0 || j >= choices[0].length || j < 0) {            return false;        }        // 2、字符不匹配:如果当前格子的字符不等于目标字符,失败        // 注意:这里也隐含了“已访问”的检查。因为访问过的格子会被标记为 '\0',而 '\0' 肯定不等于 word[k],所以会自动返回 false。        if (choices[i][j] != target[k]) {            return false;        }        // 3、成功条件:如果 k 已经到了单词的最后一个字符,且前面都匹配(能走到这里说明匹配),则成功        if (k == target.length - 1) {            return true;        }        for(int index=0 ; index<4 ; index++){             int nexti = i + dir[index][0];            int nextj = j + dir[index][1];            // --- 做选择(标记已访问) ---            // 暂时将当前字符修改为 '\0'(空字符),防止后续递归回头再次访问这个格子            // 这是一种“原地修改”的标记方法,省去了额外的 selected 数组空间            char temp = choices[i][j]; // 保存原字符,用于回溯恢复            choices[i][j] = '\0';
// --- 探索下一层(上下左右四个方向) --- // 只要有一个方向能走通,结果就是 true if(backtrack(choices, target, nexti, nextj, k+1, res)) res = true; // --- 回溯 --- choices[i][j] = temp; } return res; } // 主函数:遍历网格的每一个格子,作为搜索的起点 public boolean exist(char[][] board, String word) { char[] words = word.toCharArray(); // 将字符串转为字符数组,访问效率更高 boolean res = false; // 1. 尝试以每一个位置 (i, j) 作为单词的起始点 for (int i = 0; i < board.length; i++) { for (int j = 0; j < board[0].length; j++) { // 如果从 (i, j) 出发能走通,直接返回 true if (backtrack(board, words, i, j, 0, res)) return true; } } return false; }}【🔥中】22括号生成#
数字
n代表生成括号的对数,请你设计一个函数,用于能够生成所有可能的并且 有效的 括号组合。
长度为 n 的序列就是在长度为 n−1 的序列前加一个 ( 或 )
检查序列是否有效:遍历这个序列,并使用一个变量 balance 表示左括号的数量减去右括号的数量。如果在遍历过程中 balance 的值小于零,或者结束时 balance 的值不为零,那么该序列就是无效的,否则它是有效的
我们可以只在序列仍然保持有效时才添加 ‘(’ 或 ‘)’,而不是每次都添加,可以通过跟踪到目前为止放置的左括号和右括号的数目来做到这一点
- 如果左括号数量不大于 n,可以放一个左括号
- 如果右括号数量小于左括号的数量,可以放一个右括号
class Solution { /** * 回溯核心函数 * @param res 结果列表 * @param state 当前正在构建的字符串 (使用StringBuilder为了高效修改) * @param left 当前已经使用的左括号 '(' 的数量 * @param right 当前已经使用的右括号 ')' 的数量 * @param max 目标括号对数 n */ public void backtrack(List<String> res, StringBuilder state, int left, int right, int max) { // 【Base Case】 // 如果当前字符串长度达到了 2 * n,说明括号已经全部配对完成 if (state.length() == max * 2) { res.add(state.toString()); return; } // 【尝试添加左括号 '('】 // 【剪枝一 左括号数量】只要左括号数量未达到上限 n,就可以尝试添加 if (left < max) { state.append('('); // 做选择:添加左括号 backtrack(res, state, left + 1, right, max); // 递归进入下一层:左括号计数+1 state.deleteCharAt(state.length() - 1); // 回溯:删除刚才添加的字符 } // 【尝试添加右括号 ')'】 // 【剪枝二 右括号数量】只有当右括号数量 < 左括号数量时,才能添加右括号 // 这保证了括号的有效性(不会出现 ')' 多于 '(' 的情况) if (right < left) { state.append(')'); // 做选择:添加右括号 backtrack(res, state, left, right + 1, max); // 递归进入下一层:右括号计数+1 state.deleteCharAt(state.length() - 1); // 回溯:删除刚才添加的字符 } } /** * 主函数:生成所有可能的有效括号组合 * @param n 括号的对数 * @return 包含所有有效组合的列表 */ public List<String> generateParenthesis(int n) { List<String> res = new ArrayList<String>(); // 初始状态:结果列表为空,当前字符串为空,已用左括号数0,已用右括号数0 backtrack(res, new StringBuilder(), 0, 0, n); return res; }}
评论
欢迎交流,使用 GitHub 账号登录后即可留言。
在 GitHub Discussions 中查看讨论 ↗