Voice Agent 语音助手三种架构范式#
Cascaded 级联架构#
最经典的 pipeline 方案:

- VAD(Voice Activity Detection):检测用户是否在说话
- ASR(Automatic Speech Recognition):语音转文本
- LLM:文本推理,生成回复
- TTS(Text-to-Speech):文本转语音
工程特点:
- 每个环节独立优化、独立替换
- LLM 部分和文本 Agent 完全复用,工具调用、记忆管理等已有方案直接适用
- 延迟是各环节之和:VAD(~200ms) + ASR(~300ms) + LLM(~500ms) + TTS(~300ms) = 1.3s+
- 语调、情感等副语言信息在 ASR 阶段丢失
Omni 端到端架构#
单一多模态模型直接处理音频输入、产生音频输出:
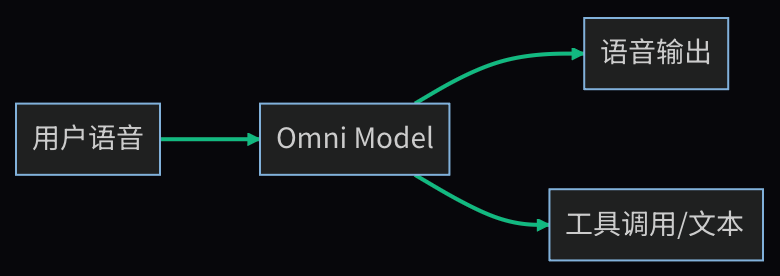
工程特点:
- 延迟极低(模型直接从音频 token 生成音频 token,无中间转换)
- 保留副语言信息:语调、情感、说话速度
- 可控性差:难以约束模型的回复格式、工具调用逻辑
- 调试困难:中间没有文本表示,无法 log 模型“想了什么”
- 成本高:音频 token 数量远大于等价文本
生产系统仍常保留文字转写,用于检索、审核、日志和无障碍显示。
Full-duplex 全双工架构#
模拟人类对话:可以被打断、可以边听边说、可以在对方说话时思考。
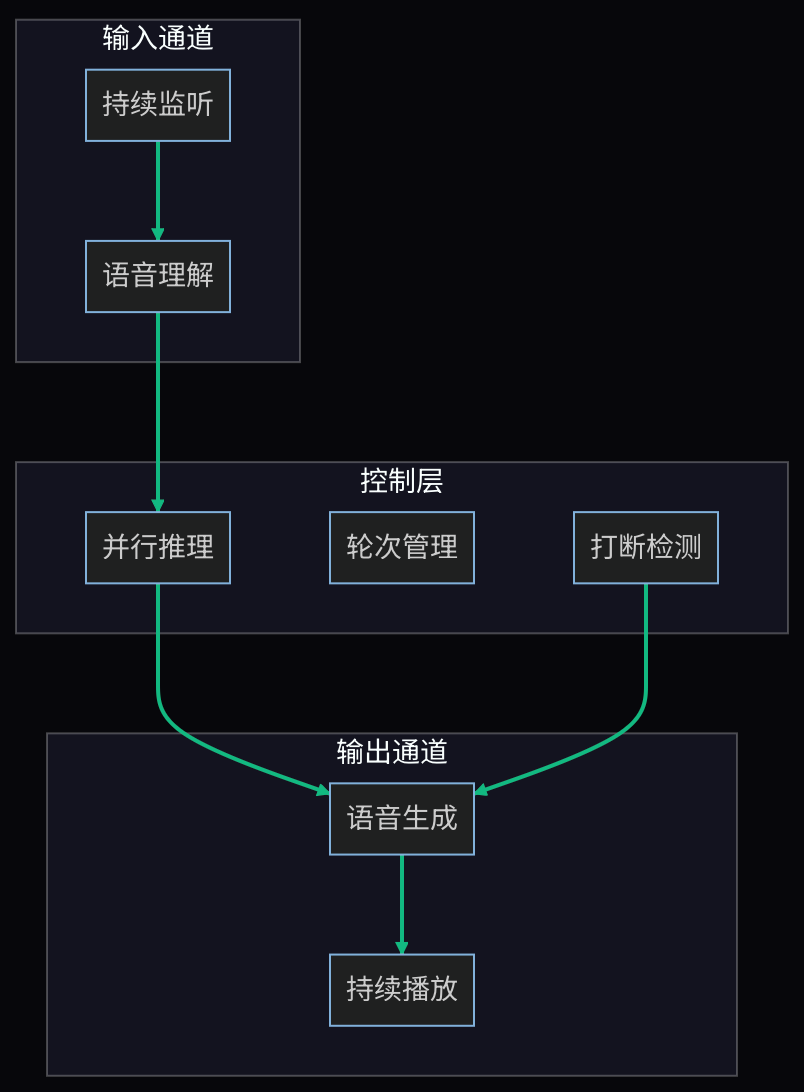
工程特点:
- 最接近自然人类对话体验
- 需要处理“同时说话”的冲突
- 打断检测本身就是一个独立的模型/规则模块
- 需要流式生成 + 流式播放 + 随时取消的基础设施
三种范式对比#
| 维度 | Cascaded 级联 | Omni 端到端 | Full-duplex 全双工 |
|---|---|---|---|
| 端到端延迟 | 1.3s+ | 300-500ms | 500-800ms |
| 可控性 | 高(文本中间层可审计) | 低(黑盒) | 中(混合架构) |
| 工具调用支持 | 成熟 | 有限 | 成熟 |
| 情感/语调保留 | 丢失 | 保留 | 部分保留 |
| 工程复杂度 | 低 | 中 | 高 |
| 成本(相同对话量) | 低 | 高 | 中 |
| 适用场景 | 客服、内部工具 | 陪伴、娱乐 | 实时助手、电话场景 |
实际工程中,很多团队采用混合方案:用 Omni 做快速响应的“嗯、好的”等短回复,用 Cascaded 做需要工具调用的复杂回复。
Computer Use / GUI Agent#
GUI Agent 的目标:让 AI 像人类用户一样操作图形界面——点击按钮、输入文字、滚动页面、读取屏幕内容。
动作空间设计#
GUI Agent 需要定义一组有限的动作原语:
# 典型动作空间actions = { "click": {"x": int, "y": int, "button": "left|right"}, "type": {"text": str}, "scroll": {"direction": "up|down|left|right", "amount": int}, "key": {"keys": str}, # 如 "ctrl+c" "screenshot": {}, # 获取当前屏幕截图 "wait": {"seconds": float}, # 等待页面加载 "drag": {"from_x": int, "from_y": int, "to_x": int, "to_y": int},}设计原则:
- 原子性:每个动作是最小操作单元,组合出复杂行为
- 可逆性标注:区分可逆操作(滚动、切换标签页)和不可逆操作(删除、提交、发送)
- 等待机制:UI 操作后需要等待渲染完成再截图验证
视觉定位方法#
模型看到截图后,如何指定“点击哪里”?两种主流方案:
方案 A:Set-of-Mark(SoM)标注选择
截图 → 视觉模型检测可交互元素 → 标注编号 → 发给 LLMLLM 回复:"点击标记 [7] 的按钮"优点:LLM 只需选 ID,不需要空间推理能力;定位精确。 缺点:多一步检测;遗漏元素时无法操作。
方案 B:坐标定位
截图 → 直接发给多模态 LLMLLM 回复:"click(324, 178)"优点:无需额外检测步骤;能操作任何可见元素。 缺点:坐标精度依赖模型视觉能力;分辨率变化时坐标失效。
实践建议:优先用 SoM(稳定性高),对 SoM 覆盖不到的元素 fallback 到坐标定位。
安全边界#
GUI Agent 直接操作用户界面,安全问题比 API 调用严重得多:
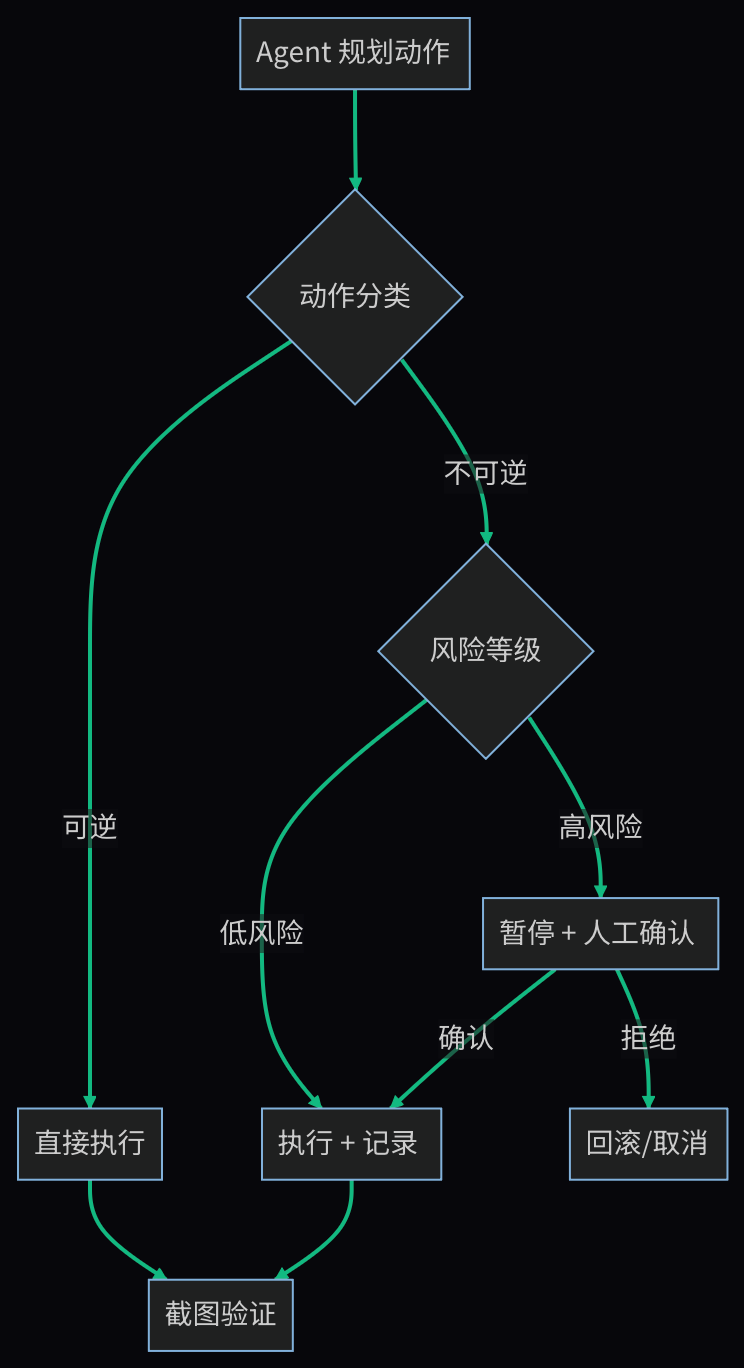
关键安全措施:
| 层次 | 措施 | 说明 |
|---|---|---|
| 环境隔离 | 沙箱/虚拟机 | Agent 在隔离环境中操作,不影响宿主机 |
| 权限收窄 | 白名单应用 | 只允许操作指定应用,禁止访问敏感区域 |
| 操作审批 | 不可逆操作确认 | 删除、发送、付款等动作需人工确认 |
| 执行限速 | 动作频率限制 | 防止失控循环高频点击 |
| 状态验证 | 操作后截图对比 | 确认动作产生了预期效果 |
当前落地的代表产品#
- Claude Computer Use:Anthropic 提供的 API 能力,模型直接接收截图、输出鼠标/键盘动作坐标
- Open Interpreter / OS-Copilot:开源方案,组合视觉模型 + 动作执行层
- 各类 RPA 增强:传统 RPA 工具接入 LLM 做决策层,保留原有的元素定位和操作基础设施
- 浏览器自动化:基于 Playwright/Puppeteer + 视觉理解,处理网页交互
共同的架构模式:
截图/DOM → 理解当前状态 → 规划下一步动作 → 执行 → 验证 → 循环快慢解耦:跨模态的共性设计原则#
Voice Agent 和 GUI Agent 看起来是完全不同的场景,但它们面临同一个核心矛盾:
用户期望实时响应(快),但深度推理需要时间(慢)。
解决方案是同一个:把实时响应通道和深度推理通道分离,并行运行。
Voice Agent 中的快慢解耦#
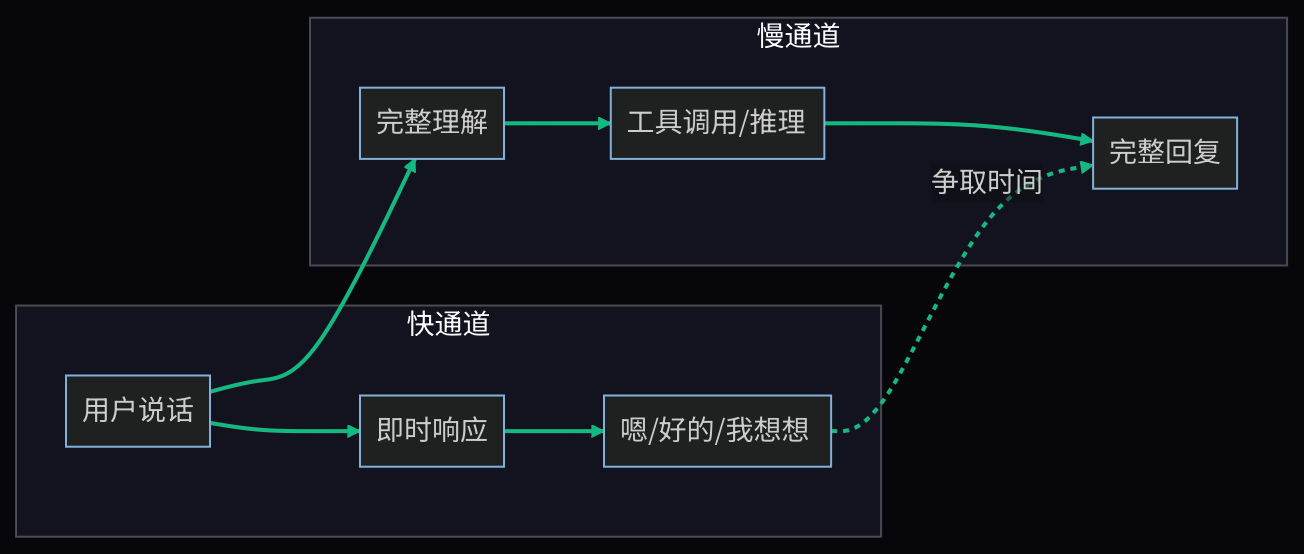
- 快通道:识别到用户说完,立即给出填充词或短确认,维持对话节奏
- 慢通道:同时启动完整的语义理解、工具调用、回复生成
- 快通道为慢通道“争取时间”,用户感知延迟从实际推理时间降到填充词的响应时间
GUI Agent 中的快慢解耦#
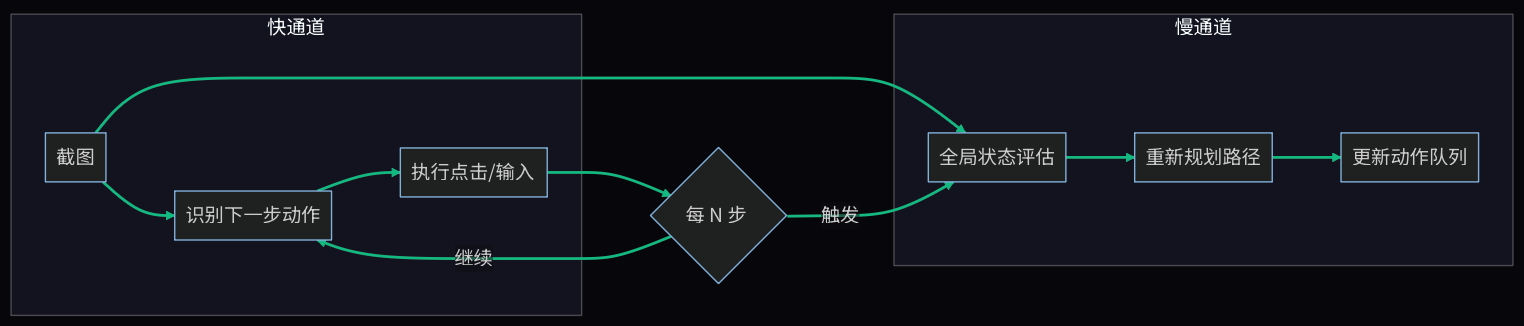
- 快通道:按已有计划快速执行下一个动作(不重新思考整体策略)
- 慢通道:每隔 N 步或检测到异常时,做全局状态评估,必要时重新规划
- 避免“每一步都做完整推理”带来的延迟爆炸
核心思想总结#
| 维度 | 快通道 | 慢通道 |
|---|---|---|
| 职责 | 维持交互节奏 | 保证决策质量 |
| 延迟要求 | <200ms | 可接受 1-5s |
| 模型规模 | 小模型/规则 | 大模型/多步推理 |
| 触发条件 | 每次交互 | 定期/异常时 |
| 失败代价 | 低(填充词/单步动作) | 高(整体策略错误) |
工程挑战#
延迟预算管理#
多模态 Agent 的延迟是硬约束,不像文本 Agent 可以“多想一会儿”。
Voice Agent 延迟预算示例:总预算 = 800ms(超过则用户感知"卡顿")
分配: 网络传输:100ms 语音理解:150ms LLM 推理:350ms(含首 token 时间) 语音合成:150ms 播放缓冲:50ms
工程手段:
- 流式处理:LLM 生成第一个句子时就开始 TTS,不等全部生成完
- 预计算:根据对话上下文预测可能的回复方向,提前准备
- 分级降级:延迟超标时,降级到模板回复或短确认
错误恢复#
多模态场景的错误恢复比文本场景复杂得多:
Voice Agent 错误恢复:
检测到错误 → 主动确认"您是说要转到人工客服,还是查询账户余额?"- ASR 识别不确定时,主动向用户确认
- 工具调用失败时,用自然语言解释并给出替代方案
- 关键操作前复述确认:“我将为您转账 500 元到 XXX 账户,确认吗?”
GUI Agent 错误恢复:
执行动作 → 截图验证 → 不符合预期 → 回退/重试- 每次动作后截图,对比预期状态和实际状态
- 页面未响应:等待 + 重试
- 导航到错误页面:检测到后回退
- 操作产生错误弹窗:识别弹窗内容,决定如何处理
共同原则:检测-确认-恢复三步循环,而不是盲目重试。