本文面向第一次接触 memU 的读者。重点不是罗列类名和文件名,而是解释它解决什么问题、实际怎样运行、一条会话怎样变成长期记忆,以及记忆怎样回到下一次 Agent 对话中。
1. TLDR:memU 到底是什么#
memU 给现有各个 Agent 增加一套跨会话记忆能力。
它做的事情可以压缩成两条链路:
保存记忆:本地 Agent Session→ 找出尚未处理的新内容→ 让 Agent 判断什么值得长期保存→ 把结果写入记忆库
使用记忆:用户的新问题→ 在记忆库中搜索相关内容→ 把命中的记忆文件交给 Agent→ Agent 带着这些历史信息继续工作
这里最重要的事实是:memU 自己不负责理解整段对话并写总结。真正判断“什么重要、该怎样合并、是否值得保存”的,仍然是宿主 Agent。memU 负责把 session、Agent 和记忆库连接起来,并保证这条链路可以增量运行、失败重试和跨宿主复用。
所以它不是:
- 一个新的聊天 Agent;
- 一个始终运行在本机的记忆服务器;
- 一个把所有对话原文直接塞进向量数据库的程序;
- 一个只属于 Codex、Claude Code 或 Pi 的专用记忆实现。
更准确地说,它是一套安装在现有 Agent 旁边的记忆基础设施。
2. 它为什么需要宿主 Agent 参与#
一段 session 里既有值得长期保留的信息,也有大量只对当次任务有用的内容。
例如:
- 用户长期偏好、项目约束,可能应该成为 memory;
- 一次调试中验证有效的步骤,可能应该成为 skill;
- 临时报错、重复命令、无关工具输出,通常不应该保存;
- 新内容可能只是补充已有记忆,而不是创建另一份近义文件。
这些判断需要理解语境。memU 没有在 MemoryService 中再调用一套 LLM,而是生成明确的整理任务,让已经运行在宿主中的 Agent 完成判断和 Markdown 编辑。
这样分工以后:
- Agent 负责内容质量;
- memU 负责工程流程和持久化;
- Markdown 是两者之间可查看、可修改的交接结果;
- embedding 只负责搜索,不负责提炼内容。
3. 先看整体架构,不急着看类名#
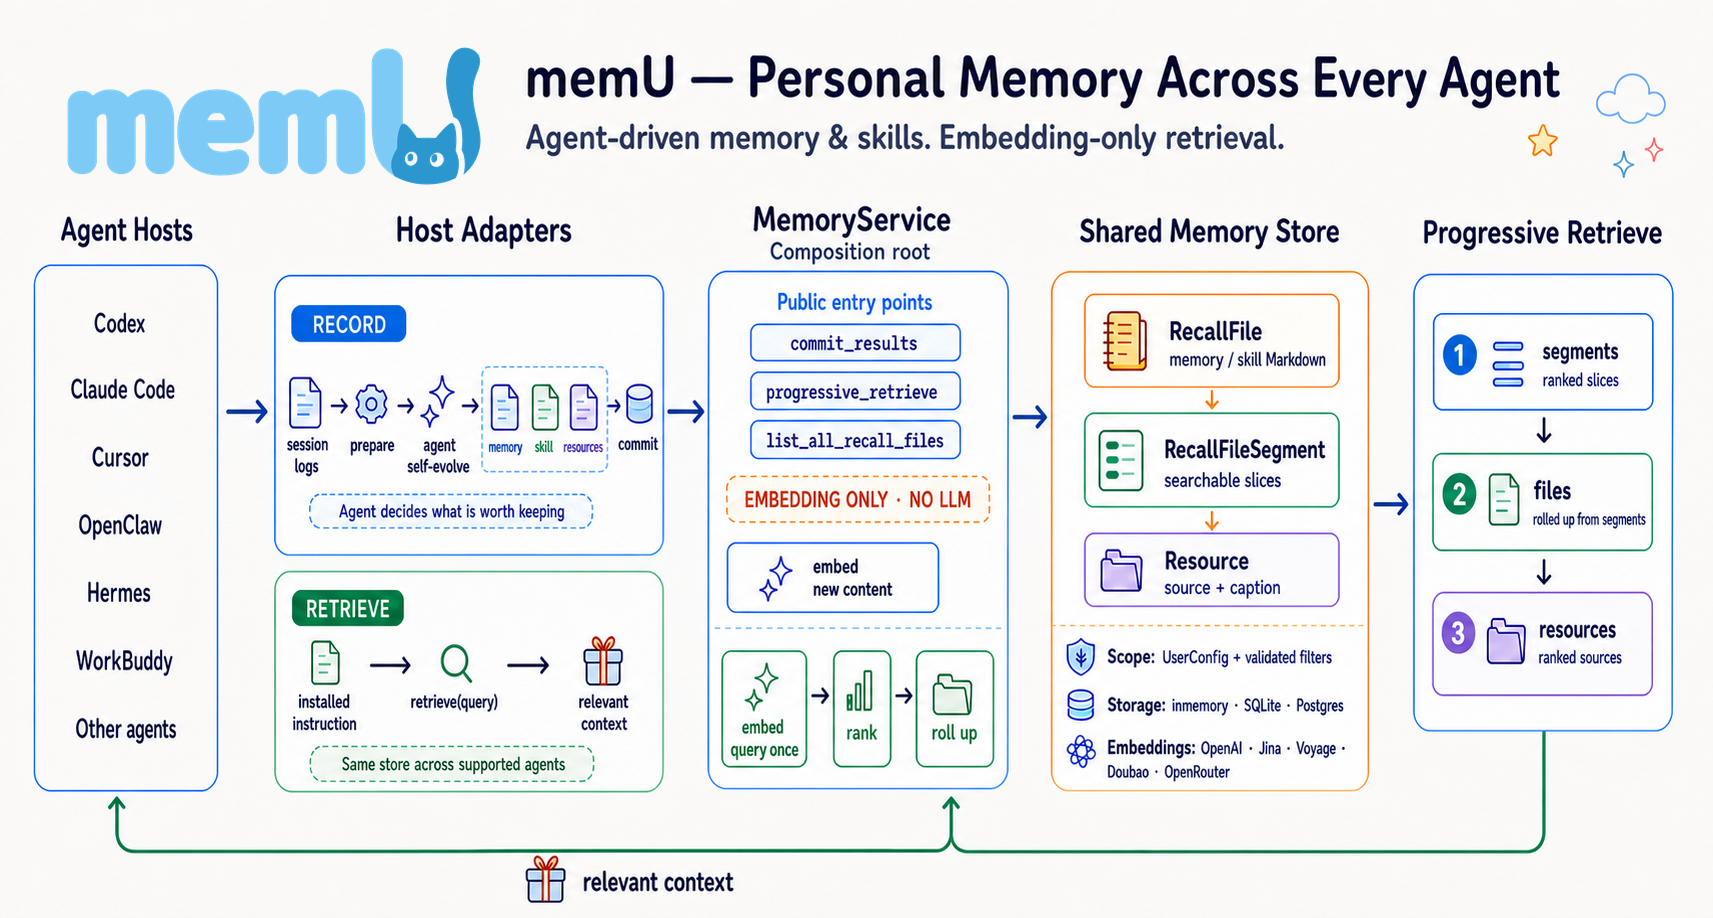
从上到下,memU 可以理解成五层:
┌──────────────────────────────────────────────┐│ 宿主接入层 ││ 知道各 Agent 的 session 在哪里、格式是什么 │└───────────────────┬──────────────────────────┘ │ 统一后的会话记录┌───────────────────▼──────────────────────────┐│ 记忆编排层 ││ 找增量、准备任务、维护游标、收集整理结果 │└───────────────────┬──────────────────────────┘ │ memory / skill / resource┌───────────────────▼──────────────────────────┐│ 记忆服务层 ││ 统一保存、更新、列出和检索记忆 │└───────────────┬───────────────────┬──────────┘ │ │┌───────────────▼──────────┐ ┌──────▼──────────┐│ Embedding 层 │ │ 存储层 ││ 把文本变成可比较的向量 │ │ 保存正文和向量 │└──────────────────────────┘ └─────────────────┘每层只解决一个问题:
| 层 | 收到什么 | 做什么 | 产出什么 |
|---|---|---|---|
| 宿主接入层 | 某个 Agent 的原始 session | 找到记录并区分对话、工具和无关数据 | 统一的会话输入 |
| 记忆编排层 | 会话输入和现有记忆 | 只处理新增部分,并安排 Agent 整理 | 更新后的 Markdown 和待提交资源 |
| 记忆服务层 | Agent 整理后的结果或检索请求 | 计算新增、更新和查询结果 | 持久化变更或命中列表 |
| Embedding 层 | 需要搜索的文本 | 生成向量 | 可用于相似度比较的数字表示 |
| 存储层 | 正文、描述、向量和范围信息 | 保存并查询 | 可长期使用的记忆数据 |
这个拆分解释了 memU 为什么容易增加新宿主:新增 Agent 时,主要变化集中在最上面的接入层,下面的整理、存储和取回流程继续复用。
4. memU 实际怎样运行:它主要是一组 CLI#
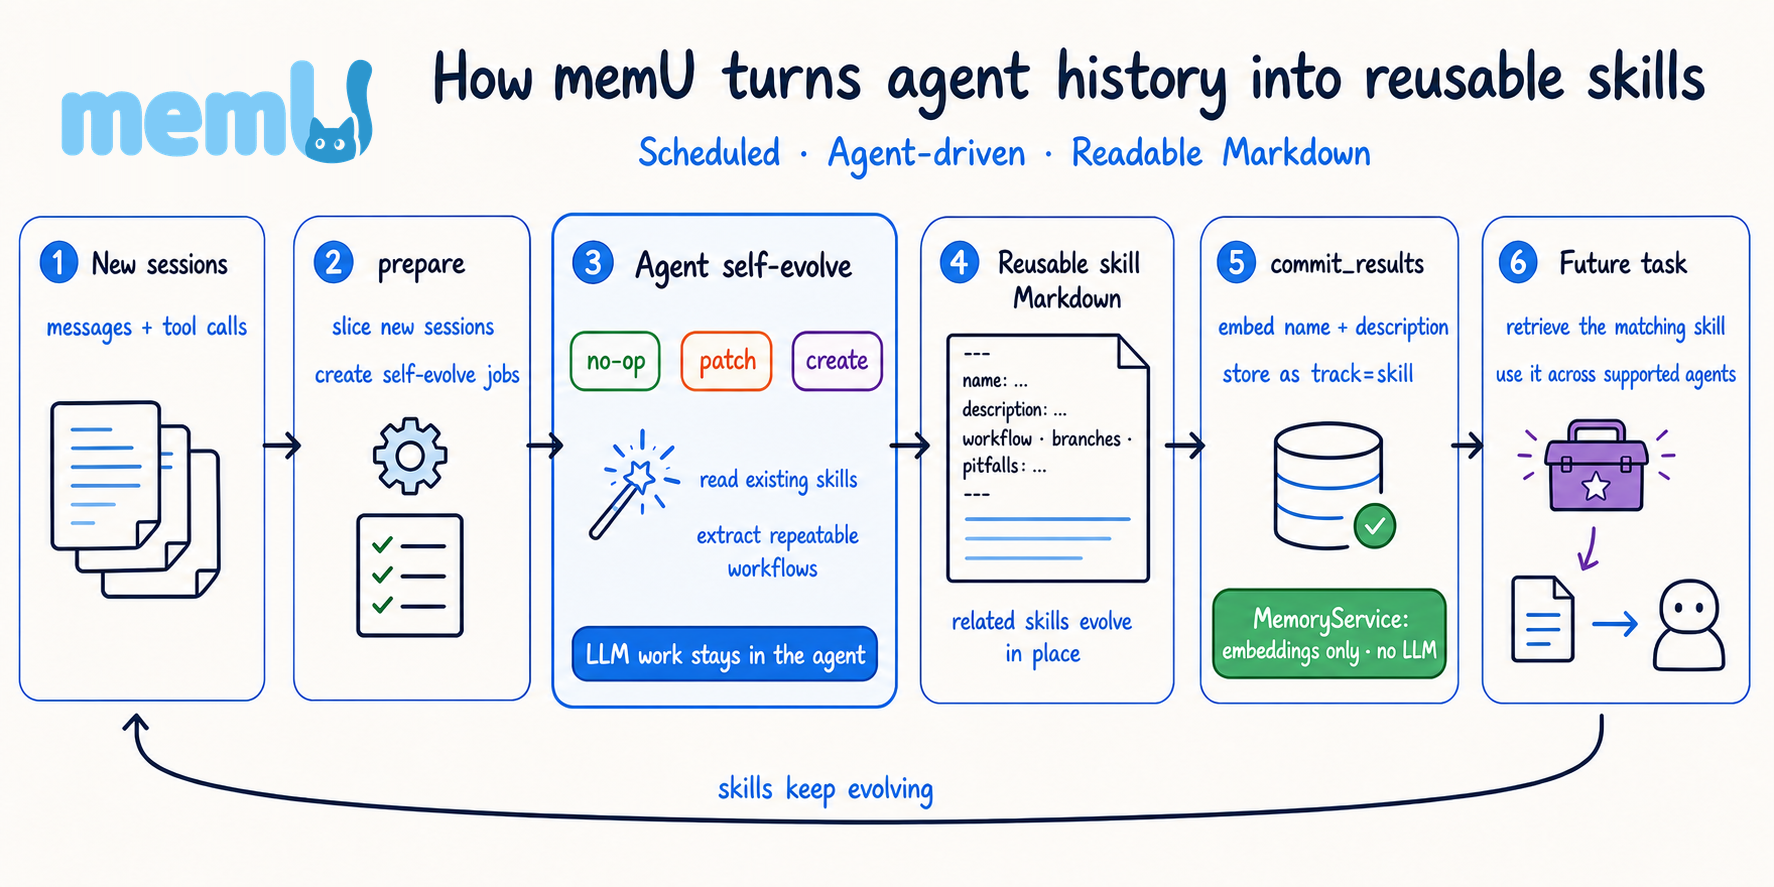
4.1 安装了什么#
Agent 侧安装的是 Python 包 memu-cli。它提供:
- 通用命令
memu; - 面向宿主的命令,例如
memu-codex、memu-claude-code; - 安装指令、检查配置、准备任务、提交结果、取回记忆和管理定时任务等子命令。
安装接入通常还会产生几类本地文件:
~/.memu/config.env:本地/Cloud 模式、数据库和 embedding 配置;- 宿主的持久指令或 retrieval skill:告诉 Agent 什么时候取回记忆;
~/.memu/hosts/<host>/...:该宿主的游标、任务和临时工作区;- OS 定时任务:周期性启动后台记忆整理。
只安装 Python 包不代表所有能力已经启用。还需要完成配置、宿主指令安装和定时任务注册。
memU 没有一个包办所有步骤的 memu install 命令。以专用 adapter 为例,安装过程通常由安装 Agent 按下面顺序执行:
pip install --upgrade memu-cli→ memu-<host> init 写入本地/Cloud 配置 `~/.memu/config.env`→ memu-<host> docs install 打印该宿主的完整安装指南 `INSTALL.md`→ memu-<host> docs task 打印定时任务配置指南 `BRIDGING_TASK.md`→ 按指南登记 scheduler Unix 写 cron/launchd;Windows 运行 schedule install→ memu-<host> install-instruction 安装 retrieve 指令和 skill→ memu-<host> doctor 检查配置和记忆 backend因此 macOS/Linux 上的 cron 虽然属于整体安装流程,但不是 docs task 自动创建的,而是安装 Agent 或用户读取指南后创建 bridge.sh、prompt 文件并登记 crontab。Generic adapter 使用相同思路,只是命令名换成 memu-agent,并且需要在安装时提供 session 路径和 Agent 的无头启动方式。
4.2 没有常驻的本地 MemoryService 进程#
文档中的“记忆服务层”是代码职责,不等于一台持续监听端口的服务器。
local mode 下,每次运行 CLI 时,它会在当前进程内创建一个 MemoryService 对象,完成数据库和 embedding 操作,然后随 CLI 一起退出。用户不需要另外启动 memu-server、FastAPI 或 Uvicorn。
一次前台取回的进程关系是:
用户正在使用的 Agent 进程→ 根据 Skill/持久指令启动 `memu-<host> retrieve` CLI 子进程→ CLI 临时创建本地 MemoryService 或 CloudMemoryClient→ 完成搜索并输出 JSON→ CLI 子进程退出→ Agent 读取命中的记忆文件并继续回答一次后台整理的进程关系是:
OS 调度器 cron / launchd / Windows Task Scheduler 到点→ 启动一次无头 headless Agent 进程→ 如有上轮遗留 jobs:先处理并运行 memu-<host> commit→ 运行 memu-<host> prepare→ Agent 读取 jobs,执行生成的整理任务 no-op / patch / create→ 运行 memu-<host> commit→ 无头 Agent 进程退出定时器通常不直接执行 prepare。它先启动无头 Agent,并把 bridging prompt 交给 Agent;Agent 再按 prompt 调用 memU CLI。有三个阶段:
| 阶段 | 谁执行 | 重点 |
|---|---|---|
prepare | memu-<host> CLI 子进程 | 纯代码:读取增量 session、镜像旧记忆、生成 jobs |
| self-evolve | 无头 Agent 本身 | 模型工作:理解 job 和 session,修改 Markdown;没有对应的一条 memU CLI |
commit | memu-<host> CLI 子进程 | 纯代码:找出变化、计算 embedding、写入本地或 Cloud backend |
4.3 Retrieve 和 Record 是两套独立入口#
memU 接入 Agent 时有两个不同方向:
- Retrieve / Inject:在用户提问时搜索旧记忆,属于前台热路径。
- Record / Memorize:定期读取历史 session 并整理新记忆,属于后台任务。
Retrieve 通常依靠写入宿主的持久指令或 skill,让 Agent 在合适时主动调用 CLI。它不一定是宿主提供的原生 hook。
Record 依靠某种 OS 调度器启动一个能够执行整理任务的 Agent:可以是 cron、launchd、Windows Task Scheduler,也可以是 Codex/OpenClaw/WorkBuddy 等宿主自己的任务系统。
因此,取回成功不能证明后台整理已经正常运行;定时任务正常也不能证明每次对话前都执行了取回。两条链路要分别检查。
4.4 不同 Agent 怎样定时执行 Record#
所有宿主最终都要定期执行同一件事:启动一个有模型能力的 Agent,让它按照固定 prompt 完成 prepare -> self-evolve -> commit。不同之处不在记忆算法,而在“谁负责到点启动 Agent”。
当前有三类接法:
| 调度接法 | 代表宿主 | 谁保存时间表 | 到点后启动什么 |
|---|---|---|---|
| OS 调度器 + headless Agent CLI | Claude Code、Cursor、Hermes | Windows Task Scheduler,或 Unix cron/launchd | 一个新的无头 Agent OS 进程 |
| 宿主原生任务系统 | Codex、OpenClaw、WorkBuddy | 宿主自己的 scheduled task / cron / automation | 一个由宿主创建的独立 Agent task/turn |
| Generic adapter | 尚无专用 adapter 的 Agent;官方 main 中的 Pi 目前属于这条 | 优先使用宿主原生调度,否则由用户配置 cron 等外部调度 | 安装时确定的 headless Agent 命令 |
无论由谁调度,定时 prompt 的主体都相同:先处理上次中断留下的 job,再 prepare,接着由 Agent 逐个执行 job,最后 commit。
4.4.1 Generic adapter:启动知识固化在安装结果中#
Generic adapter 不可能预先知道任意 Agent 的二进制位置、无头参数和认证方式。因此在 Unix 上,安装过程会根据当前机器生成类似下面的结构:
crontab 每小时触发└─ ~/.memu/hosts/agent/bridge.sh └─ <agent-cli> <headless-flag> "$(cat bridge-prompt.txt)" ├─ memu-agent prepare 纯代码:读增量并生成 job ├─ Agent 执行 jobs 模型工作:读会话并写 Markdown └─ memu-agent commit 纯代码:diff、embedding、写本地或 Cloudbridge.sh 负责固化这台机器上的事实,包括:
- Agent 可执行文件和 memU CLI 的路径;
- 无头运行参数;
- 独立保存的 prompt 文件;
- cron 环境缺失时需要补充的
PATH; - 防止同一任务重叠的目录锁;
- 日志重定向。
crontab 只保存一条很短的 wrapper 命令,不直接内联长 prompt。这样既避开 cron 行长度和 quoting 问题,也让机器相关配置集中在 wrapper 中。
截至当前官方 main,Pi 没有专用 adapter,所以它可以按 generic 路线把 pi -p 写入 wrapper。这里的局限是:generic adapter 只能依靠安装指南和当前机器完成配置,不能由 memU 代码声明 Pi 的启动、认证和 self-session 识别规则。
4.4.2 专用 adapter + OS 调度器:启动规则由 HostSpec 声明#
Claude Code、Cursor、Hermes,都声明了标准的 headless 命令:
Claude Code claude -p <prompt>Cursor cursor-agent --trust -p <prompt>Hermes hermes -z <prompt>Unix 和 Windows 使用这份知识的方式不同:
- macOS/Linux:
memu-<host> docs task只打印操作指南。安装 Agent 或用户按指南生成bridge.sh、prompt 文件并登记 cron;cron 是默认方案,用户明确选择时也可以用 launchd 调用同一个 wrapper。Unix 端的schedule子命令只提示查看文档,不会自动修改 cron 或 launchd。 - Windows:
memu-<host> schedule install根据schedule_command自动生成 prompt 和 PowerShell wrapper,并注册一个无窗口的 Task Scheduler 任务;同组命令还提供verify、status和uninstall。
专用 adapter 还能声明 generic 接入很难稳定补齐的运行条件:
needs_headless_auth:定时进程没有桌面应用的交互登录态,注册前必须验证 standalone CLI 在裸环境中确实能认证。Claude Code 可能需要setup-token,Cursor/Pi 也需要各自可被无头进程读取的凭据。session_id_env:无头 Agent 调用 memU CLI 时,把当前 session 的精确 ID 传下来。prepare 可以据此排除本次 bridging 自己产生的 session,避免下个周期继续整理“memU 正在整理记忆”这段记录。
* pi-schedule-prompt 插件#
pi-schedule-prompt 是运行在 Pi 扩展进程内的定时能力。它和 memU 的 OS 调度方案有三个根本差异:定时器在哪里、触发后运行什么、Pi 退出后是否还能执行。
它的调度器使用 croner 和 Node timer:cron job 由 new Cron(...) 管理,interval job 使用 setInterval,once job 只触发一次。扩展激活时把已启用任务挂到当前 Pi 进程;session 结束时停止。触发和 Agent 此刻是否正在回答没有直接关系,但 Pi 进程必须仍然存活。
croner npm 包不是 OS cron,而是“支持 cron 表达式的进程内定时器”。
三种 job 的区别:
| 类型 | 表达的时间规则 | 实现方式 | 示例 |
|---|---|---|---|
cron | 按日历时间重复执行 | new Cron(expression, callback) | 每小时整点、每天 9 点 |
interval | 从启动时开始,每隔固定时长执行 | setInterval(callback, ms) | 每隔 30 分钟 |
once | 在某个时间只执行一次 | 一次性 timer,通常是 setTimeout | 今天 18<00> 提醒一次 |
pi-schedule-prompt 到点后有两种投递方式:
| Job 配置 | 实际执行方式 | 状态边界 |
|---|---|---|
| 没有指定 model | 向当前 session 投递 follow-up;当前 Agent 正忙时通过已有 steer/follow-up 机制排队 | 继续使用当前 AgentSession |
| 指定 model | createAgentSession() 创建一个独立的进程内 AgentSession,运行一次 prompt,再把结果作为 scheduled_prompt marker 回贴当前 session | 上下文和消息队列独立,但不创建 OS 子进程,也不持久化该临时 session |
因此它与 memU OS 调度的进程关系区别是:
Pi pi-schedule-prompt | memU 的 OS 调度路线 | |
|---|---|---|
| 定时器位置 | Pi Node 进程内 | Agent 进程之外的 cron、launchd 或 Task Scheduler |
| 被调度的运行 | 当前或新建的进程内 AgentSession | 新的 headless Agent OS 进程 |
| Pi/交互 Agent 退出后 | 定时器停止 | 仍可按计划启动并读取磁盘 session |
| 可见状态 | 可以共享同一进程中的环境、密钥和扩展状态 | 不共享交互进程内存,只能读取磁盘和配置 |
Pi + Croner:Pi Node 进程└─ Croner timer   └─ 调用进程内 executeJob()
memU:操作系统 scheduler└─ 到点启动新的 headless Agent OS 进程
一个 Node 进程为什么能同时推进多个 Pi AgentSession?
createAgentSession()创建的是另一个会话对象,不是另一个线程或 OS 进程。每个 session 有自己的消息状态和运行锁,但它们都运行在同一个 Node 事件循环中。Agent 的运行循环会持续
await agent.prompt(...)、await agent.continue()、等待模型网络响应或工具结果。某个 session 等待 I/O 时,不占用 JavaScript 执行栈,事件循环就可以继续推进另一个 session 的异步任务:这叫协作式并发:多个 session 的等待时间可以重叠,但同一时刻仍只有一段 JavaScript 在执行。它不是多进程并行,也不是两个 session 共用同一条消息队列。每个 AgentSession 的
_isAgentRunActive只防止该 session 自己重入,不会形成阻止其他 session 运行的全局锁。
5. 本地版和 Cloud 版有什么区别#
两种模式共用上面的宿主接入和编排流程,区别主要在记忆最终写到哪里。
| 运行方式 | 数据去向 | 需要用户运行什么 | memu.so 网页能否看到 |
|---|---|---|---|
| 本地 SQLite | 本机 SQLite 文件 | 不需要数据库服务 | 不能 |
| 本地 PostgreSQL | 用户提供的 PostgreSQL/pgvector | 需要自己运行或购买数据库服务 | 不能 |
| memU Cloud | memU 的远程 API | 不需要本地数据库服务 | 能 |
配置中的 MEMU_MEMORY_MODE 决定使用 local 还是 cloud。
这里的 local 只表示记忆数据库由用户自己控制,不保证所有计算都离线。embedding provider 仍可能是 OpenAI、Jina、Voyage 等远程 API;如果要求数据处理完全留在本机,还需要配置本地的 OpenAI-compatible embedding 服务,并确保写入和检索始终使用同一模型。
5.1 本地 SQLite#
CLI 直接打开 MEMU_DB 指向的 SQLite 文件。它最适合个人机器和单写者场景,不需要另起数据库进程。
5.2 本地 PostgreSQL#
CLI 通过 DSN(Data Source Name,数据库连接字符串) 连接 PostgreSQL。例如:
postgresql://memu_user:password@127.0.0.1:5432/memu拆开就是:
postgresql:// 数据库类型memu_user 用户名password 密码127.0.0.1 数据库地址5432 PostgreSQL 端口memu 数据库名memU 不会替用户启动数据库;安装 postgres extra 只提供 Python 客户端。服务端还需要 pgvector,初始化数据库的连接用户需要创建扩展和表的权限。
5.3 memU Cloud 和网页端#
Cloud mode 下,CLI 不创建本地 MemoryService,而是创建 CloudMemoryClient,通过 Bearer API key 调用 api.memu.so。
网页能显示记忆,是因为 Agent 整理出的 memory/skill 已经由 commit 上传到 memU Cloud。网页不是从浏览器读取用户电脑里的 SQLite,也不会直接查看宿主的原始 session 文件。
仍然留在本地的内容包括:
- 原始 Agent session;
- 本轮增量切片;
- 等待 Agent 执行的 job;
- session cursor;
- 用于编辑和取回的 Markdown 副本。
API key 是长期凭据,不应出现在对话、文档、issue 或日志中。已经粘贴到 session 的 key 应当轮换。
6. 第一条纵向链路:一段 Session 怎样变成记忆#
先看完整流程:
Agent 持续保存本地 Session→ memU 找出上次成功处理之后的新记录→ 将记录整理为“只含对话”和“对话加工具”两份输入→ 读取当前已有记忆,生成本轮整理任务→ Agent 判断哪些内容不保存、更新旧文件或创建新文件→ memU 只收集实际发生变化的结果→ 在第一次写数据库前完成所有新 embedding→ 写入记忆和搜索分段→ 全部成功后推进 session cursor下面按层解释每一步。
6.1 宿主层:找到并读懂 Session#
不同 Agent 保存 session 的位置和格式不同。Codex、Claude Code、Cursor、Pi 可能都使用 JSONL,但字段结构并不相同;另一些宿主可能使用 SQLite。
宿主 adapter 需要解决四件事:
- 到哪里发现 session;
- 怎样按增量读取新记录;
- 哪些记录是用户/助手对话;
- 哪些记录是工具调用、系统元数据或应该忽略的噪声。
输出不是最终记忆,只是一份干净、统一的会话输入。
实现上,这层叫 TranscriptSource;宿主的命令、指令位置和调度方式由 HostSpec 描述。读者只需要记住:它们把“各家不同的 session”转换为“下面流程都认识的输入”。
6.2 增量层:只处理上次成功位置之后的内容#
memU 为每个宿主保存独立 cursor。准备新任务时,它根据 cursor 只读取新增或发生变化的 session,而不是每次重新整理全部历史。
每个 session 会生成两份输入:
- 只保留用户和助手对话,用于判断长期事实、偏好和项目背景;
- 同时保留对话与工具轨迹,用于还原任务怎样完成、哪些步骤有效。
新 cursor 此时只写入 pending 文件,不立即覆盖正式 cursor。原因很直接:准备完成不代表记忆已经保存成功。
6.3 准备层:把现有记忆和新 Session 变成任务#
Agent 修改记忆之前,需要看到旧内容,否则很容易重复创建近义文件。
因此 prepare 会:
- 从记忆库读取已有 memory 和 skill;
- 把它们镜像为本地 Markdown;
- 记录这些文件当前的 hash;
- 为每个新增 session 生成 memory job 和 skill job;
- 最后生成一个 resource job,整理近期真正修改过的工作区文件。
到这一步,memU 只准备材料和任务,还没有替 Agent 作语义判断,也没有提交新记忆。
6.4 Agent 整理层:决定不保存、更新还是创建#
后台启动的 Agent 按顺序读取 job。每个 job 都明确给出输入路径、输出目录和整理规则。
Agent 对每份输入作三种选择:
no-op:没有值得长期保存的新内容;patch:把新信息合并进已有 memory 或 skill;create:确实出现了新的长期主题,创建 Markdown。
这一步才是真正的“记忆提炼”。它发生在宿主 Agent 中,不发生在 MemoryService 中。允许 no-op 很重要,否则每次 session 都生成文件,记忆库很快会充满重复和一次性信息。
6.5 结果收集层:只提交真正变化的文件#
Agent 完成所有 job 后,commit 不依赖 Agent 自报“改了哪些文件”,而是比较整理前后的文件 hash。
它只收集:
- 新建或内容变化的 memory;
- 新建或内容变化的 skill;
resources.md中通过验证的文件路径和描述。
没有变化的文件不进入后面的 embedding 和数据库写入。
6.6 向量准备层:先把最容易失败的外部调用做完#
commit_results 先读取数据库当前状态,计算这次需要新增和更新什么。这时不写数据库。
接着它收集真正需要新向量的文本:
- 新的或变化的 memory/skill 描述;
- 新的或变化的检索分段;
- 新的或变化的 resource 描述。
未变化的文本沿用原 embedding,重复文本在同一批次中只计算一次。所有新 embedding 作为一个批次完成后,才开始写数据库。
这样安排的本质是:网络错误和 rate limit 最常发生在 embedding 阶段。让它在第一次数据库写入之前完成,可以保证 embedding 失败时原记忆库完全不变,整批任务能够原样重试。
注意:向量不是单独建立一张统一的 embeddings 表。
memU 有三张主要业务表,每张表直接包含自己的 embedding 列:
| 表 | 保存什么 | embedding 对应的文本 |
|---|---|---|
resources | 工作区文件路径和描述 | 文件描述 caption |
recall_files | 完整 memory/skill Markdown | 文件的名称和描述 |
recall_file_segments | 可参与检索的细粒度片段 | segment 的 text |
关系大致是:
RecallFile├─ 完整 Markdown 正文├─ description├─ embedding└─ 1..N 个 RecallFileSegment      ├─ text      └─ embedding
Resource├─ 文件路径├─ caption└─ embedding
RecallFileSegment 单独成表,不是因为向量必须分表,而是因为一份完整文件可能拆出多个可搜索片段。
SQLite 怎么实现 embedding#
先区分两个动作:
- embedding provider 负责把文本转换成向量;
- SQLite 只负责保存向量,不负责计算向量。
例如一条记忆:
用户主要使用 Python 开发可能被 embedding provider 转成:
[0.012, -0.083, 0.127, 0.044]SQLite 没有原生 vector 类型,所以 memU 把它作为 JSON 数组保存在同一行的 embedding 字段中:
text = "用户主要使用 Python 开发"embedding = [0.012, -0.083, 0.127, 0.044, ...]检索时:
当前问题→ 使用同一个 embedding 模型生成查询向量→ 从 SQLite 读取候选记录的 embedding→ Python/NumPy 计算余弦相似度→ 返回分数最高的 top-k也就是说,SQLite 主要做普通数据保存,向量排序在 Python 进程中完成。
这适合个人本地记忆,因为数据量通常不大;如果有几十万、几百万个 segment,每次把候选向量读到 Python 扫描就会变慢。
PostgreSQL + pgvector 怎么实现#
PostgreSQL 自身也没有完整的向量检索能力,memU 会启用 pgvector 扩展:
CREATE EXTENSION IF NOT EXISTS vector;然后在普通表中增加 VECTOR 类型的列:
text TEXTembedding VECTOR
vector列:
- 支持向量运算。你可以直接使用
pgvector提供的操作符(如<->欧氏距离、<=>余弦相似度)进行相似度搜索,找到与目标向量最接近的 K 个结果。- 为高速相似度搜索进行了优化。可以创建专用索引,如
IVFFlat或HNSW,从而在百万级数据中实现毫秒级的近似最近邻搜索。
以 segment 为例,数据库可以直接执行类似的逻辑:
SELECT *FROM recall_file_segmentsORDER BY embedding <=> :query_vectorLIMIT 5;<=> 计算余弦距离。距离越小,文本越相关。
当前 memU 的准确边界是:
RecallFileSegment配置为 pgvector 时,会在 PostgreSQL 内完成余弦排序和LIMIT top_k;Resource虽然也存为VECTOR列,但当前仍把候选取到 Python 中计算余弦相似度;- 当前 migration 创建了
VECTOR列,但没有额外创建 HNSW 或 IVFFlat 近似向量索引。
因此不能简单理解成“只要使用 PostgreSQL,所有搜索都自动走高性能向量索引”。
怎么理解“向量化存储”#
本质上是同时保存两份信息:
原始文本:供 Agent 最终阅读embedding:供程序判断哪些文本与当前问题语义接近完整流程:
写入时:文本 → embedding 模型 → 向量             ↓数据库同时保存文本和向量
查询时:用户问题 → 同一个 embedding 模型 → 查询向量                                  ↓                    与数据库向量计算相似度                                  ↓                        找到对应的原始文本
向量不会替代正文,也不能直接当记忆内容阅读。它只用于排序。
还必须满足一个硬条件:写入和查询应使用相同或兼容的 embedding 模型,并保持相同维度。否则:
- 向量维度可能不一致,无法计算;
- 即使维度相同,不同模型的向量空间也不可直接比较;
- 更换 embedding 模型后,通常需要重新向量化已有数据。
6.7 存储层:写入正文、描述和搜索分段#
embedding 成功后,memU 依次更新:
- 最近使用过的工作区文件;
- 完整 memory/skill 文件;
- 用于向量检索的细粒度分段。
数据库中对应的名称是 Resource、RecallFile 和 RecallFileSegment。
当前整个 commit_results 没有一个包住所有 repository 写入的总事务。因此它能保证 embedding 失败时零写入,但 embedding 成功后如果数据库操作自身失败,仍可能出现部分写入。这是当前可靠性边界。
6.8 状态确认层:成功后才推进 Cursor#
只有存储 backend 成功返回后,commit 才会:
- 把 pending cursor 提升为正式 cursor;
- 更新本地 memory hash 快照;
- 清理已经完成的 job 和临时切片。
如果中途失败,正式 cursor 不前移。下次运行会重新处理这批 session,而不是把尚未保存的内容错误标记为“已经记住”。
7. 失败时哪些状态会变化#
理解失败边界比记住命令更重要:
| 失败位置 | 已有记忆是否变化 | cursor 是否推进 | 下次怎样处理 |
|---|---|---|---|
| session 读取或 prepare 失败 | 否 | 否 | 修复后重新 prepare |
| Agent 执行 job 中断 | 否 | 否 | 先处理遗留 job,再继续 |
| embedding 失败 | 否 | 否 | 整批原样重试 |
| 数据库写入中途失败 | 可能部分变化 | 否 | 再次 commit,依靠 upsert/差异规划收敛 |
| commit 全部成功 | 是 | 是 | 下次只处理后续增量 |
这套机制追求的不是跨 Agent、文件系统、网络和数据库的完整分布式事务,而是一个更实际的保证:没有确认持久化成功,就不把输入标为已处理。
8. memU 最终保存的三类内容#
理解完整链路之后,再看存储名词会简单很多。
8.1 Memory:长期事实和背景#
输入主要是对话内容。目标是保存用户偏好、稳定事实、项目背景和长期约束。它回答的是:“后续任务需要继续知道什么?”
8.2 Skill:可重复执行的方法#
输入包含对话和工具轨迹。目标是保存已经验证过的步骤、失败分支、边界情况和检查方法。它回答的是:“以后再遇到这类任务,怎样完成?”
8.3 Resource:近期相关的工作区文件#
输入来自 session 中的工具轨迹。它只记录 Agent 实际创建或修改过、目前仍存在并能描述的文件,不是扫描整个仓库建立全文索引。
在数据库中,memory 和 skill 都以 RecallFile 保存,只是 track 不同;resource 使用单独的 Resource 记录。
memory ─┐        ├─ RecallFile + RecallFileSegment,通过 track 区分skill  ─┘
resource ─ Resource,单独一张表
9. 第二条纵向链路:新问题怎样取回旧记忆#
取回链路比记录链路短得多:
用户提出新问题→ Agent 根据持久指令运行 retrieve CLI→ memU 为问题计算一次 embedding→ 搜索相关 memory/skill 分段和 workspace resource→ 把命中的完整记忆写成本地 Markdown→ 返回路径、描述和分数→ Agent 选择需要打开的文件→ 带着相关记忆回答问题9.1 为什么先搜分段,再返回完整文件#
一份 memory 可能包含多个事实。直接用整份长文做一次比较,相关信息容易被其他内容稀释。因此 memory 会拆成较短的检索分段。
搜索命中分段后,memU 找到它所属的完整文件,并把文件路径交给 Agent。这样搜索阶段使用聚焦的文本,消费阶段仍能看到完整上下文。
skill 当前主要根据名称和描述搜索,命中后再打开完整正文。因此 skill 的描述是否准确,会直接影响它能否被找回。
9.2 progressive_retrieve 并不是多轮 LLM 检索#
当前实现只做一次 query embedding 和向量搜索,再把 segment 命中归并为文件命中。它不包含:
- LLM 意图分类;
- 结果是否充分的判断;
- 自动摘要;
- BM25;
- 图遍历或 multi-hop;
- reranker。
“先返回命中列表,再由 Agent 按需打开文件”是 Agent 和文件系统共同完成的渐进消费,不是 MemoryService 内部又运行了一轮 Agent。
10. 不同 Agent 的记忆会不会放在一起#
默认会共享长期记忆。
多个宿主通常使用同一个 ~/.memu/config.env,也就连接同一个 SQLite、PostgreSQL 或 Cloud backend。这样 Codex 整理出的记忆可以被 Pi 或 Claude Code 取回。
按宿主隔离的是工作状态:
- session 来源;
- 增量 cursor;
- pending manifest;
- job 和临时切片。
默认不按宿主隔离的是长期数据:
- memory;
- skill;
- workspace resource。
数据模型虽然支持 user_id 和 agent_id scope,但标准 host bridging 不会自动把宿主名变成独立 agent_id。因此“数据库有 agent_id 字段”不能推导出“不同 Agent 已经自动隔离”。
如果确实需要完全隔离,最直接的方式是为不同 Agent 使用不同 MEMU_CONFIG_ENV,分别指向不同数据库或 Cloud 空间;通过 Python SDK 集成时,也可以显式传 scope,并在保存和取回两端保持一致。
11. 宿主和操作系统是两个不同的扩展维度#
“支持 macOS、Windows、Linux”不代表每个平台各写了一套记忆算法。
宿主差异主要是:
- session 保存位置和记录格式;
- Agent 指令文件位置;
- 无头运行命令;
- 如何识别后台任务自己的 session。
操作系统差异主要是:
- macOS/Linux 通常使用 cron 和 shell wrapper;
- Windows 使用 Task Scheduler 和 PowerShell wrapper;
- 路径、可执行文件发现和 quoting 规则不同。
不同宿主主要替换 session 接入和运行配置,核心编排 prepare-job-commit、向量化、存储和取回流程公用保持不变。
12. 总结#
memU 是给现有各个 Agent 增加跨会话记忆提取和检索的能力。
memU 的安装是通过安装一个 memU-cli,然后各个 agent 运行安装命令,一方面是在 os 调度器注册记忆提取的定时任务,有拉起 agent 的指令;一方面是给 agent 注册记忆 retrieve 的指令或者 skill。
记忆提取链路是通过系统 cron 定时任务调度器拉起对应的无头 agent 进程,然后让 agent 自己运行 CLI 的 prepare 命令,读取 session 本地 JSONL 新增历史,然后生成记忆任务;agent 执行任务进行记忆更新和提取(记忆主要有三种类型,session 事实、skill 提炼,还有最近修改的文件);最后再运行 CLI 的 commit 命令,CLI 会把修改的记忆 md 与原有 md 进行 hash 比较,然后把最新的 md 文件提交到后端数据库并进行 embedding 后存入 vector 列。
记忆检索链路是 agent 调用 skill 运行 CLI 的 retrieve 命令进行渐进式检索,渐进式的意思是首先对 memory segment 片段表进行余弦相似度排序,得到 top-k 相关内容,然后汇总得到所有 memory 完整文件放入上下文。