Harness Engineering#
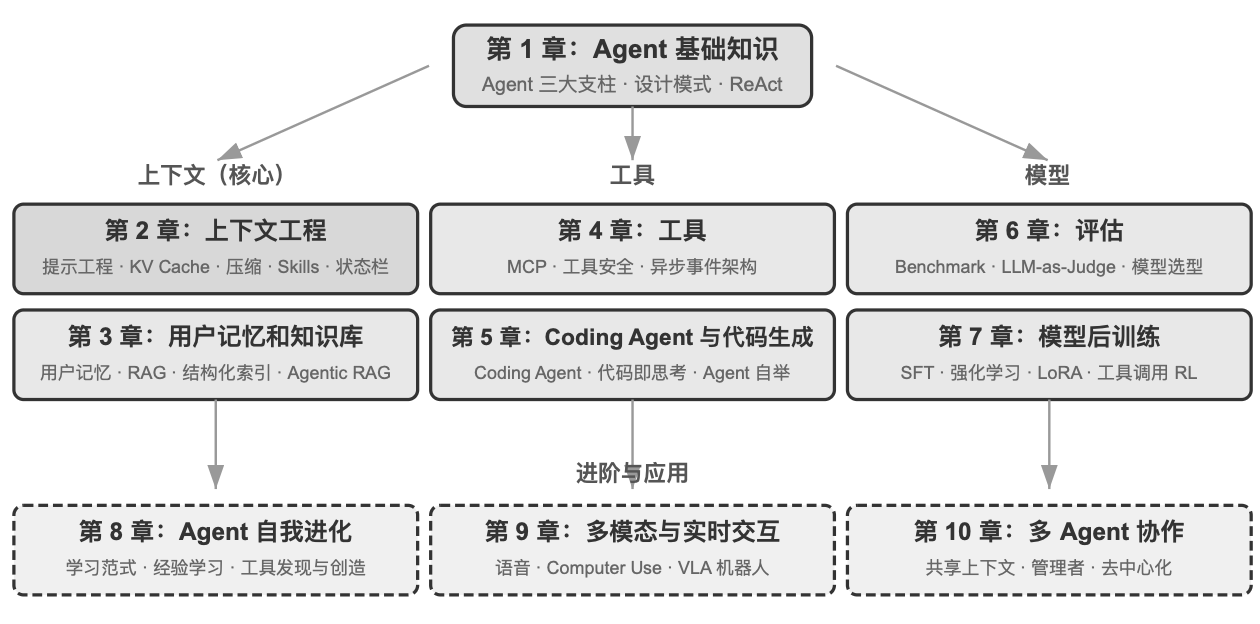
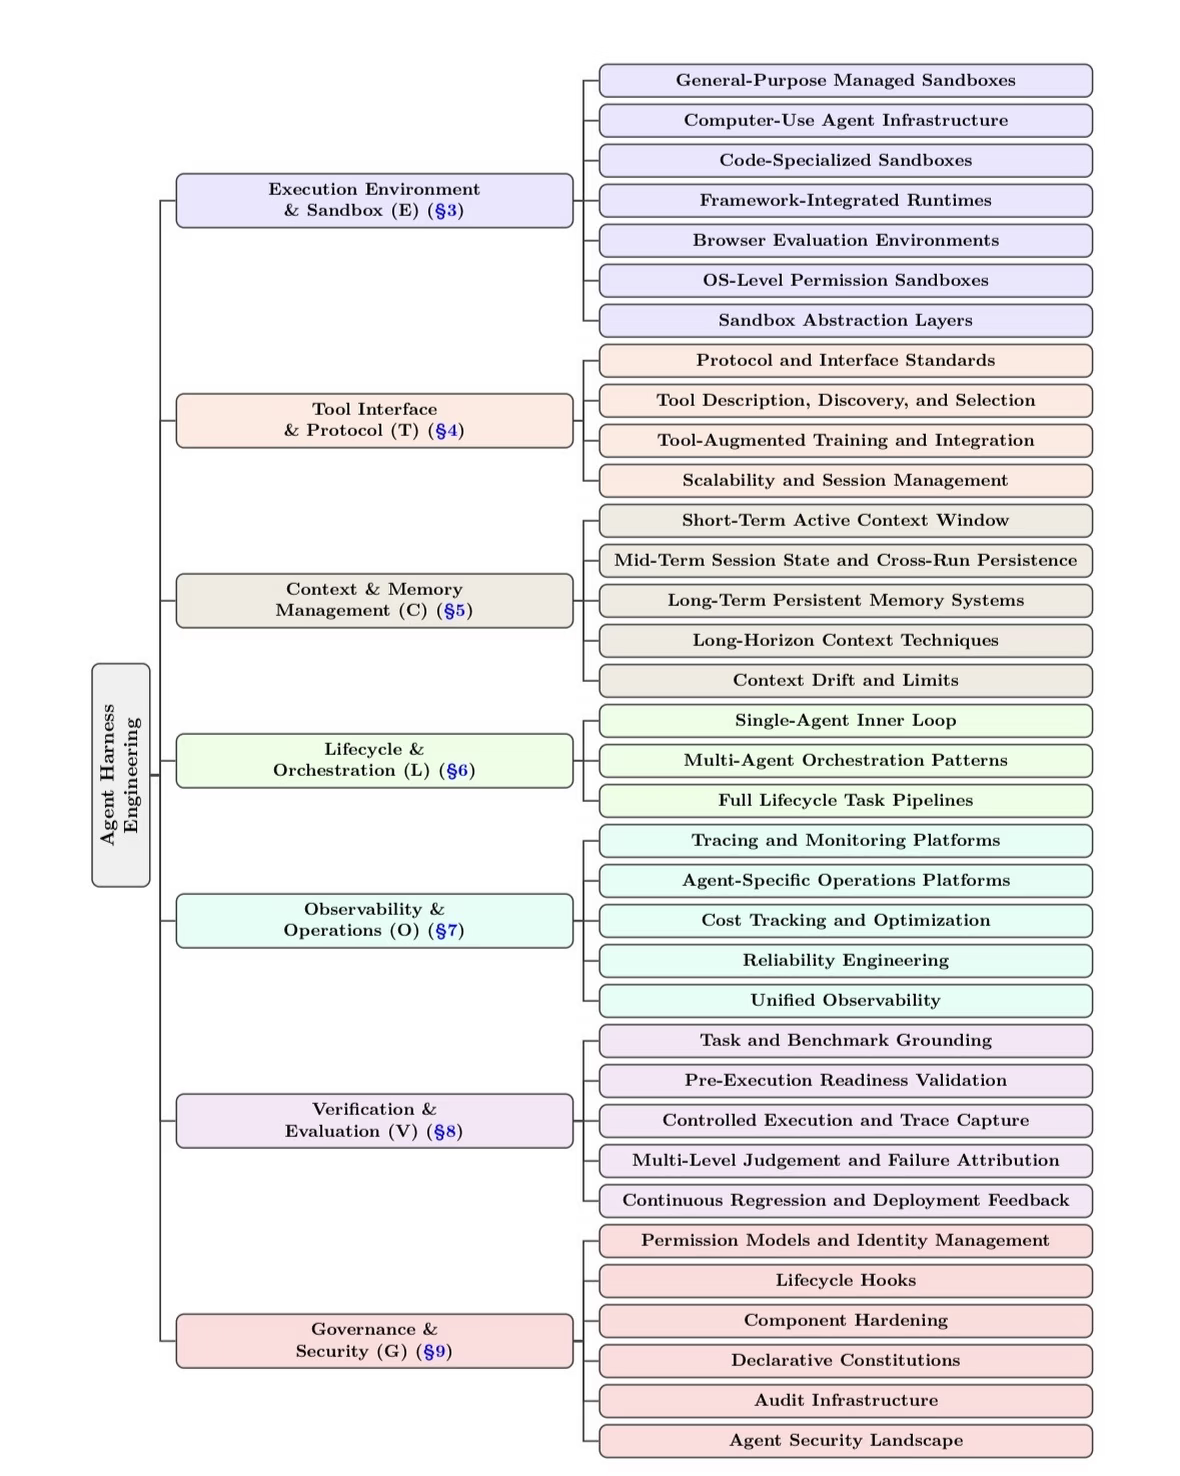

-
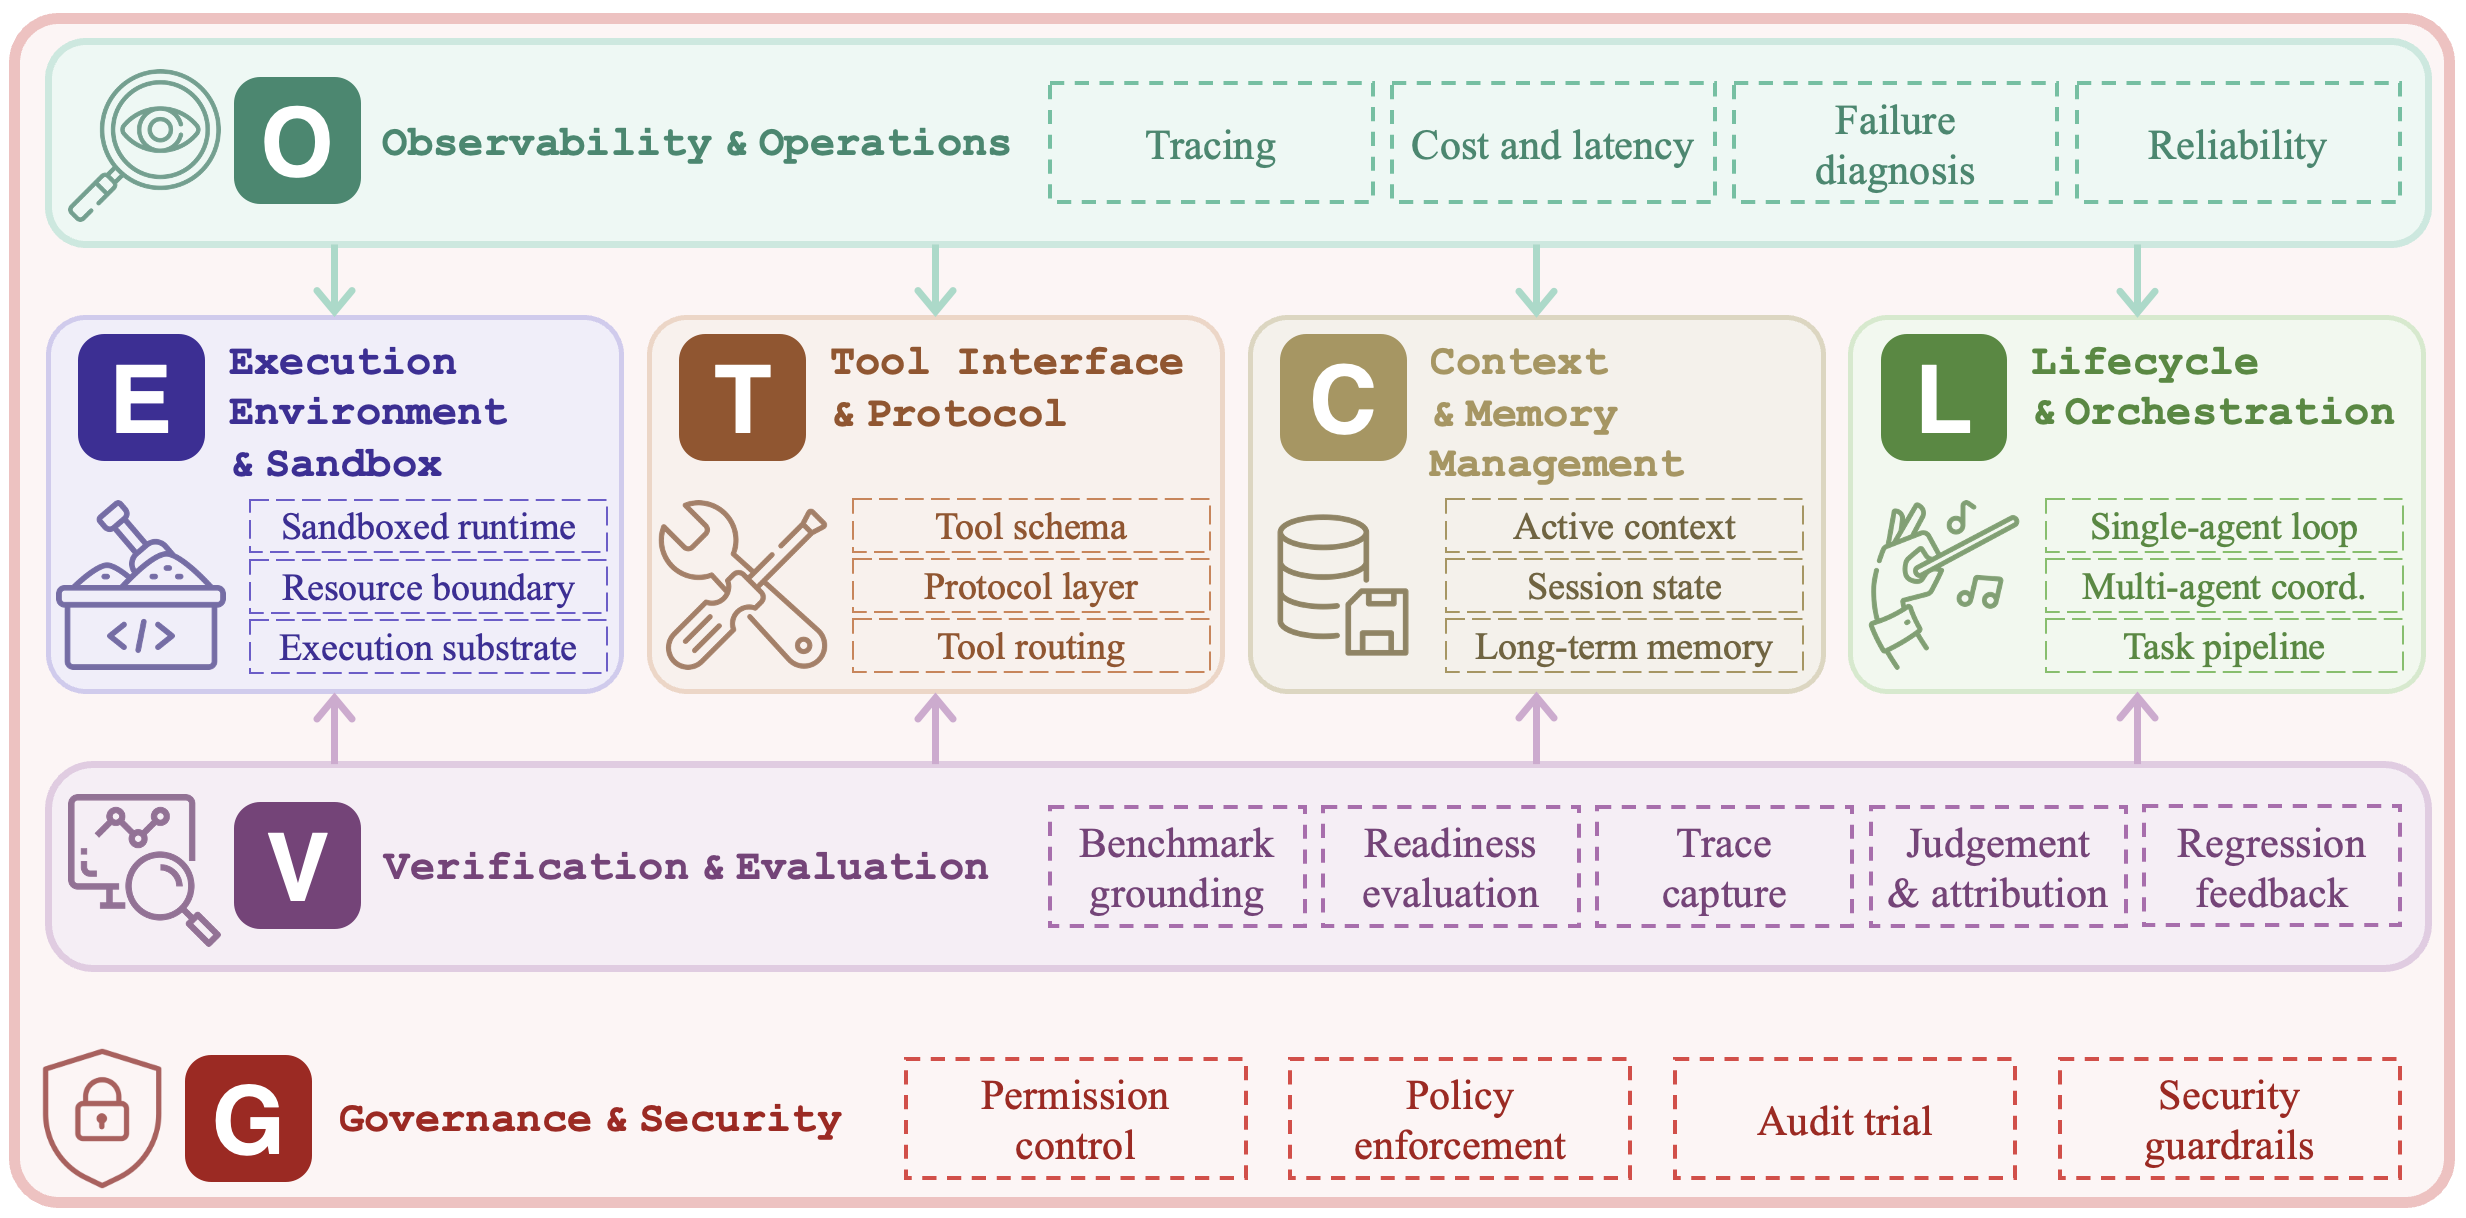
Agent Loop:Harness 的运行核心,驱动 LLM ↔ Tool ↔ Context 的循环调度,每一轮都要决定”调工具还是出终态”。
-
Tool Layer:Agent 在每一步 Loop 里可调用的能力集合。
-
Built-in Tools:内置原子能力,如
web_fetch、web_search、bash、read_file、write_file、edit、glob、grep、write_todos、agent、task_monitor、browser-use等。内置工具均可被替换和插拔。 -
MCP Tools:通过 MCP 协议接入的第三方外部工具,运行时可插拔。
-
-
Context Layer:每轮 LLM 调用前的上下文装配与治理,决定”模型这一次看到什么”。
-
Prompting:用 XML 把 System Prompt 拆成零件化组装,并在运行中注入
<system-reminder>等 nudges。 -
Compressor:对超长 trajectory 做压缩/摘要,守住 token 预算与注意力。
-
Short-term Memory:当前任务范围内的临时记忆(scratchpad、todos、近期工具结果等)。
-
Long-term Memory:跨会话持久化的长期记忆(用户画像、偏好、领域知识)。
-
-
Session Layer:面向用户界面的会话层(类比聊天软件左侧边栏的会话列表)。
-
Session Manager:会话的创建、切换、归档等生命周期管理。
-
Session Storage:会话元数据与消息历史的持久化存储,支持扩展。
-
-
Orchestrator Layer:Multi-Agent 的编排调度层。包括:
-
Workflow 架构:基于工作流式的编排,类似 LangGraph、Coze、N8N 等。
- Sub-agent 架构:类似 Claude Code 的 Sub-agent 风格,每一个并行执行的 Sub-agent 上下文隔离且互不通讯,实现起来简易且高效,常见于 Deep Research 和 Coding 任务。
-
Agent Team 架构:Claude Code 提出并实践的 Agent 团队架构,每一个 Agent 都具有一个收件箱,Agent 在执行任务过程中可以异步通讯。
-
Plugin System Layer:Harness 对外的可扩展接口,让第三方在不改核心的前提下介入。
-
Hooks:在 Agent Loop 的关键节点(pre/post tool call、turn start/end 等)注入自定义逻辑。
-
Skills:按需加载的能力包,走 SKILL.md 渐进式披露模式。
-
Plugins:更粗粒度的扩展打包形式,其实就是一组 Hooks/Skills/Tools 而已,可以通过
{plugin_name}:{skill_name}的形式来调用。
-
-
Observability & Evals Layer:Self-evolving Harness 的闭环底座,让上面的所有层都”有据可依地进化”。
-
Tracing & Debugging:记录每次运行的完整 trajectory,支持回放、归因与线上排障。
-
Feedback Loop:把线上信号(用户反馈、失败用例、Evals 退化项)回流到 Prompt、Skills、Hooks 的迭代。
-
Evals:离线基准与回归测试,对 Harness 任何一次改动做数据化验收。
-
-
Self-evolving 闭环:Tracing 采集 trajectory → Evals 打分识别短板 → Feedback Loop 把短板回流到 Prompting/Skills/Hooks → 上层持续迭代,Agent Loop 在下一轮就跑在更好的 Harness 上。
Harness 范式的演进#
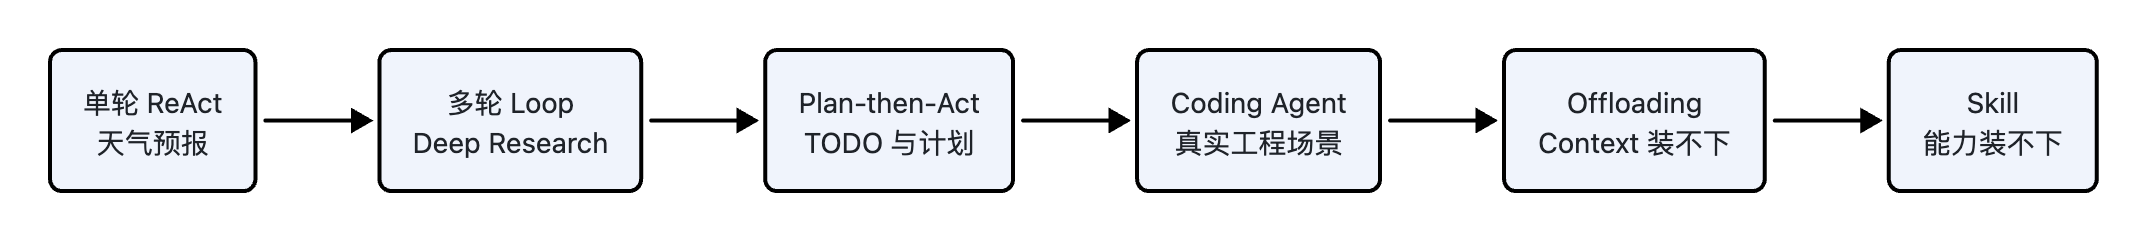
每一级往上加的东西都极少:多轮只是让 loop 多转几圈;Plan 只是在 loop 外头多塞一条 TODO;Coding Agent 只是把 Tool 从 web_search 换成 read_file、write_file、edit_file、bash;Offloading 和 Skill 解决的则是「东西多到塞不进 Context Window」之后的两个不同方向的妥协。
单轮 ReAct#
-
发起单次工具调用:

-
发起多次工具调用(一次 emit 多个 tool_call):

tool_calls 工具调用#
Function Calling 是 OpenAI 于 2023 年 6 月推出的重要特性,让模型能够输出结构化的函数调用指令。2024 年 8 月,OpenAI 进一步推出了 Structured Outputs(结构化输出),确保模型生成的参数 100% 符合 JSON Schema,大幅提升了生产环境的可靠性。理解其完整机制,是构建可靠 Agent 的基础。
多轮 ReAct Loop#

谁决定 loop 什么时候停:决定 loop 停机的不是 harness,而是 LLM 自己。
而实际上 ReAct 和 Workflow 最本质的区别就是谁决定停机。
循环外部能力拓展#
不少 Agent 实现和官方 SDK的结构都差不多,循环本身相当稳定,从最小实现一路扩展到支持子 Agent、上下文压缩和 Skills 加载,主循环基本没有变化,新增能力通常都是叠加在循环外部,而不是改动循环内部
新能力基本只通过三种方式接入,不应该让循环体本身变成一个巨大的状态机,模型负责推理,外部系统负责状态和边界,一旦这个分工确定下来,核心循环逻辑就很少需要频繁调整了:
1、工具扩展
// 1. 定义新的工具描述 (告诉 AI 这个工具怎么用)const emailTool = {  name: "send_email",  description: "发送电子邮件",  parameters: { ... }};
// 2. 定义新的执行逻辑 (真正干活代码)async function sendEmailHandler(to: string, body: string) {  console.log(`正在给 ${to} 发送邮件...`);  return "发送成功";}
// === 关键点:扩展发生在这里 ===// 我们不需要改 while 循环,只需要把新工具加进数组const myTools = [weatherTool, calculatorTool, emailTool];
// 同时维护一个执行函数的映射表const toolHandlers = {  "search_weather": weatherHandler,  "calculate": calculatorHandler,  "send_email": sendEmailHandler // 加一行代码即可};
// === 核心循环完全不用动 ===// 只要把 myTools 传进去,循环会自动识别并处理新工具const response = await client.messages.create({ tools: myTools, // 这里自动包含了新工具 messages, // ...});2、调整系统提示词结构
3、把状态外化到文件或数据库
最简单的 Agent 把历史记录存在内存变量 messages 里,程序一关就没了。为了支持“长期记忆”或“多轮对话”,我们需要把状态存到外面。
原理:循环不再持有“记忆”,它只是一个无状态的执行者。每次运行,先从数据库把记忆“读”进来,跑完循环,再把新产生的记忆“写”回去
async function runAgent(sessionId: string, userInput: string) {  // === 关键点:状态外化 ===  // 1. 从数据库加载历史对话 (比如从 Redis 或 SQLite)  const history = await db.getMessages(sessionId);  // 2. 加上用户最新的输入  const currentMessages = [...history, { role: "user", content: userInput }];  // === 核心循环 ===  // 这里的逻辑和之前一模一样,只是数据源变了  while (true) {     const response = await client.messages.create({        messages: currentMessages, // 使用加载来的历史        // ...     });
     // 处理工具调用...
     // 如果对话结束,跳出循环     if (response.stop_reason !== "tool_use") break;     // 更新临时消息列表     currentMessages.push(...);  }  // 3. 把这次完整的对话记录存回数据库  await db.saveMessages(sessionId, currentMessages);}
效果:
- 断点续传:程序崩了也没事,下次从数据库读出来接着跑
- 多用户支持:同一个循环代码,传入不同的
sessionId,就能同时服务成千上万个用户,互不干扰
Loop Engineering (Plan-then-Act)#
/to-dos、/tasks、/goal#
纯 ReAct 的 loop 只有战术,没有战略。因此可以给它加上战略层,让它先把 plan 写下来,再去执行。
新工具:write_todos、update_todos
{ "name": "write_todos", "description": "Creates or updates TODOs for complex, multi-step tasks. Use this when a task benefits from being broken into several actionable items that can be tracked or revised over time, for example deep research or coding. Do not use this for very simple tasks that only require one or two steps. Should call this tool after each TODO is done. Mark the first item as 'in_progress' if applicable.", "strict": true, "parameters": { "type": "object", "required": ["todos"], "properties": { "todos": { "type": "array", "description": "A list of TODO items representing the steps or sub-tasks needed to complete a task.", "items": { "type": "object", "required": ["content"], "properties": { "content": { "type": "string", "description": "The text description of the TODO item." }, "status": { "type": "string", "description": "The current status of the TODO item, such as pending, in_progress, or completed." }, "priority": { "type": "string", "description": "The priority level of the TODO item, such as low, medium, or high." } }, "additionalProperties": false } } }, "additionalProperties": false }}一个 TODOs 看上去是这样的:
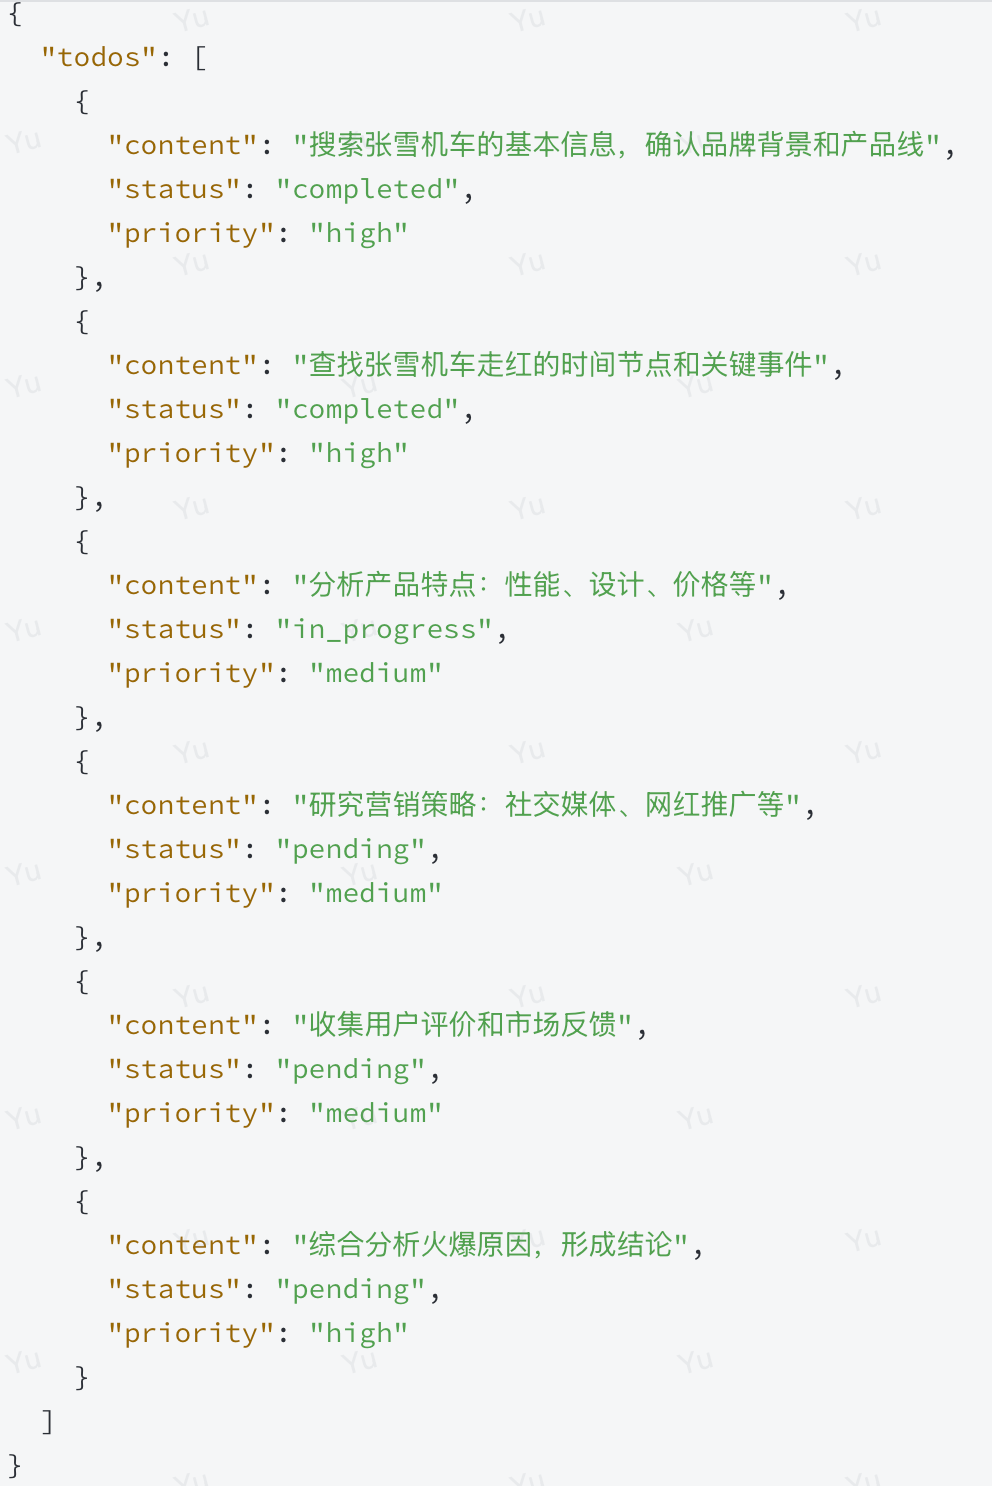

实战中会撞见两个小坑:
-
一是不熟悉的话题上,plan 会跑偏
-
二是跑到一半,模型会忘了维护 todos——明明做完了第二项,却不调
write_todos把它划成completed,也不把刚发现的一个新子任务补进去。Plan 就这么一点点失效了。
补丁 A:Plan 之前先做一次 briefing#
Plan-then-Act 的第一个坑很好理解——模型不能 plan 自己不认识的东西。
补丁也很轻。在 system prompt 里明确允许 Agent 在 plan 之前做一次 web_search,只为建立对这个话题的基本认知:
<guidelines> <guideline for="deep-research"> - Create a research plan using write_todos - Perform a quick `web_search` before planning if you're not familiar with the topic, or - Execute the plan step by step or in parallel if applicable - Dynamically change the ToDo plan according to the latest information we collect </guideline></guidelines>补丁 B:每一步之后 nudge 一下#
对第二个问题,仅仅在 system prompt 里写一句「记得更新 todos」是不够的。
Harness 的解法叫 nudge(提醒 / 推一把),也叫 system-reminder——在~~每次~~最后一次 tool_result 之后、且当前 todo list 非空时,由 harness 硬编码往上下文里追加一条提醒给模型:
<system-reminder>- There're still some ToDos not marked as 'completed', update the ToDo list before your n- Running multiple tasks in parallel is allowed, and mark multiple ToDos as 'in_progress'- Add/update/remove ToDos from your plan according to the latest information we collect i<system-reminder>画成时序图更清楚:

注意 Harness 的两个动作:一是把 tool_result 原样回传给 LLM;二是在检查到「当前 todo list 非空」时,额外追加一条 system-reminder。两件事在同一个消息里交给 LLM,看起来像是「工具返回自带了一句 nudge」。
Graph Engineering#
Workflow 和 ReAct 有什么区别#
Anthropic 对这两类系统有一个直接区分:执行路径由 DSL 领域 DAG 代码预先写死的是 Workflow,由 LLM 动态决定下一步的是 Agent,核心区别在于控制权掌握在谁手里。
| 维度 | Workflow | ReAct |
|---|---|---|
| 控制权 | 代码预定义,同输入必走同一路径 | LLM 动态决策,可能需要评测验证 |
| 执行方式 | 工具顺序固定,错误走预设分支 | 工具按需选择,模型可尝试自我修复 |
| 状态与记忆 | 显式状态机,节点跳转清晰 | 隐式上下文,状态在对话历史中累积 |
| 维护成本 | 改流程需修改代码并重新部署 | 调整系统提示即可,无需重新部署 |
| 可观测性 | 日志定位节点,延迟可预估 | 需完整执行记录理解决策链,轮数不固定 |
| 人机协作 | 人在预设节点介入 | 人在任意轮次介入或接管 |
| 适用场景 | 流程固定、输入边界清晰 | 需要中间推理与灵活判断 |
Workflow 的多种模式:
| 模式 | 支持方式 |
|---|---|
| 提示链 | 顺序调用 agent();可在两步间插入任意 TypeScript 校验。 |
| 路由 | 用普通 if / switch 或一次结构化分类 agent() 后分支;每支可指定不同 model。 |
| 并行 | 原生 parallel();分段并发和多次投票后汇总都适用。 |
| 编排器-工作者 | 已有“计划 → parallel() 分派 → 综合”的 fan-in/out 现成模式;不是内置 spawn 工具,而是由工作流代码显式调度。 |
| 评估器-优化器 | 用顺序 agent() 加 while 循环实现:生成、评估、反馈、重写,达到阈值或次数上限即结束。 |
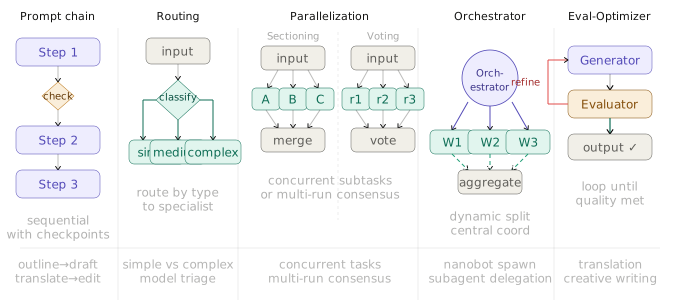
一个最小化的 DAG 引擎通常包含以下核心模块:
- 图定义:提供 DSL(如 YAML 格式属于外部 DSL,而 API 注入属于内部 DSL),供用户定义任务节点及其依赖关系。
- 图解析:解析 DSL 构建 DAG 对象,并执行拓扑排序,以检测循环依赖并生成合法的线性执行序列。
- 状态存储:跟踪任务(
Pending,Running,Success,Failed等)及整个工作流的状态,这是实现持久化的关键。 - 调度器:遍历就绪任务并派发执行的引擎核心。这里的关键逻辑是当任务完成后,动态检查并识别所有前置任务已成功的下游任务,将它们加入就绪队列。
- 执行器:负责执行具体任务,如调用
pi-agent运行一个子 Agent,或执行read,write等内置工具。 - 日志/可观测:集成 TUI 仪表盘等,展示执行进度、各任务输出及 DAG 结构。
Skill(本质 Prompt)不适合所有步骤#
1、固定步骤也要反复经过模型,这会消耗 Token,也让本来确定的事情变得不确定。
2、把计划 to-dos 写在清单 Checklist 里,不等于稳定执行。
- Skill 的本质仍是“Agent 遵循的指令”,下一步由 Agent 按 Turn 决定;
- Workflow 则是“Runtime 执行的脚本”,下一步由脚本决定;
以合同审核为例,一份 Skill 即使写了“必须检查主体、金额、期限、违约责任和争议解决”,模型仍可能因为上下文过长漏掉一项,也可能把“检查”理解成摘录而不是风险判断。
3、自我迭代对象只有 Prompt,真实进度很难被验证。
如果流程变成 JavaScript,迭代对象就多了一层可测试的结构。Agent 在真实任务中是否遍历全部文件、是否等待三个检查完成、失败后最多重试几轮,Workflow 都能直接控制(读代码、写测试、看 Diff)。Prompt 仍然负责“怎么判断”,Workflow 代码开始负责“有没有执行”。
4、跨模型差异会被流程放大。
把机械步骤留在 JavaScript 里,并不会让模型能力变得相同;它只是把差异收缩到需要智能判断的 agent() 节点。模型可以对合同条款给出不同风险判断,但五类条款是否全部检查,不应该随模型而变化。
这里需要留一个边界:Skill 本身可以携带脚本,也可以让 Agent 调用脚本。如果你已经把固定循环、校验和转换放进脚本,那么你其实已经在做同一件事——把确定性从 Prompt 中拿出来。Dynamic Workflow 给这种分工提供了一套专门的 Runtime。
Dynamic Workflow#
CodeAct 范式
Dynamic Workflow 就是 AI 根据你的需求生成、迭代出的一段 JavaScript 脚本,就像 Skill 那样,你不需要懂一行代码也可以制作和运行。是一种代码优先的 Graph Engineering 实现:TypeScript 定义有效的执行路径,Coding Agent 则负责每个节点内部的语义工作。
Workflow Creator Skill(一个完整的 Skill 工程目录)
Dynamic Workflow 核心很朴素:就是一组由 Workflow Runtime 注入的宿主 API。这个特性也让 Dynamic Workflow 可以轻松的跑在你的笔记本、手机甚至嵌入式设备上,当然更可以跑在无人值守的云主机、FaaS 上。
Workflow 脚本#
Claude Code 官方文档 展示的保存文件,由一个 meta 对象和脚本主体组成。主体是普通 JavaScript,可以使用数组、对象、JSON、Math,也支持顶层 await;与此同时,agent()、pipeline() 这些名字并不是 JavaScript 标准库,而是 Runtime 提供的能力。
export const meta = {  name: 'review-contract',  description:'检查合同中的关键条款并汇总风险',  phases: [    { title: 'Quick Search' },    { title: 'Plan' },    { title: 'Research' },    { title: 'Draft' },    { title: 'Review' },    { title: 'Finalize' },  ]}
const target = args?.file
const { clauses } = await agent(`读取 ${target},列出关键条款。`, {  schema: {    type: 'object',    required: ['clauses'],    properties: {      clauses: { type: 'array', items: { type: 'string' } },    },  },})const reviews = await pipeline(clauses, clause => agent(`判断这项条款的风险:${clause}`)
return reviews
它的头部和 Skill 的 Frontmatter 相似:meta 是一段静态的字面量信息,先告诉宿主这段 Workflow 叫什么、做什么以及可能需要经历的阶段(Phase),脚本正文再描述实际执行过程。保存后的 Workflow 还可以通过全局 args 接收结构化输入。Runtime 也可以把 Token 预算以 budget 暴露给脚本,让循环在预算耗尽前停止。后面的 API 一览会逐个展开这些符号。
1、JavaScript 负责机械控制流
代码擅长的事情,都可以留在脚本里:去重、精确排序、数学运算、传统算法(如经典的线性回归、聚类、模拟退火等)、判断结果数量、限制重试次数、等待并行任务、把上一步结果传给下一步等,另外就是机械化的流控(Flow Control),如复杂的嵌套循环、If…Else 逻辑判断、并行/异步/同步等。这些动作不需要模型每一轮重新理解。
遇到语义判断时,脚本才调用 agent()。例如,JavaScript 可以确保合同的每项条款都经过审核,却不应该用几个 if 判断条款是否公平;它可以检查 100 份文档是否全部返回结果,却不应该自己评价证据是否可信。
2、Workflow Runtime 可移植
Workflow 脚本可移植,不等于丢给任意 JS 引擎就能跑,Node.js 并不知道 agent() 是什么,也没有 Workflow 的权限、并发上限、进度记录和恢复机制。
只有当另一个 Harness 能实现等价的 agent(),并提供相同的输入、隔离、并发和恢复约定,才能实现真正的移植。
这套编排的可移植性来自接口边界:上层是普通 JavaScript 控制流,下层是可替换的 Agent Runtime。只要边界保持一致,agent() 背后可以是 Claude Code,也可以是另一套完整的 ReAct Loop。脚本关心的是“派一个 Agent 完成这项任务并返回结果”,不必关心 Harness 内部如何维护 Context、调用 Tool 和判断结束。
Workflow API 一览#
Dynamic Workflow 的脚本可见原语不多。其中只有 agent() 直接启动 AI 执行;其余 API 负责调度、分组、记录和预算控制。
| API 方法(点击可直接跳转至源代码) | 说明 |
|---|---|
| 核心 API 只有一个 | |
|
启动一个拥有独立 Context 和工具能力的 Sub-Agent。默认返回最终文本;传入 schema 时返回通过 JSON Schema 校验的对象;被跳过或终止失败时可能返回 null。 |
| 流程控制 API | |
|
并发执行一组 thunk,等待全部结束后返回等长数组。单项失败记为 null,因此它天然形成一个 Barrier。 |
|
让每个 item 独立流过多个 stage。某个 item 不必等其他 item 完成当前 stage;单项失败后,该位置返回 null。 |
|
调用一个已保存的 Workflow,或运行指定路径的 Workflow 脚本,并把第二个参数作为子 Workflow 的 args。Runtime 只允许一层嵌套。 |
|
把后续 agent() 调用归入指定进度分组,便于在 Workflow 进度视图中观察。也可以在单次 agent() 的 phase 选项里覆盖。 |
| 进度外化与日志 API | |
|
向 Workflow 进度视图写一条运行日志,不改变控制流。 |
| 注入的全局变量 | |
|
全局输入。宿主把调用 Workflow 时传入的数组或对象直接注入脚本;未传入时为 undefined。 |
|
全局 Token 预算视图。没有设置总预算时,total 为 null,remaining() 返回 Infinity。 |
Agent 通过 JSON Schema 进一步控制输出:
不传 schema 时,agent() 返回最终文本,文本适合报告、解释和评审意见,因为下一位消费者是人。问题出在中间结果:下游如果要据此分支、过滤或继续并行,自然语言就不是稳定接口。
这里的 schema 不是一句“请返回 JSON”。在 Claude Code 中,Runtime 会给 Sub-Agent 注入 StructuredOutput Tool;Agent 完成调查后,要通过这个 Tool 提交结果。Runtime 随即按 JSON Schema 校验,形状不匹配时,Agent 仍留在 Loop 中修正输出;多次尝试仍无法通过时,agent() 会失败,而不是把一段看似 JSON 的文本交给下游。
JSON.parse()只能证明文本语法合法,不能证明ok一定是布尔值、issues一定存在,或每条问题都有文件与行号。Structured Output 把“像 JSON”推进到了“满足这份契约”。
Schema 也不宜写成一棵过深的树。字段越多、嵌套越深,Agent 修正失败输出的成本越高。更稳妥的做法是让一次 agent() 只交付一个清晰中间态,再由脚本完成去重、排序、空值过滤和分支。