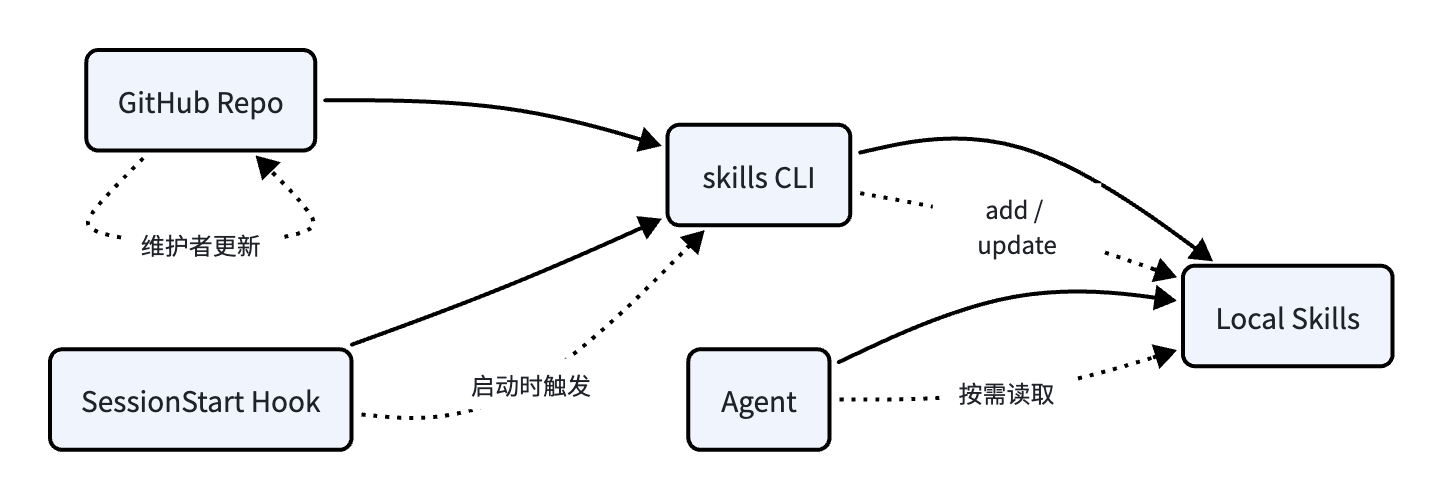
本指南说明如何为 agents 编写专业级 skill、用 LLM 进行验证,以及如何保持精简的上下文窗口。
这份指南浓缩了创建 agent skills 的最佳实践。如果你需要更完整的文档,请看 Claude 的文档。
要评估你的 skill 是否表现良好并防止回归,请查看 skillgrade。
核心原则#
- 简洁为王: 上下文窗口是公共资源,skill 的 token 会和系统提示、对话历史、其他 skill 的元数据竞争。默认假设 agent 已经很聪明——只补充它不知道的上下文。逐条质疑:“这句话值得它的 token 成本吗?”
- 匹配自由度: 按任务的脆弱程度和可变性匹配指令的具体程度。
- 高自由度(文本指令): 多种方法都有效、决策依赖上下文时使用(如代码审查)。
- 中自由度(带参数的脚本/伪代码): 存在推荐模式、允许一定变化时使用。
- 低自由度(精确命令): 操作脆弱易错、一致性至关重要时使用(如数据库迁移:给出精确命令并禁止修改)。
- 用目标模型测试: skill 是模型能力的延伸,在你想支持的所有模型上测试。对小模型给足引导,对大模型避免过度解释。
Skill 的结构#
每个 skill 都必须遵循下面的目录结构:
输出模板、JSON schema、图片skill-name/├── SKILL.md # 必需:元数据 + 核心指令(<500 行)├── scripts/ # 用于确定性任务的可执行代码(Python/Bash)├── references/ # 补充上下文(API 文档、cheatsheet、领域逻辑)└── assets/ # 输出模板、JSON schema、图片- SKILL.md: 充当“主脑”。用它来做导航和高层流程说明。
- References: 直接从 SKILL.md 链接。只保留 一层深度。
- Scripts: 用于脆弱、重复性的操作,且变化本身就是 bug 的场景。不要把库代码打包在这里;
优化 frontmatter 以提升可发现性#
SKILL.md 里的 frontmatter 中,name 和 description 是 agent 在触发 skill 之前唯一能看到的字段。如果它们没有针对可发现性进行优化,或者不够具体,这个 skill 就等于“隐身”。
- 遵守严格命名: name 字段必须是 1-64 个字符,只能包含小写字母、数字和连字符(不能有连续连字符),并且 必须与父目录名完全一致(例如,
name: angular-testing必须位于angular-testing/SKILL.md)。 - 命名规范: 优先用动名词形式(
processing-pdfs、analyzing-spreadsheets、testing-code)。避免含糊名字(helper、utils、tools)和过于笼统的名字(documents、data、files)。 - 编写面向触发的 description:(最多 1,024 个字符)。这是 agent 用来路由的唯一元数据。要用第三人称来描述能力,并包含”负向触发条件”。
- 差: “React skills.”(太笼统)
- 好: “使用 Tailwind CSS 创建并构建 React 组件。用户希望更新组件样式或 UI 逻辑时使用。不要用于 Vue、Svelte 或纯 CSS 项目。”
渐进式披露与资源管理#
通过“按需加载”信息来保持干净的上下文窗口。SKILL.md 是高层逻辑的“主脑”;把细节卸载到子目录中。
发给 Agent:当前 SKILL.md 太长了,缺乏 progressive-disclosure 机制,但是也请不要滥用。
- 保持 SKILL.md 精简: 主文件限制在 <500 行。把它用于导航和主要流程。
- 使用扁平化子目录: 将大量上下文移到标准文件夹中。保持文件严格为 一层深(例如
references/schema.md,不要写成references/db/v1/schema.md)。 - 即时(JiT)加载: 明确告诉 agent 什么时候去读某个文件。除非你直接指示它,它不会看到这些资源(例如:“具体错误码请查看
references/auth-flow.md”)。 - 显式路径: 无论操作系统如何,始终使用带正斜杠(
/)的相对路径。 - 长参考文件加目录: 超过 100 行的参考文件,在开头放一个目录(Contents),让 agent 即使部分读取也能看到全貌、按需跳转。
Skills 是给 agents 用的,不是给人看的。为了保持上下文精简并避免不必要的 token 消耗,不要创建:
- 文档文件:
README.md、CHANGELOG.md或INSTALLATION_GUIDE.md。 - 冗余逻辑: 如果 agent 已经可以可靠地完成某个任务,就删掉那条指令。
- 库代码: skills 应该引用现有工具,或只包含很小、单一用途的脚本。长期存在的库代码应该放在标准 repo CLI 目录中。
内容准则#
给 LLM 写指令,而不是给人写说明。
- 使用分步编号: 把工作流定义成严格的时间顺序。如果存在决策树,要清晰地画出来(例如:“步骤 2:如果你需要 source map,就运行
ng build --source-map。否则跳到步骤 3。”)。 - 提供具体模板: agent 对模式匹配非常擅长。与其花几段文字描述 JSON 输出应该长什么样,不如把模板放在 assets/ 目录里,并指示 agent 直接复制其结构。
- 使用第三人称祈使式: 把指令写成直接命令 agent 的形式(例如,“提取文本…”,而不是 “我会提取…” 或 “你应该提取…”)。
- 避免时效性信息: 不要写会过期的内容。如果必须保留旧版说明,用
<details>折叠放进 “Old patterns” 部分。 - 一个好的 Skill 应该适当引入 Human-in-the-Loop。你可以在 Skill 的 prompt 里明确要求它使用
AskUserQuestion来与用户进行多轮交互。AskUserQuestion工具支持单选、多选和预览单选等交互,同时还支持 Step-by-step 式的向导。
在引用 skill 文件中的概念时,要保持具体且一致。
- 使用相同术语: 为同一个概念固定一个术语。
- 保持术语足够具体: 使用该领域原生且最具体的术语。例如,在 Angular 中用“template”,而不是“html”、“markup”或“view”。
为重复操作打包确定性脚本#
不要每次运行 skill 时,都让 LLM 从头编写复杂的解析逻辑或样板代码。
- 卸载脆弱/重复性任务: 如果 agent 需要解析复杂数据集,或查询某个特定数据库,就在 scripts/ 目录里提供一个经过测试的 Python、Bash 或 Node 脚本让它运行。
- 妥善处理边界情况: agent 依赖标准输出(stdout/stderr)判断脚本是否成功。编写脚本时要返回高度描述性、可读性强的错误消息,这样 agent 就能准确地自我修正,而不必请求用户介入。
常见模式#
- 模板模式: 输出格式用模板。严格需求(如 API 响应、数据格式)用 “ALWAYS use this exact template”;灵活场景给出”合理默认值,按判断调整”。
- 示例模式: 当输出质量依赖样例时,提供输入/输出对,比纯文字描述更有效(例如 commit message 格式给 2-3 个示例)。
- 条件工作流模式: 在决策点明确分支——“创建新内容? → 走创建流程;编辑现有内容? → 走编辑流程”。流程太复杂时拆到独立文件,按任务类型指示 agent 读取对应文件。
Skill 的组合#
你可以组合 skills(也叫 router skills),如果你想条件性地包含另一个 skill,或者想创建一个由多个 subskill 组成的 skill。示例:
---name: build_projectdescription: ...---
## 概览...
## Build targets
### Client
要把 client 构建成可部署二进制文件,请看 [path to skills]。
### Server
要把 server 构建成可部署二进制文件,请看 [path to skill]。
...验证指南#
因为 LLM 会使用你的 skills,所以我找到的确保它们有用的最好方法,就是和 LLM 协作。
为 skill 做 eval 非常关键,这样才能确保你做的修改是正向的,并且不会引入回归。一个常见的 skill 基准是 SkillsBench,可以给你一些灵感。
当你完成 skill 的初稿后,可以按下面步骤验证:
发现性验证#
Agent 严格依据 YAML frontmatter 加载 skill。要单独测试 LLM 如何理解你的 description,避免误触发(比如本来是 Angular 的 skill,却被 React 应用触发了)。
把下面的文本原样粘贴到一个全新的 LLM 对话里:
我正在基于 agentskills.io 规范构建一个 Agent Skill。agents 会完全根据下面的 YAML 元数据来决定是否加载这个 skill。
仅根据这段描述:
- 生成 3 个真实的用户提示词,我要 100% 确认它们应该触发这个 skill。
- 生成 3 个看起来相似、但不应该触发这个 skill 的用户提示词(例如,迁移 React app 到 Vite,或者只是更新 Angular 版本)。
- 批评这段描述:它是不是太宽泛了?给出一个优化后的改写版本。
另外,也可以给 agent 分配你预期会触发 skill 的任务,并读取和检查它的思考过程。和 agent 来回互动,找出它为什么选择(或没有选择)某些 skill。
逻辑验证#
确保你的逐步指令是确定性的,不要强迫 agent 去臆造缺失的步骤。
把你的整个 SKILL.md 和支持文件的目录结构喂给 LLM:
下面是我的
SKILL.md草稿以及其支持文件的目录树。[把你的 SKILL.md 内容贴在这里] 现在,请把自己当作一个刚刚触发这个 skill 的自主 agent。针对“将我的 Angular v17 app 迁移到 Vite”这个请求,按步骤模拟你的执行过程。
对于每一步,请写出你的内部独白:
- 我具体在做什么?
- 我在读取或运行哪个具体文件/脚本?
- 标出任何执行阻塞(Execution Blockers):指出到底是哪一行让我不得不猜测或臆造,因为我的指令不够清晰(例如,如何把 Angular 的环境文件映射到 Vite 的
import.meta.env)。
边界情况测试#
从漏洞、未支持的配置,以及 web 工具固有的失败状态出发,强迫 LLM 对你的逻辑发起攻击。
让 LLM 来“攻击”你的逻辑:
现在,切换角色。把自己当作一个无情的 QA 测试员。你的目标是破坏这个 skill。 请就边界情况、失败状态或
SKILL.md中缺失的兜底逻辑,向我提出 3 到 5 个高度具体、具有挑战性的问题。重点关注:
- 如果
scripts/esbuild-optimizer.mjs因为遗留的 CommonJS 依赖而失败怎么办?- 如果用户的
angular.json里包含了大量自定义的 Webpack builder(@angular-builders/custom-webpack),而 Vite 不支持怎么办?- 我是否对用户的 Node 环境做了什么隐含假设?
现在不要修复这些问题。只需按编号提出问题,然后等我回答。
SkillOpt 测试与进化#
- Rollout(前向传播):冻结的目标模型使用当前的技能文档去执行一批任务,记录下完整的执行轨迹和得分,作为”证据”。
- Reflect(反向传播):一个独立的优化器模型分析失败和成功的轨迹,找出系统性问题,并提出具体的修改建议(
add/delete/replace)。这相当于计算”文本空间的梯度”。 - Aggregate & Select(梯度裁剪):将相似的修改建议合并,然后根据”文本学习率”(
lr,默认每步最多4个编辑操作)进行排名和截断,防止单次改动过大导致”灾难性遗忘”。 - Update & Gate(参数更新与验证):应用选中的修改,并在一个独立的验证集(Selection Split)上重新评估新的技能文档。只有验证集表现提升的修改才会被最终接受,否则被拒绝。这是防止过拟合的关键。
第一步:用模型跑任务,收集数据
我们拿100道编程题,让模型带着这份skill去解题。每道题模型会输出答案,我们检查答案对不对,给每个题打分(0或1)。同时把模型的完整思考过程(CoT)和最终代码都保存下来。
这100条记录就是“证据”。比如其中30题做对了,70题做错了。错的题里,有40题是因为没加logging导致调试失败。
第二步:分析错误,生成修改建议
我们启用第二个模型(优化器),把上面100条记录、每道题的得分、模型思考过程,全部作为输入喂给它。
优化器分析后输出具体的编辑指令,比如:
replace(第15行, "必须用logging", "必须在每个函数入口和出口加logging,且记录入参值")add(第20行, "禁止在循环内用logging.debug,改用列表收集后统一输出")
这些指令就是“文本梯度”,指向具体怎么改skill文档。
第三步:筛选并合并修改建议
假设优化器一口气提了20条修改建议。系统会按“如果只改这一条,预估能挽回多少分”排序,然后根据预设的步长上限(比如每轮最多改4条),只取前4条。
同时检查这4条有没有冲突(比如一条要删某段,另一条要改同一段),有冲突就合并或舍弃。
第四步:用验证集验证修改,决定是否采纳
我们手里还留了另一组没见过的50道题(验证集),这50道题之前任何阶段都没用过。
把修改后的新skill文档给模型,重新跑这50道题,算出新得分。拿新得分和修改前在这50道题上的得分对比:
- 新得分更高:采纳这次修改,用新skill替换旧skill
- 新得分更低或持平:直接丢弃这次修改,保留旧skill
这个门控机制保证每次进化都是“真实有效”的。
额外机制:防止重复犯错
系统里有个“被拒修改黑名单”,记录所有被验证门控拒绝的修改指令。下一轮优化器再生成建议时,我们会把黑名单也喂给它,明确告诉它:“这3种改法以前试过,没用,别再提了。”
最终产出
重复上面1-4步,比如跑20轮。每轮结束后,我们始终保存的是在验证集上得分最高的那份skill文档。最后部署时,直接把这份文档塞进目标模型的系统提示词里,模型推理时按这些规则执行,整个过程没有任何额外开销。
反模式#
- Windows 风格路径: 一律用正斜杠(
scripts/helper.py),不要用反斜杠。正斜杠跨平台兼容。 - 提供过多选项: 不要罗列一堆可选库,给一个默认选择 + 逃生舱(如”用 pdfplumber 提取文本;扫描件 OCR 用 pdf2image + pytesseract”)。
- 假设工具已安装: 明确指出依赖及安装命令(
pip install pypdf),不要只说”用 pdf 库处理”。
检查清单#
发布 skill 前逐项确认:
- description 具体且包含关键触发词,同时说明”做什么”和”何时用”
- SKILL.md 正文 < 500 行,细节拆到独立文件
- 无时效性信息(或放在 “Old patterns” 部分)
- 术语全篇一致
- 参考文件一层深,超过 100 行的文件带目录
- 工作流步骤清晰,关键操作有验证/反馈循环
- 脚本自行处理错误、无魔法数字、依赖明确
- 至少创建 3 个评估场景,并在目标模型上测试
npx skills 进行 SKILL 维护#