我们说“在代码库里搜索”,实际可能在问不同的问题:
这个字符串出现在哪里?哪里存在这种代码写法?实现登录功能的代码可能在哪里?谁调用了这个函数?这四个问题需要的能力逐级增加:
| 问题 | 工具需要理解什么 | 常用工具 |
|---|---|---|
| 字符串出现在哪里 | 文件里的字符 | rg、git grep |
| 哪里存在这种代码写法 | 编程语言的语法结构 | ast-grep、Semgrep、Comby |
| 某项功能可能在哪里实现 | 关键词和自然语言含义 | QMD、zvec-grep、Sourcegraph |
| 谁调用了这个函数 | 符号定义和项目关系 | 代码图、LSP |
搜索工具越往下,需要预先理解和保存的信息越多,运行成本也通常越高。实际排查代码时,可以先用便宜的工具缩小范围,再读取源码确认。
先找候选文件 → 再确认代码结构 → 再查询调用关系 → 最后阅读源码和测试真实行为一、文本搜索:找到出现某段文字的地方#
1. rg 搜索的是什么#
假设项目里有三个文件:
src/user.ts 包含 getUserByIdsrc/order.ts 不包含 getUserByIdREADME.md 包含 getUserById 的使用说明执行:
rg "getUserById" .这条命令可以拆成三部分:
rg:启动 ripgrep;"getUserById":要寻找的文字;.:从当前目录开始搜索。
结果可能是:
src/user.ts:12:export function getUserById(id: string) {README.md:28:Call getUserById to load a user.rg 只负责告诉你这段文字出现在哪里。它不会判断第一处是函数定义,第二处是文档。
再看两个常见命令:
rg "TODO|FIXME" src/这里的 | 表示“TODO 或 FIXME”,所以它会在 src/ 中找出包含任意一个词的行。
rg -g "*.ts" "fetch\(" src/逐项解释:
-g "*.ts":只检查.ts文件;fetch\(:寻找fetch(,其中\(表示把左括号当普通字符;src/:只搜索src目录。
2. rg 为什么快#
一次文本搜索要做四件事:找到文件、读取内容、寻找文字、打印结果。rg 的速度主要来自减少无用工作。
第一,它默认跳过 .gitignore 中的文件、隐藏目录和常见二进制文件。项目里的 node_modules、构建产物和缓存经常占据大量空间,不读取它们就能省下很多时间。
第二,它可以同时检查多个文件。电脑有多个 CPU 核心时,不同文件可以并行搜索。
第三,搜索条件里如果有固定文字,它会先找固定文字,再检查完整条件。例如搜索:
getUserById\(它可以先找 getUserById。一行里连这个名字都没有,就不需要继续检查后面是否跟着左括号。
第四,处理器可以一次比较一组字节。扫描长文本时,可以成组检查字符,不必把每个字符都单独处理。这类 CPU 能力通常称为 SIMD。理解它的作用即可:搜索结果不变,完成相同比较需要的步骤更少。
不同搜索内容会触发不同优化。复杂正则、超大单文件、慢磁盘都会影响速度,因此“快”不是所有情况下的固定保证。ripgrep 项目说明
3. git grep 与 rg 有什么不同#
git grep "getUserById"git grep 默认在 Git 管理的文件中搜索。Git 已经记录了这些文件的名单,所以它不需要把当前目录里的所有文件都当成候选。
两者最实用的区别是搜索范围:
| 情况 | rg | git grep |
|---|---|---|
| 已被 Git 跟踪的文件 | 搜索 | 搜索 |
| 没被 Git 跟踪的新文件 | 默认搜索 | 默认不搜索 |
被 .gitignore 忽略的文件 | 默认跳过 | 不属于跟踪范围 |
| 不在 Git 仓库里 | 可以使用 | 不能按仓库方式使用 |
| 搜索指定提交中的内容 | 不负责 | 可以 |
git grep 还能搜索 Git 索引或指定历史版本里的内容。Git grep 文档
4. 文本搜索的边界#
下面三处都包含 deleteUser(:
deleteUser(id); // 真正的函数调用// deleteUser(id); // 注释const example = "deleteUser(id)"; // 字符串执行 rg "deleteUser\(" 时,三处都可能被找到。因为它比较的是字符,不知道哪些字符属于代码、注释或字符串。
这不是 rg 的缺陷。它的职责就是快速、完整地寻找文字。当问题变成“只找真正的函数调用”时,需要语法结构搜索。
二、语法结构搜索:寻找某种代码写法#
1. 什么是语法结构#
编程语言规定了代码由哪些结构组成。例如:
const total = add(price, tax);解析器看到的结构大致是:
变量声明├── 变量名:total└── 初始值:函数调用 ├── 被调用对象:add └── 参数 ├── price └── tax这棵树表达各部分在语法上的包含关系,通常称为语法树。结构搜索先把代码解析成树,再寻找符合条件的节点。
这样就能区分:
add(price, tax); // 函数调用"add(price, tax)"; // 字符串// add(price, tax); // 注释2. ast-grep:临时查找和改写代码结构#
假设要找所有 console.log(...) 调用。代码可能写成一行,也可能换行:
console.log("started");
console.log(  user.id,  user.name);
const example = "console.log('text')";
使用:
ast-grep --lang js --pattern 'console.log($$$ARGS)' src/逐项解释:
--lang js:按 JavaScript 语法解析;console.log(...):只匹配这种调用结构;$$$ARGS:表示零个或多个参数,并把参数内容记为ARGS;src/:搜索目录。
它会匹配前两个真实调用,不会把字符串中的 console.log 当成调用。换行通常也不会影响结果,因为它比较的是解析后的结构。
单个 $A 通常表示一个语法节点:
ast-grep --lang js --pattern 'foo($A)' src/它可以匹配:
foo(user)foo(user.id)foo(getUser())这里的 $A 分别接住了 user、user.id 和 getUser() 这三个完整表达式。官方把这种占位符称为 metavariable(元变量)。ast-grep 模式语法
ast-grep 也可以把匹配结构改写:
ast-grep --lang js \ --pattern 'oldApi($A)' \ --rewrite 'newApi($A)' \ src/如果原代码是:
oldApi(user)oldApi(order.id)改写后是:
newApi(user)newApi(order.id)$A 把原参数保存下来,改写时再放回新调用中。
ast-grep 能确认“这里长得像某种调用”,但一般不能确认 oldApi 最终指向项目里的哪个定义。语法结构与符号关系是两个层次。
3. Semgrep:把代码规则保存下来并持续检查#
先看一个具体需求:团队不允许 JavaScript 代码使用 eval(...),因为它会把字符串当代码执行。
需要检查的代码:
eval(userInput); // 应该报告safeParse(userInput); // 不报告const text = "eval(x)"; // 不报告可以把规则保存为 no-eval.yml:
rules: - id: no-eval languages: [javascript] message: Do not execute strings with eval severity: ERROR pattern: eval(...)逐行解释:
rules:这个文件里保存一组检查规则;id: no-eval:规则的唯一名字,报告问题时会显示;languages: [javascript]:使用 JavaScript 语法解析目标文件;message:发现问题时告诉开发者什么;severity: ERROR:把问题标为错误级别;pattern: eval(...):匹配所有eval调用,...代表参数内容不限。
运行:
semgrep --config no-eval.yml src/输出会指出文件、行号、规则 ID 和消息。把这条命令放进 CI 后,每次提交代码都能执行同一规则;发现违规代码时,团队可以选择让检查失败,从而阻止合并。
Semgrep 的本质是:把“什么代码算问题”写成长期保存的规则,再对整个项目反复执行。规则可以组合多个条件,也可以用于数据流和污点分析,但这些属于后续能力。Semgrep 规则说明
ast-grep 与 Semgrep 的区别#
两者都会解析代码,能力有重叠。主要差别在使用目标:
| 问题 | ast-grep | Semgrep |
|---|---|---|
| 临时查找某种代码 | 很适合 | 可以 |
| 批量结构化替换 | 核心能力 | 不是主要用途 |
| 保存团队检查规则 | 可以配置 | 核心用途 |
| 在 CI 中输出问题报告 | 需要自行组织 | 核心用途 |
| 安全规则和数据流分析 | 不是重心 | 更完整 |
如果你今天要找出并改掉一种写法,先考虑 ast-grep。如果规则要在今后每次提交中继续检查,Semgrep 更贴合这个任务。
4. Comby:理解括号边界的代码模板替换#
先看正则容易遇到的问题:
foo(bar(x))如果想取出 foo(...) 的参数,参数本身还有一层括号。简单正则很容易在第一个右括号处提前结束,或者一路匹配到最后一个右括号。
Comby 允许用模板中的“洞”接住一段内容:
comby 'foo(:[arg])' 'safeFoo(:[arg])' .js src/逐项解释:
'foo(:[arg])':寻找foo(...);:[arg]:接住圆括号里面的完整内容,并命名为arg;'safeFoo(:[arg])':把函数名改成safeFoo,参数原样放回;.js:按 JavaScript 的字符串、注释和括号规则处理;src/:处理这个目录。
输入:
foo(bar(x))foo(user.id)输出:
safeFoo(bar(x))safeFoo(user.id)Comby 知道括号需要成对,因此第一个 :[arg] 能完整接住 bar(x)。它还会根据语言处理字符串和注释。这正是它比普通正则适合代码替换的地方。Comby 基础用法
Comby 没有像完整 AST 那样精确区分每一种语言节点。它主要理解括号、代码块、字符串和注释等边界,所以接入新语言或文本格式比较轻。
三种结构工具怎么选#
| 工具 | 它真正理解的内容 | 最适合的任务 |
|---|---|---|
ast-grep | 完整语法树中的节点结构 | 临时结构搜索、批量改写 |
| Semgrep | 语法结构、规则条件及部分数据流 | 安全扫描、缺陷规则、CI 检查 |
| Comby | 括号、代码块、字符串、注释等边界 | 多语言轻量模板替换 |
它们都比正则更适合处理代码,但没有自动回答“这个函数调用最终指向哪个定义”。要回答符号关系,还需要项目级解析。
三、不知道准确关键词时:索引和语义搜索#
文本与结构搜索都要求你大致知道要找什么。如果只知道“登录失败后在哪里重试”,真实代码却使用 retryAuthenticationRequest,直接搜中文描述不会命中。
这类工具会先为文档或代码建立索引,再按相关程度返回候选片段。
1. BM25:按关键词相关程度排序#
普通 rg 回答“有没有这个词”。BM25 还会计算哪些结果更值得排在前面。
索引会记录:
- 某个词出现在哪些文档;
- 在每篇文档中出现多少次;
- 这个词在整个资料库里常见还是少见;
- 文档本身有多长。
搜索 JWT validation 时,一篇多次讨论 JWT 校验的短文档,通常会排在只偶然出现一次 JWT 的长文档前面。
BM25 仍然依赖词语。查询写“登录凭证”,文档只写“authentication token”,它不一定知道两者相关。
2. 向量搜索:按模型判断的含义接近程度排序#
向量搜索先用 embedding 模型把每段文字转换成一组数字。模型在训练中学过大量语言,因此含义相关的文本通常会得到比较接近的数字表示。
例如查询:
登录失败后在哪里重试?即使源码或文档没有这句话,也可能召回:
retry authentication request after token refresh它的结果不是确定匹配。含义看起来接近的片段,实际可能属于另一个功能,因此必须继续读取源码确认。
3. 重排:重新检查候选结果的顺序#
关键词搜索和向量搜索先各自找出一批候选。重排器再同时阅读查询和候选片段,重新判断哪个更相关。
用户问题 → 关键词搜索得到候选 → 向量搜索得到候选 → 合并候选 → 重排 → 返回前几条召回、合并和重排都会增加计算成本,所以这种搜索通常比 rg 重。
4. QMD:搜索 Markdown 和知识库#
QMD 面向 Markdown、会议记录和个人知识库。当前实现组合了 BM25、向量搜索和本地模型重排。
# 把当前目录加入名为 notes 的集合qmd collection add . --name notes
# 按关键词搜索qmd search "authentication flow"
# 按含义搜索qmd vsearch "how does login work"
# 混合搜索并重排qmd query "how does login work"
这里的“集合”是一组要建立索引的文件。首次使用需要建索引;文件发生变化后,索引也需要更新。
QMD 的主要对象是文档。它返回相关片段,不负责证明函数调用关系。
5. zvec-grep:搜索本地工作区#
zvec-grep 的命令是 zg,面向包含代码和文档的本地工作区。它把精确文本、BM25 和向量搜索放在同一个入口下。
zg "where authentication is validated"这类查询适合 Agent 刚进入陌生项目、还不知道真实函数名的时候。它先返回可能相关的文件和片段,Agent 再用 rg、结构搜索或源码阅读确认。zvec-grep 检索流程
QMD 与 zvec-grep 的区别主要是对象范围:
| 工具 | 主要对象 | 常见用途 |
|---|---|---|
| QMD | Markdown、会议记录、知识库 | 搜个人资料和项目文档 |
| zvec-grep | 整个本地工作区中的代码和文档 | 帮人或 Agent 探索项目 |
四、从源代码到 Agent 可查询的项目图#
前面的工具主要返回“哪些位置可能相关”。现在的问题变成:
谁调用了 fetch?handler 又调用了哪些函数?从 API 入口到数据库函数经过了哪些调用?回答这些问题,需要把每个文件里的代码结构转换成一张项目级关系图。完整链路只有一条:
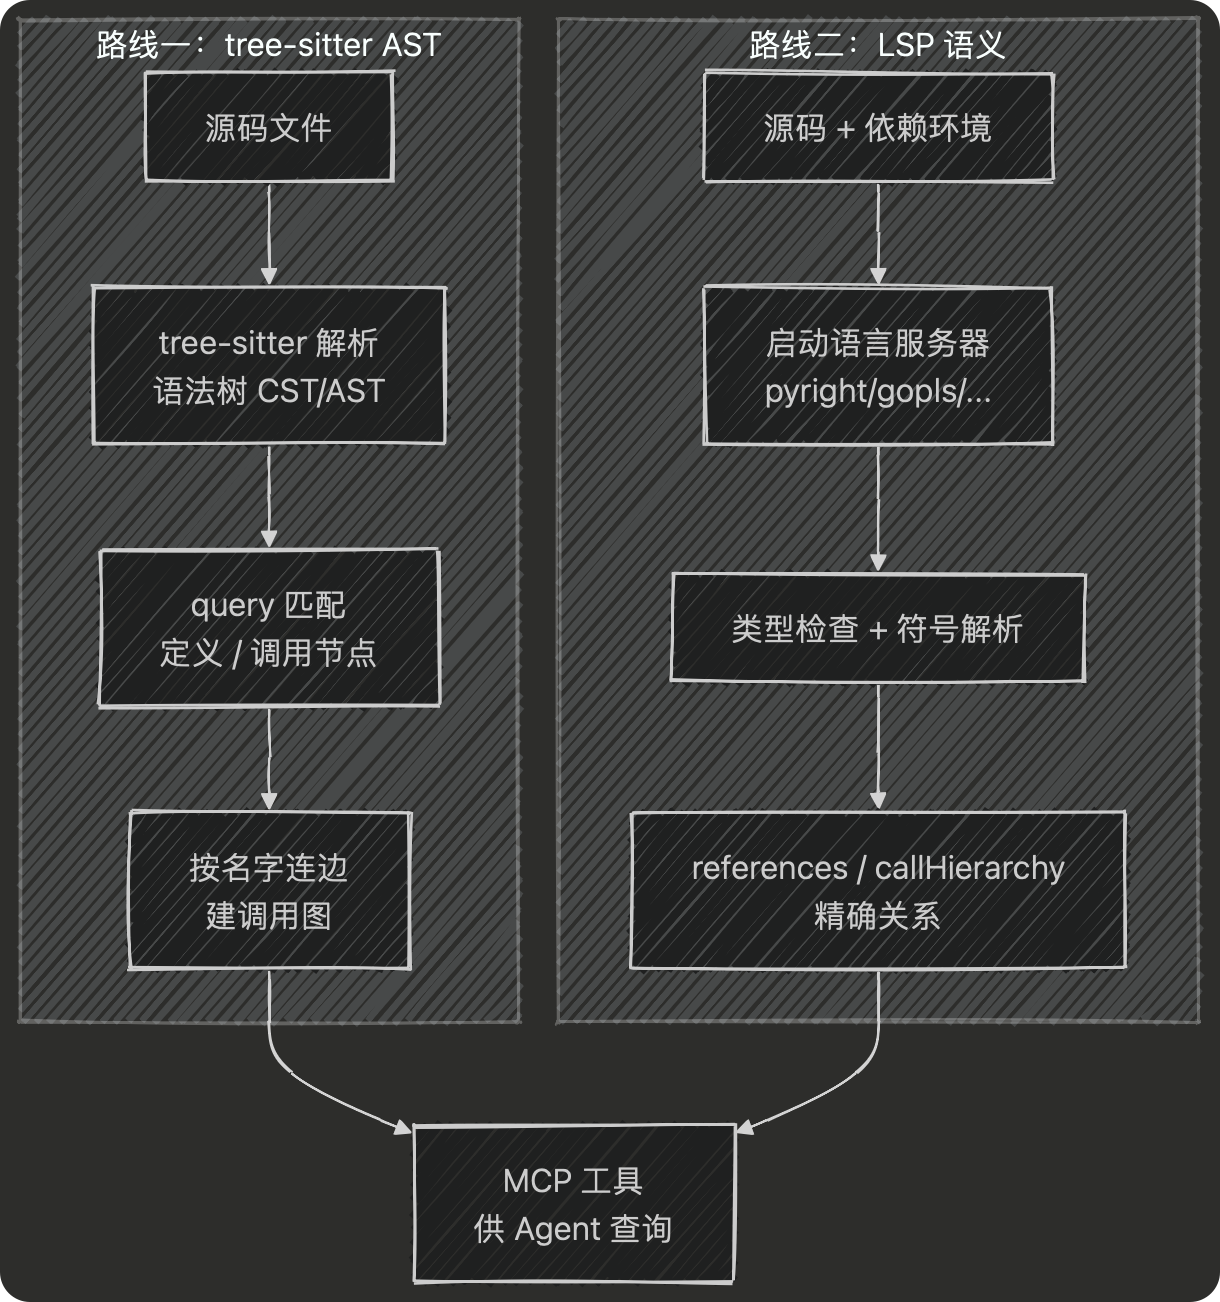
源代码文件 → 每个文件解析出一棵语法树 → 抽取函数、类、调用和导入 → 确定每个名字具体指向哪个符号 → 建立项目级节点和边 → 保存到数据库 → 通过 MCP 供 Agent 查询tree-sitter、LSP、CodeGraph 和 MCP 分别出现在这条链路的不同位置,后面按处理顺序说明。
1. 一个源文件通常对应一棵语法树#
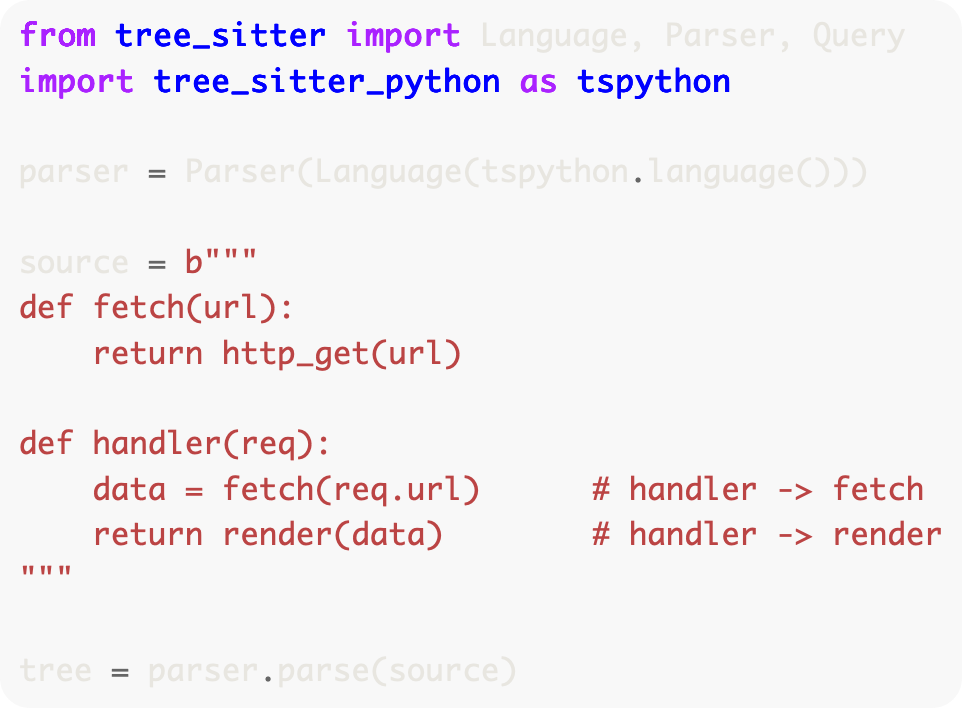
假设项目有两个文件:
from service import fetch
def handler(): fetch() render()def fetch(): http_get()解析器分别处理两个文件:
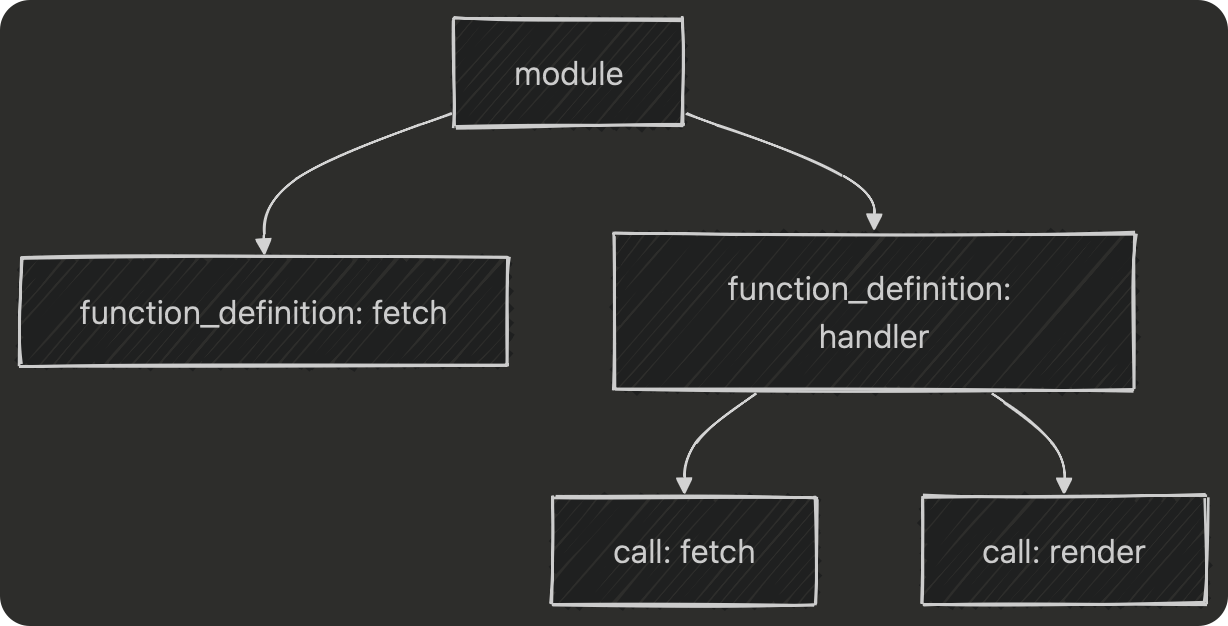
handler.py 的语法树module├── import: service.fetch└── function: handler    └── body        ├── call: fetch        └── call: render
service.py 的语法树module└── function: fetch    └── body        └── call: http_get
一个项目因此会处理很多棵文件语法树。调用图并不是把这些树直接拼成一棵大树,而是从每棵树里抽取信息,再建立另一种数据结构。
2. 第一步:抽取定义、调用和导入#
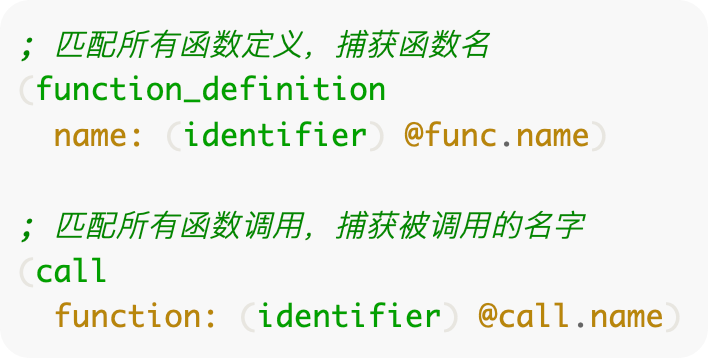
这一步常由 tree-sitter 完成。它按照某种语言的 grammar(语法规则)解析单个文件,知道 def 后面是函数定义、name(...) 是调用表达式,再通过 query 查找对应节点。tree-sitter 查询语法
遍历语法树后,可以得到中间记录:
定义:handler.py::handler定义:service.py::fetch
调用:handler 函数体中出现 fetch()调用:handler 函数体中出现 render()调用:fetch 函数体中出现 http_get()
导入:handler.py 从 service 导入 fetch
这里必须记录调用所在的函数作用域。如果一个函数内部又定义了函数,内层函数发出的调用属于内层函数,不能全部记到外层函数名下。
tree-sitter 的职责到这里基本结束:它能找出 fetch() 是调用,却不会自动知道这个 fetch 定义在哪个文件。它的优势是无需安装完整项目依赖,代码暂时有错误时也能尽量生成局部语法树。
3. 第二步:解析每个名字指向谁#
看见 fetch() 只能说明这里调用了一个名叫 fetch 的对象。项目里可能有多个同名函数:
service.py::fetchcache.py::fetchbrowser.py::fetch分析器需要结合当前文件的导入和作用域,确定 handler.py 中的 fetch() 指向:
service.py::fetch这一步叫符号解析。只按名字连接时,同名函数会造成错误关系。
符号解析有两种常见做法:
- 在 tree-sitter 抽取结果上,自己根据导入、模块、作用域和语言规则解析;
- 请求语言服务器,让它返回已经解析过的定义、引用或调用层级。
第二种方式通常通过 LSP(Language Server Protocol,语言服务器协议)完成。LSP 规定客户端怎样向 pyright、gopls、rust-analyzer、clangd 等语言服务器发送 JSON-RPC 请求。真正理解语言、类型和项目依赖的是语言服务器。
| LSP 请求 | 回答的问题 |
|---|---|
textDocument/definition | 光标处符号定义在哪里 |
textDocument/references | 哪些位置引用这个符号 |
callHierarchy/incomingCalls | 谁调用这个函数 |
callHierarchy/outgoingCalls | 这个函数调用谁 |
tree-sitter 与 LSP 的差别集中在这一点:
| 对比项 | tree-sitter + 自建解析 | LSP + 语言服务器 |
|---|---|---|
| 首先得到什么 | 单个文件的语法结构 | 已解析的符号和类型信息 |
| 跨文件关系 | 工具自己实现 | 通常由语言服务器处理 |
| 同名函数消歧 | 取决于自建规则 | 通常更准确 |
| 项目依赖不完整 | 仍能抽取语法 | 结果可能受影响 |
| 启动和资源成本 | 通常较低 | 通常较高 |
| 适合任务 | 全仓快速抽取、建立离线图 | 精确跳转、引用和局部调用查询 |
常见组合方式是:先用 tree-sitter 扫描整个仓库,再对准备修改的少量符号使用 LSP 确认定义和引用。
有些调用无法静态确定:
getattr(obj, method_name)()callback()handler.process()method_name 可能在运行时才知道,callback 可能由外部传入,handler 的真实类型也可能变化。可靠的索引应该把这种关系标成“未解析”或“存在多个候选”,不能假装已经确定。
4. 第三步:建立项目级节点和边#
符号解析完成后,把函数作为节点,把调用作为有方向的边:
handler.py::handler → service.py::fetchhandler.py::handler → handler.py::renderservice.py::fetch → http_client.py::http_get合并显示就是:
handler → fetch → http_get ↘ render这是整个项目的一张图。每个函数不是各自拥有一张图;以某个函数为起点查询时,只是从项目图中取出与它相连的部分。
callees_of(handler) → fetch, renderwho_calls(fetch) → handler节点不只有函数,也可以是文件、模块、类、接口、方法、变量、路由和组件。边也不只有 calls:
| 边 | 表示的关系 | 示例 |
|---|---|---|
contains | 包含 | 文件包含类,类包含方法 |
calls | 调用 | handler 调用 fetch |
imports | 导入 | handler.py 导入 service.py |
extends | 继承 | 子类继承父类 |
implements | 实现 | 类实现接口 |
references | 引用 | 某处使用某个符号 |
5. 第四步:保存并提供查询接口#
小型和中型代码图可以直接存入 SQLite:
nodes(id, kind, qualified_name, file_path, start_line, end_line)edges(source_id, target_id, kind, resolved, line_number)nodes 保存函数、类、文件等实体;edges 保存谁调用谁、谁导入谁等关系。
再通过 MCP 提供 Agent 可以调用的工具:
definition_of(symbol) → 定义在哪个文件、哪一行callees_of(function) → 这个函数调用谁who_calls(function) → 谁调用这个函数find_path(a, b) → a 到 b 之间有没有关系路径CodeGraph 指的就是把前面这些步骤做成一个长期可用的工程系统。典型实现会负责文件发现、tree-sitter 抽取、符号解析、节点和边的存储、图查询以及 MCP 封装。具体产品选用哪些模块,要以它自己的源码为准。

文件修改后,不必重建整个项目图。系统可以只重新解析变化文件、更新这些文件贡献的节点和边,再重新处理受影响的跨文件关系。比如一个导出函数改名后,其他文件中指向它的边也需要重新解析。
MCP 不负责理解代码,它只是查询入口。真正决定结果准确度的是前面的语法抽取和符号解析。
tree-sitter 的 query 长这样:
用 Python 的 py-tree-sitter 跑一遍,直观感受”从源码到调用边”:
解析出来的语法树(简化)大致是:
然后遍历树,对每个函数收集它 body 内的调用名,连边:
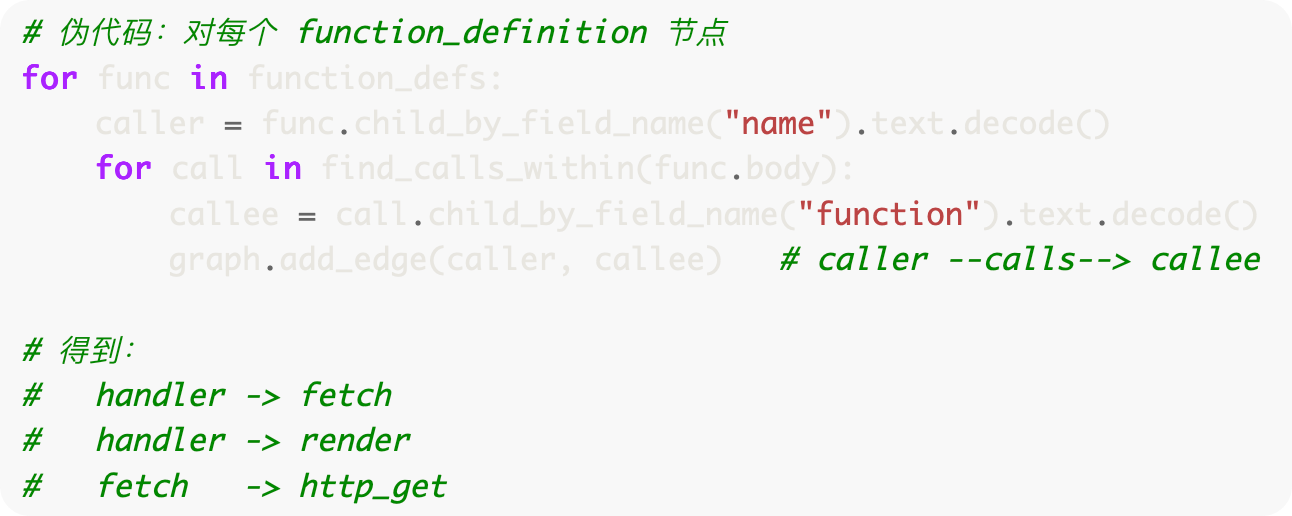
一张调用图就出来了。存进 SQLite 或 Neo4j,再包一层 MCP 工具(who_calls(fn)、callees_of(fn)、definition_of(sym)),Agent 就能直接查关系,不用 read 整个文件。
AST 调用图说到底是一张”名字层面”的近似图:召回不错、结构大致对,但精度有天花板,边可能多连(连错),也可能少连(连不上)。它换来的是快、纯本地、零依赖、省 token,代价是你得接受它不那么准。
LSP 走 JSON-RPC。启动服务器、initialize 握手、didOpen 打开文件之后,“查找所有引用”是这样一次往返:
// → 请求:谁引用了 service.py 第 2 行第 4 列的这个符号{ "jsonrpc": "2.0", "id": 1, "method": "textDocument/references", "params": { "textDocument": { "uri": "file:///app/service.py" }, "position": { "line": 2, "character": 4 }, "context": { "includeDeclaration": false } }}// ← 响应:精确的引用位置,跨文件、已消歧{ "jsonrpc": "2.0", "id": 1, "result": [ { "uri": "file:///app/handler.py", "range": { "start": {"line": 9, "character": 11}, "end": {"line": 9, "character": 16} } }, { "uri": "file:///app/worker.py", "range": { "start": {"line": 41, "character": 8}, "end": {"line": 41,"character": 13} } } ]}注意请求里传的是坐标(行、列),不是名字。服务器先把光标处解析成一个确切的符号,再返回这个符号的所有引用——哪怕工程里有五个同名函数,它也只给你指的那一个。调用图同理,走 callHierarchy 拿到的是解析过类型的入边 / 出边。
精确不是白来的:
- 要能”跑起来”:语言服务器需要一个可索引的工程,最好依赖都装好——它得解析 import、找到第三方库的类型才能准。代码跑不起来 / 环境脏,精度就打折甚至挂掉。
- 启动 + 索引慢:大仓首次索引几十秒到几分钟,内存吃得也多(rust-analyzer 啃大工程能上 GB)。
- 一种语言一个 server:多语言仓库要同时管好几个服务器进程。
- 有状态、协议啰嗦:
initialize→initialized→didOpen→ 等索引完 → 才能查,是一套有状态的长连接,比”解析完就完事”的 tree-sitter 重得多。 - 没有对外暴露的”整张图”:语言服务器内部确实持有全工程的语义模型(符号表、类型、索引),全局调用关系它是”知道”的——这点别误解。但 LSP 协议没有”把整张调用图导出来”这么一个方法,你只能从某个符号出发、用
callHierarchy(prepareCallHierarchy→incomingCalls/outgoingCalls)一层层查,自己 BFS 展开,而且多是按需现算。想要一张能离线存储、随便查的全图,得自己爬一遍拼出来——不像 AST 那样一遍扫完就落成静态图。
五、这些工具到底怎么选#
已知函数名、报错或配置项#
使用 rg。它启动快、结果完整,适合第一轮定位。
rg "Connection refused" .rg "DATABASE_URL" .知道代码结构,但格式不固定#
使用 ast-grep。例如只找真实的 console.log(...) 调用,而不匹配注释和字符串。
要把检查规则长期放进 CI#
使用 Semgrep。把违规结构、提示文字和严重级别写成规则文件,让每次提交执行同一检查。
要做一次跨语言的轻量模板替换#
考虑 Comby。它适合括号嵌套、字符串和代码块会让普通正则难以处理的场景。
不知道真实关键词,只知道功能描述#
使用 QMD 或 zvec-grep 召回候选内容,然后再用 rg、结构搜索和源码阅读确认。
要查谁调用谁#
使用代码图或 LSP。对重名、多态、回调和动态调用保持谨慎,关键修改仍要回到源码和测试确认。